使用大语言模型
大语言模型(LLM)能够理解和生成接近人类表达的文本,广泛用于聊天机器人、内容生成、代码补全等应用。
本指南介绍如何在 GPUStack 中部署和调用 LLM。
前提条件
开始前,请确认:
- 有一台配备一张或多张 GPU 的 Linux 机器,总显存至少 30 GB。本指南使用仅支持 Linux 的 vLLM 后端。
- 可以访问 Hugging Face 或 ModelScope,以下载模型文件。
- GPUStack 已安装并运行;如未完成,请参考快速入门。
步骤 1:部署大语言模型
从 Catalog 部署
Catalog 中的大语言模型标记为 LLM 分类。只要 GPU 资源充足,且后端与环境兼容,默认配置通常即可运行。例如,vLLM 后端需要 amd64 Linux Worker。
下面以部署 Qwen3 0.6B 为例。
按以下步骤从 Catalog 部署模型:
- 在 GPUStack 界面中打开
Catalog页面。 - 在模型列表中通过下拉菜单选择
LLM筛选模型。 - 查看模型说明、最大上下文长度和支持的规格。
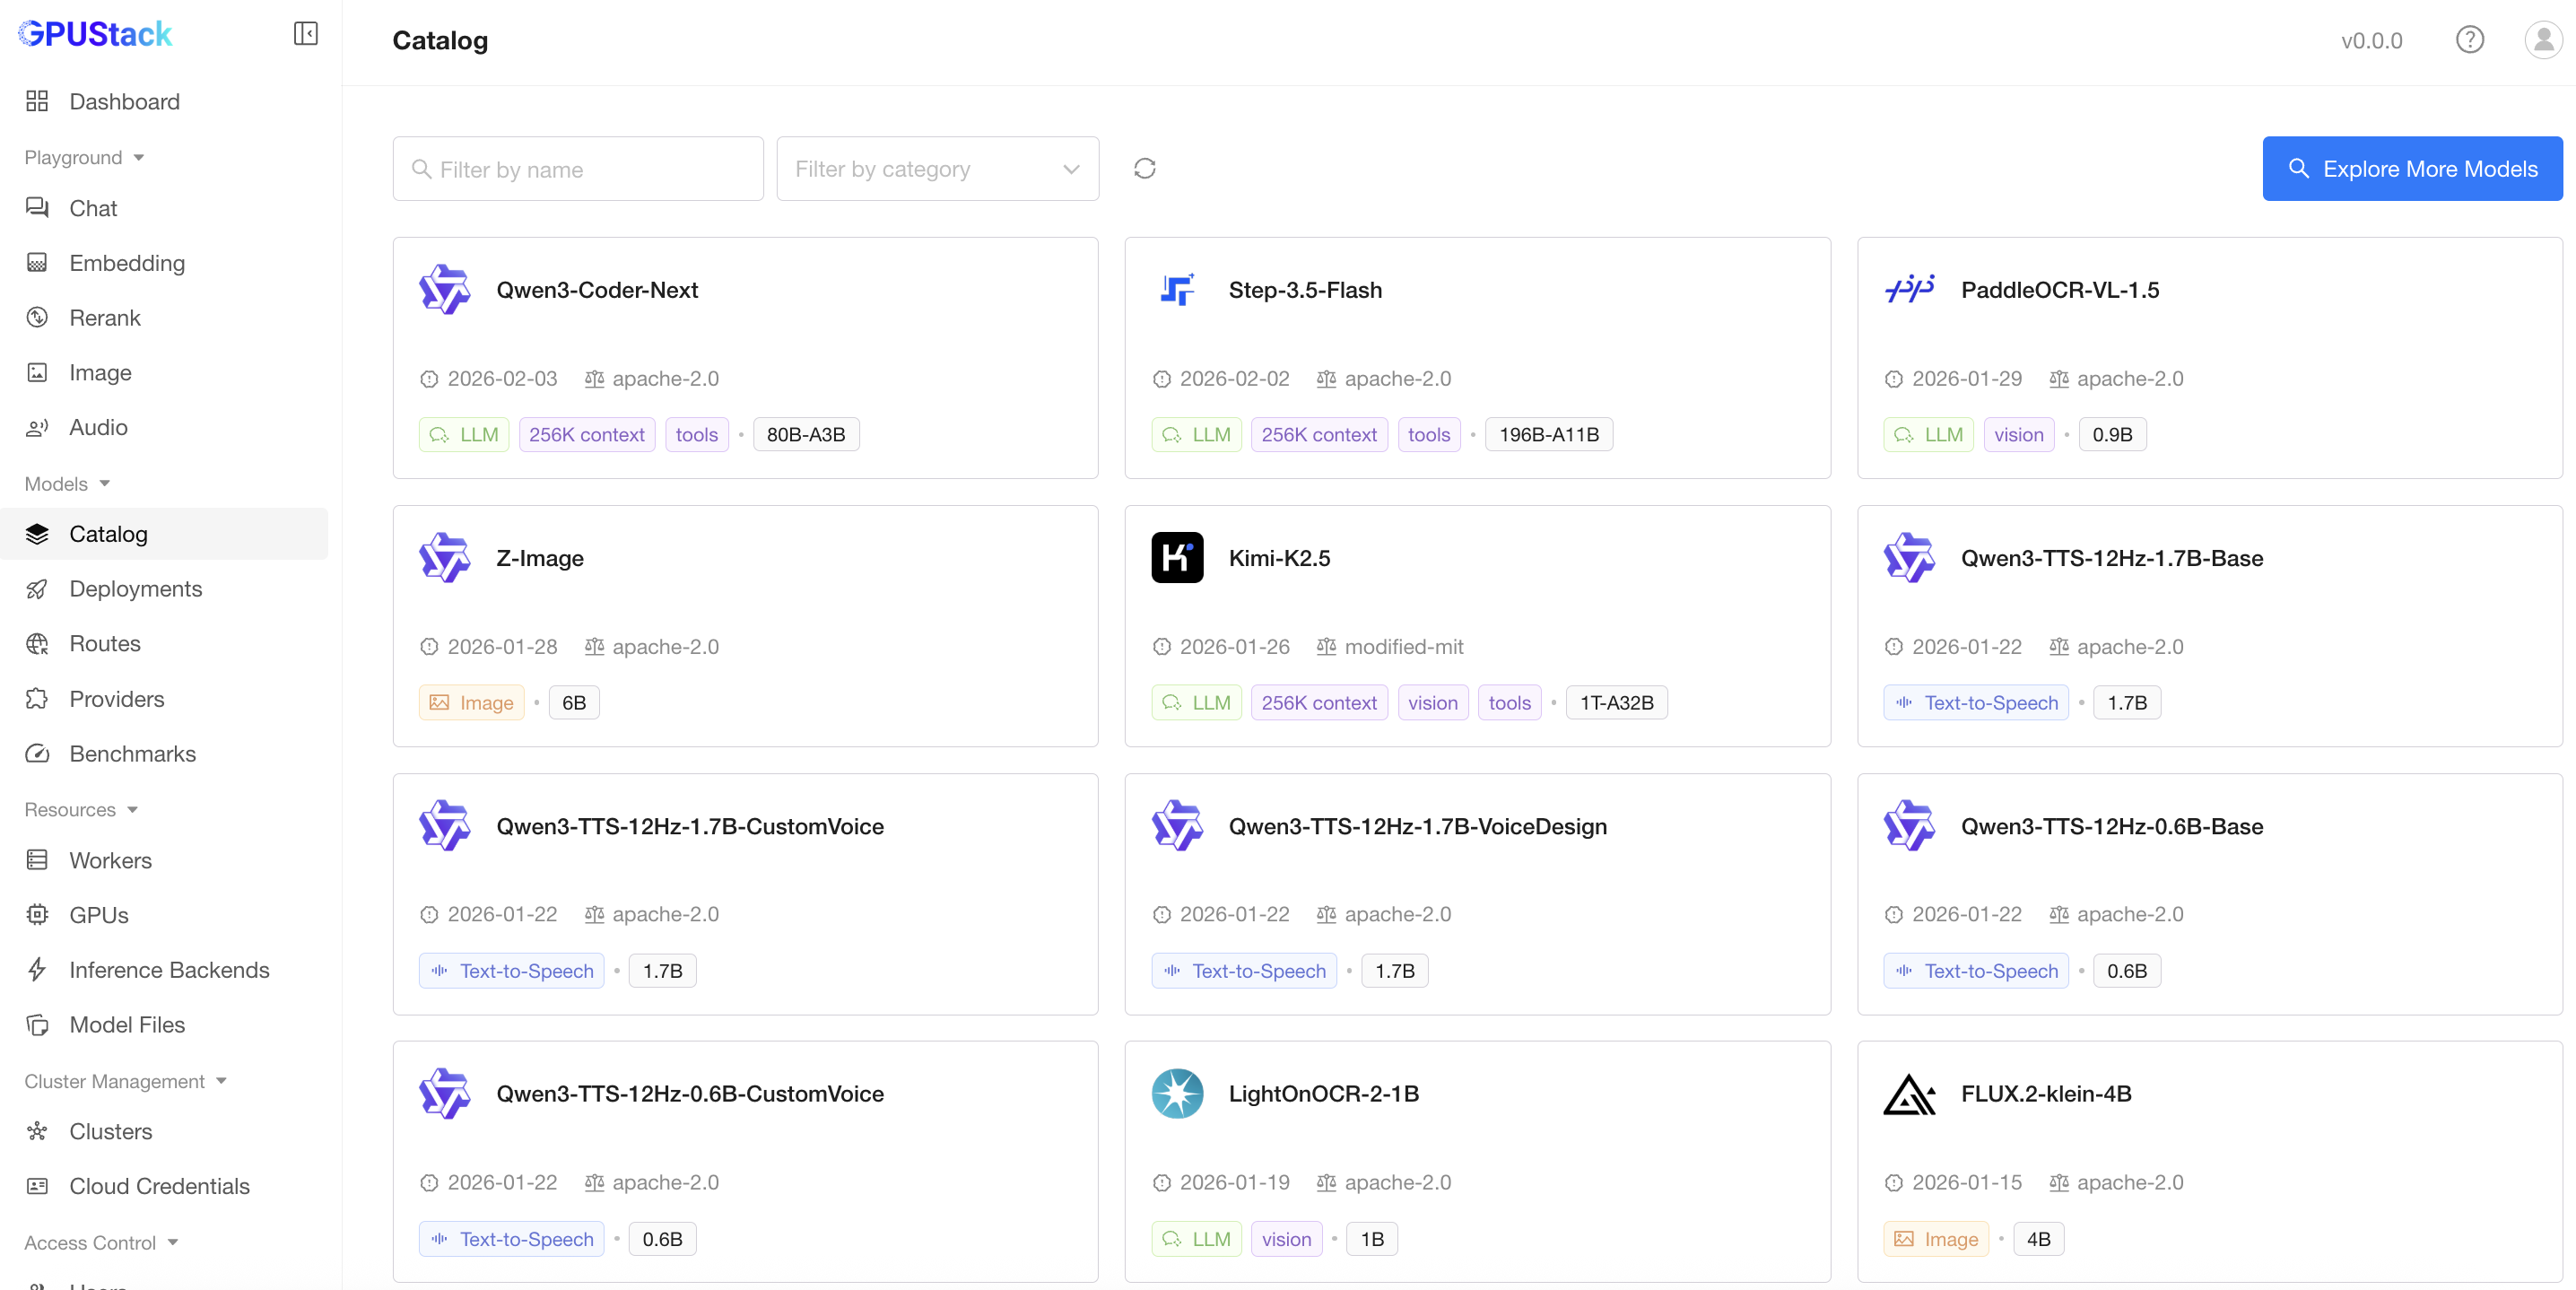
使用 vLLM 部署
- 在 Catalog 中选择
Qwen3 0.6B。 - 根据需要修改模型名称和配置。
- 点击
Save部署模型。
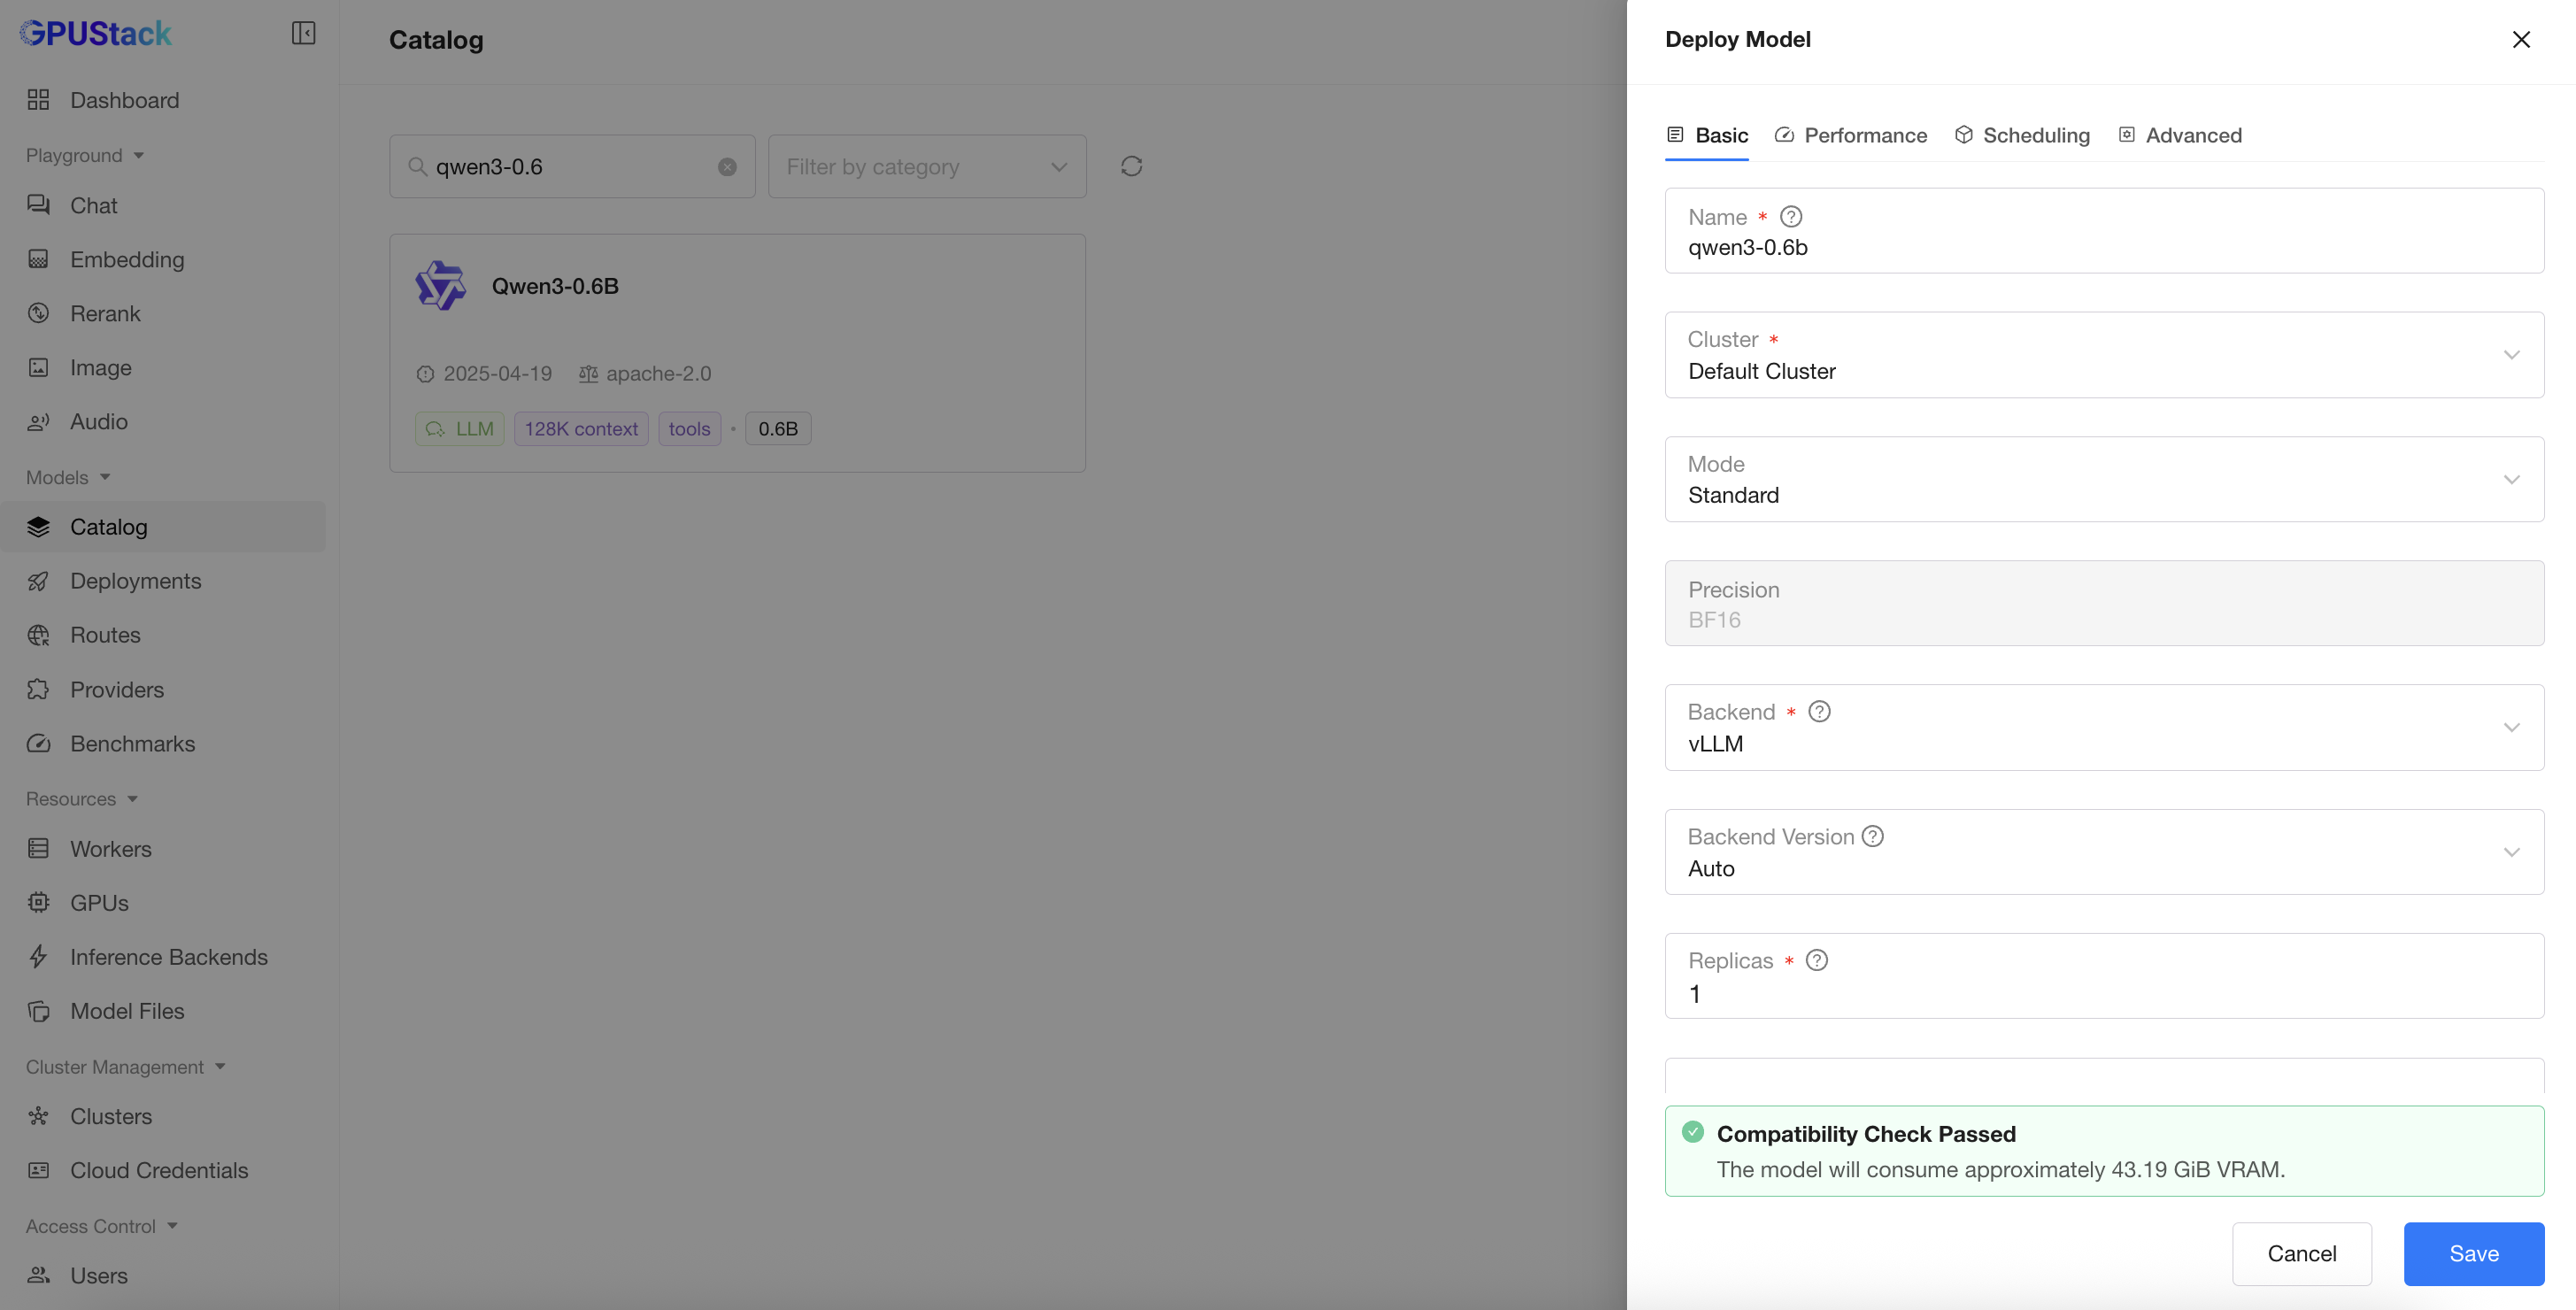
部署后,可在 Deployments 页面查看部署状态,并等待模型进入运行状态。
步骤 2:使用 LLM 生成文本
- 在 GPUStack 界面中打开
Playground>Chat页面。 - 确认右上角
Model下拉菜单中选中了已部署的模型。 - 输入用于文本生成的提示词。
- 按需调整右侧
Parameters。 - 点击
Submit生成文本。
生成的思维链和结果会显示在界面中。
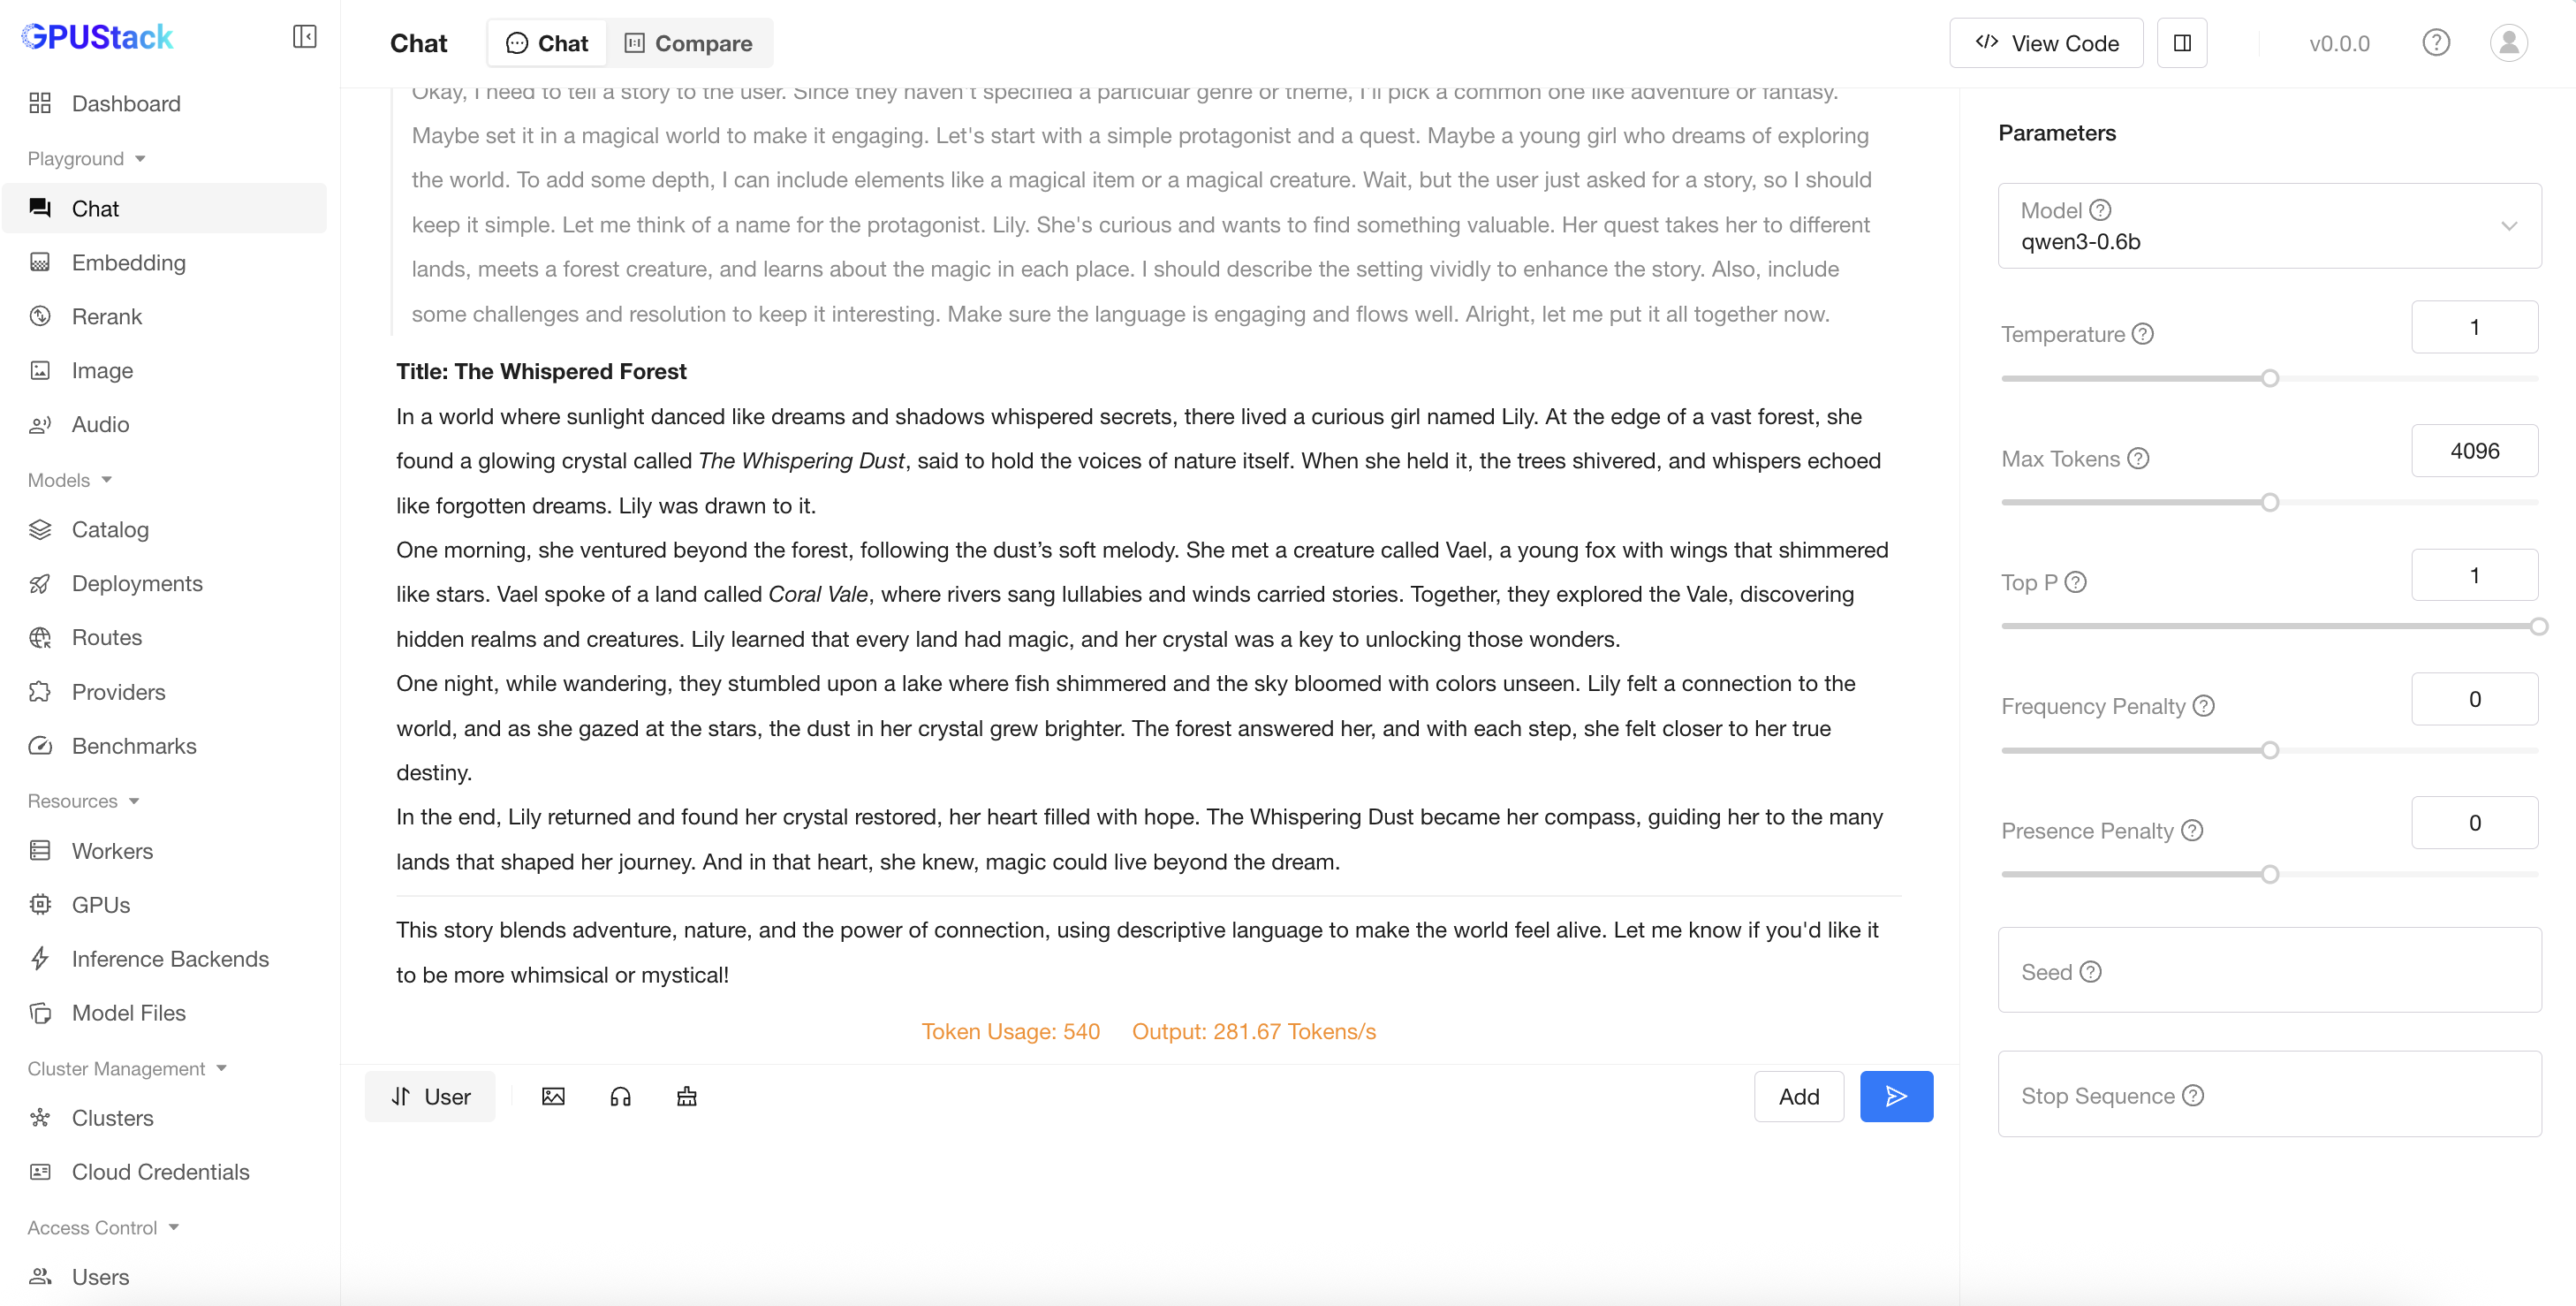
完成以上步骤后,即可在 GPUStack 中使用 LLM 执行文本生成和自然语言任务。尝试不同的提示词和设置,以探索模型能力。