使用向量嵌入模型 文本向量嵌入(Text embeddings) 是文本的数值表示,可以捕获语义,使机器理解不同文本之间的关系和相似性。它将文本转换为连续空间中的向量,语义相近的文本在空间中的距离也更近。文本向量嵌入广泛用于自然语言处理、信息检索和推荐系统。
本指南介绍如何在 GPUStack 中部署向量嵌入模型,并使用部署的模型生成文本向量。
前提条件 开始前,请确认:
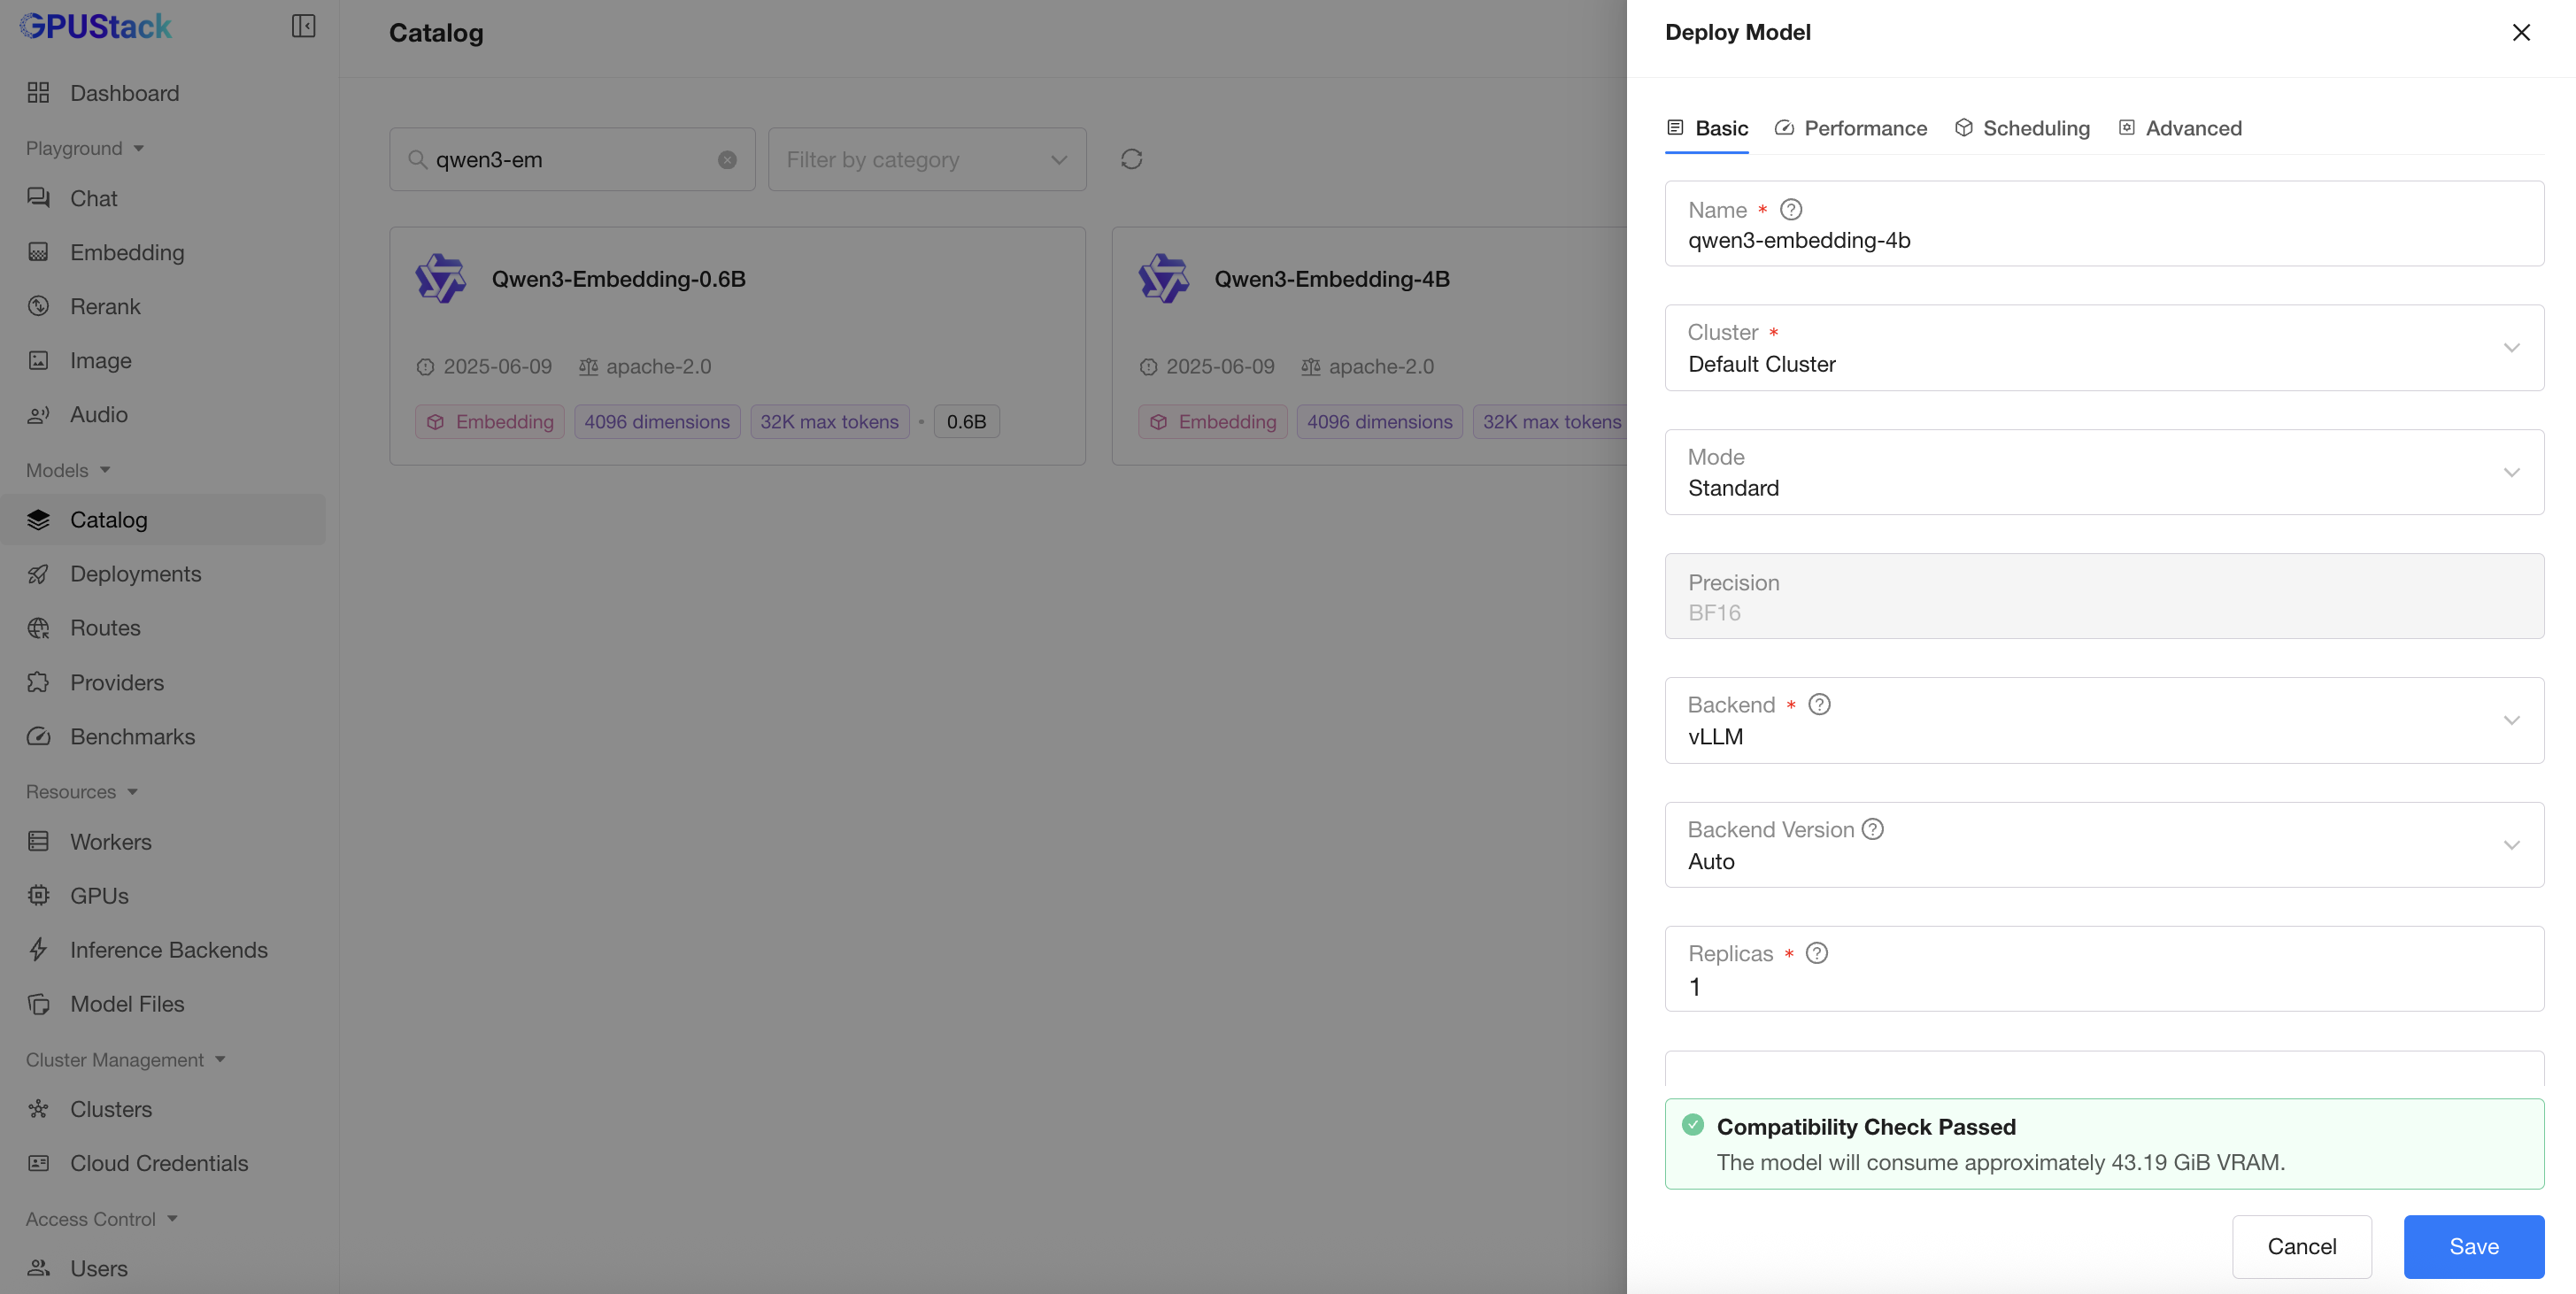
GPUStack 已安装并运行;如未完成,请参考快速入门 。 可以访问 Hugging Face,以下载模型文件。 步骤 1:部署模型 按以下步骤从 Catalog 部署模型:
在 GPUStack 界面中打开 Catalog 页面。 在模型列表中通过下拉菜单选择 Embedding 筛选模型。 查看模型说明、最大上下文长度和支持的规格。
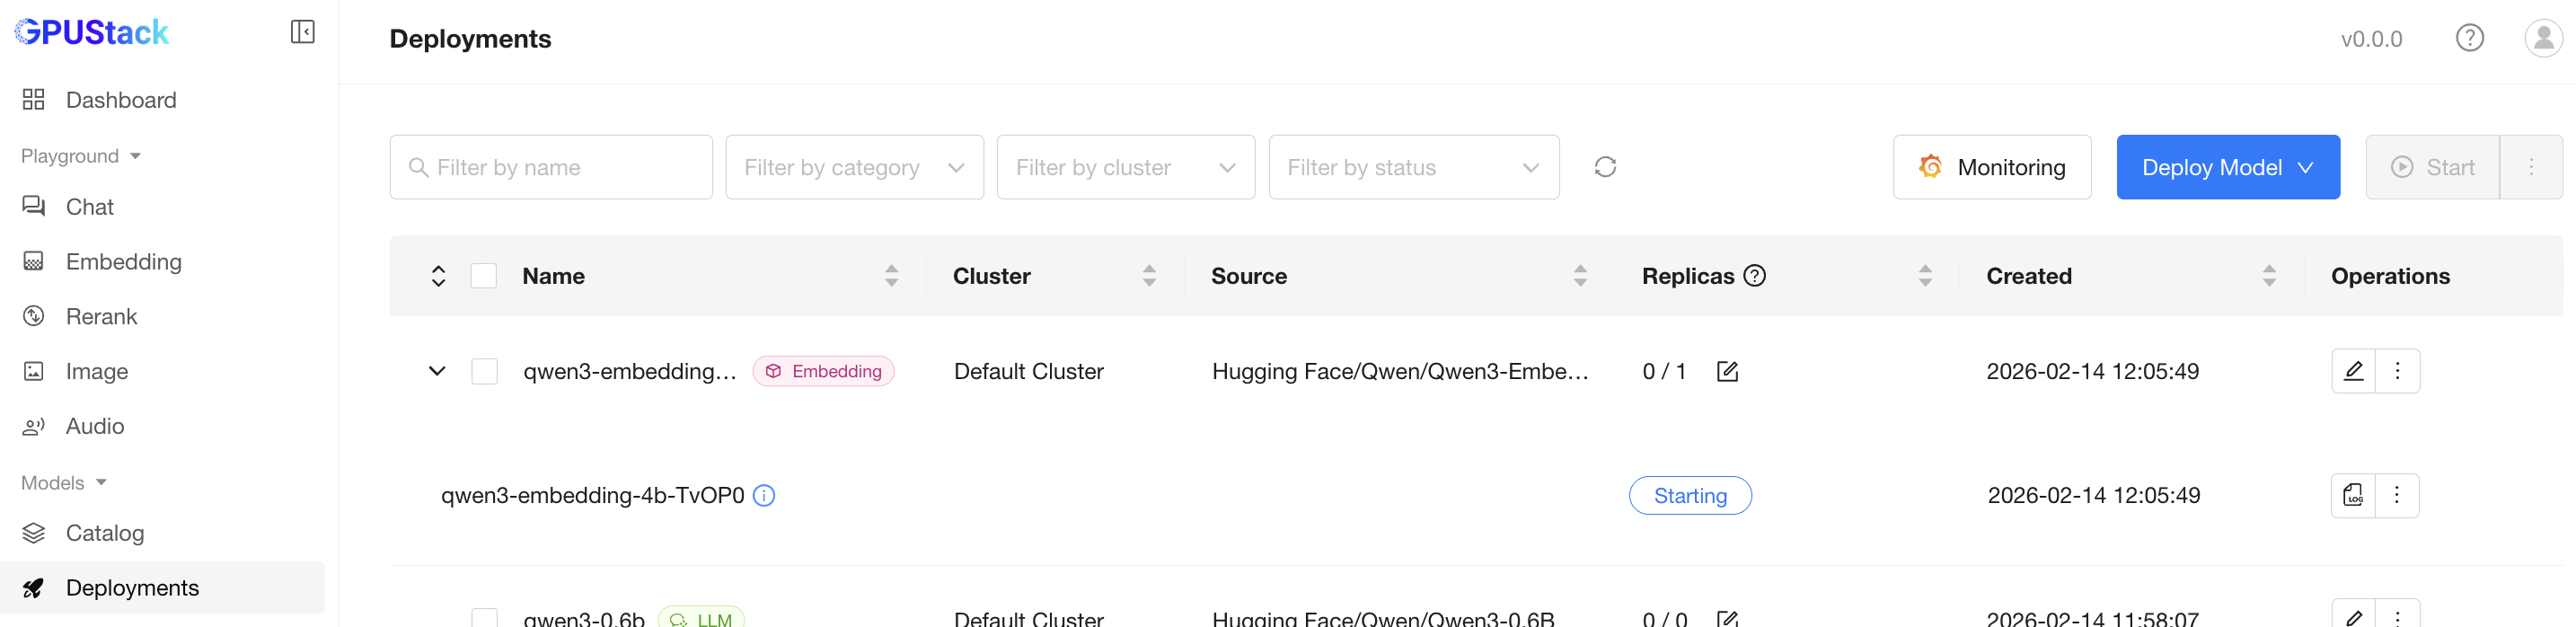
部署后,可在 Deployments 页面查看模型部署状态。
步骤 2:生成 API 密钥 调用 GPUStack API 生成文本向量需要 API 密钥:
打开 Access Control > API Keys 页面。 点击 New API Key。 输入密钥名称并点击 Save。 复制生成的 API 密钥。密钥只能查看一次,请妥善保存。 步骤 3:生成文本向量 部署模型并取得 API 密钥后,即可通过 GPUStack API 生成文本向量。以下是使用 curl 的示例:
export SERVER_URL = <your-server-url>
export GPUSTACK_API_KEY = <your-api-key>
$SERVER_URL /v1/embeddings \
"Content-Type: application/json" \
"Authorization: Bearer ${ GPUSTACK_API_KEY } " \
'{
"model": "qwen3-embedding-4b",
"input": "The food was delicious and the waiter...",
"encoding_format": "float"
}'
将 <your-server-url> 替换为 GPUStack Server 的 URL,将 <your-api-key> 替换为上一步生成的 API 密钥。
响应示例:
{
"data" : [
{
"embedding" : [
-0.012189436703920364 , 0.016934078186750412 , 0.003965042531490326 ,
-0.03453584015369415 , -0.07623119652271271 , -0.007116147316992283 ,
0.11278388649225235 , 0.019714849069714546 , 0.010370955802500248 ,
-0.04219457507133484 , -0.029902394860982895 , 0.01122555136680603 ,
0.022912170737981796 , 0.031186765059828758 , 0.006303929258137941 ,
# ... addi t io nal values
],
"index" : 0 ,
"object" : "embedding"
}
],
"model" : "qwen3-embedding-4b" ,
"object" : "list" ,
"usage" : {
"prompt_tokens" : 9 ,
"total_tokens" : 9 ,
"completion_tokens" : 0 ,
"prompt_tokens_details" : null
}
}