GPU 服务实例
GPU 服务实例让你能在几分钟内启动可通过 SSH 访问的 GPU 实例。
它提供类似虚拟机的环境,包含单块或多块设备,可用于学习、推理、测试和微调等任务。
底层每个 GPU 服务实例都由 Kubernetes Pod 支撑,因此混合使用 GPU 实例和纯 CPU 实例,有助于提高整台机器(虚拟机或裸金属)的资源利用率。
GPUStack 可管理多个 Kubernetes 集群,并提供统一界面,在其中任意集群上启动 GPU 服务实例。
从 GPUStack 2.2 升级?
GPUStack 2.3 搭载最新 GPUStack Operator,可自行完成原地升级的状态收敛:Worker Deployment 采用替换而非重叠运行的方式(Recreate),Worker 的启动时间预算为 900s,并会接管 v0.5.x 遗留的按应用划分的 Helm release。
升级后的 Worker 状态正常后,请使用 Operator 的清理脚本移除孤立的 v0.5.x 调度对象:
如果之前的升级尝试已陷入卡死状态(Kueue CRD 一直处于 Terminating,Worker 始终无法变为 Ready),参见 Operator 的迁移故障排查。完整流程参见 Operator 的迁移指南。
前提条件
要使用 GPU 服务实例,至少需要一个 Kubernetes 集群。
尚未添加集群时,首次打开 GPU Service > GPU Instances 页面会提示添加集群。
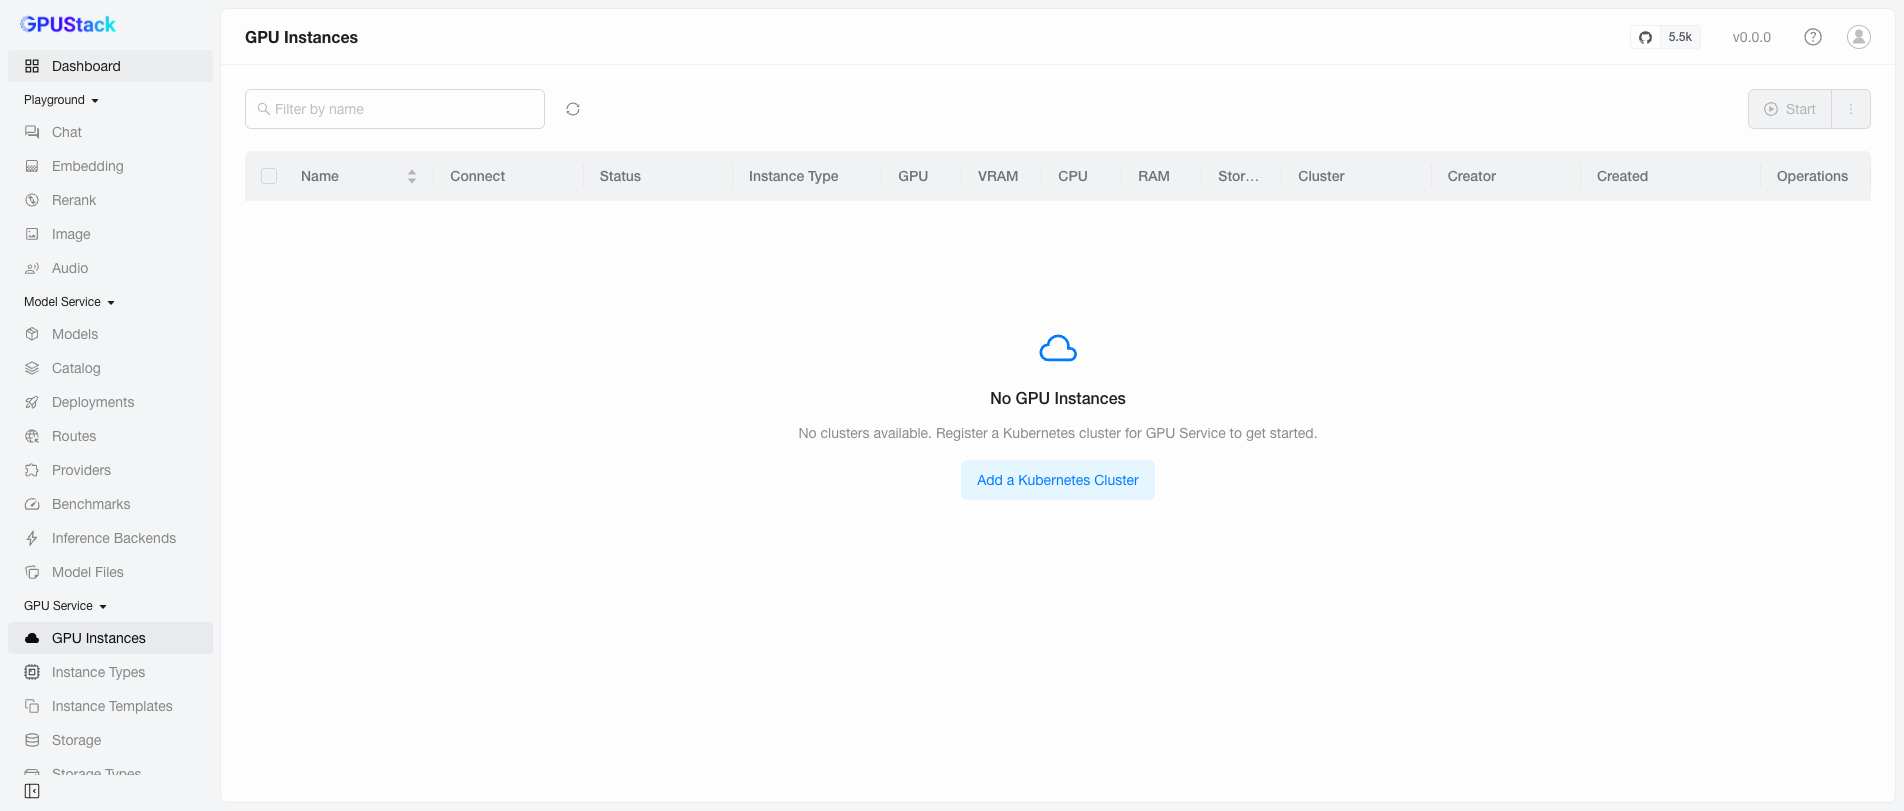
单击 Add a Kubernetes Cluster 进入 Resources > Clusters 页面。
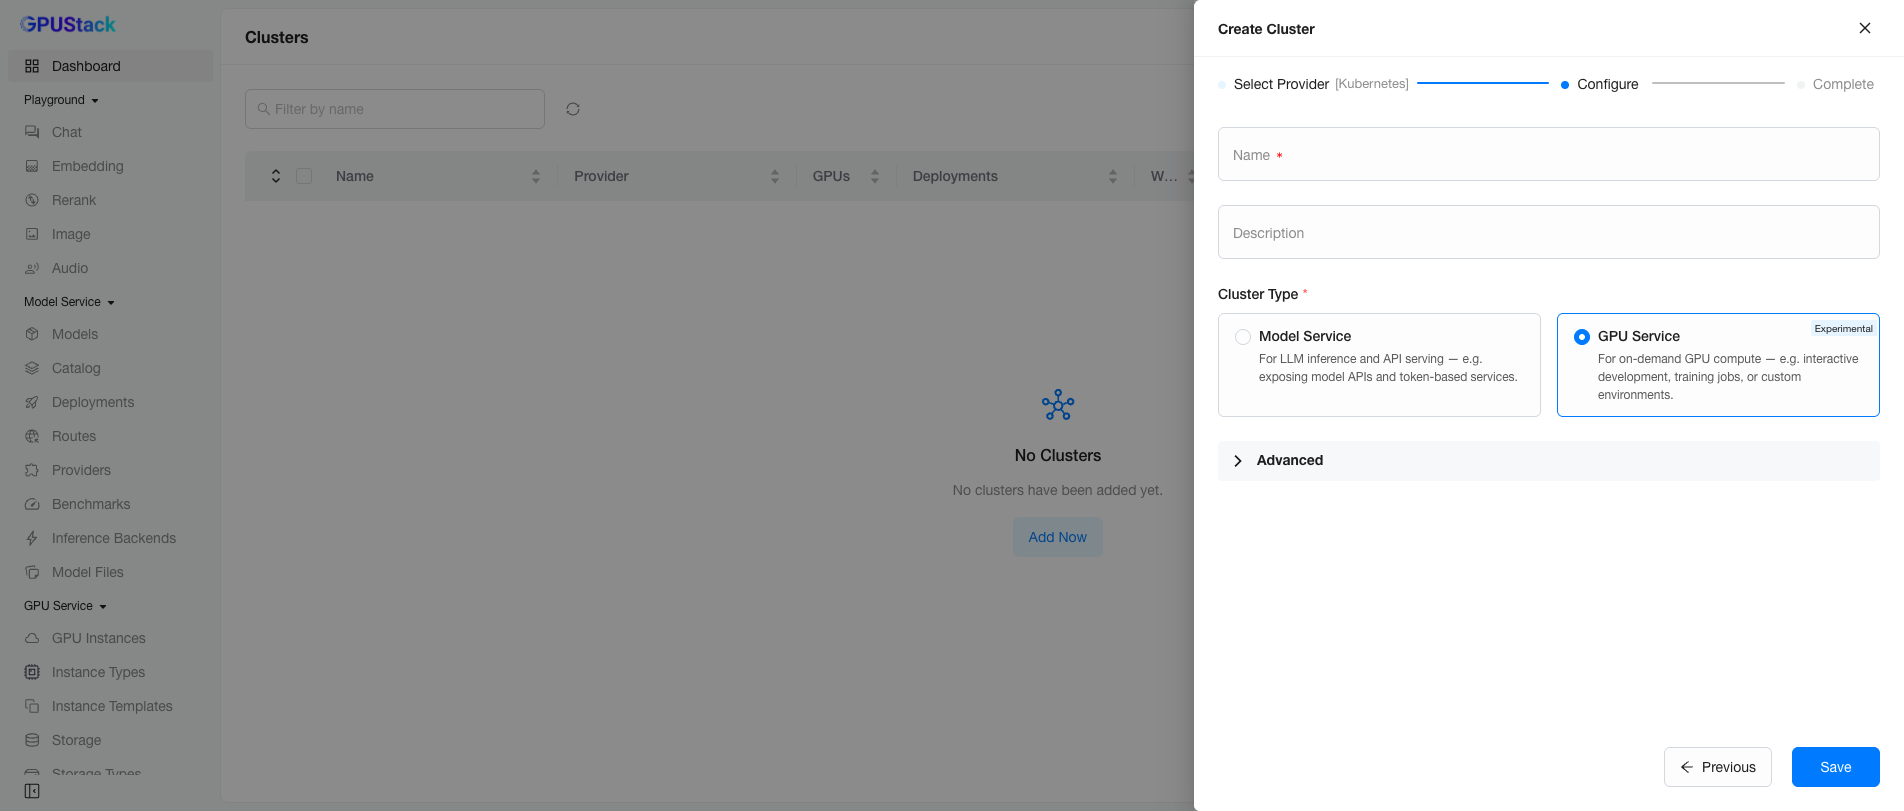
创建集群向导依次经过 Select Provider(选择 Kubernetes)→ Configure → Complete。在 Configure 步骤中填写集群 Name 和可选的 Description,将 Cluster Type 选择为 GPU Service,然后单击 Save。
警告
一个 Kubernetes 集群只能用于一种用途:Model Service 或 GPU Service。
高级选项
添加用于 GPU Service 的集群时,展开 Advanced 选项可以配置更多设置。
从节点派生实例类型
默认启用。Operator 会发现各节点的设备,按产品预设的单位 CPU/RAM 自动派生匹配的实例类型:每种加速器型号一个类型,另加一个纯 CPU 类型。如果希望自行定义每个实例类型,请设置为 Disabled;Operator 随后会停止创建类型,已有派生类型也可以永久删除。

派生类型的管理方法参见 GPU 服务实例类型。
允许节点混用实例类型
默认启用。它允许节点同时提供不同的实例类型,例如 GPU 节点可以同时承载 GPU 实例和纯 CPU 实例。设置为 Disabled 后,每个节点将专用于单一实例类型。

允许访问 GPU 服务实例
Kubernetes 节点通常位于 NAT 或防火墙之后,因此节点 IP 可能无法从集群外访问:
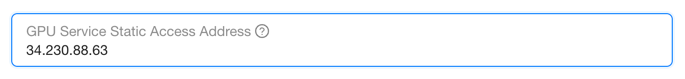
此时,请在 GPU Service Static Access Address 中设置地址(例如 LoadBalancer VIP),使 GPU 服务实例能够被访问。
确保 GPUStack Worker 可达
大多数情况下,GPU 服务需要(反向)访问 Kubernetes 集群,才能创建、删除和监控实例。
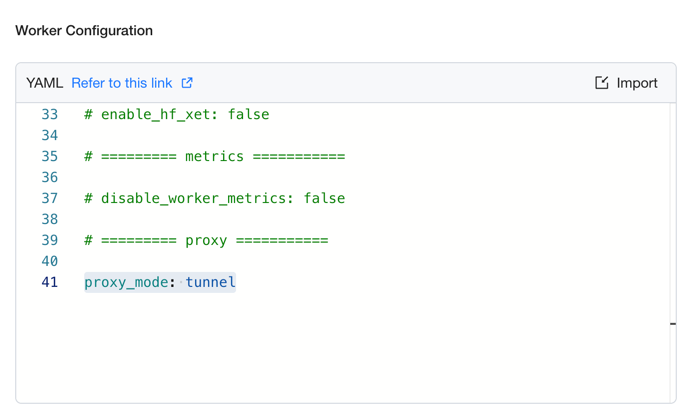
如果 GPUStack Server 部署在 Kubernetes 集群之外,请在 Worker Configuration 中设置 proxy_mode=tunnel,启用 GPUStack Worker 的 Tunnel 模式。该模式会保持从 Worker 到 GPUStack Server 的长连接,并为 GPU 服务提供访问集群的隧道。
可以在 Resources > Workers 页面查看 Worker 的 Status 列,验证 GPUStack Server 与 Worker 之间的连接。
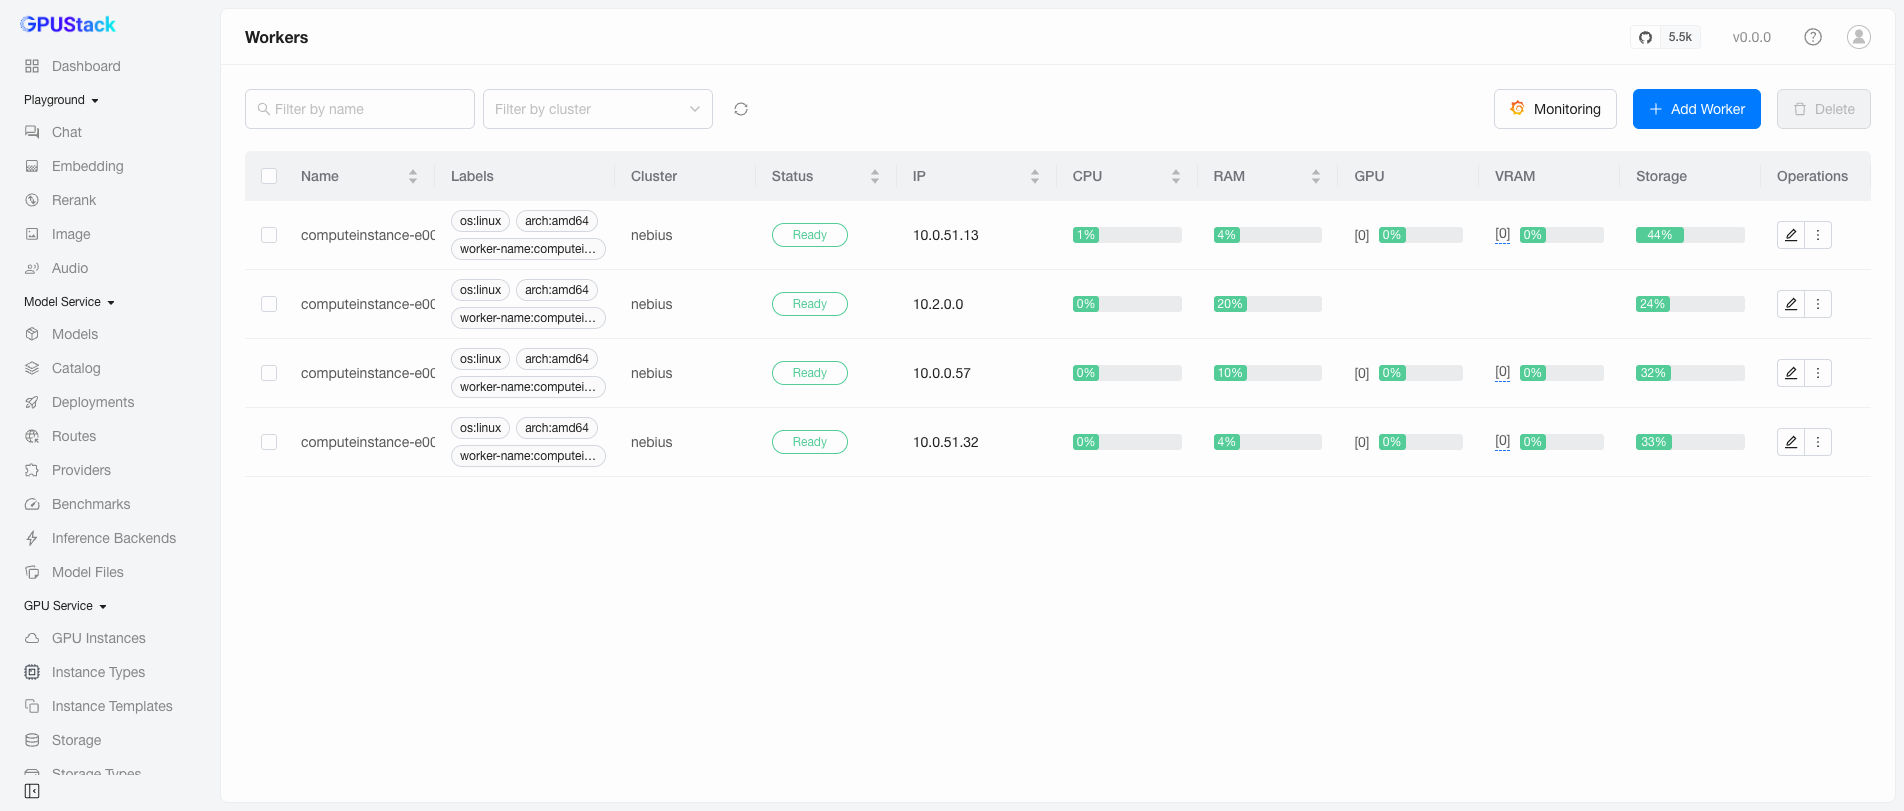
自动发现实例类型
添加启用 GPU Service 的 Kubernetes 集群后,GPUStack Operator 会自动发现集群中的 GPU 设备,收集其信息,并生成相应的 GPU 服务实例类型。
实例类型管理参见 GPU 服务实例类型。本页其余部分介绍实例的部署和管理。
添加实例
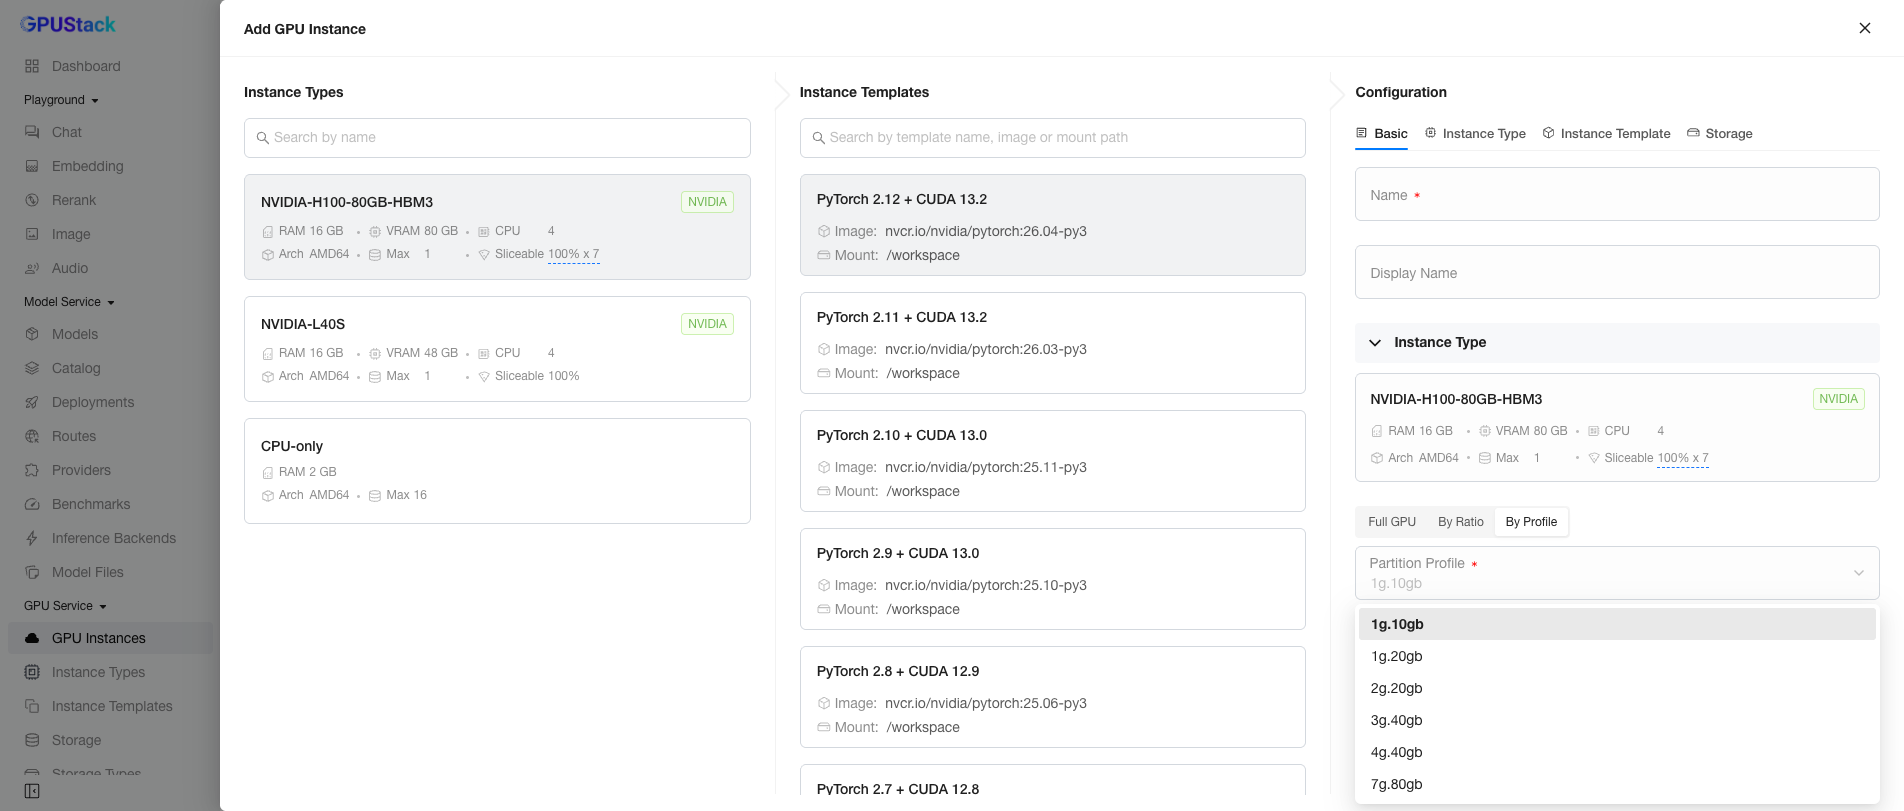
在 GPU Service > GPU Instances 页面,单击 Add GPU Instance 打开创建表单。
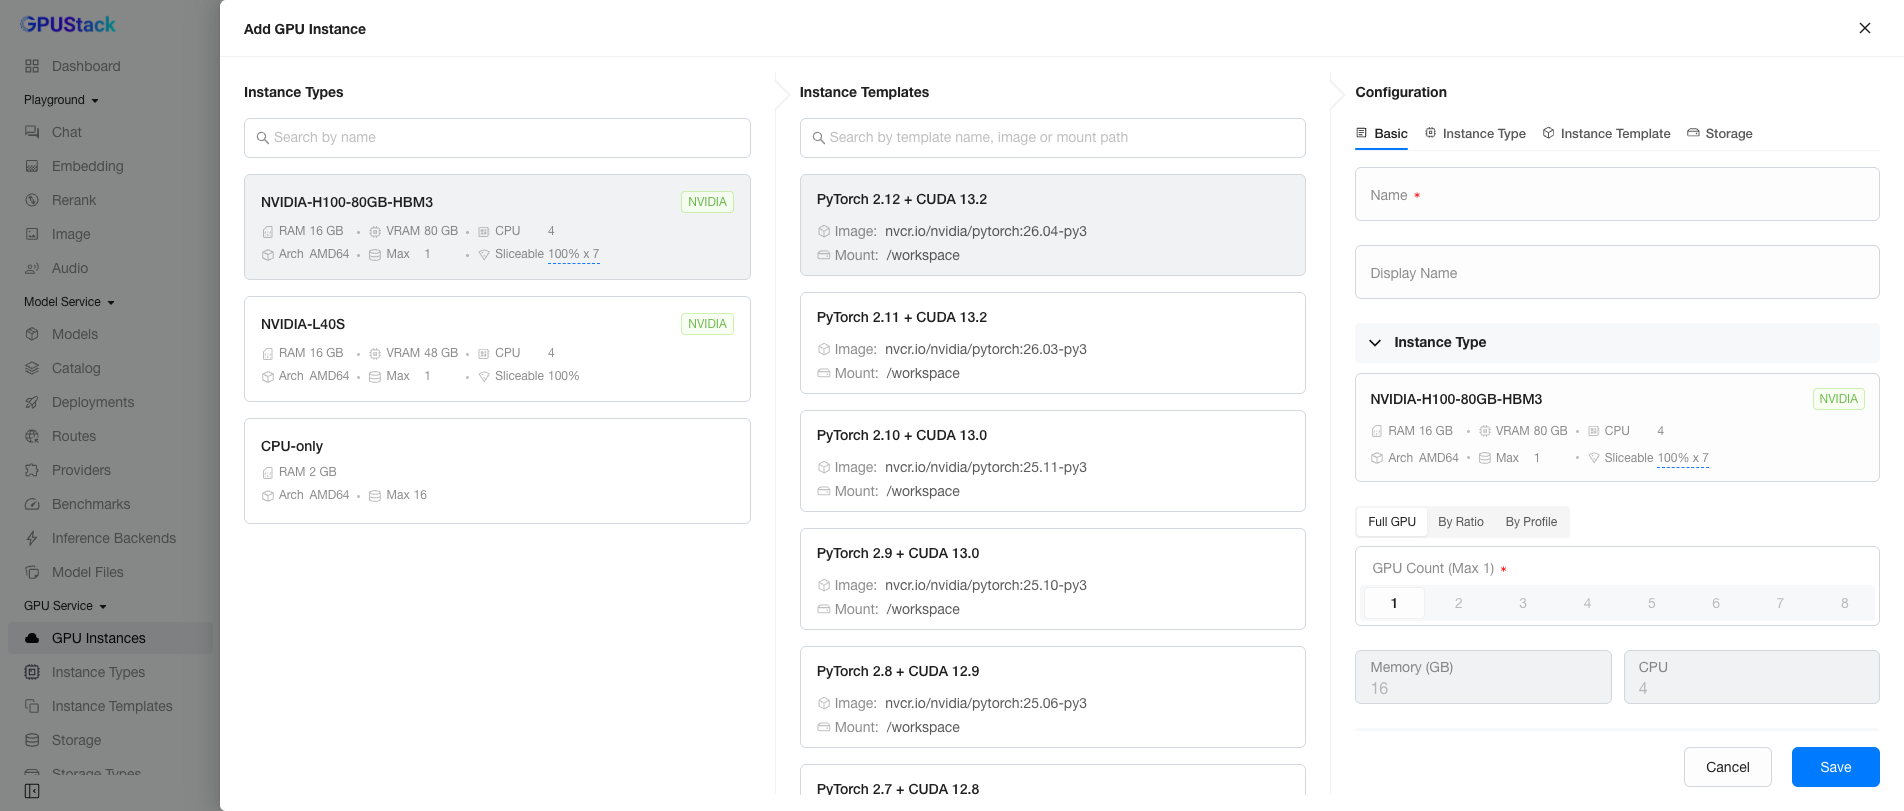
选择实例类型
最左侧的 Instance Types 列显示从 Kubernetes 集群发现的所有实例类型。
每张实例类型卡片包含以下信息:
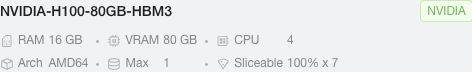
- Name:实例类型的产品名称,例如
NVIDIA-H100-80GB-HBM3。包含特殊字符的产品名称会被转换为符合 Kubernetes 命名规则的形式。 - Manufacturer/Vendor:右上角显示厂商标签,例如
NVIDIA,或纯 CPU 类型的GENERIC。 - RAM/VRAM/CPU:该类型每单位分配的主机 RAM、设备内存容量和 CPU 核数。
- Arch:CPU 架构,例如
AMD64或ARM64,用于选择兼容镜像。 - Max:一次最多可选择的设备数量。Max 为 0 时,表示该实例类型的所有设备都已分配,释放部分设备前无法选择。
- Sliceable:该类型设备的拆分方式,包括逻辑切片配额(百分比),以及支持分区的设备上仍可用的硬件分区数量。
实例类型的单位资源
单位资源指该类型每单位分配的主机 CPU 和 RAM;对于加速器类型,一单位指一块完整设备。从节点派生的类型使用 Operator 维护的各产品预设资源大小(参见单位资源参考);逻辑切片或物理分区再按其 VRAM 占比从预设中计算资源。也可以定义自己的类型,使用自定义单位资源。
选择完整设备、逻辑切片或物理分区
对于加速器类型,Configuration 面板最多提供三种分配模式:
- Full GPU——独占使用完整设备。
- By Ratio——逻辑切片:选择
VRAM Percentage和Compute Percentage。设备保持完整,同时提供其他切片,各配额在运行时强制执行。
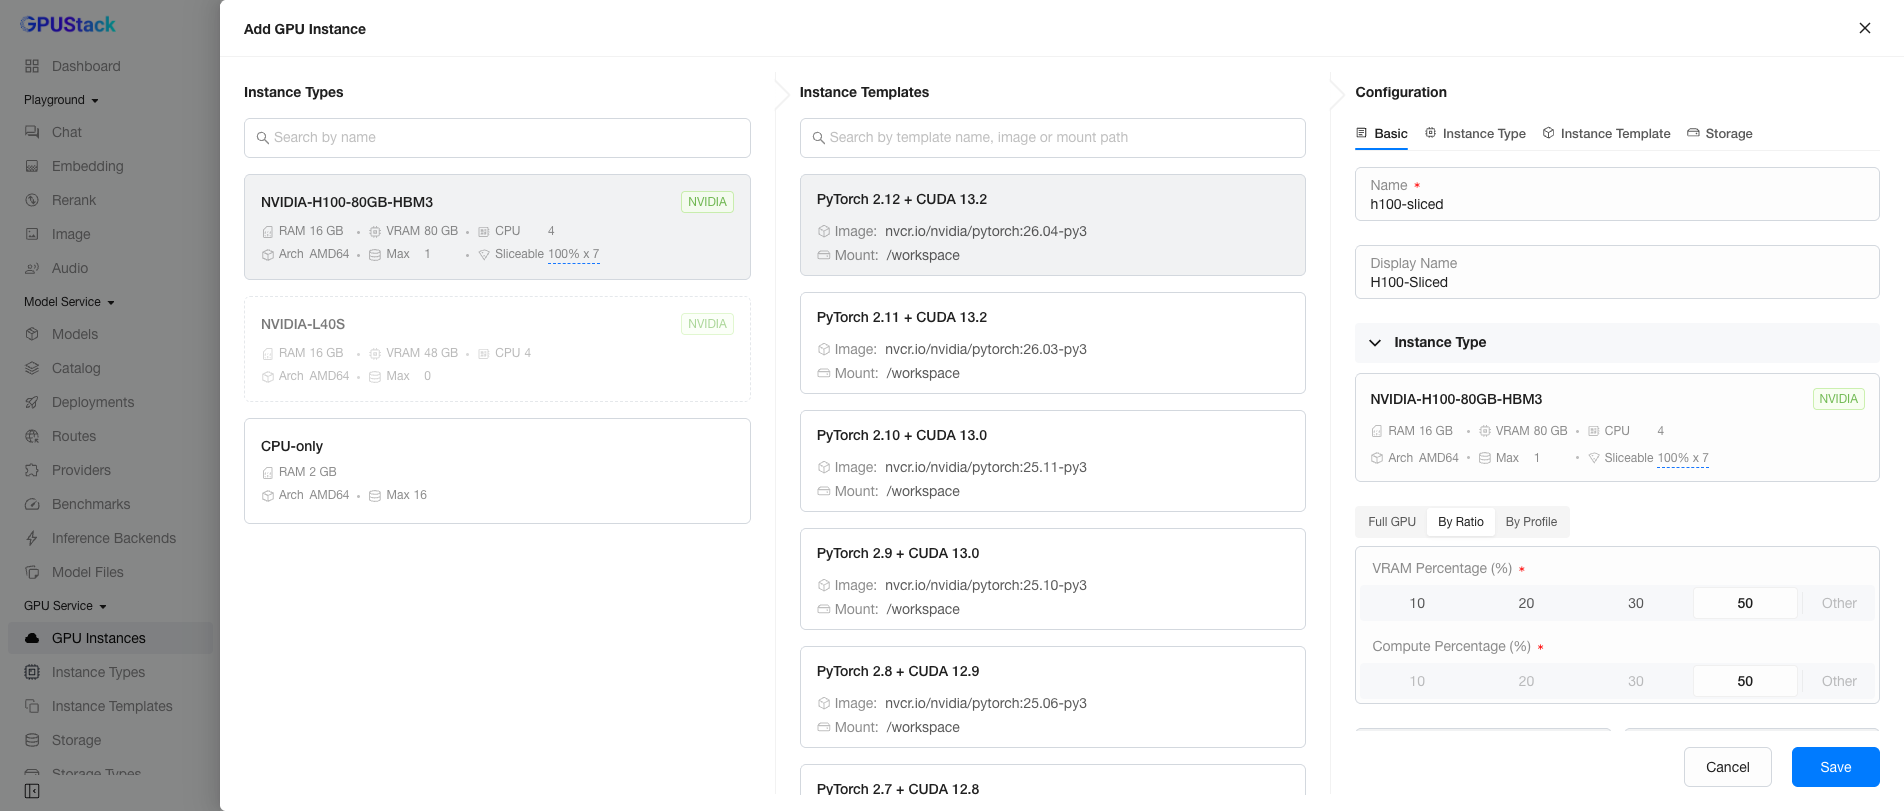
- By Profile——从已启用 MIG 的设备中分配物理分区:选择
Partition Profile(例如 H100 上的1g.10gb)。Operator 会为你创建 MIG 实例。仅当集群中有节点启用 MIG 时,此选项卡才会出现;启用 MIG 是管理员按节点执行的操作,参见 GPU 服务实例类型。
纯 CPU 实例类型
为提高整体资源利用率,GPU 服务也支持纯 CPU 实例类型。
初始情况下,GPUStack Operator 为纯 CPU 实例类型提供固定规格:1 CPU + 2 GB RAM。自定义方法参见 GPU 服务实例类型。
选择实例模板
中间的 Instance Templates 列显示可用模板,选择不同实例类型时,列表会随之更新。
模板在 GPU Service > Instance Templates 页面管理,参见 GPU 服务实例模板。
实例配置
最右侧的 Configuration 表单用于设置新实例的详细信息,分为五个部分:Basic、Instance Type、Instance Template、Storage 和 SSH Access。
- Basic:实例名称和显示名称。
- Instance Type:实例类型和分配模式,即完整设备、逻辑切片或物理分区。
- Instance Template:要继承的模板(镜像、命令、环境变量等)。选择模板后仍可调整配置。
- Storage:选择
Ephemeral存储或Persistent存储。 - SSH Access:分配给实例的 SSH 公钥,或禁用 SSH 访问。
填写表单后,单击 Save 创建实例。
浏览实例
创建后会返回 GPU Service > GPU Instances 页面,列出所有实例。列包括 Name(如设置显示名称则显示它)、Connect、Status、Instance Type、GPU、VRAM、CPU、RAM、Storage、Cluster、Creator、Created 和 Operations。
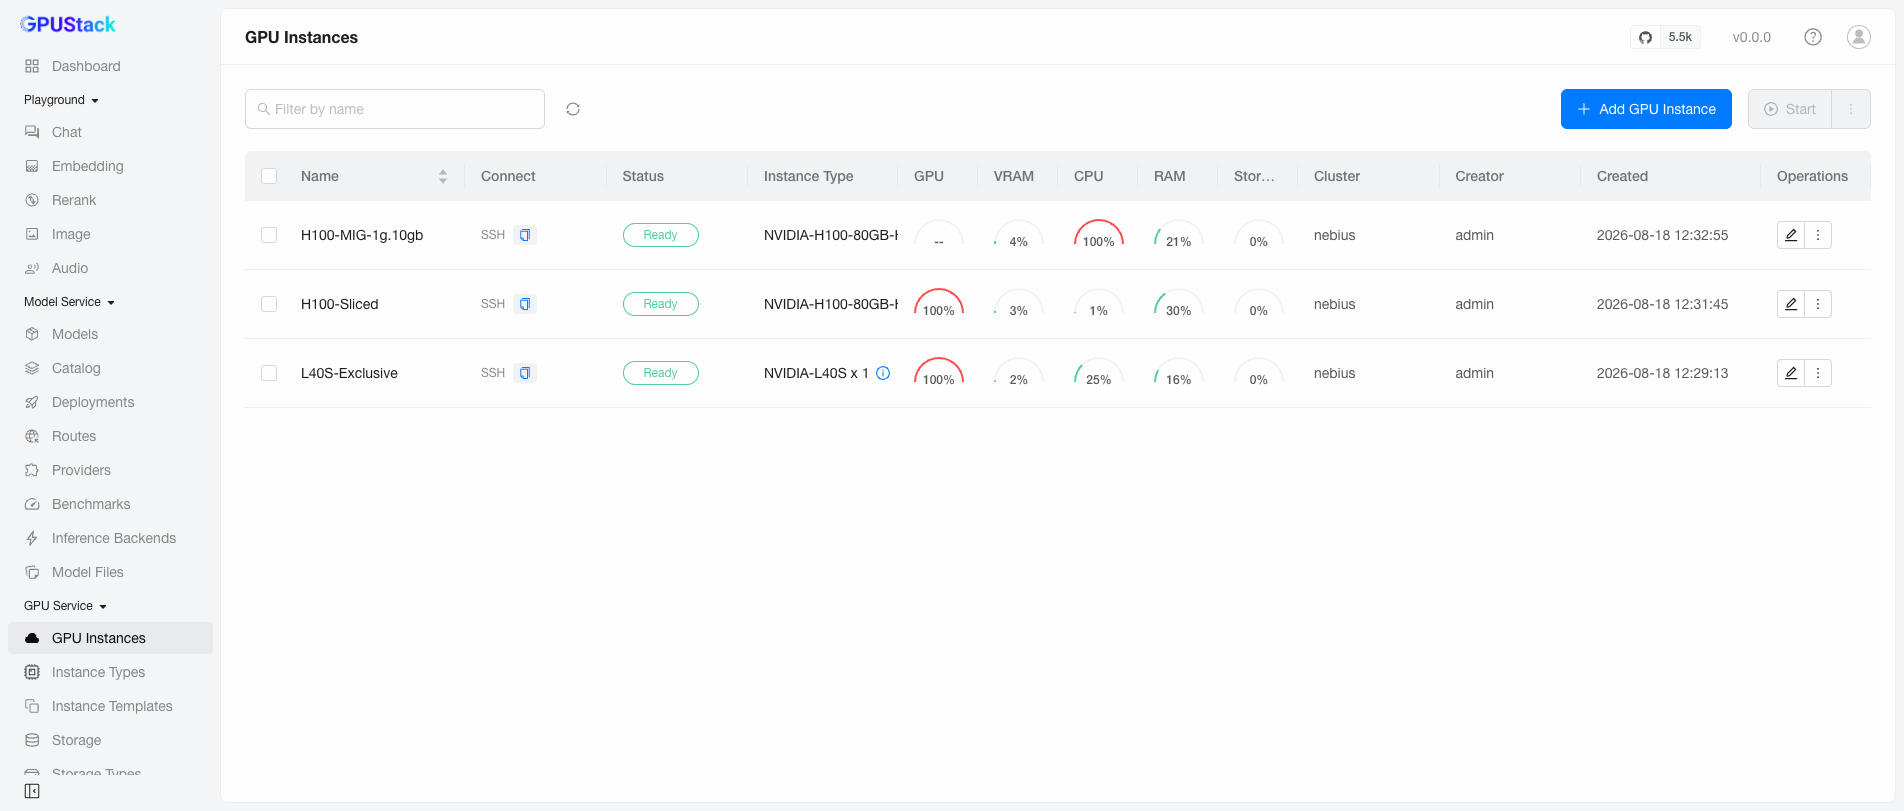
可以按显示名称或名称筛选实例,即 Name 列可能显示的任意一个值。对 Name 列排序时,按实际显示的标签排序。
访问实例
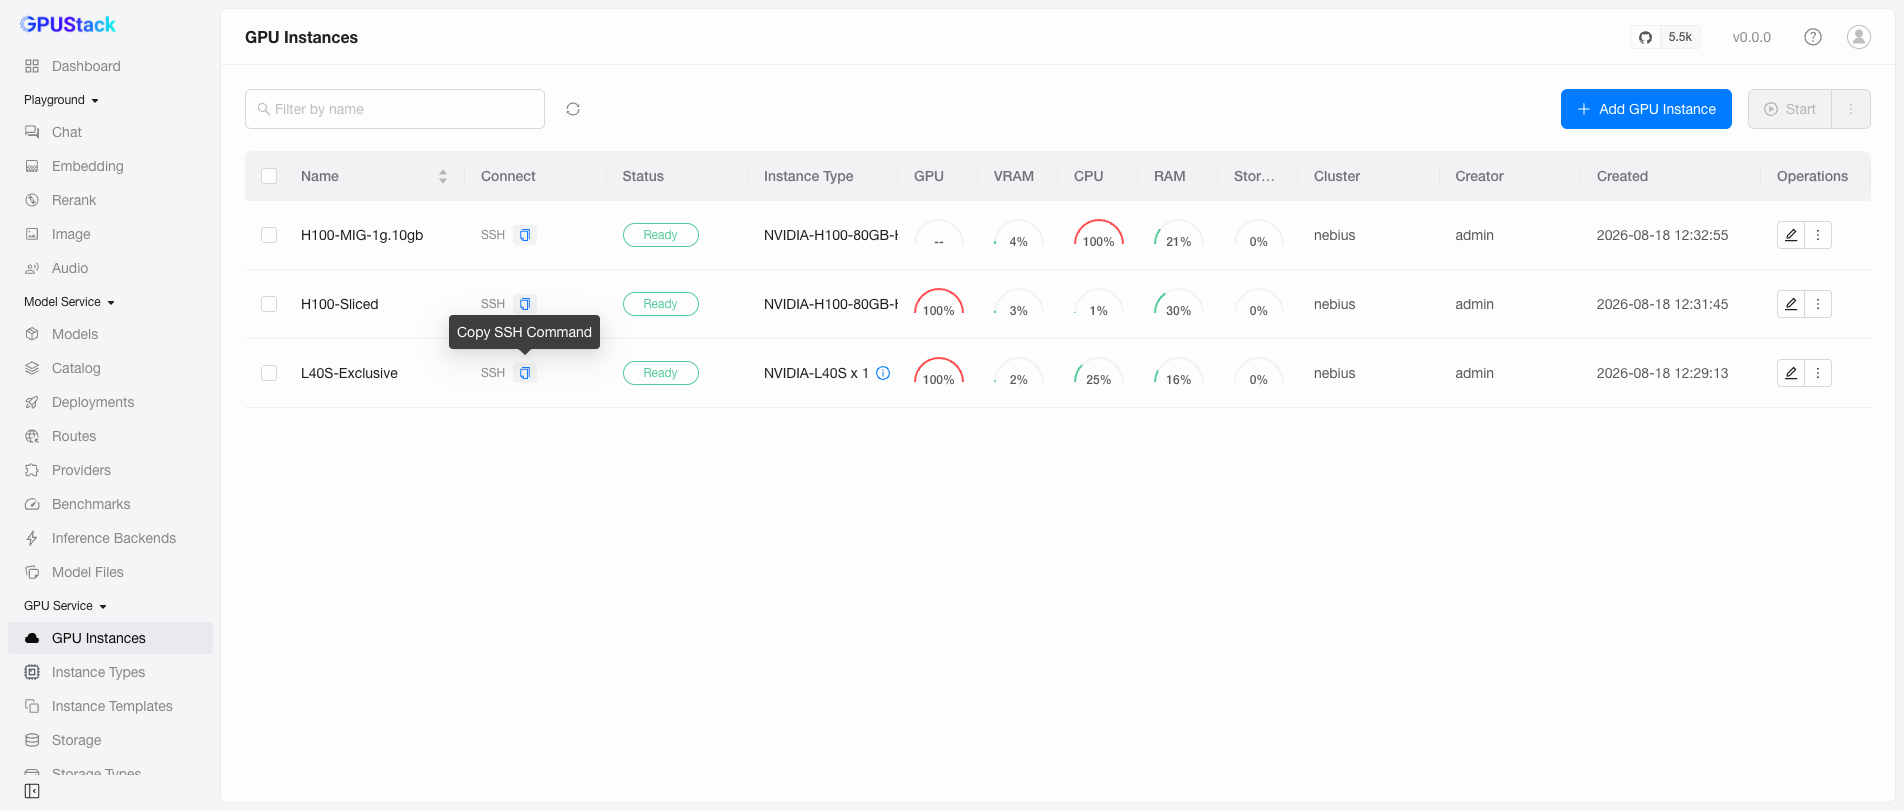
Connect 列根据实例的端口配置显示访问地址,可以是可复制粘贴的 SSH 命令,和/或可单击访问 Web 页面的链接。
例如,将 SSH 命令粘贴到终端,即可直接连接实例。
指标
GPU、VRAM、CPU、RAM 和 Storage 列显示每个运行中实例的实时利用率仪表,页面可见时每隔几秒刷新一次。无论采用哪种分配模式,仪表显示的都是实例自身用量相对于自身配额的比例:独占实例读取完整设备,切片读取分配给它的份额,物理分区读取该分区自身的容量。
无法测量的指标显示为空,而不是零。例如,MIG 分区不报告 GPU 核心利用率(驱动无法测量),因此其 GPU 仪表显示 --,而 VRAM 仪表仍正常工作。
这些数值来自 Operator 的实例指标子资源和 node exporter;各字段、来源及限制参见实例指标参考。
关于上方的仪表
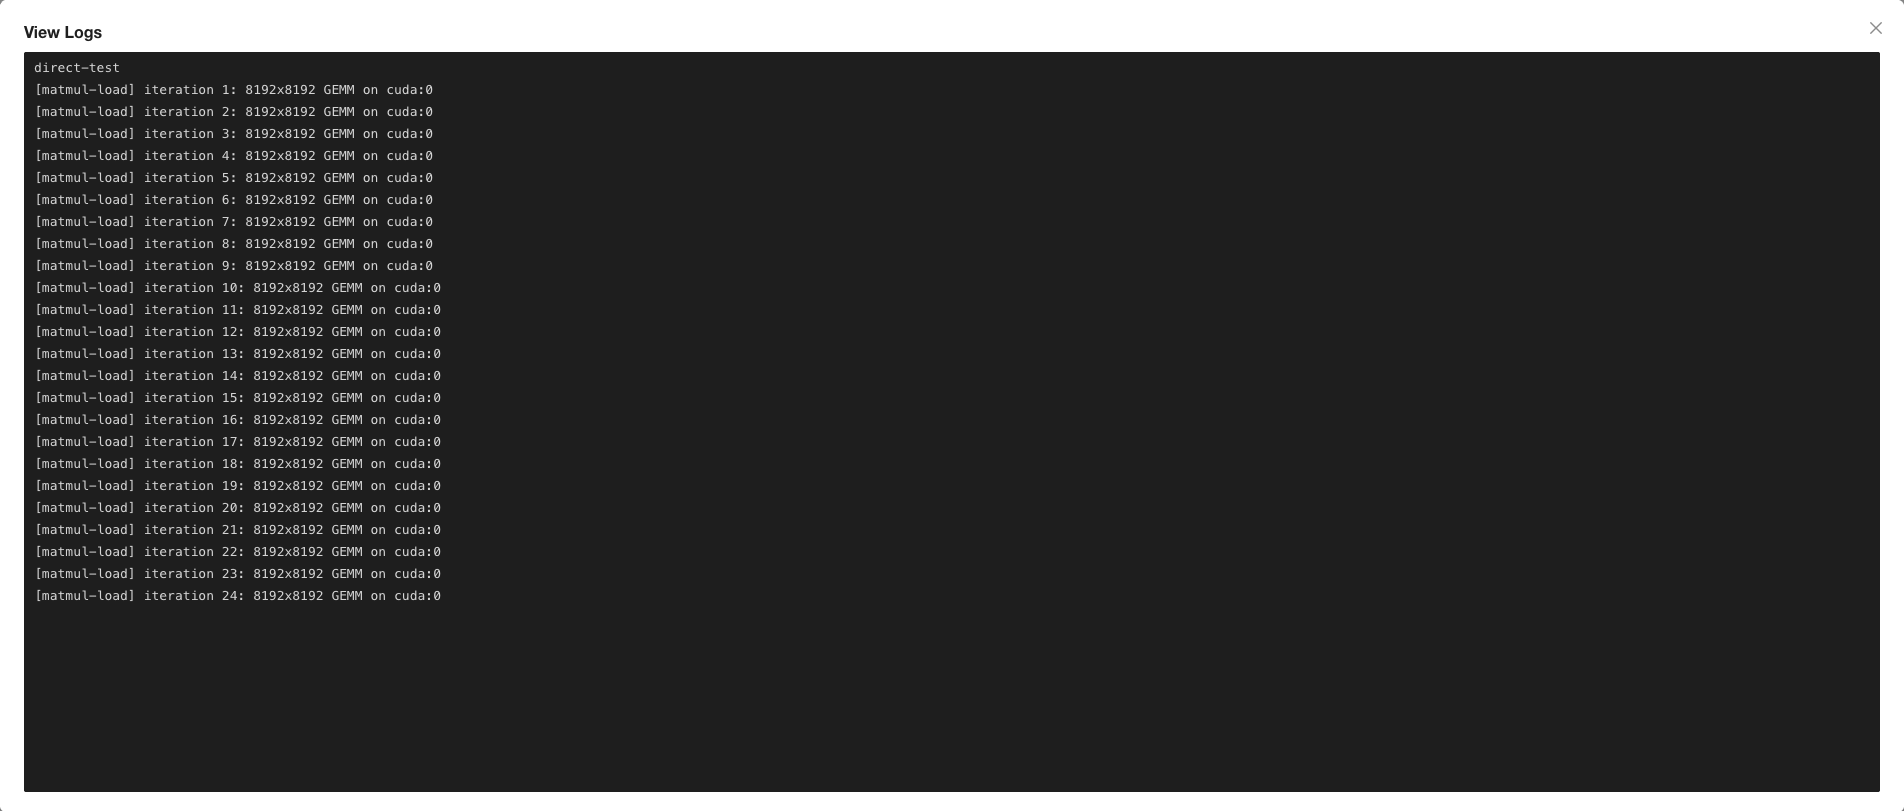
列表截图中的三个演示实例处于人工负载之下:每个实例都运行 Python/PyTorch 循环,分配主机 RAM,并在设备上重复执行 8192×8192 矩阵乘法(循环执行 a = a @ a)。因此,独占 L40S 和 50% 切片 H100 的 GPU 仪表都显示 100%(切片用满自身计算配额时显示 100%),而 MIG 实例的 GPU 仪表显示 --,CPU 显示 100%。
编辑实例
单击实例上的 Edit 打开配置。
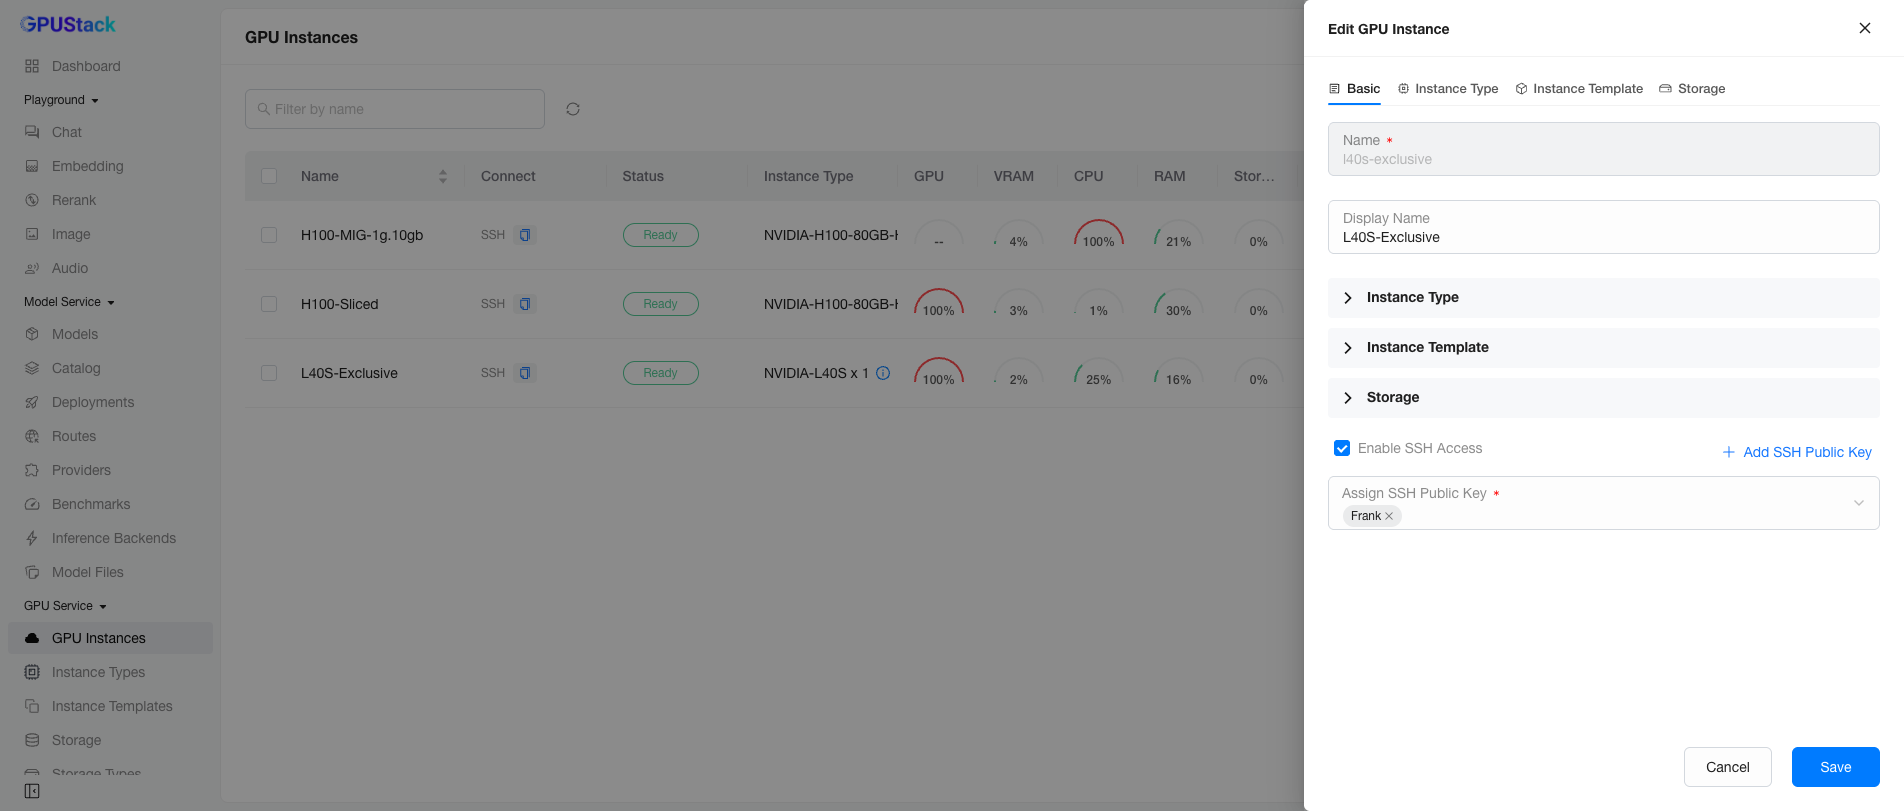
目前大部分字段不可编辑,只能修改显示名称和 SSH 访问配置。你可以添加或移除 SSH 公钥,也可以禁用 SSH 访问。
说明
后续版本计划支持编辑更多实例配置。
实例操作
GPU 服务提供查看日志、查看事件、停止/启动和删除等实例操作。
查看日志
单击 View Logs 查看实例日志,便于观察 Jupyter Notebook 或 TensorBoard 等应用的输出。
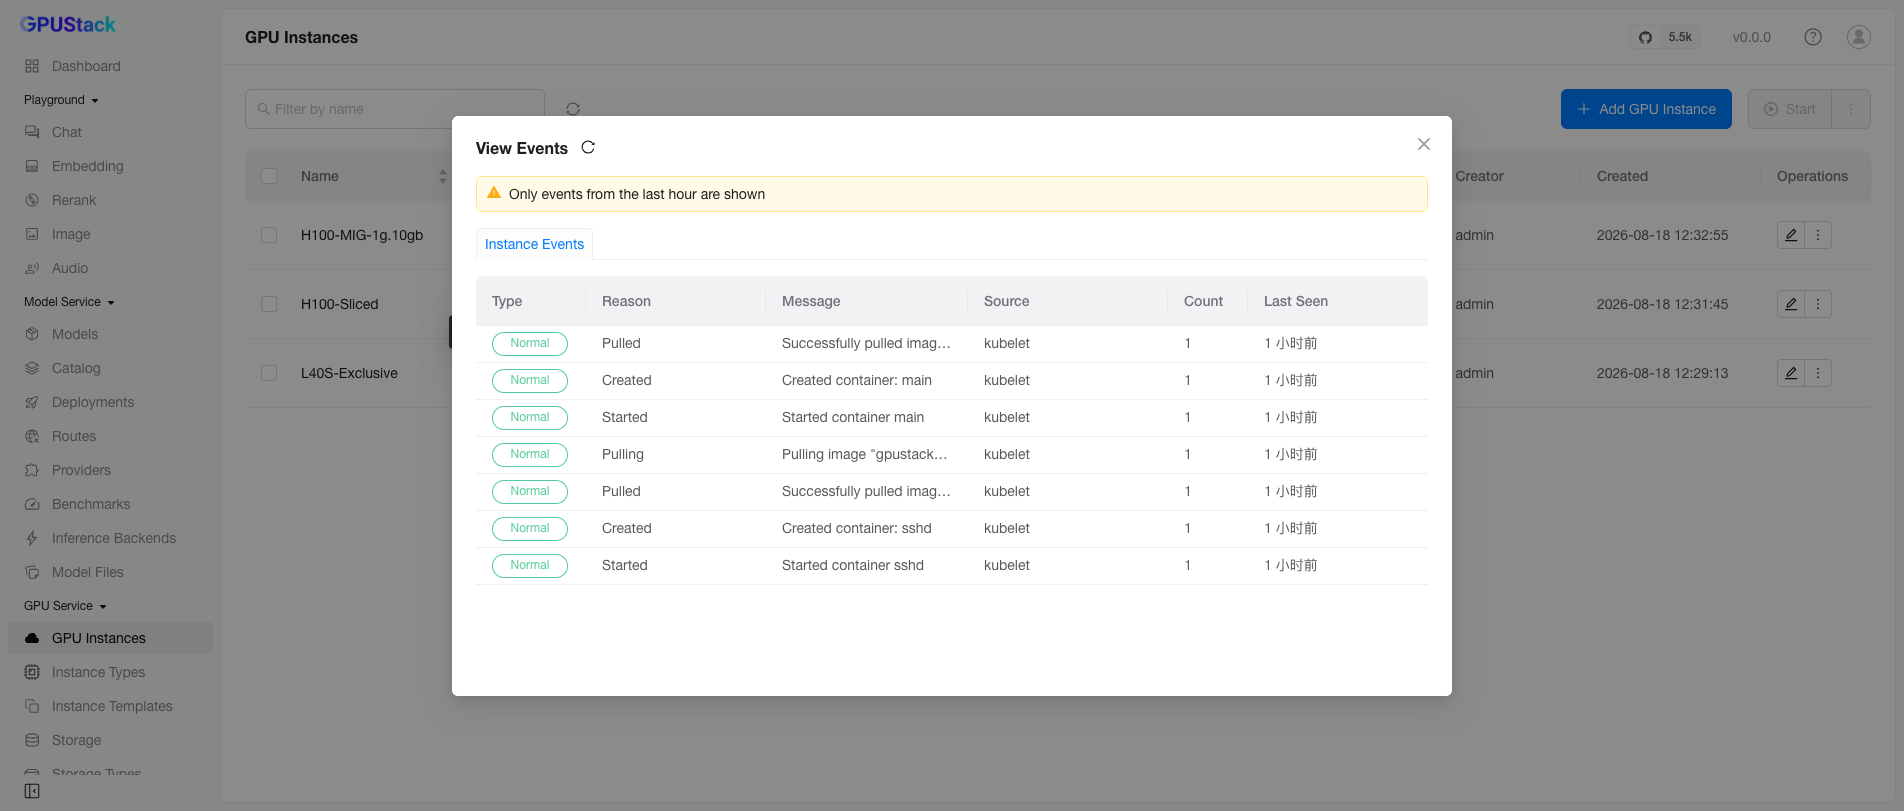
查看事件
单击 View Events 查看实例事件,帮助追踪状态变化,例如实例停留在 Pending、Running 或 Failed 状态。
停止/启动/删除
单击 Stop 停止实例,单击 Start 重新启动,可用于临时释放资源并在稍后继续工作。
警告
停止实例会释放其计算资源,重新启动时会重新创建实例。实例将分配到新的 IP 地址,临时存储中的所有数据都会丢失。
单击 Delete 删除实例并释放其全部资源。