使用 LoRA 适配器提供模型服务
LoRA(Low-Rank Adaptation)是一种参数高效的微调方法,通过加载较小的适配器文件,让基础模型适应特定领域,无需重新训练全部权重。
GPUStack 支持在已部署的基础 LLM 上挂载多个 LoRA 适配器,并为每个适配器自动创建一个 Model Route。调用方将 OpenAI 兼容请求的 model 字段设为对应路由名称,即可按请求切换适配器,无需为每个微调模型独占一张 GPU。
本教程介绍如何在 vLLM、SGLang 或昇腾 MindIE 后端上,为同一个基础模型挂载多个 LoRA 适配器,并通过 OpenAI 兼容 API 调用指定适配器。
说明
目前只有 vLLM、SGLang 和昇腾 MindIE(Ascend MindIE)后端支持 LoRA。其他后端会忽略 lora_list 配置。
前提条件
开始前,请确认:
- GPUStack 已安装并运行。
- 有一个配备 GPU 的 Linux Worker。此处使用的基础模型是
Qwen3-8B,GPU 显存需足以运行 8B 模型,例如 24 GB 或更多。两个适配器共享该实例,仅增加少量内存开销。 - 可以访问 Hugging Face,以下载模型和适配器文件。
本教程在一个基础模型上挂载两个 LoRA 适配器,演示调用方如何按请求切换微调版本。配置如下:
| 项目 | 本教程使用的值 |
|---|---|
| 模型来源 | Hugging Face |
| 后端 | vLLM |
| 基础模型 | Qwen/Qwen3-8B |
| LoRA 适配器 1 | AMaslovskyi/qwen-devops-foundation-lora,命名为 devops |
| LoRA 适配器 2 | XinyuanWang/qwen3-8b-medical-lora,命名为 medical |
两个适配器都声明以 Qwen/Qwen3-8B 为基础模型。这是硬性要求:同一部署中挂载的所有适配器必须共享同一个基础模型。
提示
使用上述配置完成教程后,可以将来源替换为 ModelScope 或 Local Path,将后端替换为 SGLang 或昇腾 MindIE(Ascend MindIE),并使用自己的基础模型和适配器。各后端差异见后端兼容性与限制。
步骤 1:部署带 LoRA 适配器的基础模型
- 在
Deployments页面点击Deploy Model,选择Hugging Face作为来源。 - 搜索
Qwen/Qwen3-8B,从结果中选中该模型。 - 将后端设为
vLLM。 -
展开
Advanced,找到LoRA Adapters,添加第一个适配器:- 在适配器下拉菜单中输入并选择
AMaslovskyi/qwen-devops-foundation-lora。 - 在
LoRA name中输入devops。
- 在适配器下拉菜单中输入并选择
-
点击添加第二个适配器:
- 在适配器下拉菜单中输入并选择
XinyuanWang/qwen3-8b-medical-lora。 - 在
LoRA name中输入medical。
- 在适配器下拉菜单中输入并选择
-
点击
Save完成部署。
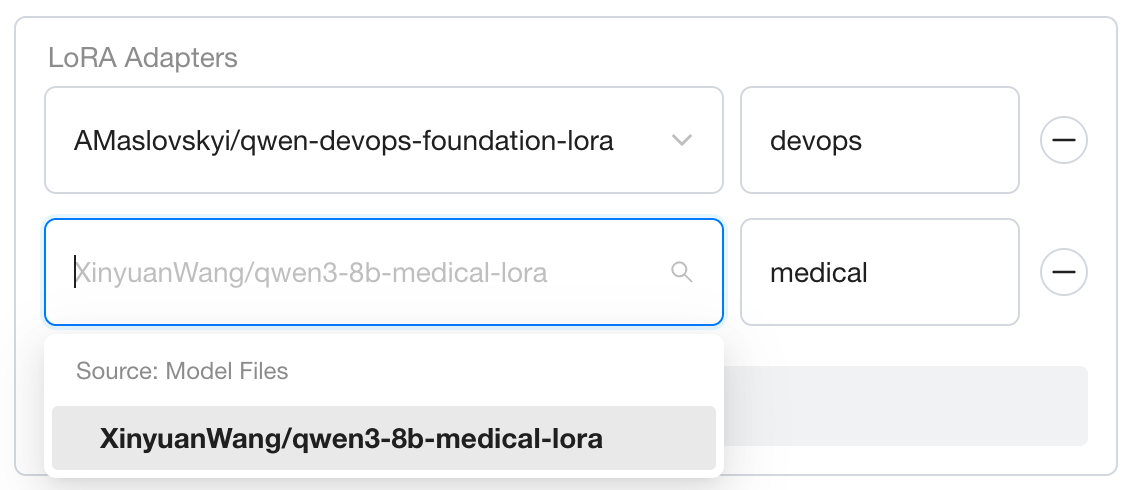
说明
只填写适配器名称 devops、medical,不要添加基础模型前缀。GPUStack 会自动生成完整标识符 qwen3-8b:devops、qwen3-8b:medical,它们也是调用各适配器时使用的 Model Route 名称,见步骤 2。
提示
每个适配器必须有不同的 LoRA name。添加更多适配器时,重复上述添加步骤即可。目标适配器未出现在下拉菜单中时,先在 Hugging Face 或 ModelScope 确认该模型确实提供 LoRA 适配器,再粘贴完整仓库 ID 进行搜索和选择。
步骤 2:调用 LoRA 适配器
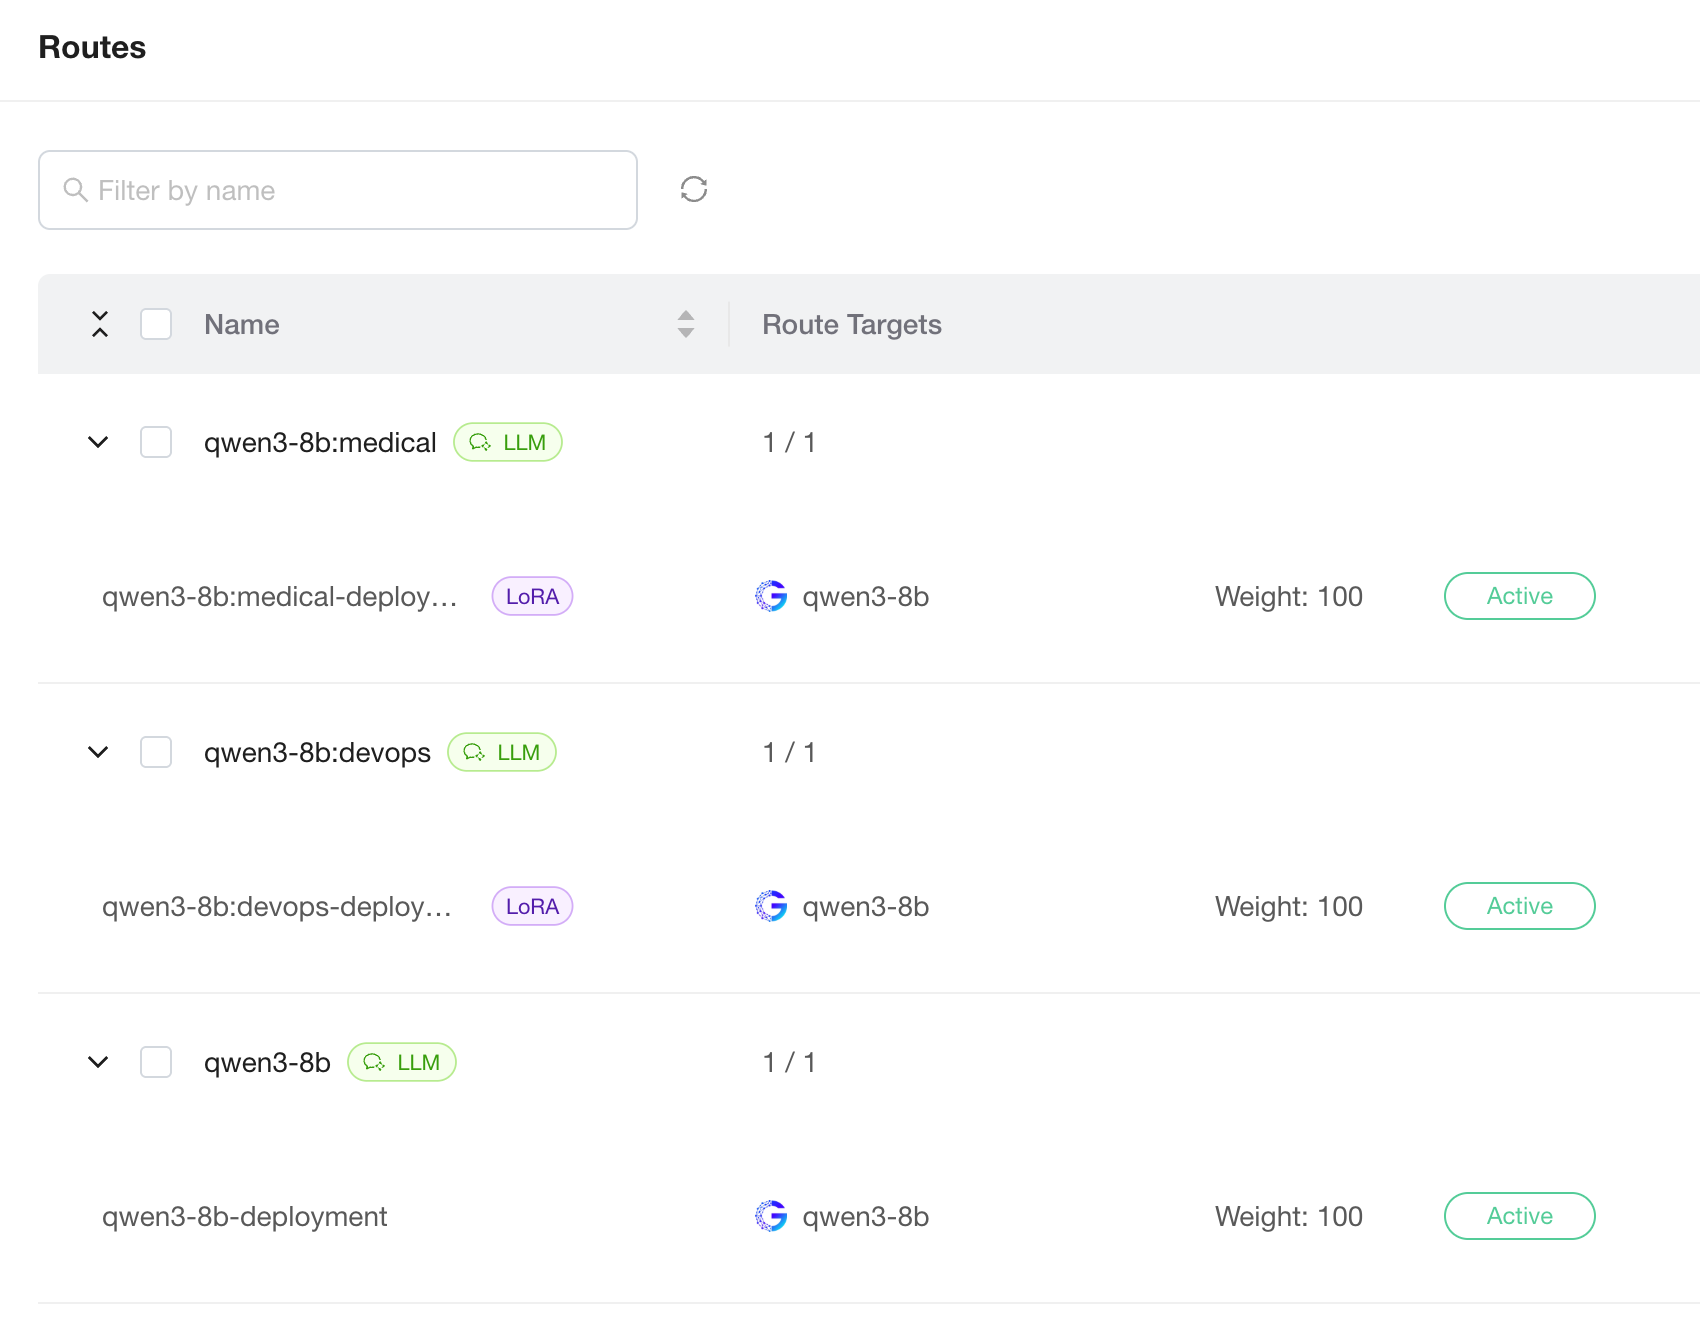
部署后,GPUStack 为每个 LoRA 适配器自动创建名称为 <base-model-name>:<adapter-name> 的 Model Route。本例会产生三条路由:基础模型 qwen3-8b,以及 qwen3-8b:devops 和 qwen3-8b:medical。LoRA 路由与基础模型自身的路由一起出现在 Model Routes 页面,并带有 LoRA 标记,便于识别。
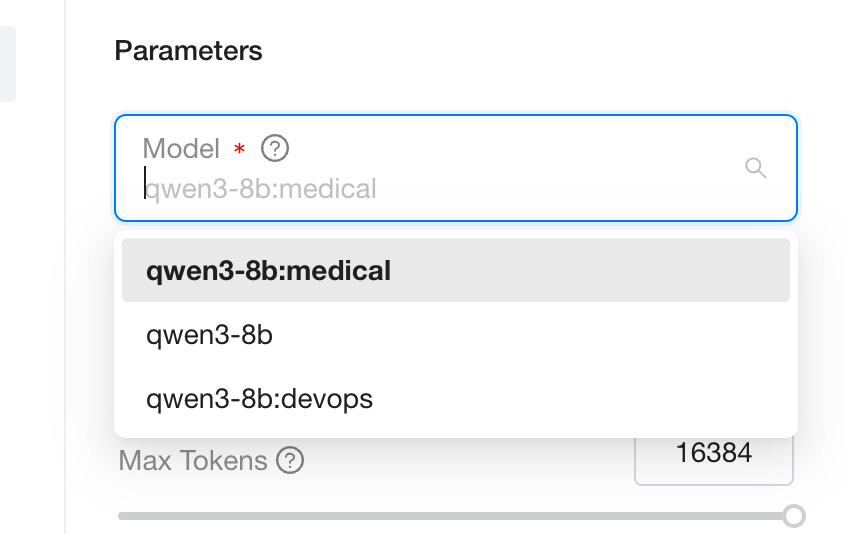
Playground 的模型下拉菜单会列出基础模型及所有 LoRA 适配器,切换选项即可将请求路由到对应适配器。OpenAI 兼容 API 同理:将 model 设为基础模型名称或适配器路由名称。所有适配器共享同一个 GPU 实例,因此切换适配器的开销远低于切换模型。
例如,只修改 model 字段,就能把同一个提示词发送到不同的微调版本。先向 DevOps 适配器发送 Kubernetes 问题:
然后仅修改 model 值,将临床问题发送到 medical 适配器:
将 <your-gpustack-server> 替换为 GPUStack Server 地址,将 <your-api-key> 替换为 API Keys 页面创建的密钥。改为发送 "model": "qwen3-8b" 时,会调用不使用任何适配器的基础模型。
步骤 3:管理 LoRA 适配器
部署创建后,可以调整 LoRA 配置:
- 添加适配器:编辑已部署模型并保存。已处于
Running状态的实例必须重启,才会挂载并提供新适配器的服务。 - 移除适配器:从已部署模型中删除对应项。当没有
Running实例继续使用该适配器时,GPUStack 会自动删除对应 Model Route。 - 名称冲突:如果两个不同基础模型的适配器名称最终生成同一个 Model Route,提交会因冲突被拒绝。重命名其中一个适配器即可解决。
后端兼容性与限制
不同推理后端的 LoRA 支持存在差异:
| 后端 | LoRA 启动参数/配置 | 主要限制 |
|---|---|---|
vLLM | --enable-lora、--max-loras、--lora-modules | --max-loras 根据 lora_list 的长度自动设置。基础模型启动后,适配器数量固定;修改需要重启实例。 |
SGLang | --enable-lora、--lora-paths name=path、--max-loras-per-batch | 同一批次中同时激活的 LoRA 数量受 --max-loras-per-batch 限制。 |
昇腾 MindIE(Ascend MindIE) | 配置文件中的 maxLoras / maxLoraRank / LoraModules | maxLoraRank 默认为 64,rank 更高的适配器会启动失败。maxLoras=0 时,自动等于已挂载适配器数量。 |
GPUStack 会自动注入这些参数,通常无需在 Backend Parameters 中重复填写。只有需要覆盖默认值,例如提高 maxLoraRank 时,才需在 Advanced → Backend Parameters 中添加参数。
完整说明和限制见各后端官方文档:
- vLLM:LoRA Adapters
- SGLang:LoRA Serving
- 昇腾 MindIE:Multi-LoRA(仅中文)