使用 MultiProcessing 后端运行分布式 vLLM
单个 Worker 的显存或算力不足以运行模型时,vLLM 可以将一个模型实例拆分到多个 Worker 协同推理。GPUStack 将这些跨节点进程编排为单个模型实例,仅提供一个 OpenAI 兼容端点。vLLM 通过 --distributed-executor-backend 提供 ray 和 mp(MultiProcessing)两条执行路径。本教程使用 MP 后端,结合张量并行(TP)与数据并行(DP),在多个 Worker 间运行分布式推理。
本教程介绍如何在 GPUStack 上启用跨 Worker 分布式推理,显式选择 MP 后端,并结合张量并行与数据并行,将单个模型实例部署到两个节点。
说明
- 在
Backend Parameters中显式设置--distributed-executor-backend=mp,或使用 vLLM ≥0.18.0的自定义镜像(后端版本带-custom后缀)时,MP 后端生效。从0.18.0开始,vLLM 默认不再依赖 Ray,因此 GPUStack 会自动回退为mp,以避免启动失败。 - Ray 与 MP 路径、headless follower,以及
dp_only/mp_only/nested拓扑的概念区别,见内置推理后端中的Distributed Inference Across Workers部分。 - 此功能目前处于实验阶段。
前提条件
开始前,请确认:
- GPUStack 已安装并运行。
- 至少有 2 个 Linux 节点,各节点 GPU 的数量和型号相同。本教程以 2 个节点 × 8 张 GPU,共 16 张 GPU 为例,适用于 NVIDIA、AMD、昇腾等厂商的加速卡。
- 建议节点间使用 NVLink、InfiniBand 等高速互连,以获得更好的性能。
- 所有参与节点必须能通过相同路径访问模型文件。可使用共享文件系统,或预先将模型下载到各节点的相同路径。
- 所选模型适合
tensor-parallel-size=8、data-parallel-size=2的布局,即每个数据并行副本占用一个完整的 8-GPU 节点。
说明
本教程假定每个数据并行副本(tensor-parallel-size=8)完整占用一个 8-GPU 节点。请按模型和硬件调整 --tensor-parallel-size 与 --data-parallel-size。
步骤 1:添加 GPUStack Worker
按照安装文档,在每个节点运行加入命令,将其加入同一个 GPUStack 集群。
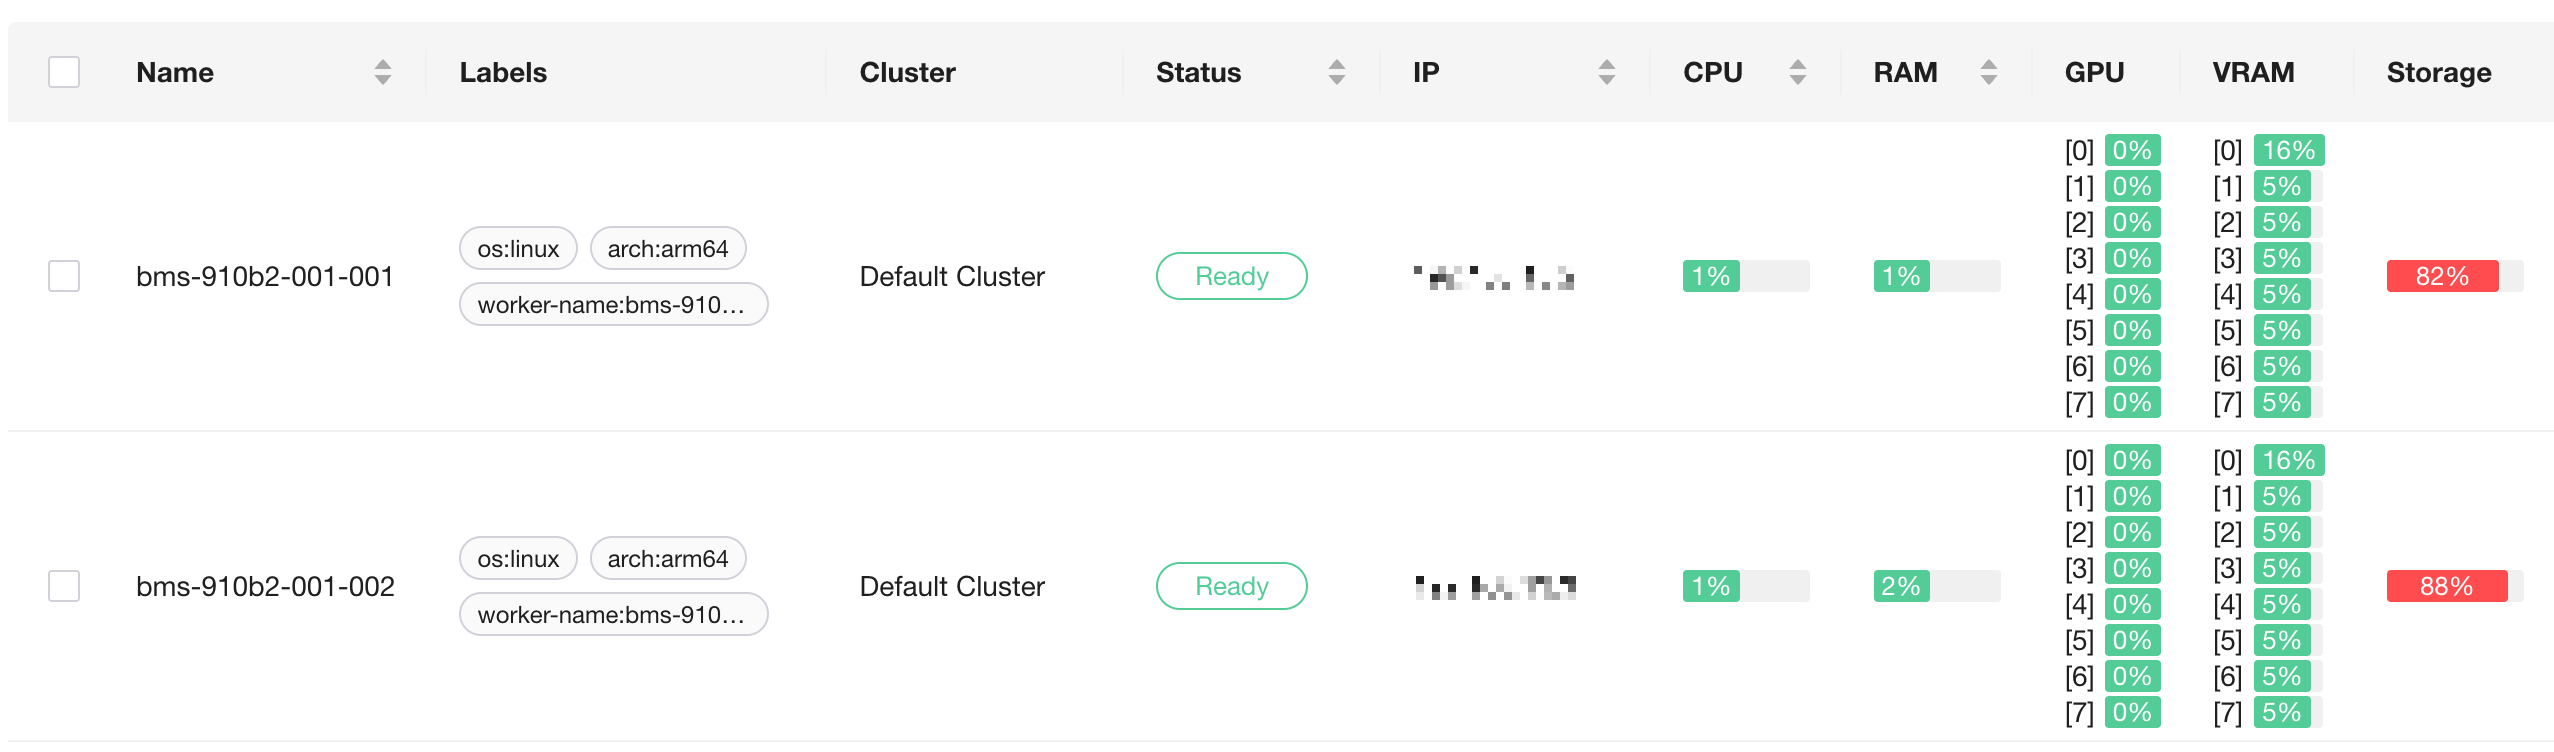
加入后,在 GPUStack 的 Workers 页面确认两个节点均为 Ready 状态,且 GPU 已显示。
步骤 2:使用 MP 后端部署模型
- 打开
Deployments页面。 - 点击
Deploy Model,选择模型来源,例如Local Path,填写各节点一致的模型路径。 - 确认
Backend为vLLM。 - 在高级设置中勾选
Allow Distributed Inference Across Workers,启用跨 Worker 分布式推理。 -
在
Backend Parameters中添加: -
兼容性检查通过后,点击
Save部署。
将整个分布式实例作为一次部署
建议将跨节点分布式实例作为单次部署。仅按上述步骤创建一个部署时,GPUStack 会:
- 从两个 Worker 选择 GPU,本例共 16 张,并自动推导各节点的
--data-parallel-size-local,因此无需手动设置该参数; - 注入多节点拓扑参数
--nnodes、--node-rank、--master-addr和--master-port; - 自动为 follower 实例添加
--headless,使其只参与分布式计算,不启动 API 端点。follower 日志中出现--headless是正常现象。
无法满足自动调度条件时
如果某项条件不满足,导致自动调度无法分配资源,例如显存不满足 gpu_memory_utilization,请将 Scheduling Mode 切换为 Manual 或 Specify GPU,再通过 GPU Selector 在两个 Worker 上各选择 8 张 GPU,共 16 张。完整自动调度条件见内置推理后端。
手动拆成多个部署时,使用 GPUSTACK_SKIP_GPU_COUNT_CHECK 跳过 GPU 数量检查
某些场景中可能希望每个节点创建一个部署,例如自行管理外部负载均衡器,手动选择 GPU,并设置 --data-parallel-size-local 1。此时每个部署只选择 8 张 GPU,而 tensor-parallel-size × data-parallel-size = 16,GPU 数量与 world size 不一致,因此 GPUStack 会报错:the selected gpu count (8) does not match the world size (16)。
如果这正是预期布局,请在每个部署的 Environment Variables 中设置 GPUSTACK_SKIP_GPU_COUNT_CHECK=1,跳过检查并保留手动选择的 GPU 数量。此开关仅在手动选择 GPU 时生效,即 Scheduling Mode 为 Manual 或 Specify GPU,不影响自动调度。
步骤 3:监控部署
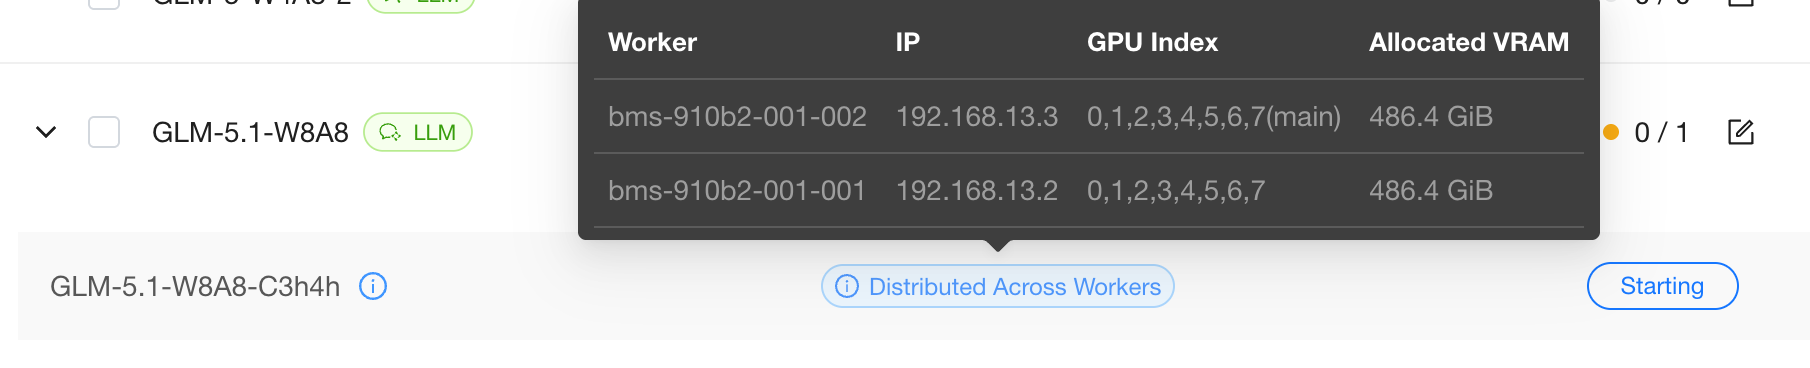
在 Deployments 页面查看部署状态,将鼠标悬停在 Distributed Across Workers 上,查看实例在各 Worker 上的 GPU 使用情况。点击 View Logs 查看实时日志:
- leader 实例加载模型,并提供 OpenAI 兼容端点;
- follower 实例日志中的
--headless表示它只参与分布式计算,不占用 API 端口,属于正常现象。
加载模型可能需要几分钟。
步骤 4:通过 Playground 验证
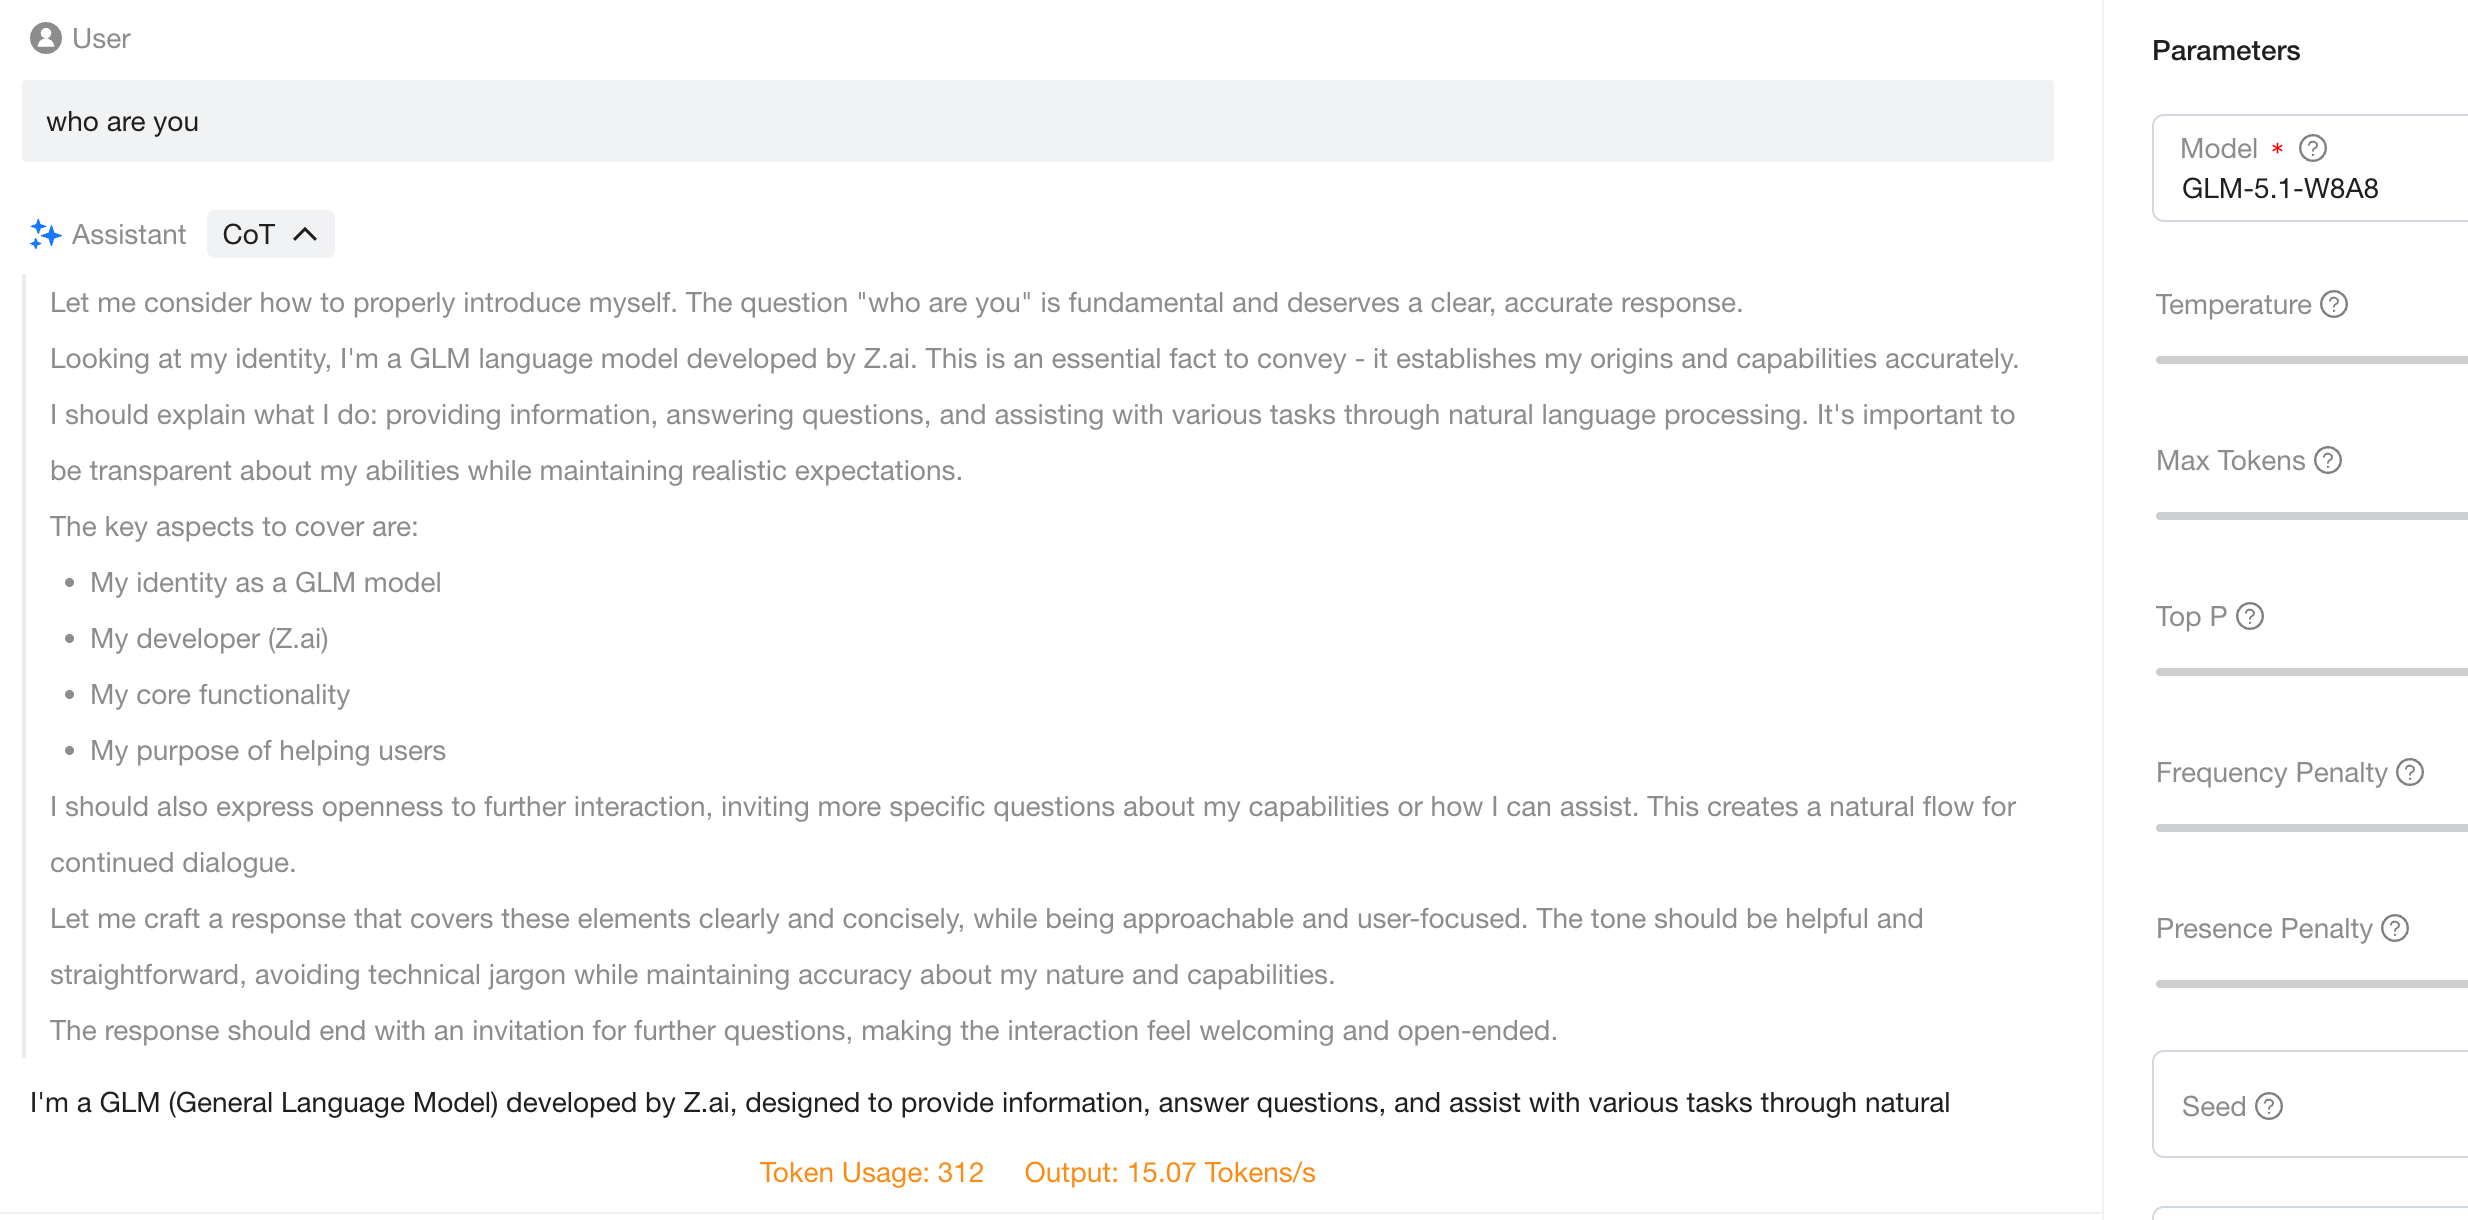
部署运行后,可直接在 GPUStack Playground 中验证。所有外部请求均进入 leader,再由其分发给 follower,因此使用方式与单 Worker 部署相同:
- 打开
Playground>Chat。 - 如果只部署了一个模型,会默认选中;否则在右上角下拉菜单中选择模型。
- 输入提示词,与模型交互。
至此,已在 GPUStack 集群中通过 vLLM MP 后端跨多个节点部署并运行分布式推理。
如需帮助,可联系 GPUStack 社区或支持团队。