使用分布式 vLLM 运行 DeepSeek R1 671B
本教程介绍如何在 GPUStack 集群中通过分布式 vLLM配置和运行原版 DeepSeek R1 671B。由于模型规模很大,通常需要跨多个 Worker 进行分布式推理。
GPUStack 简化了 vLLM 分布式推理的配置和编排,只需少量手动配置即可运行 DeepSeek R1 这类大型模型。
前提条件
开始前,请确认满足以下要求:
- 有足够数量的 Linux 节点,各节点配备所需 GPU。例如:
| GPU | 节点数量 |
|---|---|
| H100/H800:8 | 2 |
| A100/A800-80GB:8 | 4 |
| A100/A800:8 | 8 |
- 建议使用 NVLink、InfiniBand 等高速互连,以获得更好的性能。
- 各节点应将模型文件下载到相同路径。GPUStack 虽然支持即时下载模型,但下载耗时受网络速度影响,建议提前下载。
说明
- 本教程使用 4 个节点,每个节点配备 8 张 A800-80GB GPU,通过 200G InfiniBand 互连。
- A100/A800 GPU 不支持 DeepSeek R1 原版使用的 FP8 精度,因此使用 Unsloth 提供的 BF16 版本。
步骤 1:安装 GPUStack Server
按照安装文档,可使用以下命令启动 GPUStack Server:
说明
- 将
/path/to/your/model替换为实际路径。
GPUStack Server 启动后,运行以下命令获取初始管理员密码:
步骤 2:访问 GPUStack 界面
使用 admin 用户和获取的密码登录 GPUStack 界面。
步骤 3:安装 GPUStack Worker
在 GPUStack 界面中打开 Workers 页面,点击 Add Worker 获取添加命令。
然后在每个 Worker 节点上运行添加命令,启动 GPUStack Worker:
说明
- 按实际情况替换占位路径、IP 地址/主机名和集群令牌。
- 将
/path/to/your/model替换为系统中实际存储 DeepSeek R1 模型文件的路径。
添加所有 Worker 后,返回 GPUStack 界面。
在 Workers 页面确认所有 Worker 均为 Ready 状态,且 GPU 已显示。
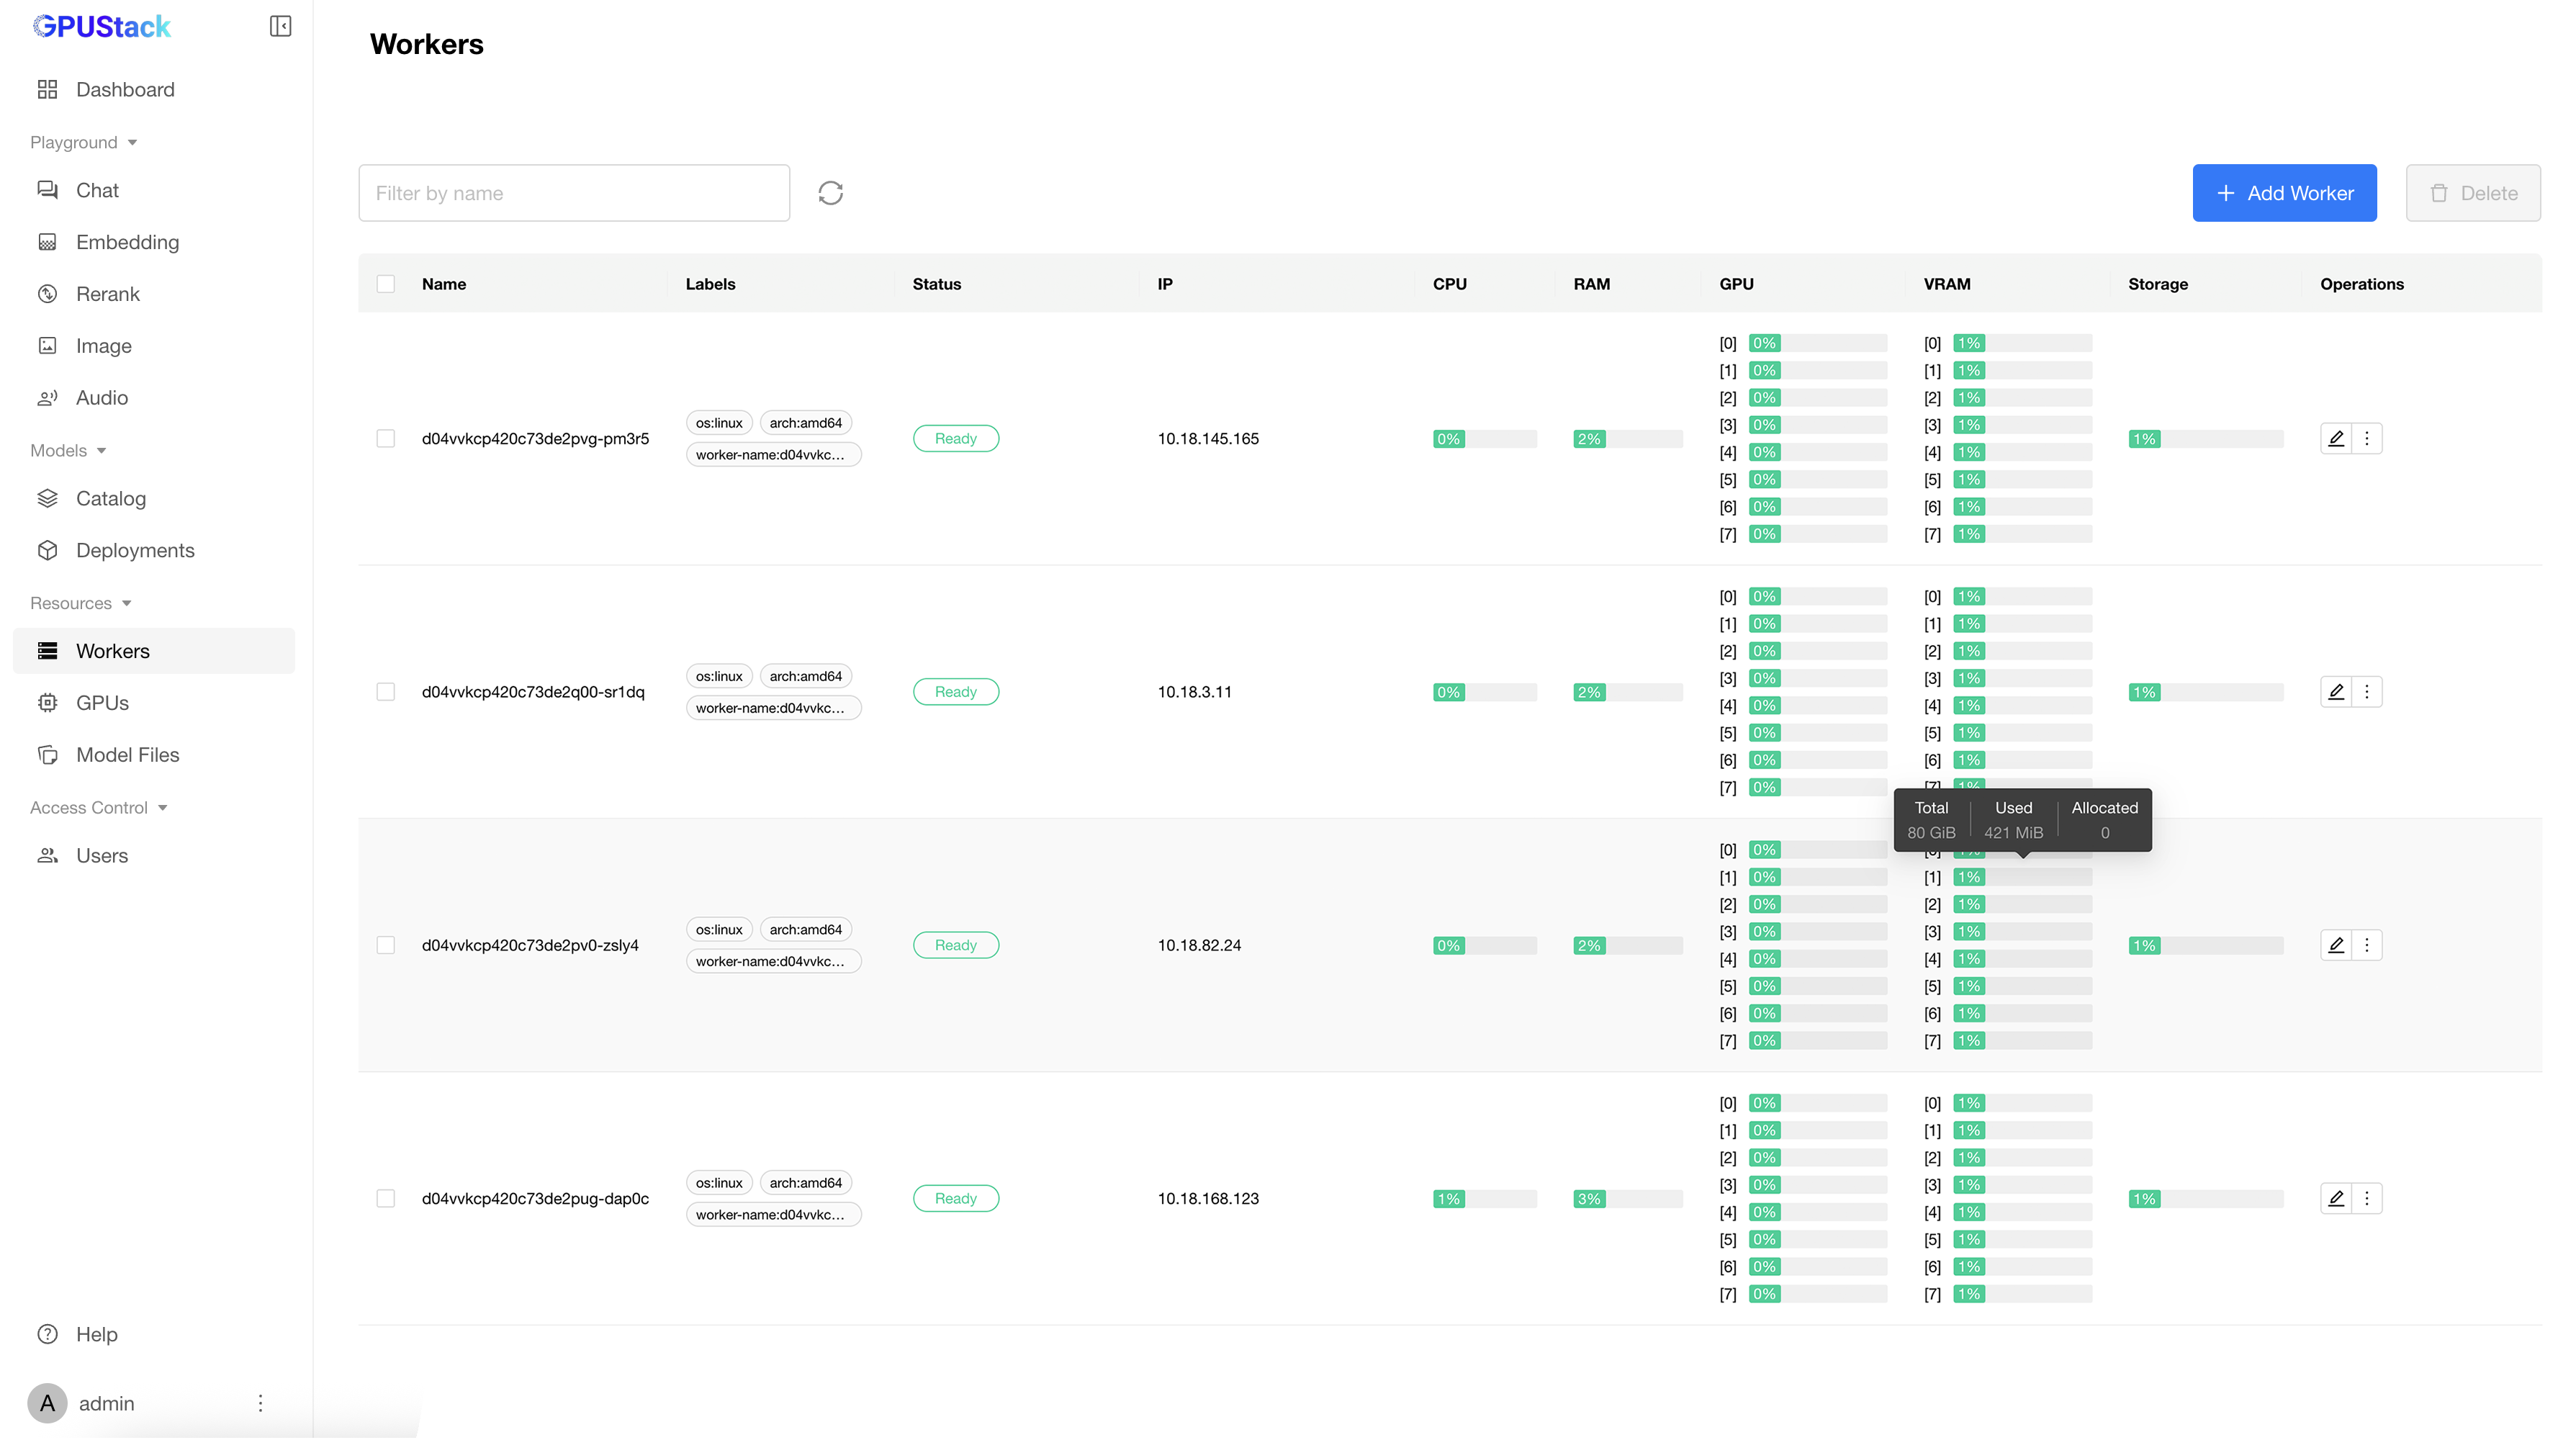
步骤 4:部署 DeepSeek R1 模型
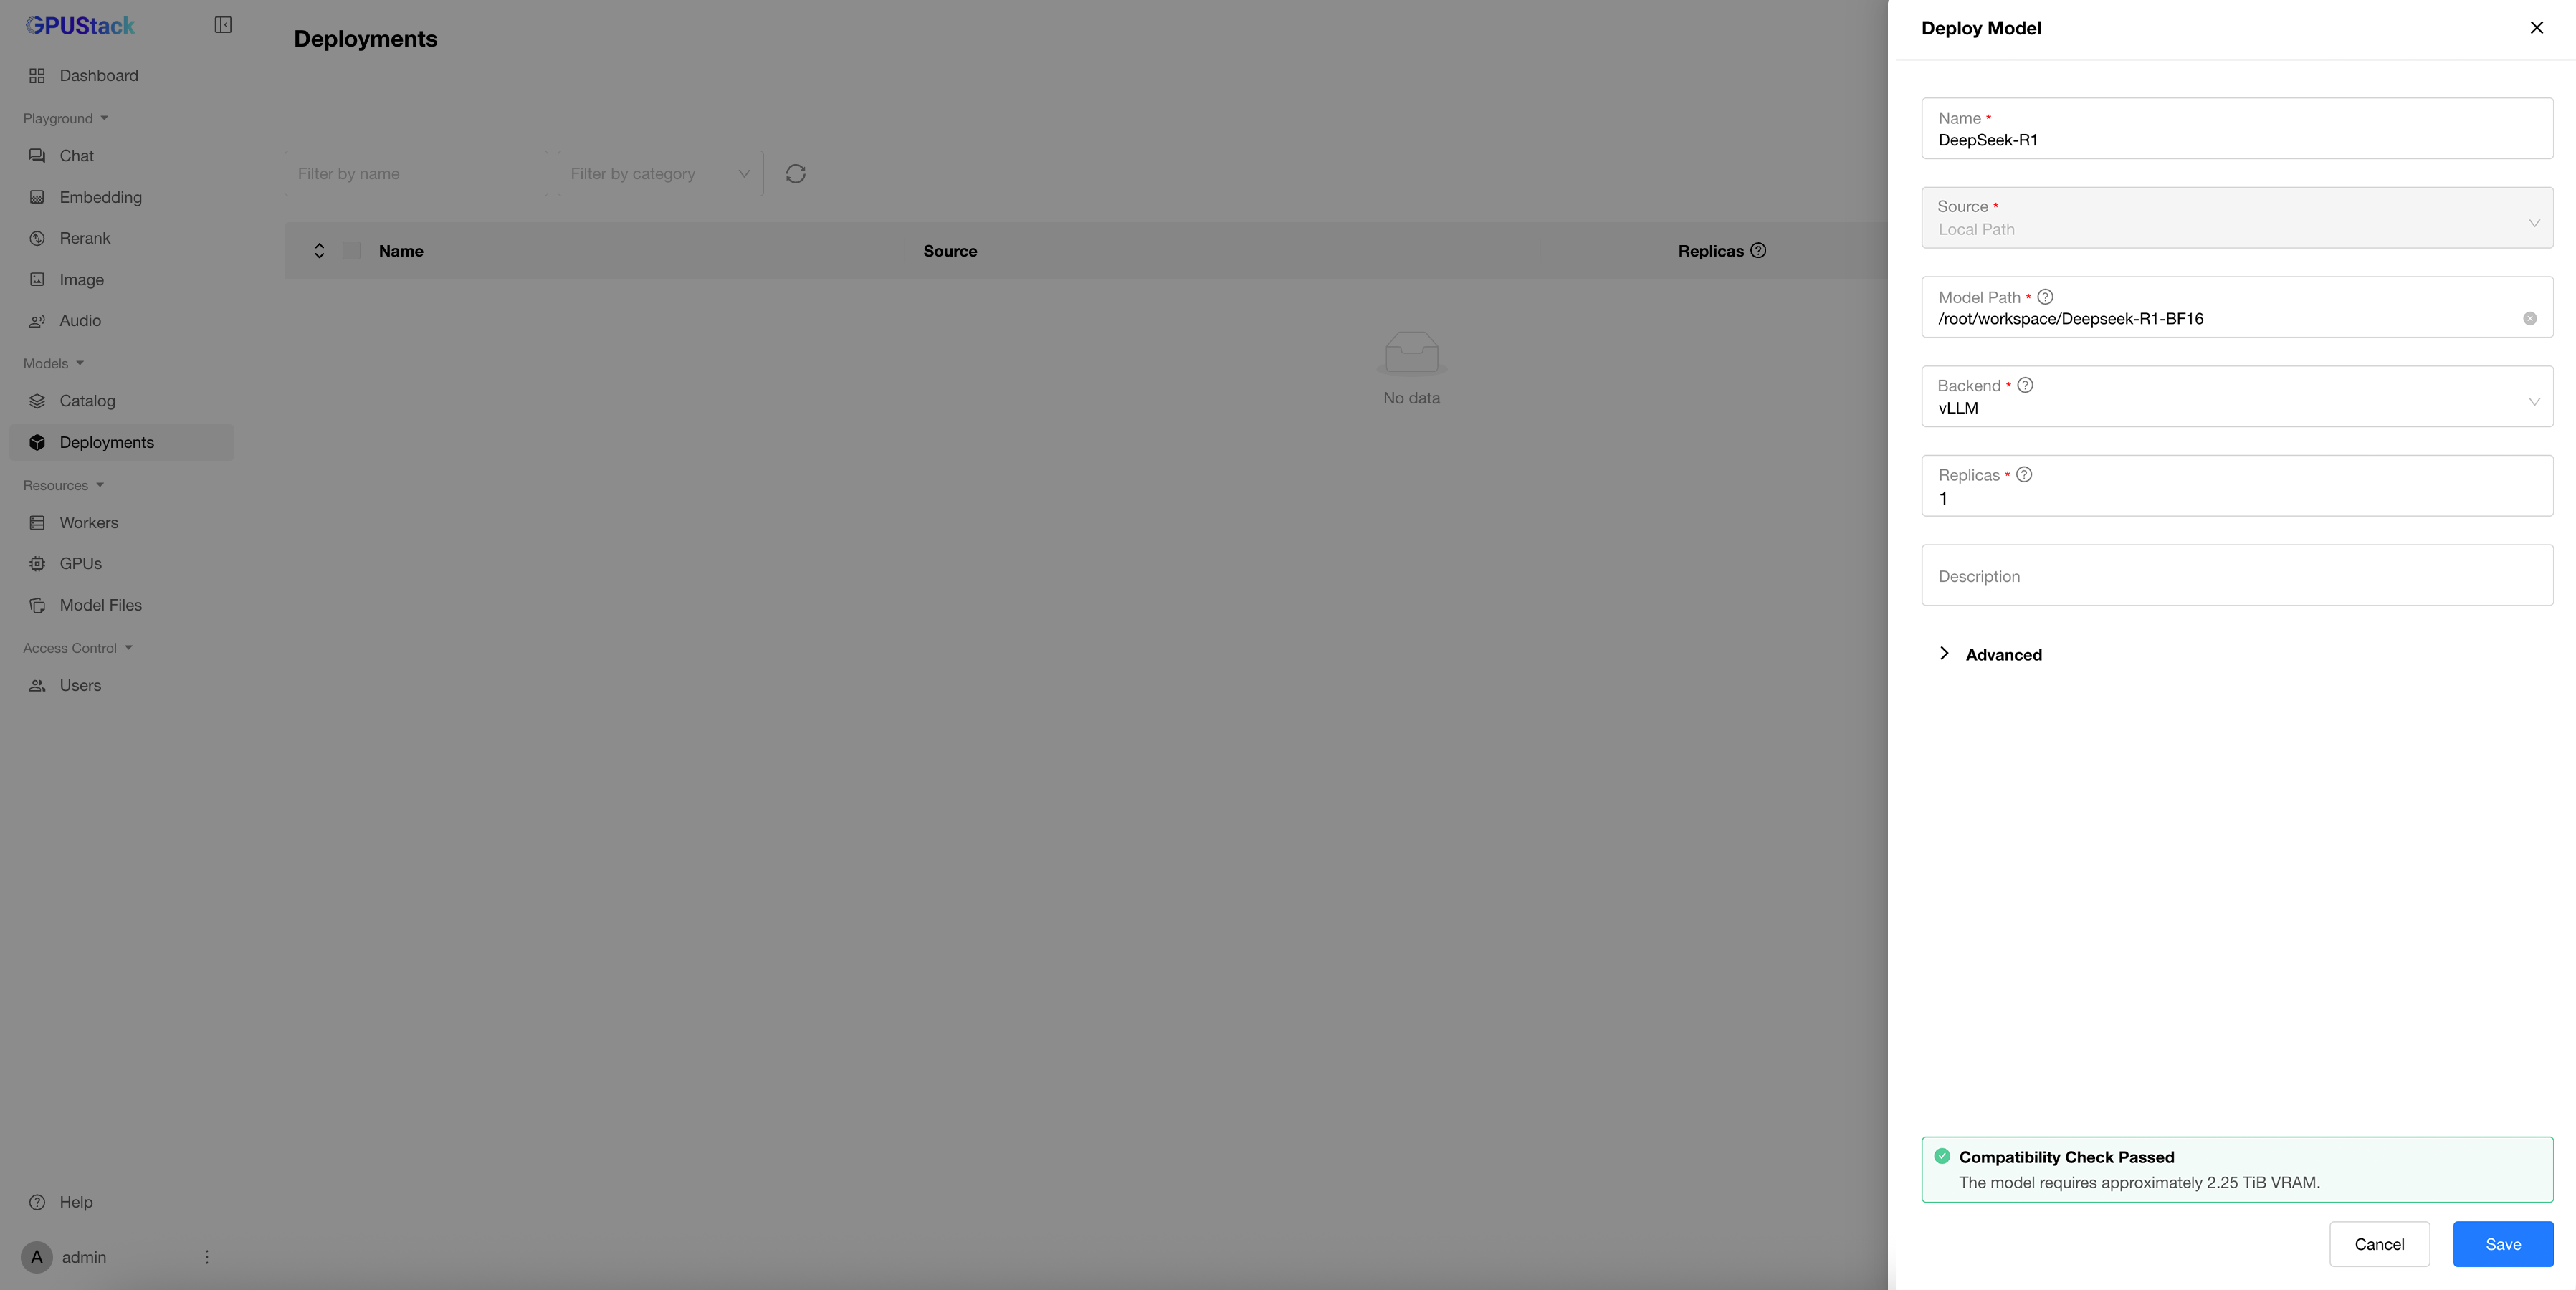
- 打开
Deployments页面。 - 点击
Deploy Model。 - 将模型来源设为
Local Path。 - 在
Name中输入名称,例如DeepSeek-R1。 - 将
Model Path设为各 Worker 节点上包含 DeepSeek R1 模型文件的目录。 - 确认
Backend为vLLM。 - 兼容性检查通过后,点击
Save部署。
步骤 5:监控部署
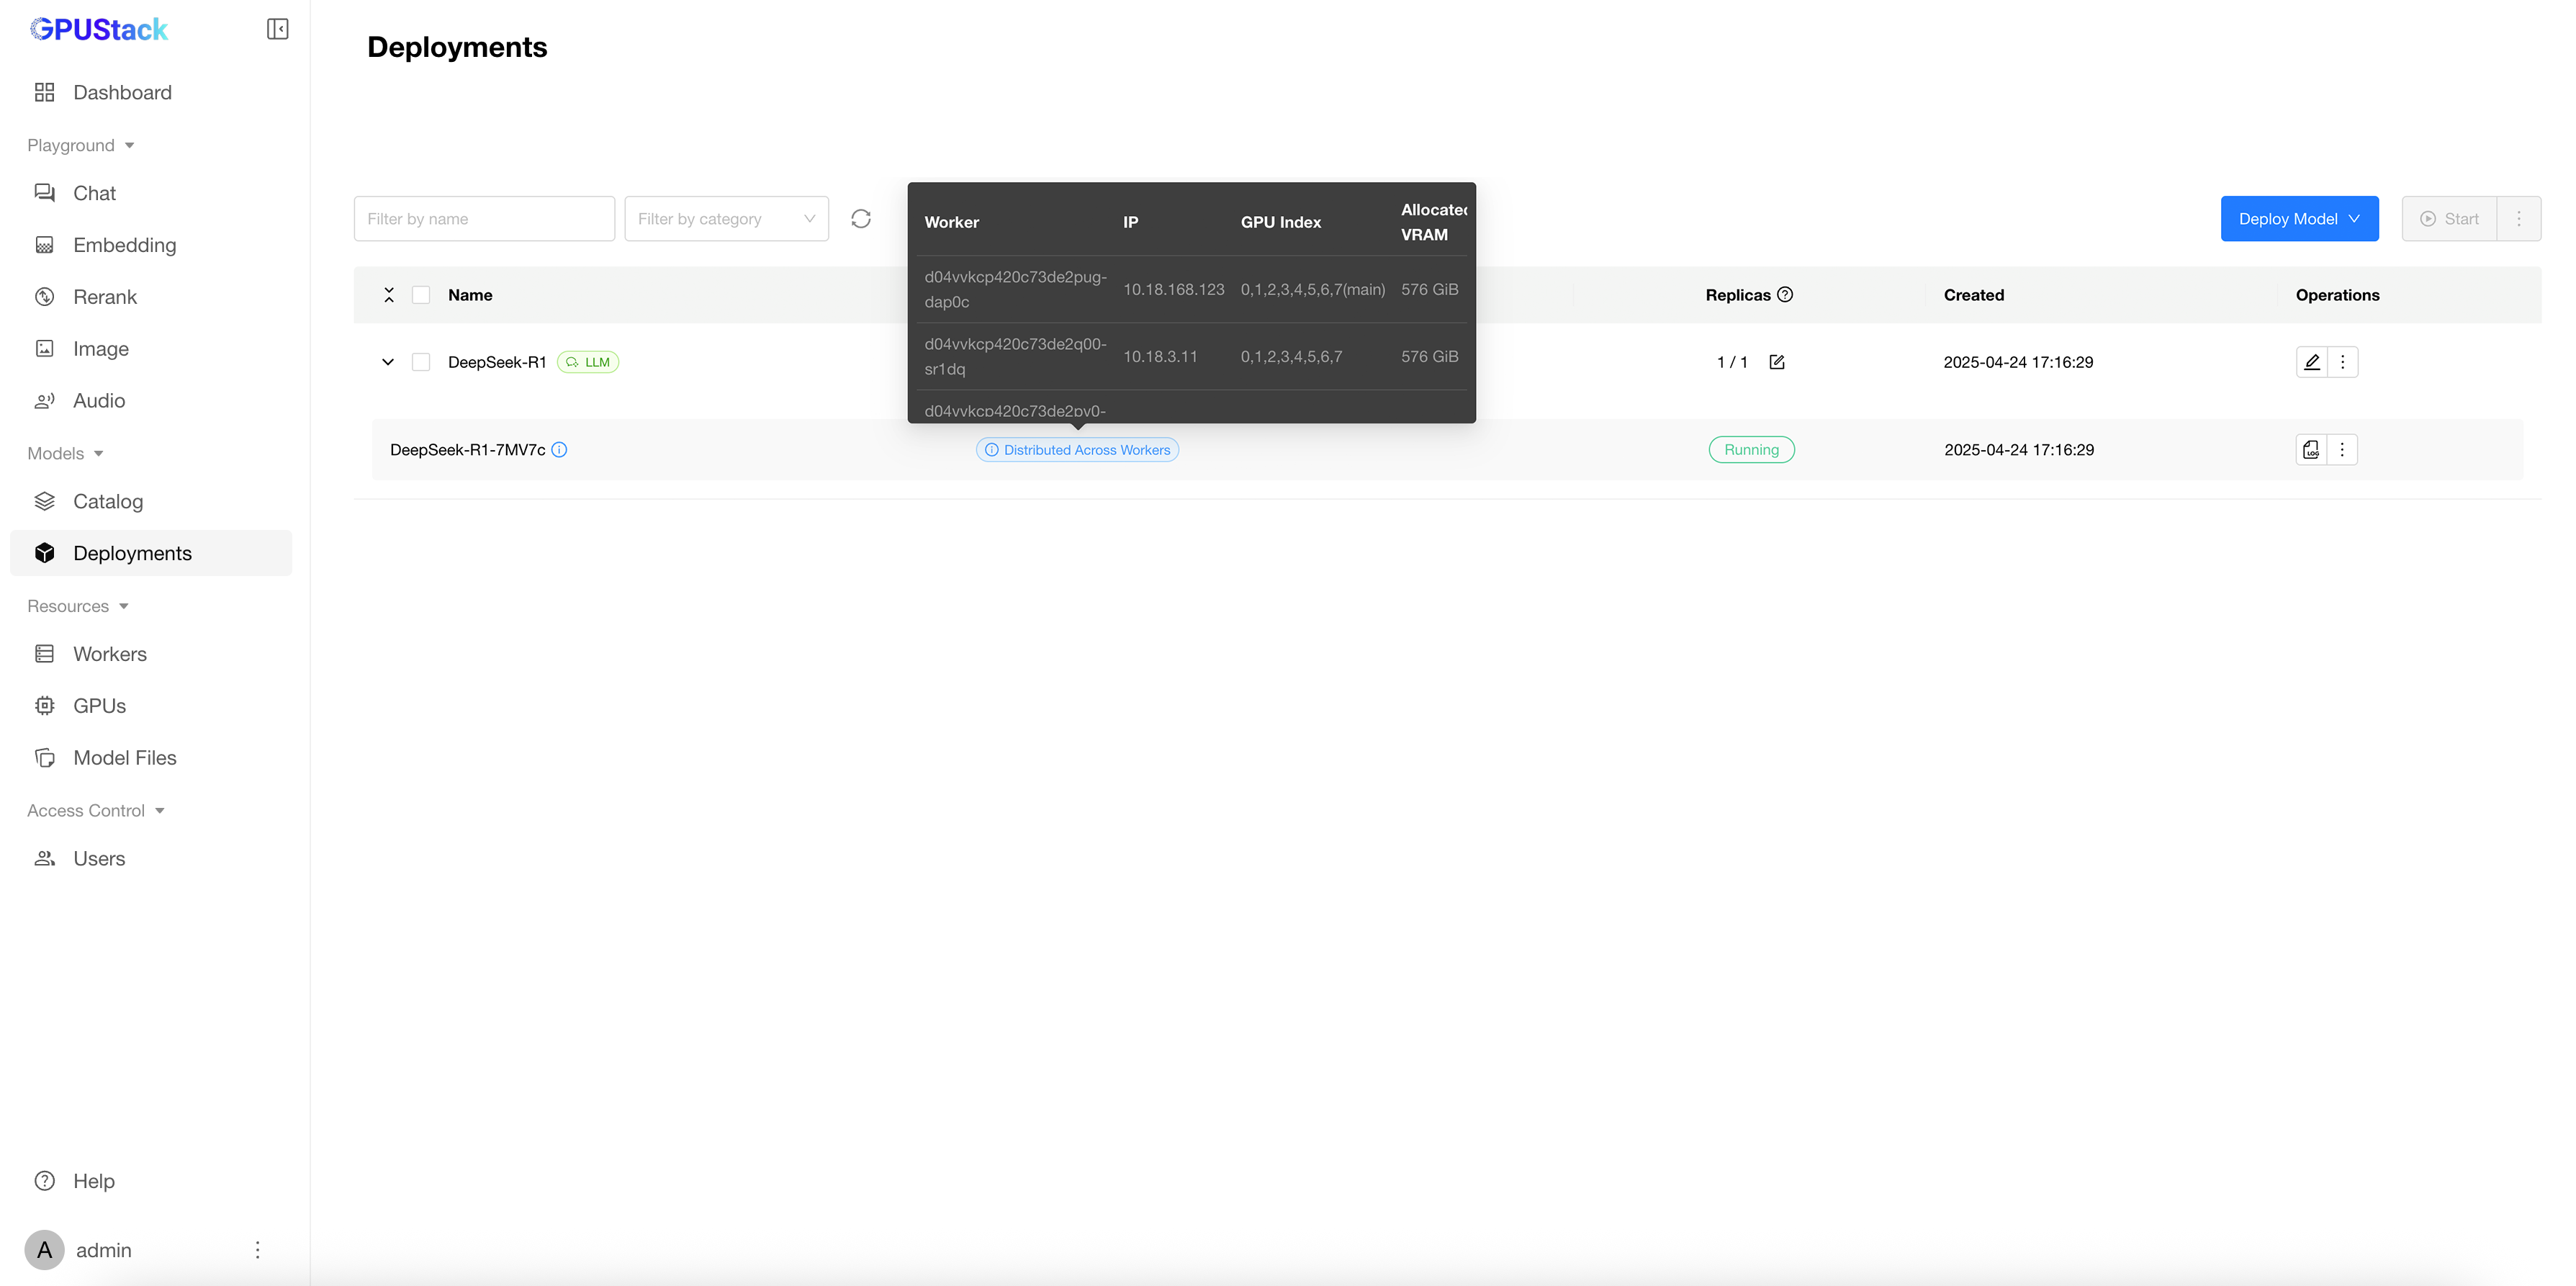
在 Deployments 页面查看部署状态。将鼠标悬停在 distributed across workers 上,查看 GPU 和 Worker 使用情况。点击 View Logs 查看模型加载进度的实时日志。加载可能需要几分钟。
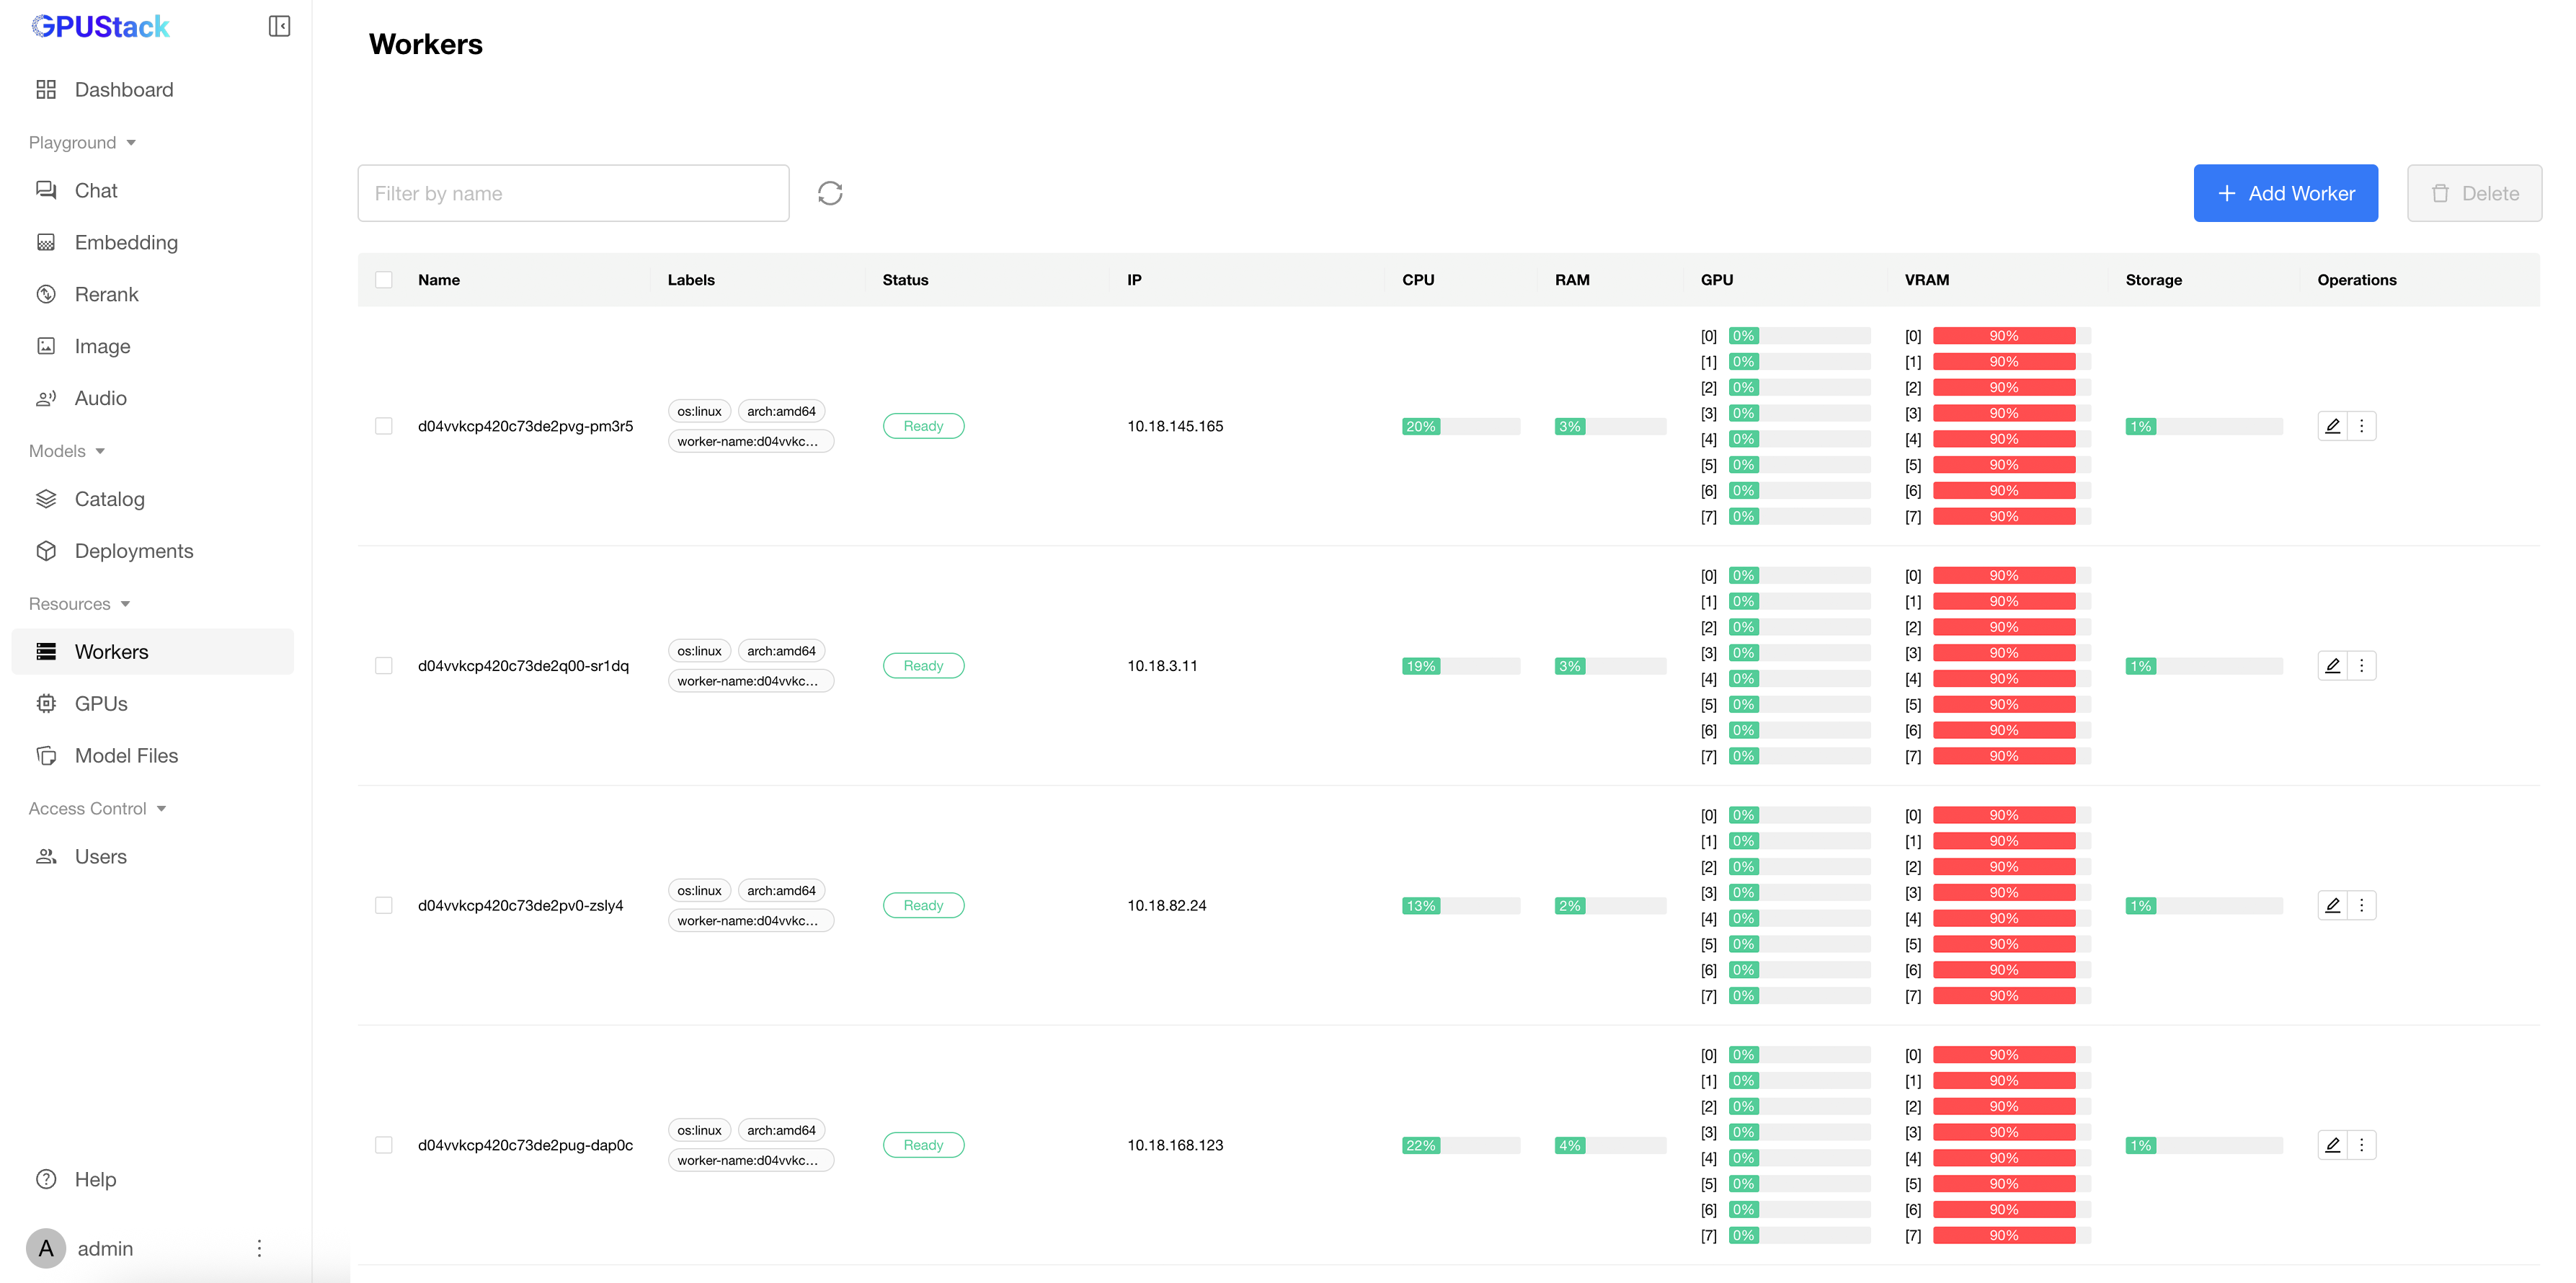
模型运行后,在 Workers 页面查看 GPU 使用率。vLLM 默认使用 90% 的 GPU 显存,可在模型配置中调整。
步骤 6:通过 Playground 执行推理
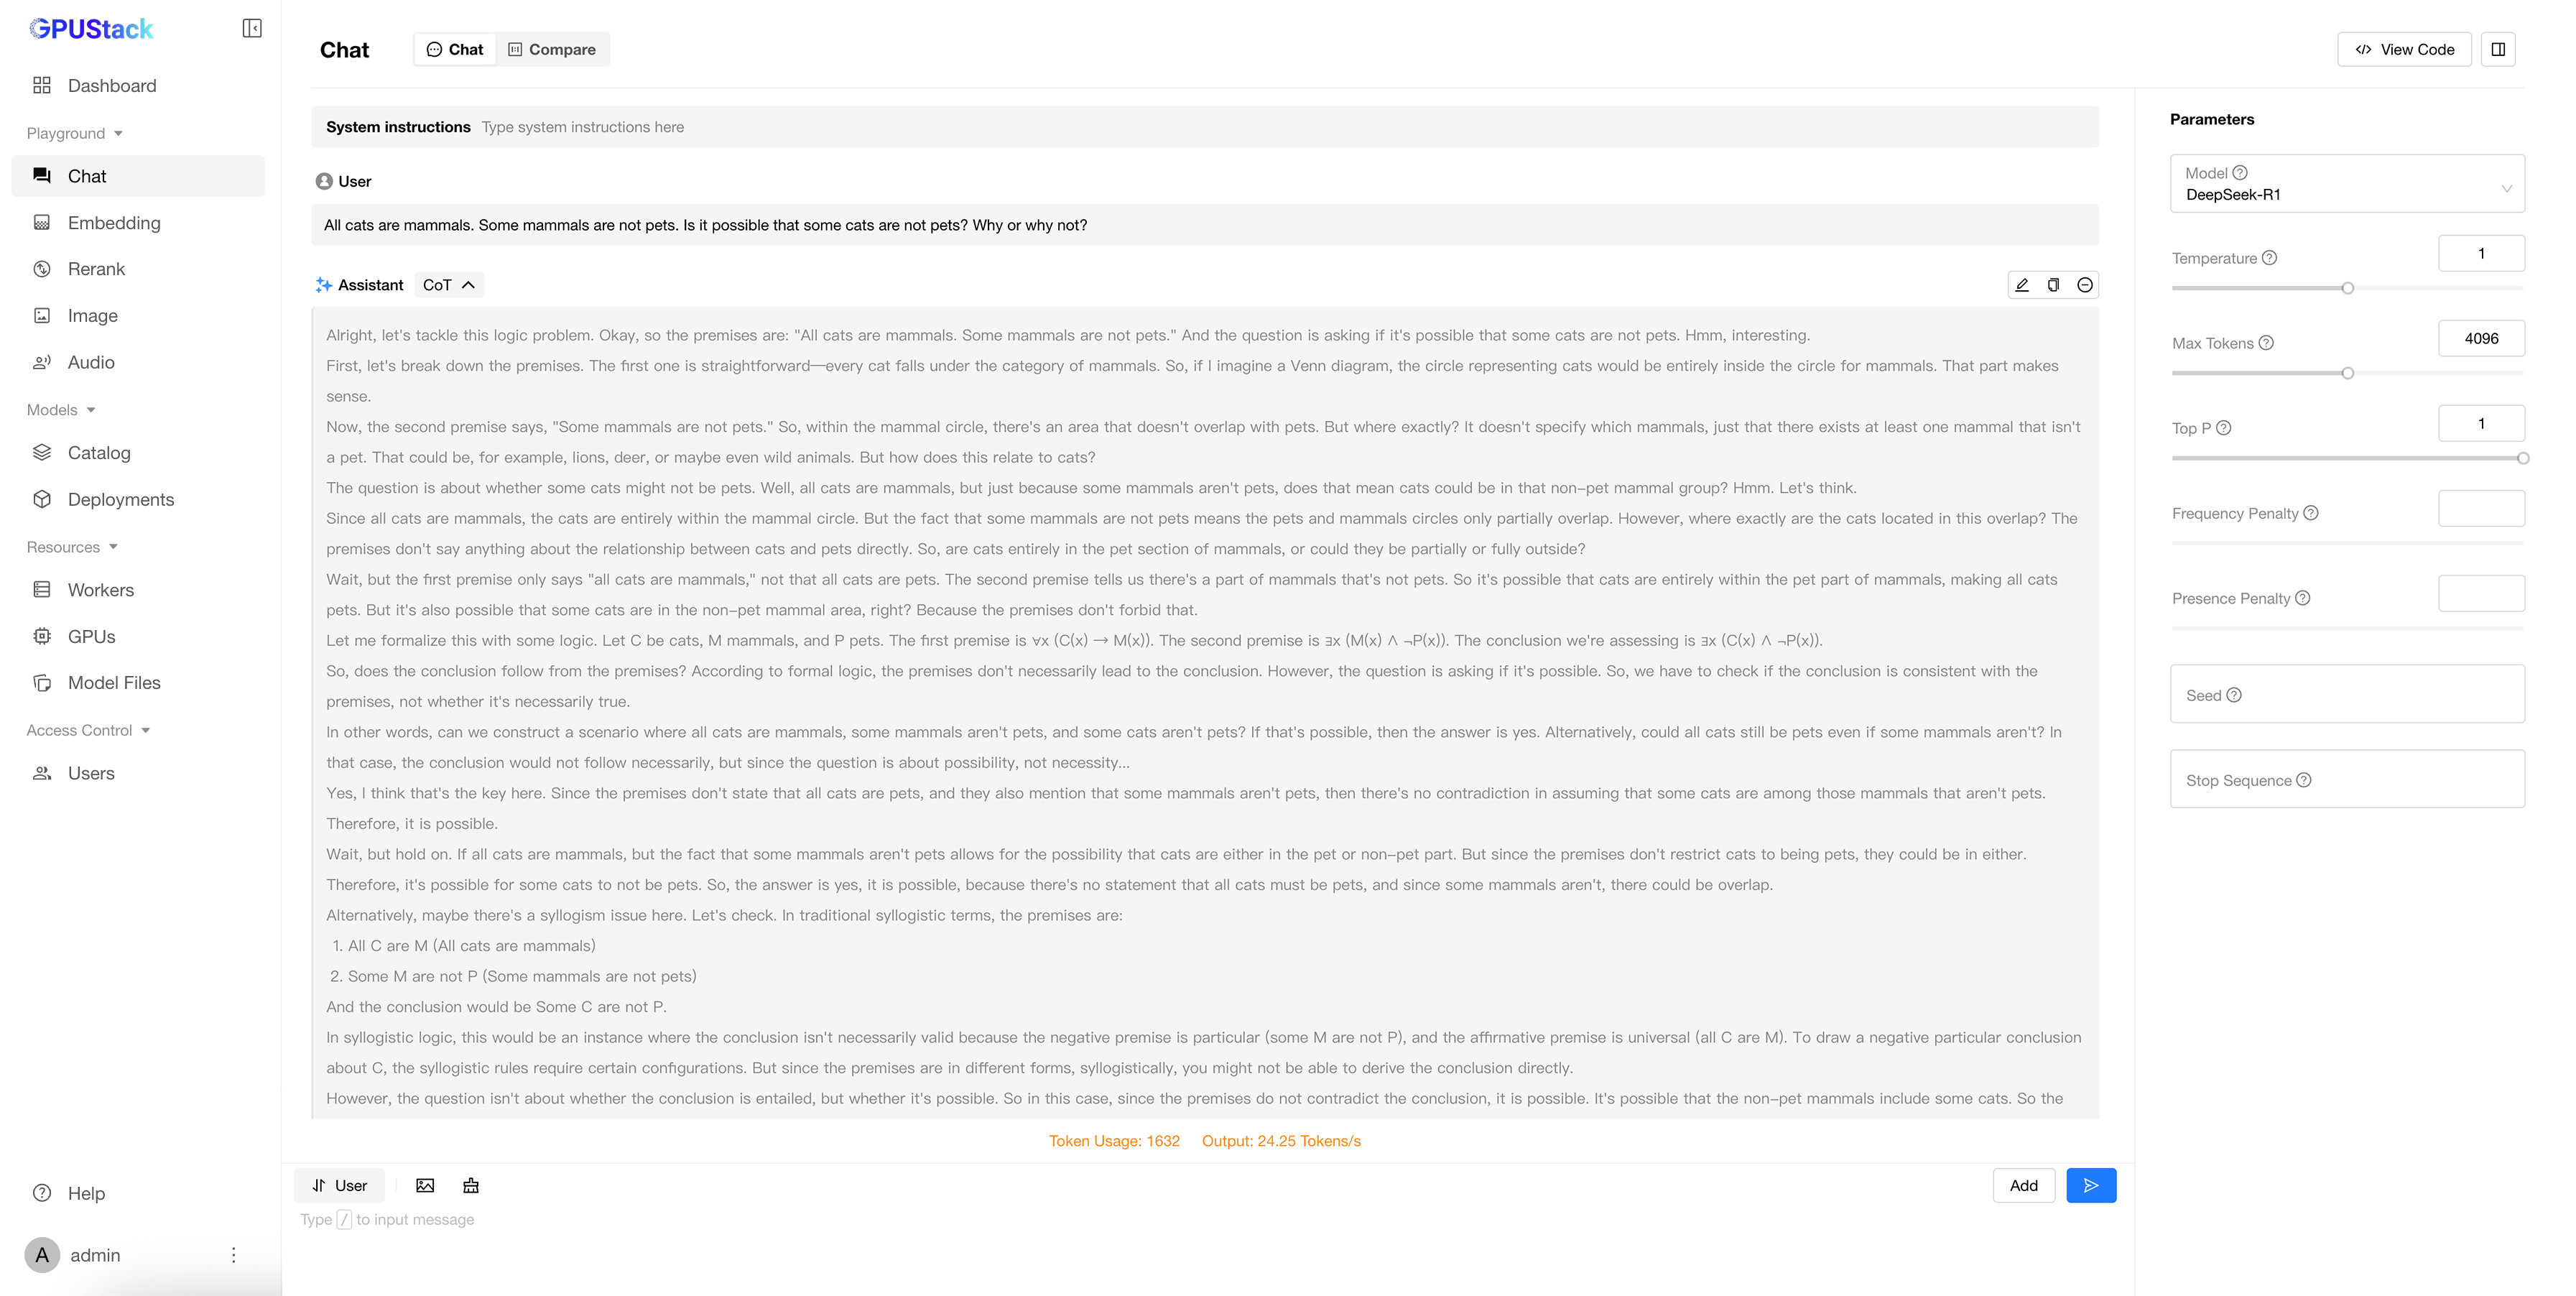
模型部署并运行后,即可在 GPUStack Playground 中测试。
- 打开
Playground->Chat。 - 如果只部署了一个模型,会默认选中;否则通过下拉菜单选择
DeepSeek-R1。 - 输入提示词,与模型交互。
也可以在 Compare 标签页中测试并发推理场景。
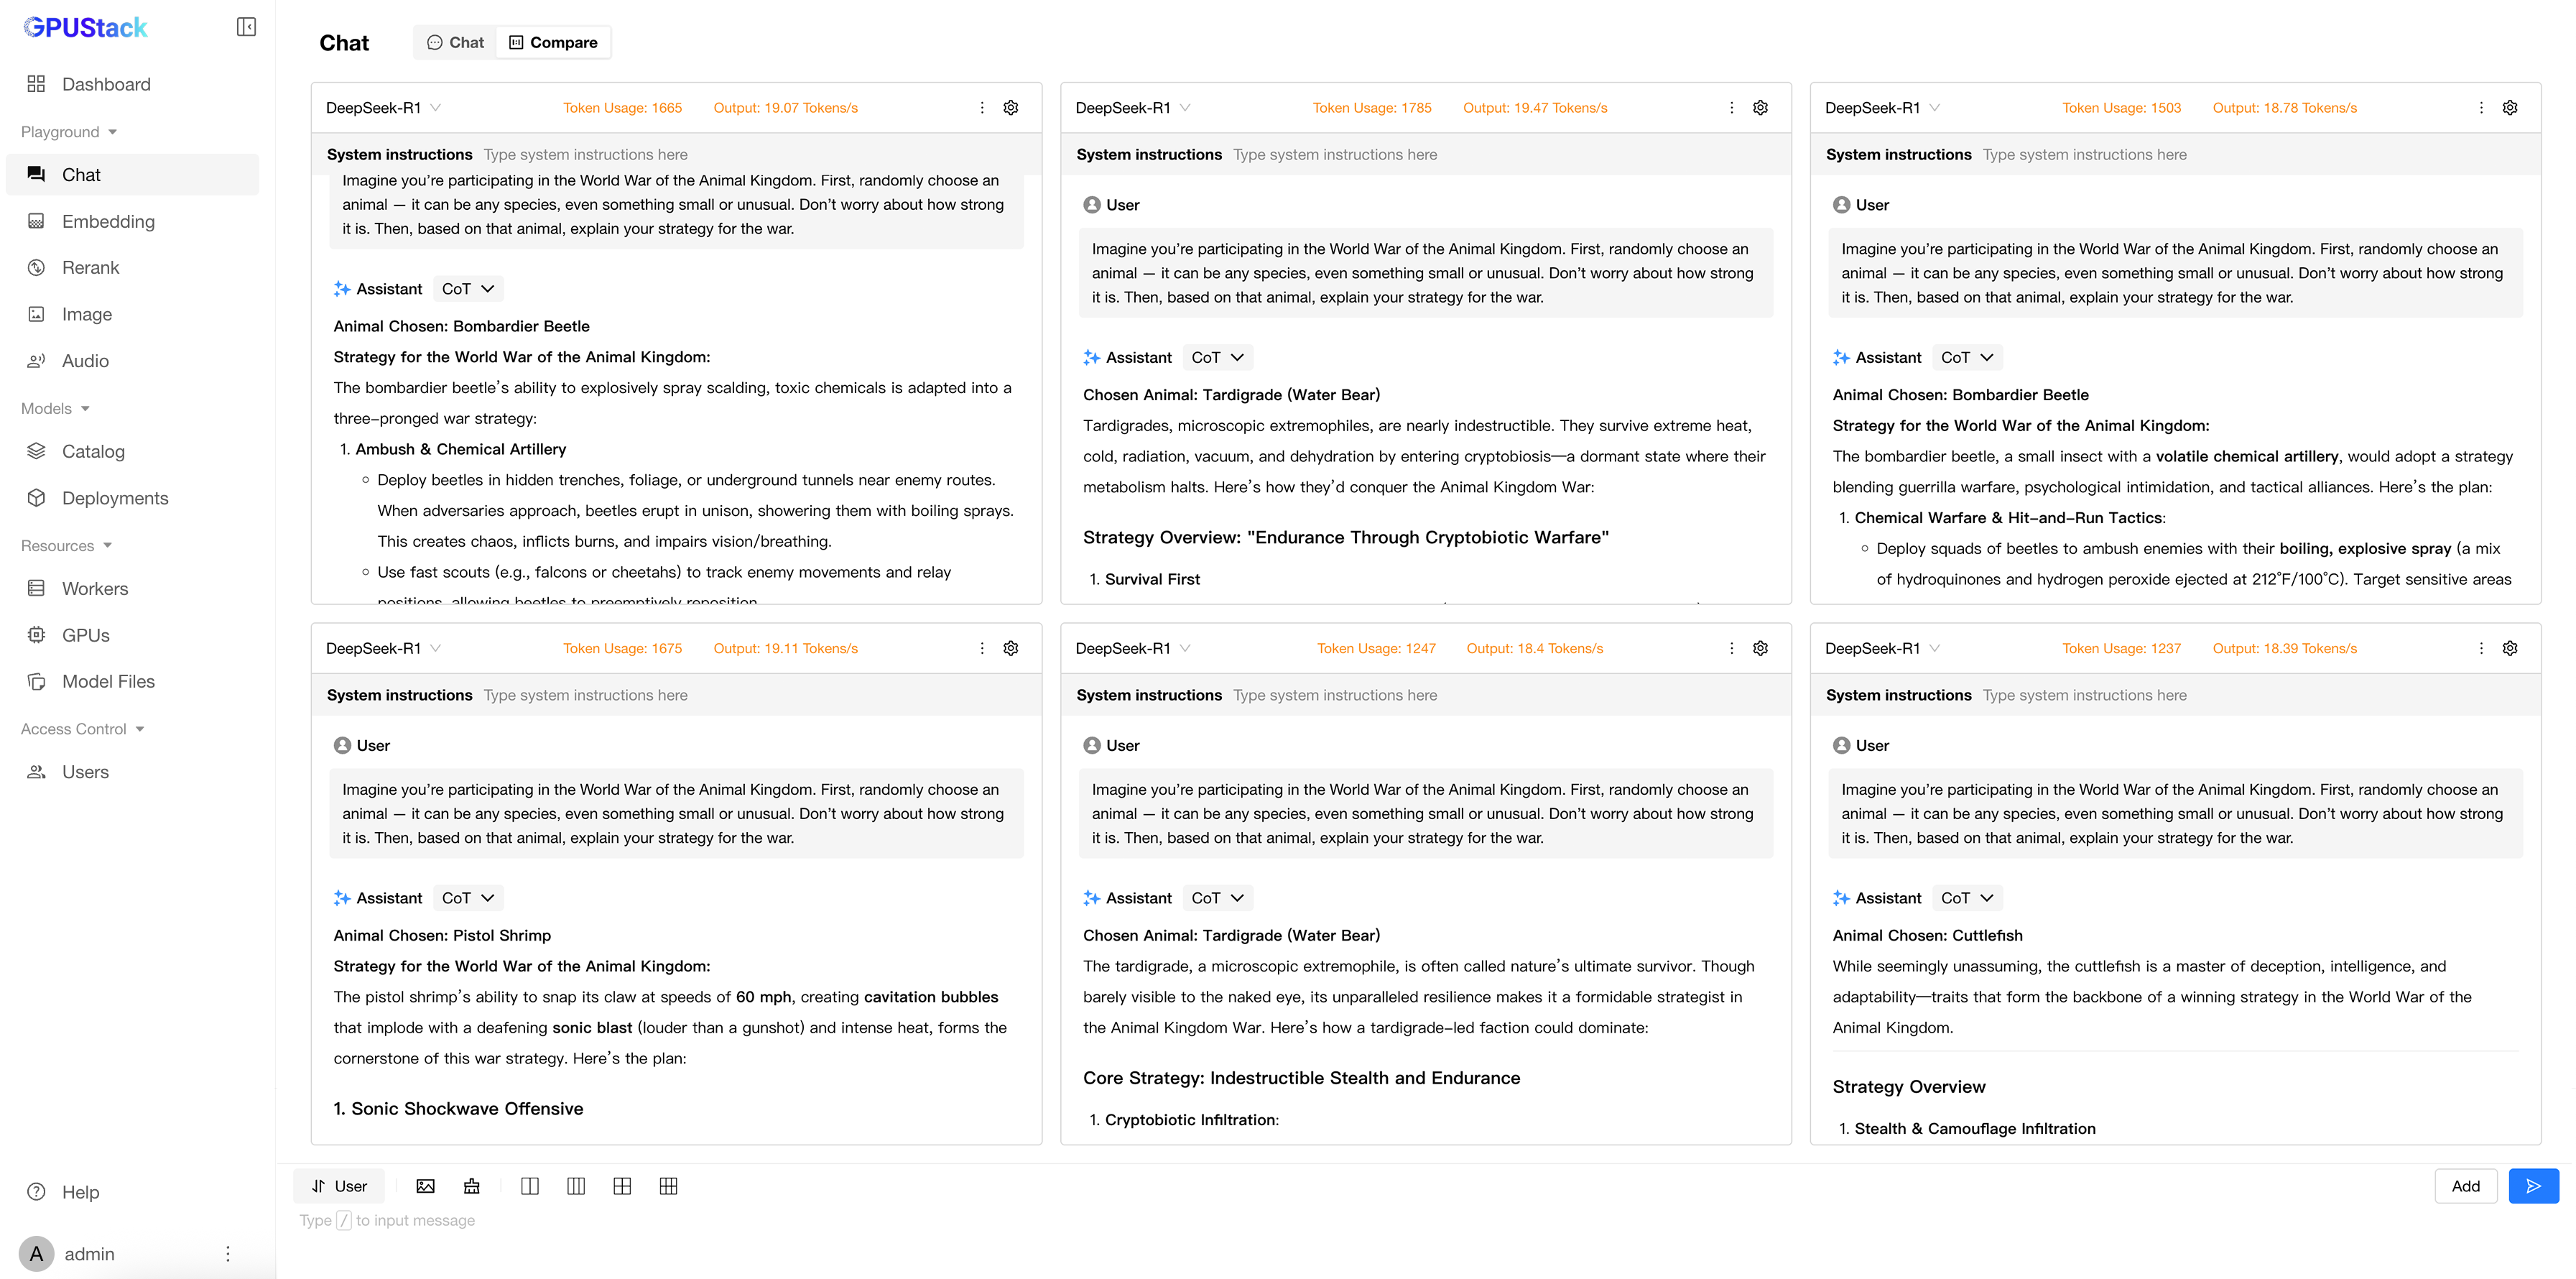
至此,已在 GPUStack 集群上通过分布式 vLLM 部署并运行 DeepSeek R1 671B。可进一步在自己的应用中测试模型的性能和能力。
如需帮助,可联系 GPUStack 社区或支持团队。