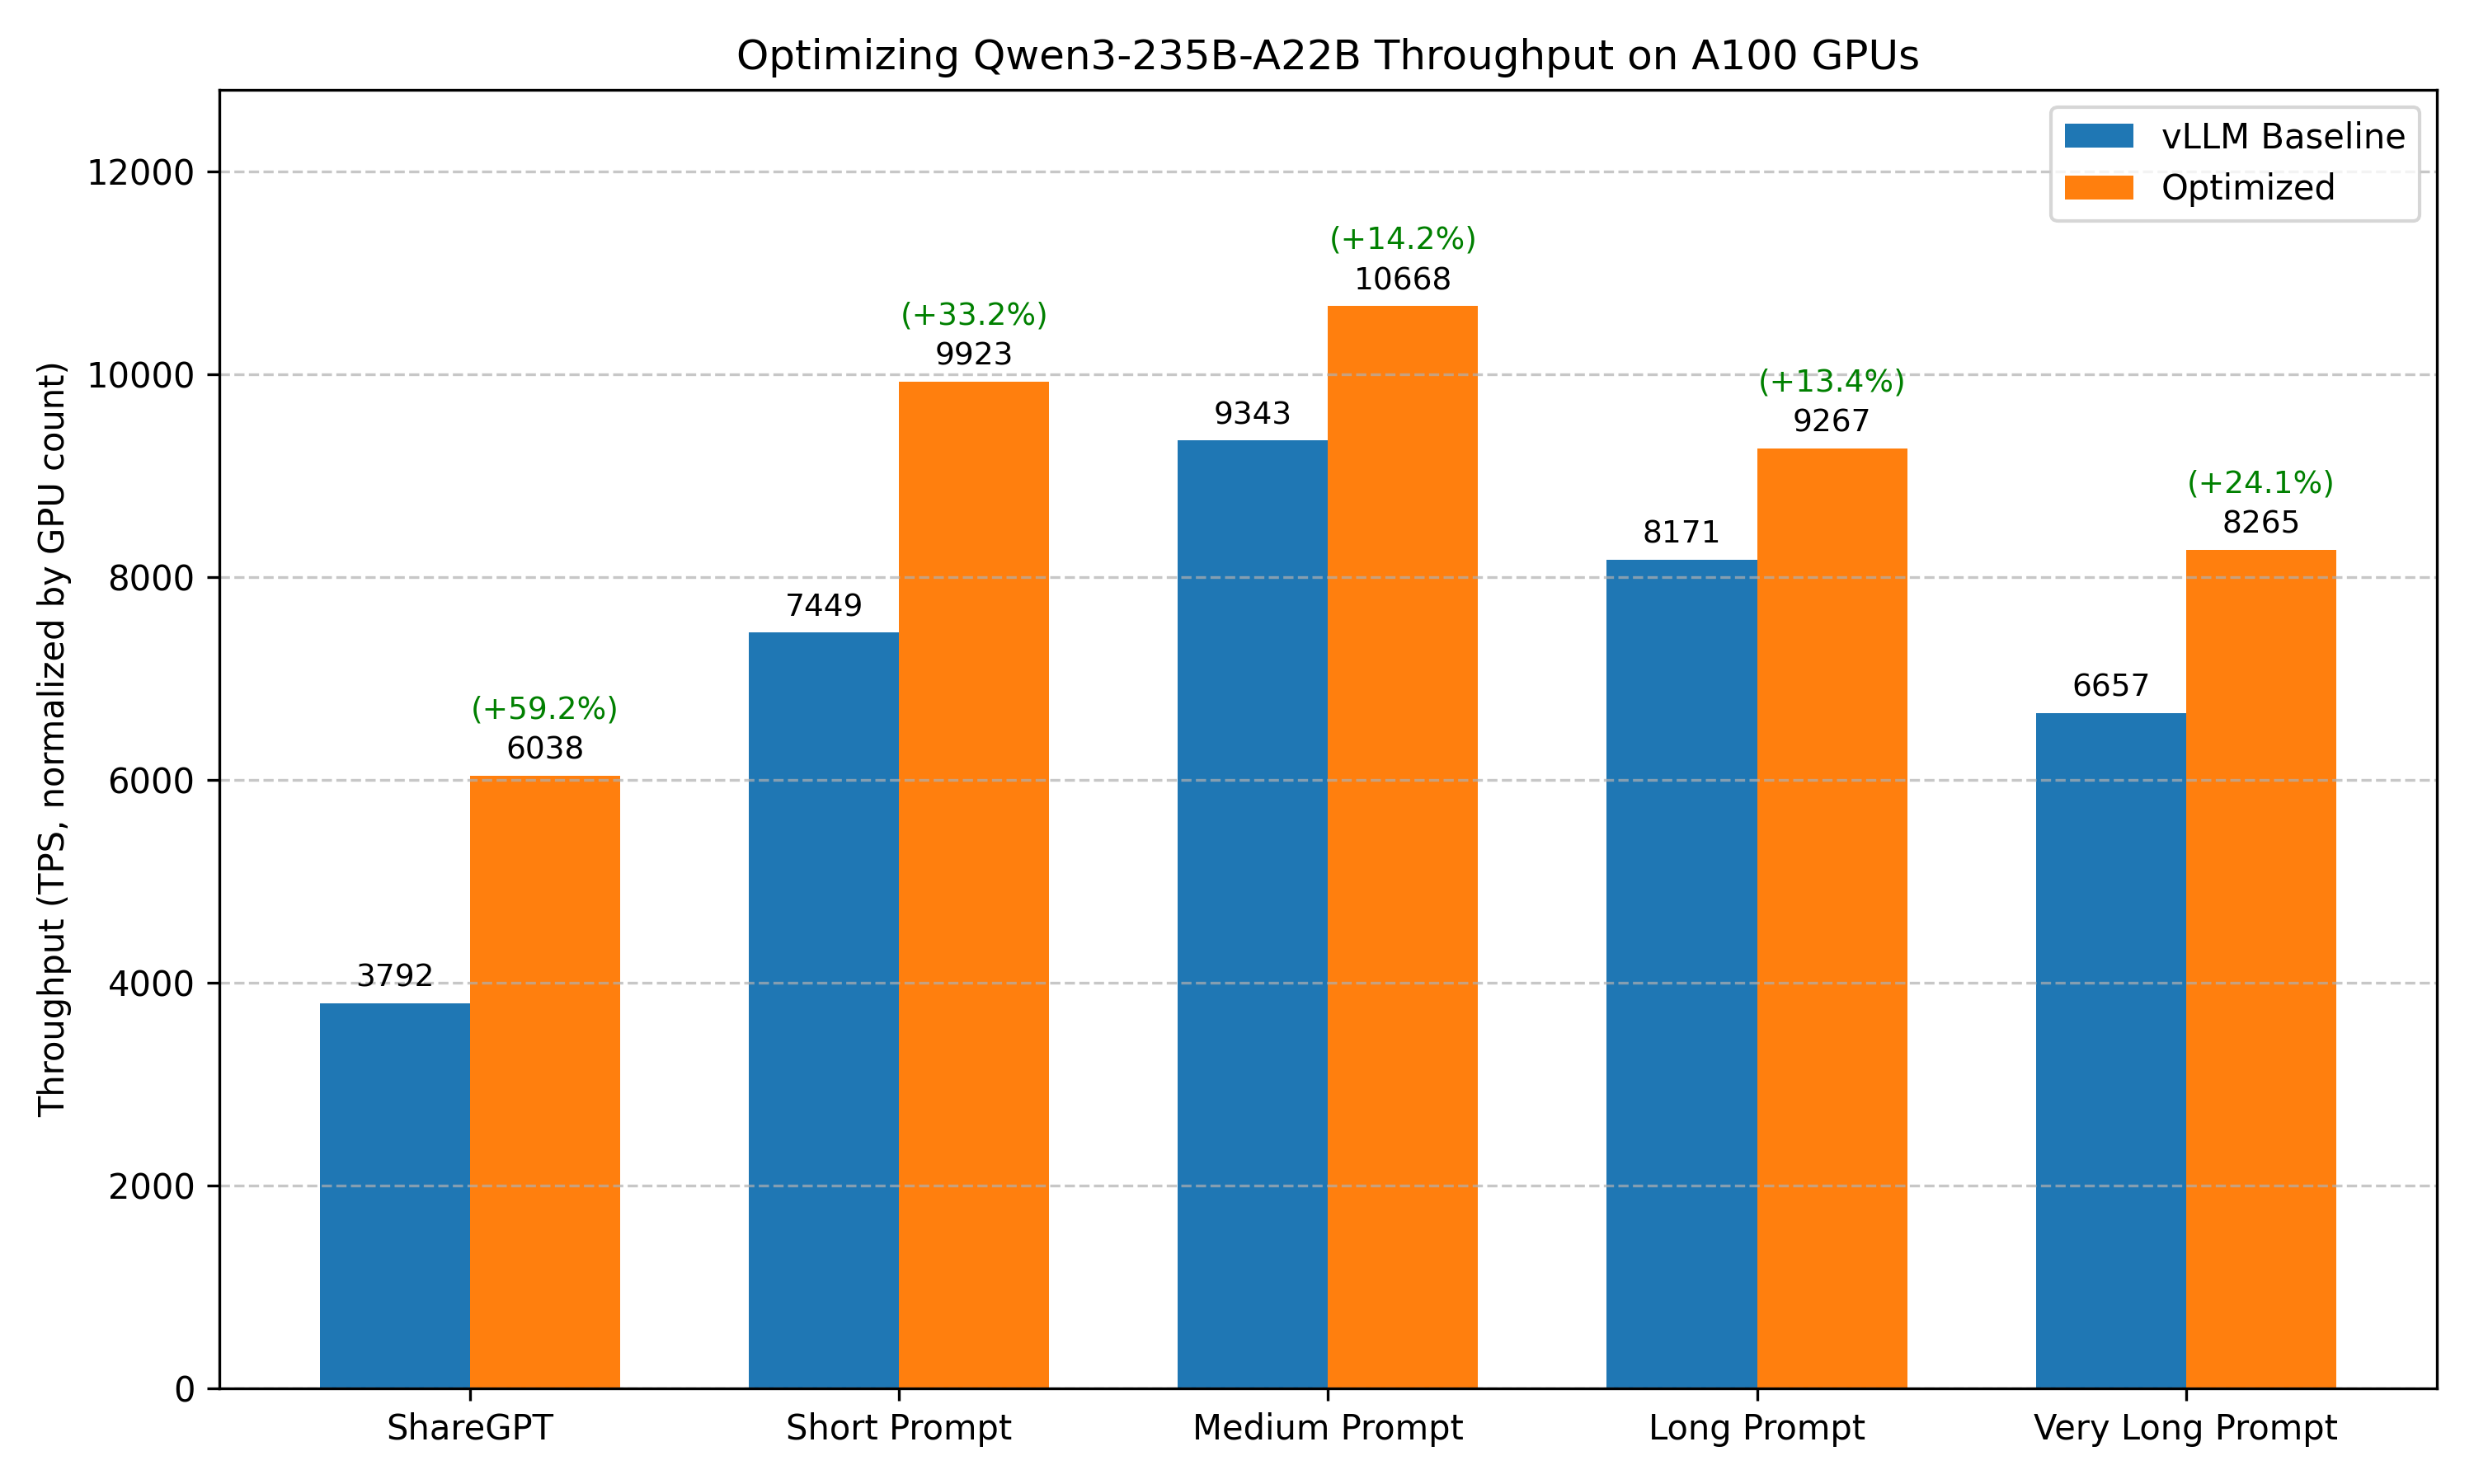
NVIDIA A100 GPUs 上的 Qwen3-235B-A22B 吞吐量优化 结论
Qwen3-235B-A22B-Instruct-2507 在 A100 GPUs 上的吞吐量优化推荐配置:
推理服务命令 serve Qwen/Qwen3-235B-A22B-Instruct-2507-FP8 -tp 4
优化前后的基准测试结果对比:
基准测试用例 基准配置(未做任何优化的 vLLM) 优化后 ShareGPT Total TPS: 3792.50 Total TPS: 3019.19x2 (+59.2%) 短提示词 Total TPS: 7449.43 Total TPS: 4961.66x2 (+33.2%) 中等长度提示词 Total TPS: 9342.67 Total TPS: 5333.91x2 (+14.2%) 长提示词 Total TPS: 8170.72 Total TPS: 4633.41x2 (+13.4%) 超长提示词 Total TPS: 6657.49 Total TPS: 4132.51x2 (+24.1%)
说明
基准测试未覆盖所有可能的优化组合。例如,我们会选择默认配置下表现最好的推理引擎作为后续调优的起点。这种剪枝方式得到的是局部最优解,未必是全局最优解。 其他优化方法取决于具体使用场景,包括最大批大小、调度配置、扩展 KV cache、CUDA graph、Torch Compile 等。本文结论可作为进一步针对性优化的起点。 测试基于特定的硬件和软件环境。推理引擎的改进可能带来新的结论。 量化可能影响准确率,但对于大多数模型,FP8 量化的准确率下降可控制在 1% 以内。详情参见评估结果 。因此,强烈建议在高吞吐量推理服务场景中使用 FP8 量化。 如有遗漏或需要根据最新变化更新的内容,请告诉我们 。
优化目标 在高并发请求场景下实现高吞吐量。
实验环境 模型 Qwen3-235B-A22B-Instruct-2507
硬件 单节点配备 8 × NVIDIA A100 SXM 80GB GPU。
引擎版本 vLLM: v0.11.0 SGLang: v0.5.5.post1 基准测试数据集 ShareGPT 不同序列长度的随机数据集: 超长提示词:32000 输入 tokens,100 输出 tokens 长提示词:4000 输入 tokens,200 输出 tokens 中等长度提示词:2000 输入 tokens,100 输出 tokens 短提示词:128 输入 tokens,4 输出 tokens 基准测试脚本 使用 vLLM bench CLI 工具对模型性能进行基准测试。运行基准测试的命令如下:
# Prepare the ShareGPT dataset
https://huggingface.co/datasets/anon8231489123/ShareGPT_Vicuna_unfiltered/resolve/main/ShareGPT_V3_unfiltered_cleaned_split.json
# Benchmark on ShareGPT dataset
bench serve --model Qwen/Qwen3-235B-A22B-Instruct-2507 --backend openai-chat --endpoint /v1/chat/completions --dataset-name sharegpt --dataset-path ShareGPT_V3_unfiltered_cleaned_split.json --num-prompts 1000
# Benchmark on random dataset (fixed seed for reproducibility)
bench serve --model Qwen/Qwen3-235B-A22B-Instruct-2507 --backend openai-chat --endpoint /v1/chat/completions --dataset-name random --random-input-len 4000 --random-output-len 200 --num-prompts 500 --seed 42
实验结果 1. 选择推理引擎 vLLM
推理服务脚本 serve Qwen/Qwen3-235B-A22B-Instruct-2507 -tp 8
基准测试结果
SGLang
推理服务脚本 -m sglang.launch_server --model-path Qwen/Qwen3-235B-A22B-Instruct-2507 --tp-size 8
基准测试结果
结果:SGLang(4635.31 tok/s) > vLLM (3792.50 tok/s)
2. vLLM 中的 量化 SGLang 无法在 A100 GPU 上运行 FP8 量化模型。vLLM 通过 Marlin 内核支持在 A100 GPU 上以 w8a16 量化方式运行。
vLLM FP8
推理服务脚本 # TP8 only is not compatible for the model weight. Use EP as well.
serve Qwen/Qwen3-235B-A22B-Instruct-2507-FP8 -tp 8 --enable-expert-parallel
基准测试结果
3. vLLM 中的 并行策略 TP4
推理服务脚本 serve Qwen/Qwen3-235B-A22B-Instruct-2507-FP8 -tp 4
基准测试结果
TP4 EP4
推理服务脚本 serve Qwen/Qwen3-235B-A22B-Instruct-2507-FP8 -tp 4 --enable-expert-parallel
基准测试结果
4. vLLM 中的 最大批处理 Token 数 推理服务脚本 serve Qwen/Qwen3-235B-A22B-Instruct-2507-FP8 -tp 4 --max-num-batched-tokens 4096
基准测试结果
优化选项汇总 优化选项 吞吐量提升 引擎选择 +22.2% 量化 - 并行策略 +59.2% 注意力后端 - 最大批处理 Token 数 -
其他基准测试用例 我们进一步对优化后的配置进行了基准测试,评估其在不同工作负载下的泛化表现。
基准配置的推理服务脚本 serve Qwen/Qwen3-235B-A22B-Instruct-2507 -tp 8
基准配置的测试结果 # random 32K input
============ Serving Benchmark Result ============
requests: 100
duration ( s) : 481 .89
input tokens: 3200000
generated tokens: 8191
throughput ( req/s) : 0 .21
token throughput ( tok/s) : 17 .00
output token throughput ( tok/s) : 140 .00
concurrent requests: 100 .00
Token throughput ( tok/s) : 6657 .49
to First Token----------------
TTFT ( ms) : 240229 .05
TTFT ( ms) : 240137 .10
TTFT ( ms) : 475251 .39
per Output Token ( excl. 1st token) ------
TPOT ( ms) : 298 .86
TPOT ( ms) : 307 .94
TPOT ( ms) : 311 .82
Latency----------------
ITL ( ms) : 295 .13
ITL ( ms) : 303 .36
ITL ( ms) : 370 .10
==================================================
# random 4K input
============ Serving Benchmark Result ============
requests: 500
duration ( s) : 255 .70
input tokens: 1997942
generated tokens: 91352
throughput ( req/s) : 1 .96
token throughput ( tok/s) : 357 .26
output token throughput ( tok/s) : 1403 .00
concurrent requests: 500 .00
Token throughput ( tok/s) : 8170 .72
to First Token----------------
TTFT ( ms) : 122190 .64
TTFT ( ms) : 121615 .01
TTFT ( ms) : 244882 .42
per Output Token ( excl. 1st token) ------
TPOT ( ms) : 205 .64
TPOT ( ms) : 220 .33
TPOT ( ms) : 237 .80
Latency----------------
ITL ( ms) : 204 .69
ITL ( ms) : 239 .57
ITL ( ms) : 246 .21
==================================================
# random 2K input
============ Serving Benchmark Result ============
requests: 500
duration ( s) : 112 .15
input tokens: 998175
generated tokens: 49632
throughput ( req/s) : 4 .46
token throughput ( tok/s) : 442 .54
output token throughput ( tok/s) : 1691 .00
concurrent requests: 500 .00
Token throughput ( tok/s) : 9342 .67
to First Token----------------
TTFT ( ms) : 54722 .50
TTFT ( ms) : 54532 .60
TTFT ( ms) : 106756 .03
per Output Token ( excl. 1st token) ------
TPOT ( ms) : 190 .79
TPOT ( ms) : 208 .61
TPOT ( ms) : 209 .09
Latency----------------
ITL ( ms) : 189 .23
ITL ( ms) : 208 .52
ITL ( ms) : 211 .58
==================================================
# random 128 input
============ Serving Benchmark Result ============
requests: 1000
duration ( s) : 17 .68
input tokens: 127698
generated tokens: 4000
throughput ( req/s) : 56 .56
token throughput ( tok/s) : 226 .26
output token throughput ( tok/s) : 948 .00
concurrent requests: 1000 .00
Token throughput ( tok/s) : 7449 .43
to First Token----------------
TTFT ( ms) : 12767 .63
TTFT ( ms) : 12409 .68
TTFT ( ms) : 17339 .37
per Output Token ( excl. 1st token) ------
TPOT ( ms) : 155 .16
TPOT ( ms) : 158 .22
TPOT ( ms) : 168 .04
Latency----------------
ITL ( ms) : 116 .37
ITL ( ms) : 157 .64
ITL ( ms) : 179 .04
==================================================
优化后的推理服务脚本 serve Qwen/Qwen3-235B-A22B-Instruct-2507-FP8 -tp 4
优化后的测试结果 # random 32K input
============ Serving Benchmark Result ============
requests: 100
duration ( s) : 776 .36
input tokens: 3200000
generated tokens: 8300
throughput ( req/s) : 0 .13
token throughput ( tok/s) : 10 .69
output token throughput ( tok/s) : 152 .00
concurrent requests: 100 .00
Token throughput ( tok/s) : 4132 .51
to First Token----------------
TTFT ( ms) : 387908 .55
TTFT ( ms) : 387968 .52
TTFT ( ms) : 766523 .82
per Output Token ( excl. 1st token) ------
TPOT ( ms) : 481 .71
TPOT ( ms) : 496 .29
TPOT ( ms) : 513 .27
Latency----------------
ITL ( ms) : 476 .10
ITL ( ms) : 490 .85
ITL ( ms) : 612 .03
==================================================
# random 4K input
============ Serving Benchmark Result ============
requests: 500
duration ( s) : 450 .71
input tokens: 1997942
generated tokens: 90389
throughput ( req/s) : 1 .11
token throughput ( tok/s) : 200 .55
output token throughput ( tok/s) : 1066 .00
concurrent requests: 500 .00
Token throughput ( tok/s) : 4633 .41
to First Token----------------
TTFT ( ms) : 216485 .01
TTFT ( ms) : 215365 .76
TTFT ( ms) : 436587 .02
per Output Token ( excl. 1st token) ------
TPOT ( ms) : 347 .13
TPOT ( ms) : 371 .93
TPOT ( ms) : 412 .29
Latency----------------
ITL ( ms) : 344 .46
ITL ( ms) : 425 .81
ITL ( ms) : 436 .76
==================================================
# random 2K input
============ Serving Benchmark Result ============
requests: 500
duration ( s) : 196 .42
input tokens: 998175
generated tokens: 49495
throughput ( req/s) : 2 .55
token throughput ( tok/s) : 251 .99
output token throughput ( tok/s) : 1116 .00
concurrent requests: 500 .00
Token throughput ( tok/s) : 5333 .91
to First Token----------------
TTFT ( ms) : 95261 .76
TTFT ( ms) : 94982 .78
TTFT ( ms) : 189238 .63
per Output Token ( excl. 1st token) ------
TPOT ( ms) : 342 .39
TPOT ( ms) : 376 .64
TPOT ( ms) : 377 .99
Latency----------------
ITL ( ms) : 339 .59
ITL ( ms) : 376 .62
ITL ( ms) : 380 .69
==================================================
# random 128 input
============ Serving Benchmark Result ============
requests: 1000
duration ( s) : 26 .54
input tokens: 127698
generated tokens: 4000
throughput ( req/s) : 37 .67
token throughput ( tok/s) : 150 .70
output token throughput ( tok/s) : 311 .00
concurrent requests: 1000 .00
Token throughput ( tok/s) : 4961 .66
to First Token----------------
TTFT ( ms) : 17260 .17
TTFT ( ms) : 17240 .71
TTFT ( ms) : 26154 .32
per Output Token ( excl. 1st token) ------
TPOT ( ms) : 265 .87
TPOT ( ms) : 272 .95
TPOT ( ms) : 278 .77
Latency----------------
ITL ( ms) : 199 .40
ITL ( ms) : 272 .50
ITL ( ms) : 288 .23
==================================================