NVIDIA H200 GPUs 上的 DeepSeek-R1 吞吐量优化 结论
在配备 H200x8 的单节点上优化 DeepSeek-R1 吞吐量的推荐配置:
推理服务命令 -m sglang.launch_server --model deepseek-ai/DeepSeek-R1-0528 --tp 8 --enable-dp-attention
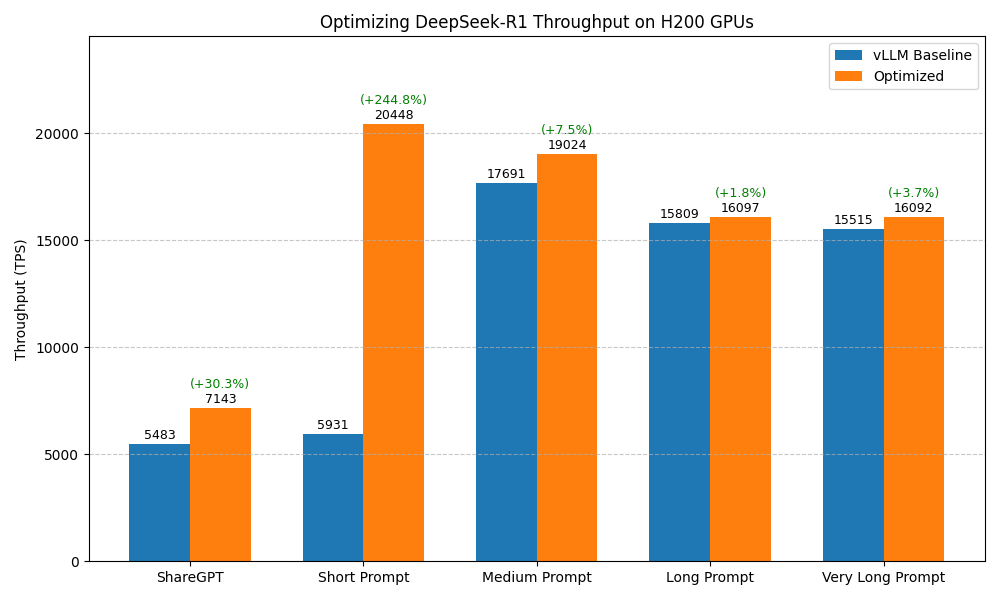
优化前后的基准测试结果对比:
基准测试用例 基准配置(未做任何优化的 vLLM) 优化后 ShareGPT Total TPS: 5482.59 Total TPS: 7143.30 (+30.3%) 短提示词 Total TPS: 5931.25 Total TPS: 20448.42 (+244.8%) 中等长度提示词 Total TPS: 17690.89 Total TPS: 19024.33 (+7.5%) 长提示词 Total TPS: 15808.55 Total TPS: 16096.80 (+1.8%) 超长提示词 Total TPS: 15514.57 Total TPS: 16091.68 (+3.7%)
说明
基准测试未覆盖所有可能的优化组合。例如,我们会选择默认配置下表现最好的推理引擎作为后续调优的起点。这种剪枝方式得到的是局部最优解,未必是全局最优解。 其他优化方法取决于具体使用场景,包括最大批大小、调度配置、扩展 KV cache、CUDA graph 等。本文结论可作为进一步针对性优化的起点。 测试基于特定的硬件和软件环境。推理引擎的改进可能带来新的结论。 如有遗漏或需要根据最新变化更新的内容,请告诉我们 。
优化目标 在高并发请求场景下实现高吞吐量。
实验环境 模型 deepseek-ai/DeepSeek-R1-0528
硬件 单节点配备 8 × NVIDIA H200 SXM GPU。
引擎版本 vLLM: v0.11.0 SGLang: v0.5.3 TensorRT-LLM : v1.0.0 基准测试数据集 ShareGPT 不同序列长度的随机数据集: 超长提示词:32000 输入 tokens,100 输出 tokens 长提示词:4000 输入 tokens,200 输出 tokens 中等长度提示词:2000 输入 tokens,100 输出 tokens 短提示词:128 输入 tokens,4 输出 tokens 基准测试脚本 使用 vLLM bench CLI 工具对模型性能进行基准测试。运行基准测试的命令如下:
# Prepare the ShareGPT dataset
https://huggingface.co/datasets/anon8231489123/ShareGPT_Vicuna_unfiltered/resolve/main/ShareGPT_V3_unfiltered_cleaned_split.json
# Benchmark on ShareGPT dataset
bench serve --model deepseek-ai/DeepSeek-R1-0528 --backend openai-chat --endpoint /v1/chat/completions --dataset-name sharegpt --dataset-path ShareGPT_V3_unfiltered_cleaned_split.json --num-prompts 1000
# Benchmark on random dataset (fixed seed for reproducibility)
bench serve --model deepseek-ai/DeepSeek-R1-0528 --backend openai-chat --endpoint /v1/chat/completions --dataset-name random --random-input-len 4000 --random-output-len 200 --num-prompts 500 --seed 42
实验结果 1. 选择推理引擎 vLLM
推理服务脚本 serve deepseek-ai/DeepSeek-R1-0528 -tp 8
基准测试结果
SGLang
推理服务脚本 -m sglang.launch_server --model-path deepseek-ai/DeepSeek-R1-0528 --host 0 .0.0.0 --port 8000 --tp-size 8
基准测试结果
TensorRT-LLM
推理服务脚本 /workspace/DeepSeek-R1-0528 --tp_size 8 --ep_size 8
基准测试结果
结果:SGLang(6635.73 tok/s) > vLLM (5482.59 tok/s) > TensorRT-LLM (3385.88 tok/s)
2. SGLang 中的 并行策略 TP+DP Attention
推理服务脚本 -m sglang.launch_server --model-path deepseek-ai/DeepSeek-R1-0528 --host 0 .0.0.0 --port 8000 --tp-size 8 --enable-dp-attention
基准测试结果
3. SGLang 中的 Torch.compile 推理服务脚本 -m sglang.launch_server --model-path deepseek-ai/DeepSeek-R1-0528 --host 0 .0.0.0 --port 8000 --tp-size 8 --enable-dp-attention --enable-torch-compile
基准测试结果
4. SGLang 中的 MTP 推理服务脚本 -m sglang.launch_server --model-path deepseek-ai/DeepSeek-R1-0528 --host 0 .0.0.0 --port 8000 --tp-size 8 --enable-dp-attention --enable-torch-compile --speculative-algorithm EAGLE --speculative-num-steps 1 --speculative-eagle-topk 1 --speculative-num-draft-tokens 2
基准测试结果
优化选项汇总 优化选项 吞吐量提升 引擎选择 +21.0% 并行策略 +7.6% Torch Compile - MTP -
其他基准测试用例 我们进一步对优化后的配置进行了基准测试,评估其在不同工作负载下的泛化表现。
基准配置的推理服务脚本 serve deepseek-ai/DeepSeek-R1-0528 -tp 8
基准配置的测试结果 # random 32K input
============ Serving Benchmark Result ============
requests: 100
duration ( s) : 206 .90
input tokens: 3199900
generated tokens: 10000
throughput ( req/s) : 0 .48
token throughput ( tok/s) : 48 .33
output token throughput ( tok/s) : 498 .00
concurrent requests: 100 .00
Token throughput ( tok/s) : 15514 .57
to First Token----------------
TTFT ( ms) : 101351 .99
TTFT ( ms) : 101163 .80
TTFT ( ms) : 200267 .68
per Output Token ( excl. 1st token) ------
TPOT ( ms) : 365 .79
TPOT ( ms) : 400 .72
TPOT ( ms) : 404 .78
Latency----------------
ITL ( ms) : 362 .20
ITL ( ms) : 459 .96
ITL ( ms) : 614 .75
==================================================
# random 4K input
============ Serving Benchmark Result ============
requests: 500
duration ( s) : 132 .68
input tokens: 1997530
generated tokens: 100000
throughput ( req/s) : 3 .77
token throughput ( tok/s) : 753 .67
output token throughput ( tok/s) : 2922 .00
concurrent requests: 500 .00
Token throughput ( tok/s) : 15808 .55
to First Token----------------
TTFT ( ms) : 63058 .71
TTFT ( ms) : 61952 .74
TTFT ( ms) : 124112 .96
per Output Token ( excl. 1st token) ------
TPOT ( ms) : 164 .23
TPOT ( ms) : 177 .37
TPOT ( ms) : 195 .80
Latency----------------
ITL ( ms) : 163 .74
ITL ( ms) : 57 .87
ITL ( ms) : 383 .79
==================================================
# random 2K input
============ Serving Benchmark Result ============
requests: 500
duration ( s) : 59 .26
input tokens: 998393
generated tokens: 50000
throughput ( req/s) : 8 .44
token throughput ( tok/s) : 843 .71
output token throughput ( tok/s) : 4036 .00
concurrent requests: 500 .00
Token throughput ( tok/s) : 17690 .89
to First Token----------------
TTFT ( ms) : 28911 .90
TTFT ( ms) : 27559 .21
TTFT ( ms) : 53497 .07
per Output Token ( excl. 1st token) ------
TPOT ( ms) : 237 .02
TPOT ( ms) : 276 .56
TPOT ( ms) : 322 .76
Latency----------------
ITL ( ms) : 235 .10
ITL ( ms) : 357 .74
ITL ( ms) : 379 .46
==================================================
# random 128 input
============ Serving Benchmark Result ============
requests: 1000
duration ( s) : 22 .07
input tokens: 126882
generated tokens: 4000
throughput ( req/s) : 45 .32
token throughput ( tok/s) : 181 .27
output token throughput ( tok/s) : 2082 .00
concurrent requests: 1000 .00
Token throughput ( tok/s) : 5931 .25
to First Token----------------
TTFT ( ms) : 19392 .11
TTFT ( ms) : 18992 .42
TTFT ( ms) : 21440 .63
per Output Token ( excl. 1st token) ------
TPOT ( ms) : 351 .83
TPOT ( ms) : 389 .74
TPOT ( ms) : 432 .12
Latency----------------
ITL ( ms) : 263 .87
ITL ( ms) : 368 .43
ITL ( ms) : 470 .22
==================================================
# ShareGPT batch size 4
============ Serving Benchmark Result ============
requests: 100
request concurrency: 4
duration ( s) : 108 .42
input tokens: 22836
generated tokens: 21338
throughput ( req/s) : 0 .92
token throughput ( tok/s) : 196 .81
output token throughput ( tok/s) : 216 .00
concurrent requests: 9 .00
Token throughput ( tok/s) : 407 .45
to First Token----------------
TTFT ( ms) : 123 .30
TTFT ( ms) : 117 .53
TTFT ( ms) : 258 .12
per Output Token ( excl. 1st token) ------
TPOT ( ms) : 19 .36
TPOT ( ms) : 19 .13
TPOT ( ms) : 22 .67
Latency----------------
ITL ( ms) : 19 .41
ITL ( ms) : 18 .84
ITL ( ms) : 48 .61
==================================================
优化后的推理服务脚本 -m sglang.launch_server --model deepseek-ai/DeepSeek-R1-0528 --tp 8 --enable-dp-attention
优化后的测试结果 # random 32K input
============ Serving Benchmark Result ============
requests: 100
duration ( s) : 199 .47
input tokens: 3199900
generated tokens: 9952
throughput ( req/s) : 0 .50
token throughput ( tok/s) : 49 .89
output token throughput ( tok/s) : 521 .00
concurrent requests: 100 .00
Token throughput ( tok/s) : 16091 .68
to First Token----------------
TTFT ( ms) : 98133 .46
TTFT ( ms) : 97539 .39
TTFT ( ms) : 196094 .04
per Output Token ( excl. 1st token) ------
TPOT ( ms) : 198 .62
TPOT ( ms) : 198 .45
TPOT ( ms) : 365 .31
Latency----------------
ITL ( ms) : 209 .45
ITL ( ms) : 35 .27
ITL ( ms) : 1680 .63
==================================================
# random 4K input
============ Serving Benchmark Result ============
requests: 500
duration ( s) : 130 .31
input tokens: 1997530
generated tokens: 100000
throughput ( req/s) : 3 .84
token throughput ( tok/s) : 767 .42
output token throughput ( tok/s) : 3227 .00
concurrent requests: 500 .00
Token throughput ( tok/s) : 16096 .80
to First Token----------------
TTFT ( ms) : 62808 .37
TTFT ( ms) : 61113 .90
TTFT ( ms) : 122763 .87
per Output Token ( excl. 1st token) ------
TPOT ( ms) : 107 .91
TPOT ( ms) : 105 .31
TPOT ( ms) : 179 .79
Latency----------------
ITL ( ms) : 115 .81
ITL ( ms) : 46 .40
ITL ( ms) : 155 .40
==================================================
# random 2K input
============ Serving Benchmark Result ============
requests: 500
duration ( s) : 55 .11
input tokens: 998393
generated tokens: 50000
throughput ( req/s) : 9 .07
token throughput ( tok/s) : 907 .31
output token throughput ( tok/s) : 5778 .00
concurrent requests: 500 .00
Token throughput ( tok/s) : 19024 .33
to First Token----------------
TTFT ( ms) : 27248 .86
TTFT ( ms) : 25136 .93
TTFT ( ms) : 49876 .53
per Output Token ( excl. 1st token) ------
TPOT ( ms) : 154 .49
TPOT ( ms) : 148 .01
TPOT ( ms) : 294 .80
Latency----------------
ITL ( ms) : 159 .34
ITL ( ms) : 48 .78
ITL ( ms) : 801 .82
==================================================
# random 128 input
============ Serving Benchmark Result ============
requests: 1000
duration ( s) : 6 .40
input tokens: 126882
generated tokens: 4000
throughput ( req/s) : 156 .24
token throughput ( tok/s) : 624 .94
output token throughput ( tok/s) : 2769 .00
concurrent requests: 1000 .00
Token throughput ( tok/s) : 20448 .42
to First Token----------------
TTFT ( ms) : 3626 .25
TTFT ( ms) : 3413 .13
TTFT ( ms) : 4879 .78
per Output Token ( excl. 1st token) ------
TPOT ( ms) : 802 .48
TPOT ( ms) : 940 .27
TPOT ( ms) : 1182 .88
Latency----------------
ITL ( ms) : 481 .68
ITL ( ms) : 139 .56
ITL ( ms) : 3031 .24
==================================================