

概览
GPUStack 是一款开源 GPU 集群管理器,用于 AI 模型推理服务和 GPU 实例供应。它配置和编排 vLLM、SGLang、TensorRT-LLM 或您自己的推理引擎,并支持按需启动可通过 SSH 访问的 GPU 实例。
-
多集群 GPU 管理
跨本地服务器、Kubernetes 和云服务商管理 GPU 集群。支持为模型部署和 GPU 实例进行 GPU 切分,并可配置显存和计算资源配额。
-
可插拔推理引擎
自动配置 vLLM、SGLang 和 TensorRT-LLM 等高性能推理引擎,也可按需添加自定义推理引擎。
-
推理性能优化
提供低延迟和高吞吐预调优配置。支持 Prefill/Decode 分离、平台统一管理的共享 KV Cache 和推测性解码。
-
内置性能评估
扫描不同并发或请求速率下的吞吐量与延迟,帮助您选择满足性能目标的运行配置。
-
GPU 实例
按需启动可通过 SSH 访问的 GPU 实例,适用于开发、微调和交互式工作负载。
-
企业级运维
支持自动故障恢复、负载均衡、监控、身份认证和访问控制。
架构
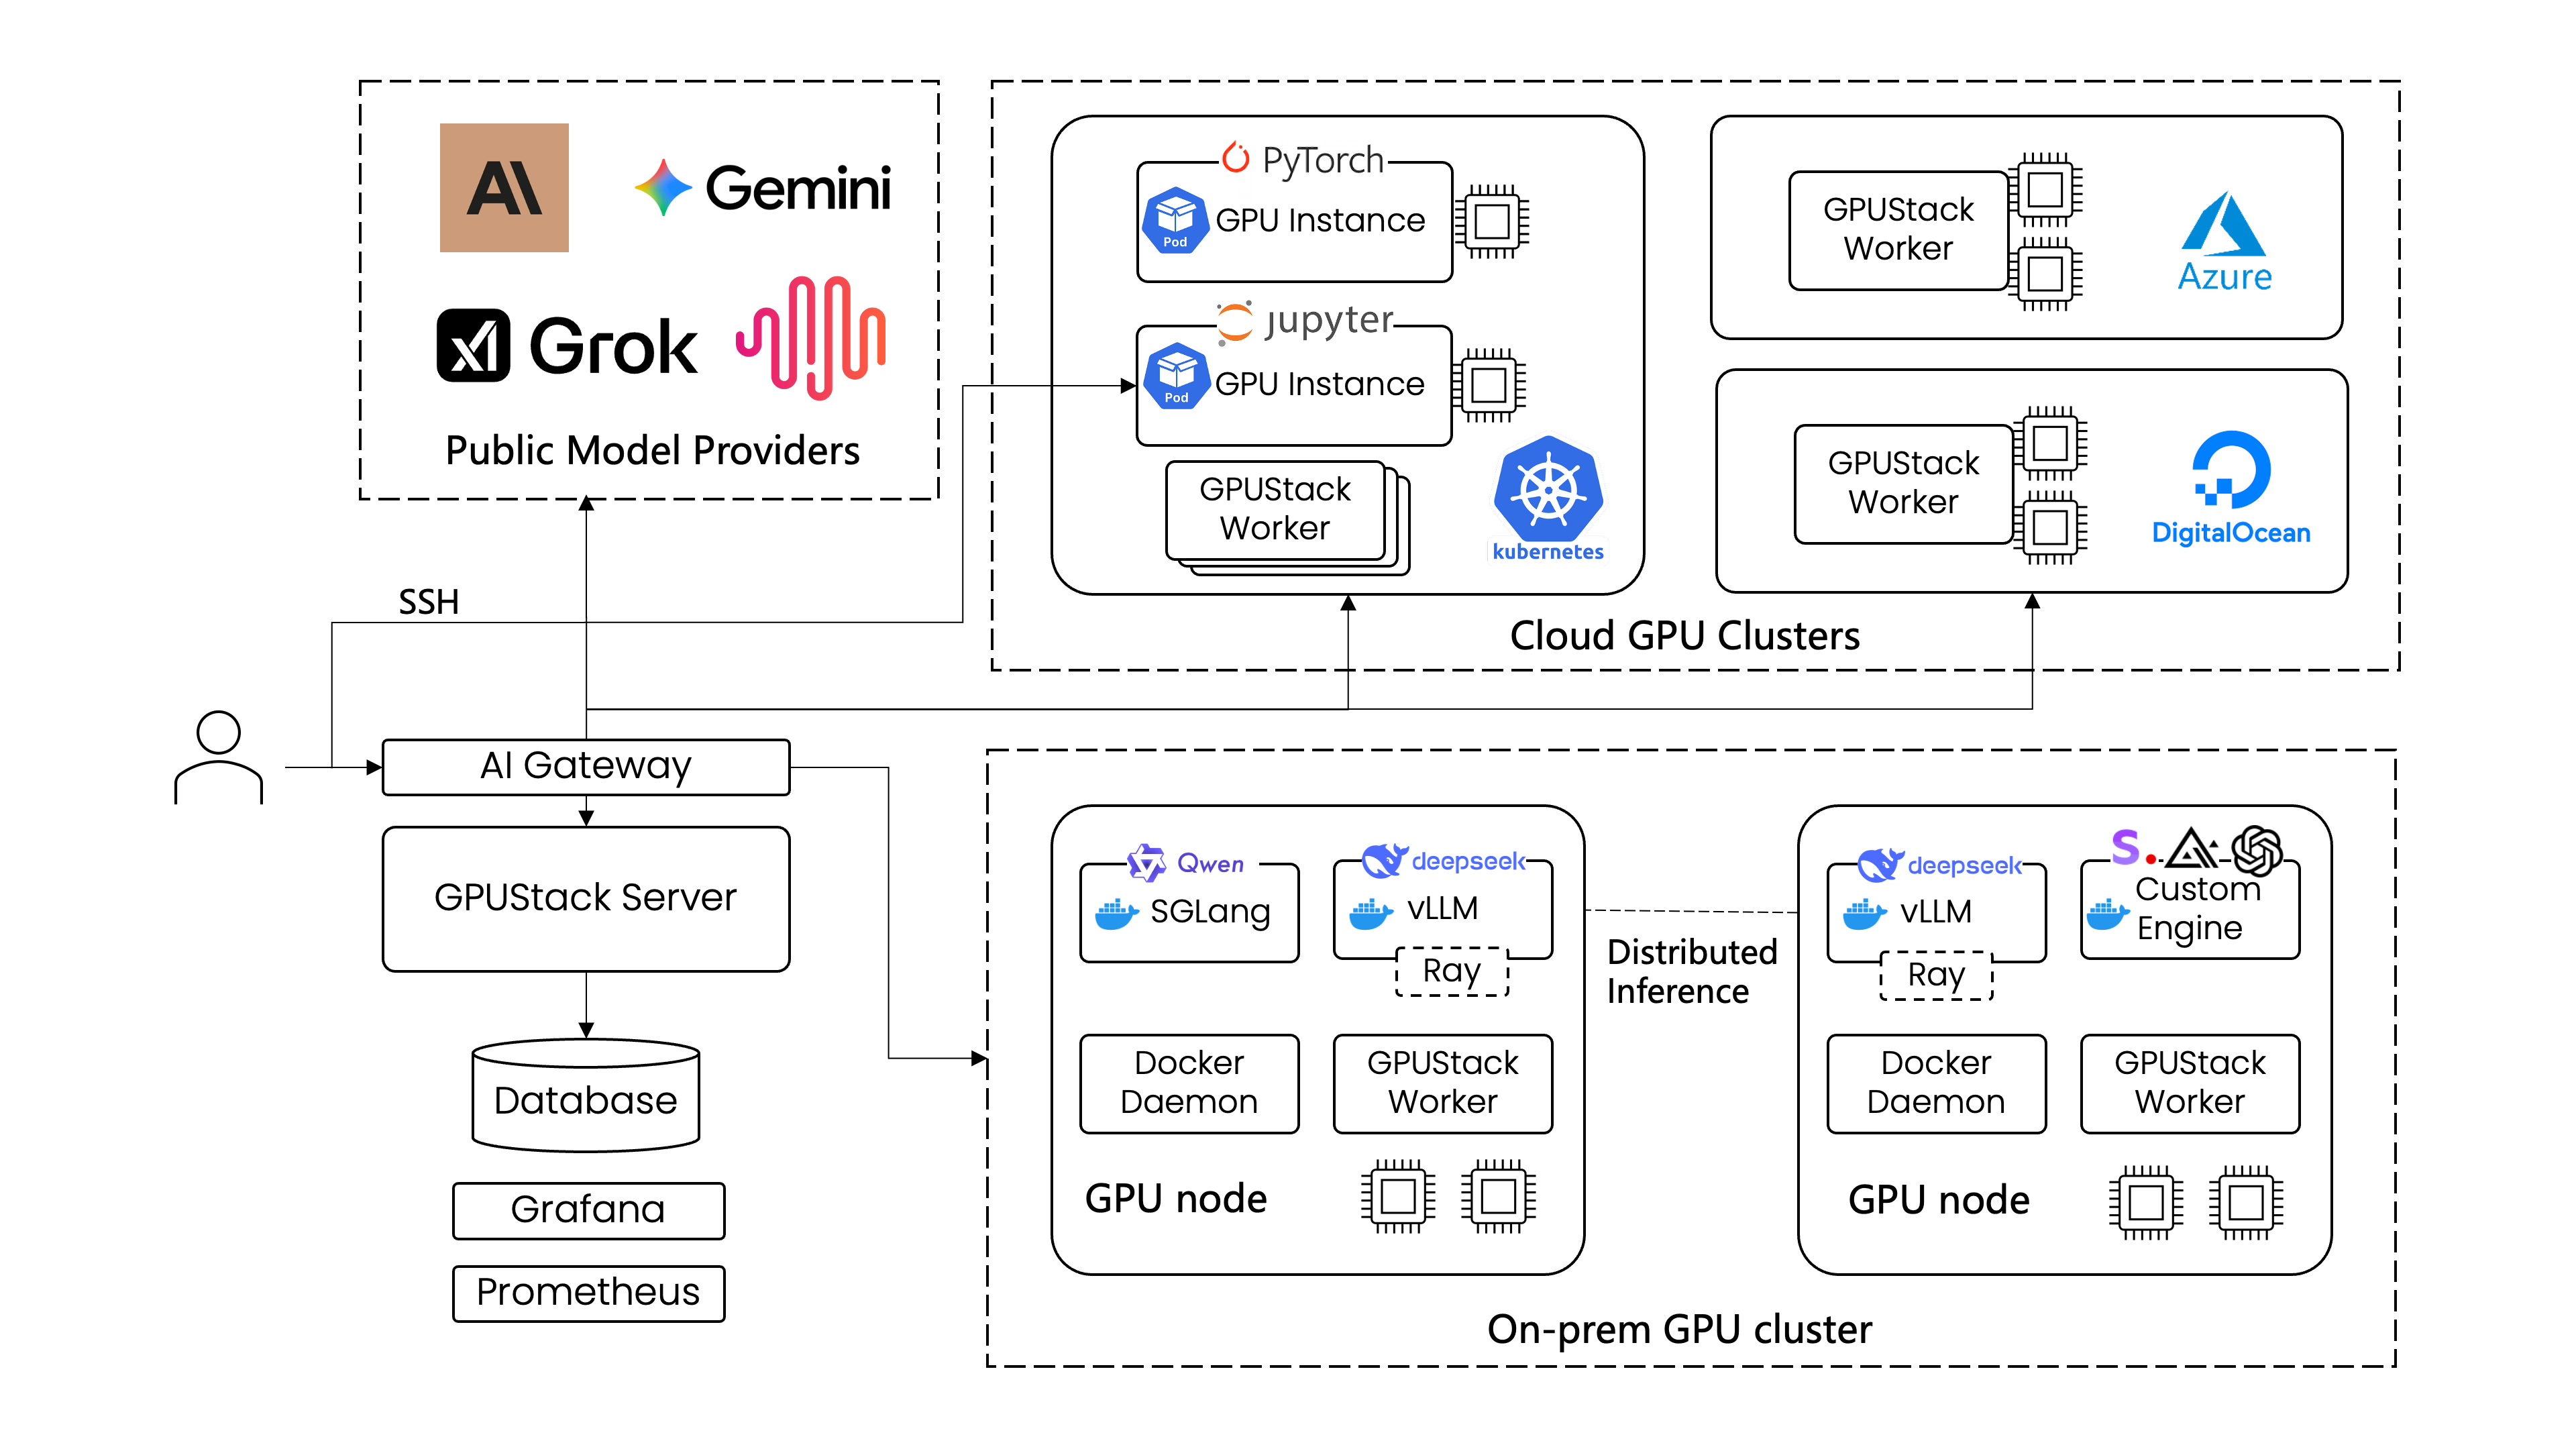
GPUStack 帮助开发团队、IT 组织和服务提供商大规模提供模型即服务(Model-as-a-Service)。它支持大语言、语音、图像和视频模型的行业标准 API,内置用户身份认证和访问控制、GPU 性能与利用率实时监控,以及 Token 用量和 API 请求速率的详细计量。
下图展示了单个 GPUStack Server 如何管理跨本地和云环境的多个 GPU 集群。GPUStack 调度器分配 GPU 以最大化资源利用率,并选择合适的推理引擎以获得最佳性能。管理员还可以通过集成的 Grafana 和 Prometheus 仪表盘,全面了解系统健康状况和各项指标。
集群状态一目了然
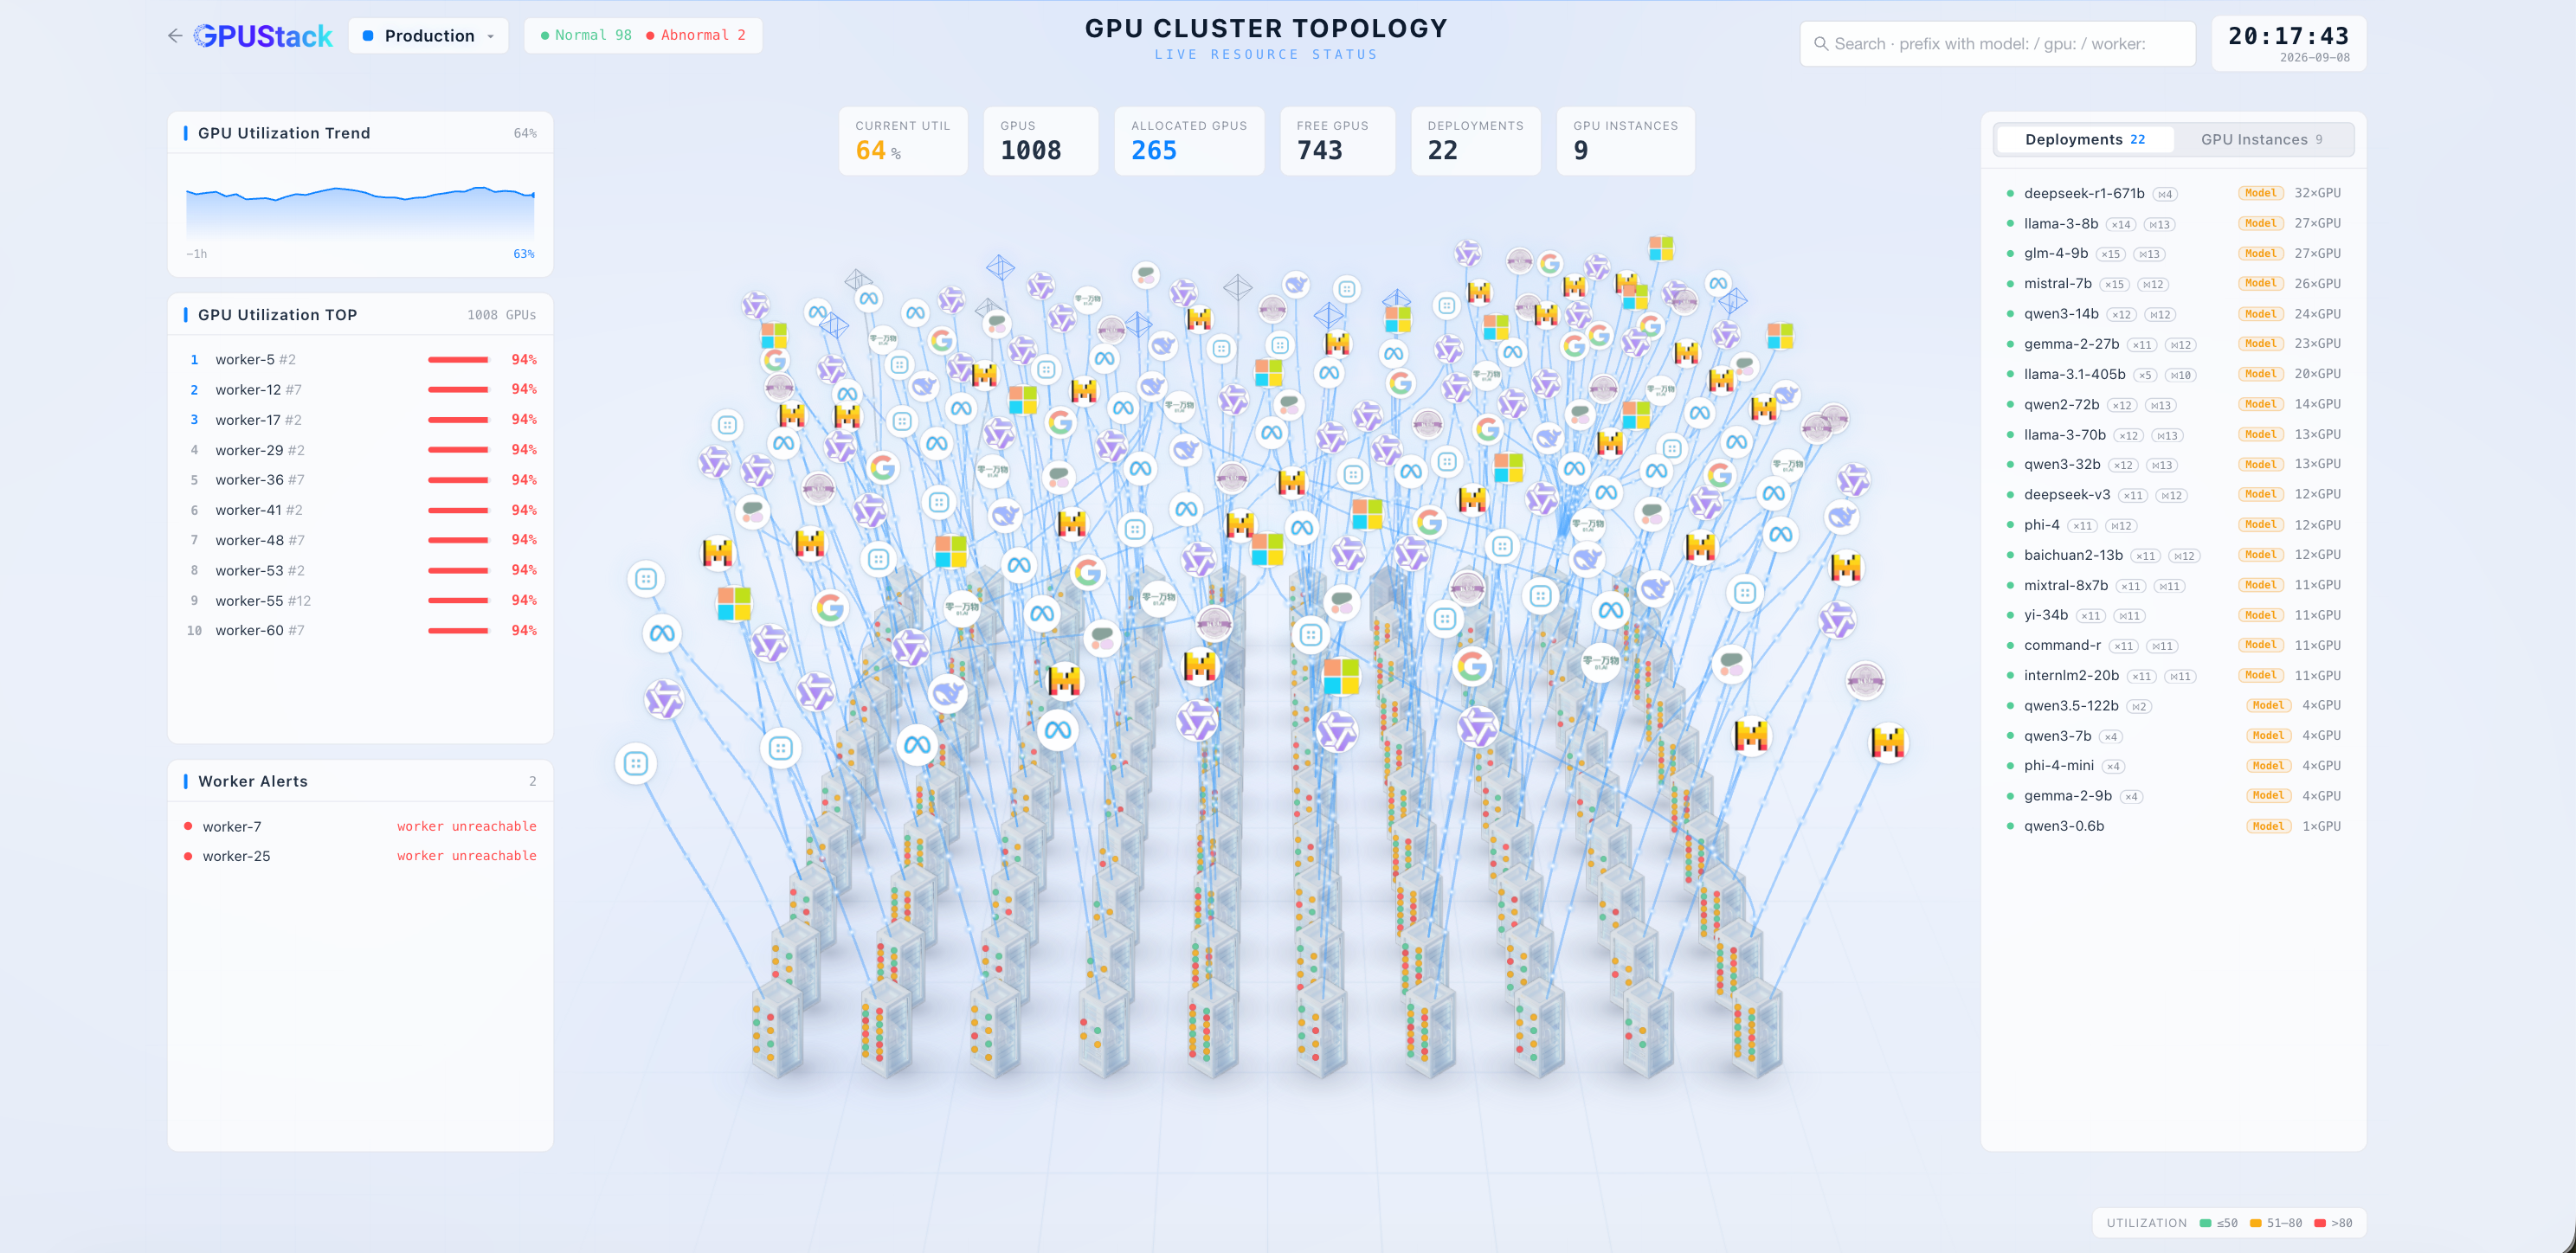
GPUStack Enterprise 的 GPU 集群拓扑视图提供整个集群体系的实时全景:在同一处查看每个 Worker、GPU 和模型部署,以及实时利用率、资源分配和健康状态。
优化推理性能
GPUStack 通过自动选择引擎和优化参数,提供开箱即用的高性能推理。下图展示了相对于 vLLM 默认配置的吞吐量提升:
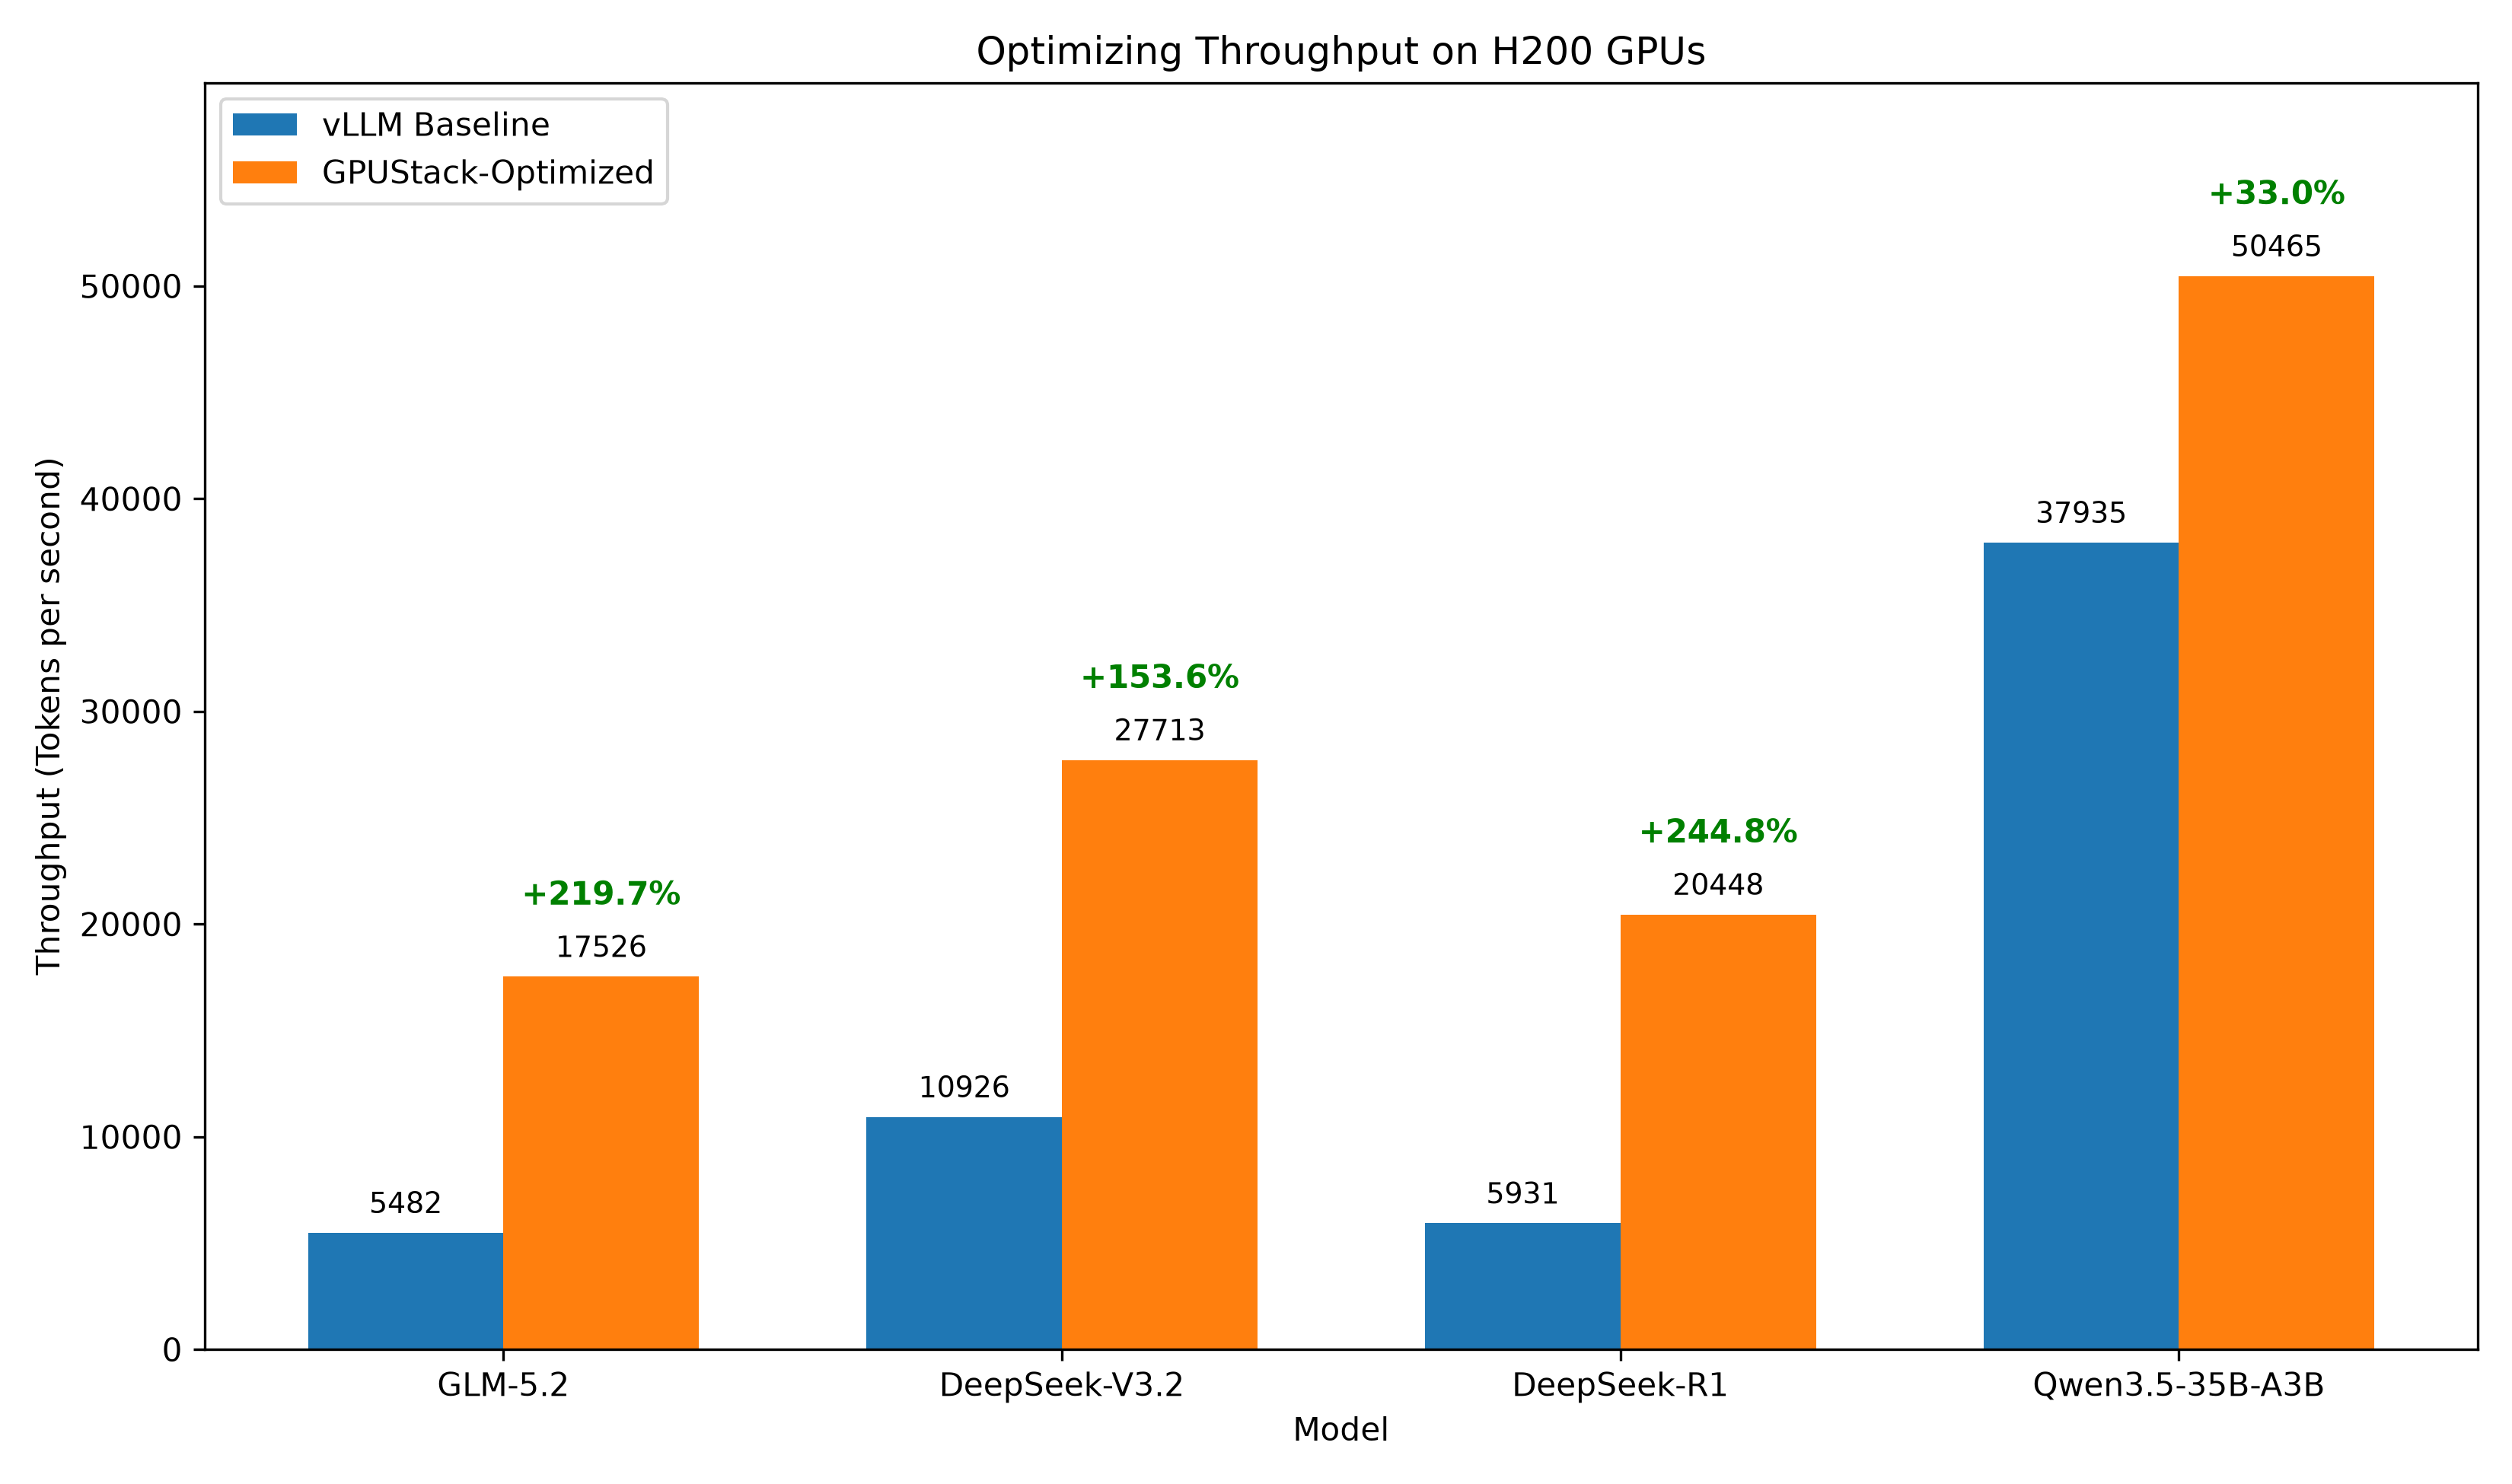
有关详细的基准测试方法和结果,请参阅推理性能实验室。
支持的加速器
GPUStack 支持多种用于 AI 推理的加速器:
有关详细要求和配置说明,请参阅安装要求。