与 Dify 集成
Dify 可接入 GPUStack,使用本地部署的 LLM、向量嵌入、重排序、图像生成、语音转文本和文本转语音能力。
部署模型
- 在 GPUStack 界面中打开
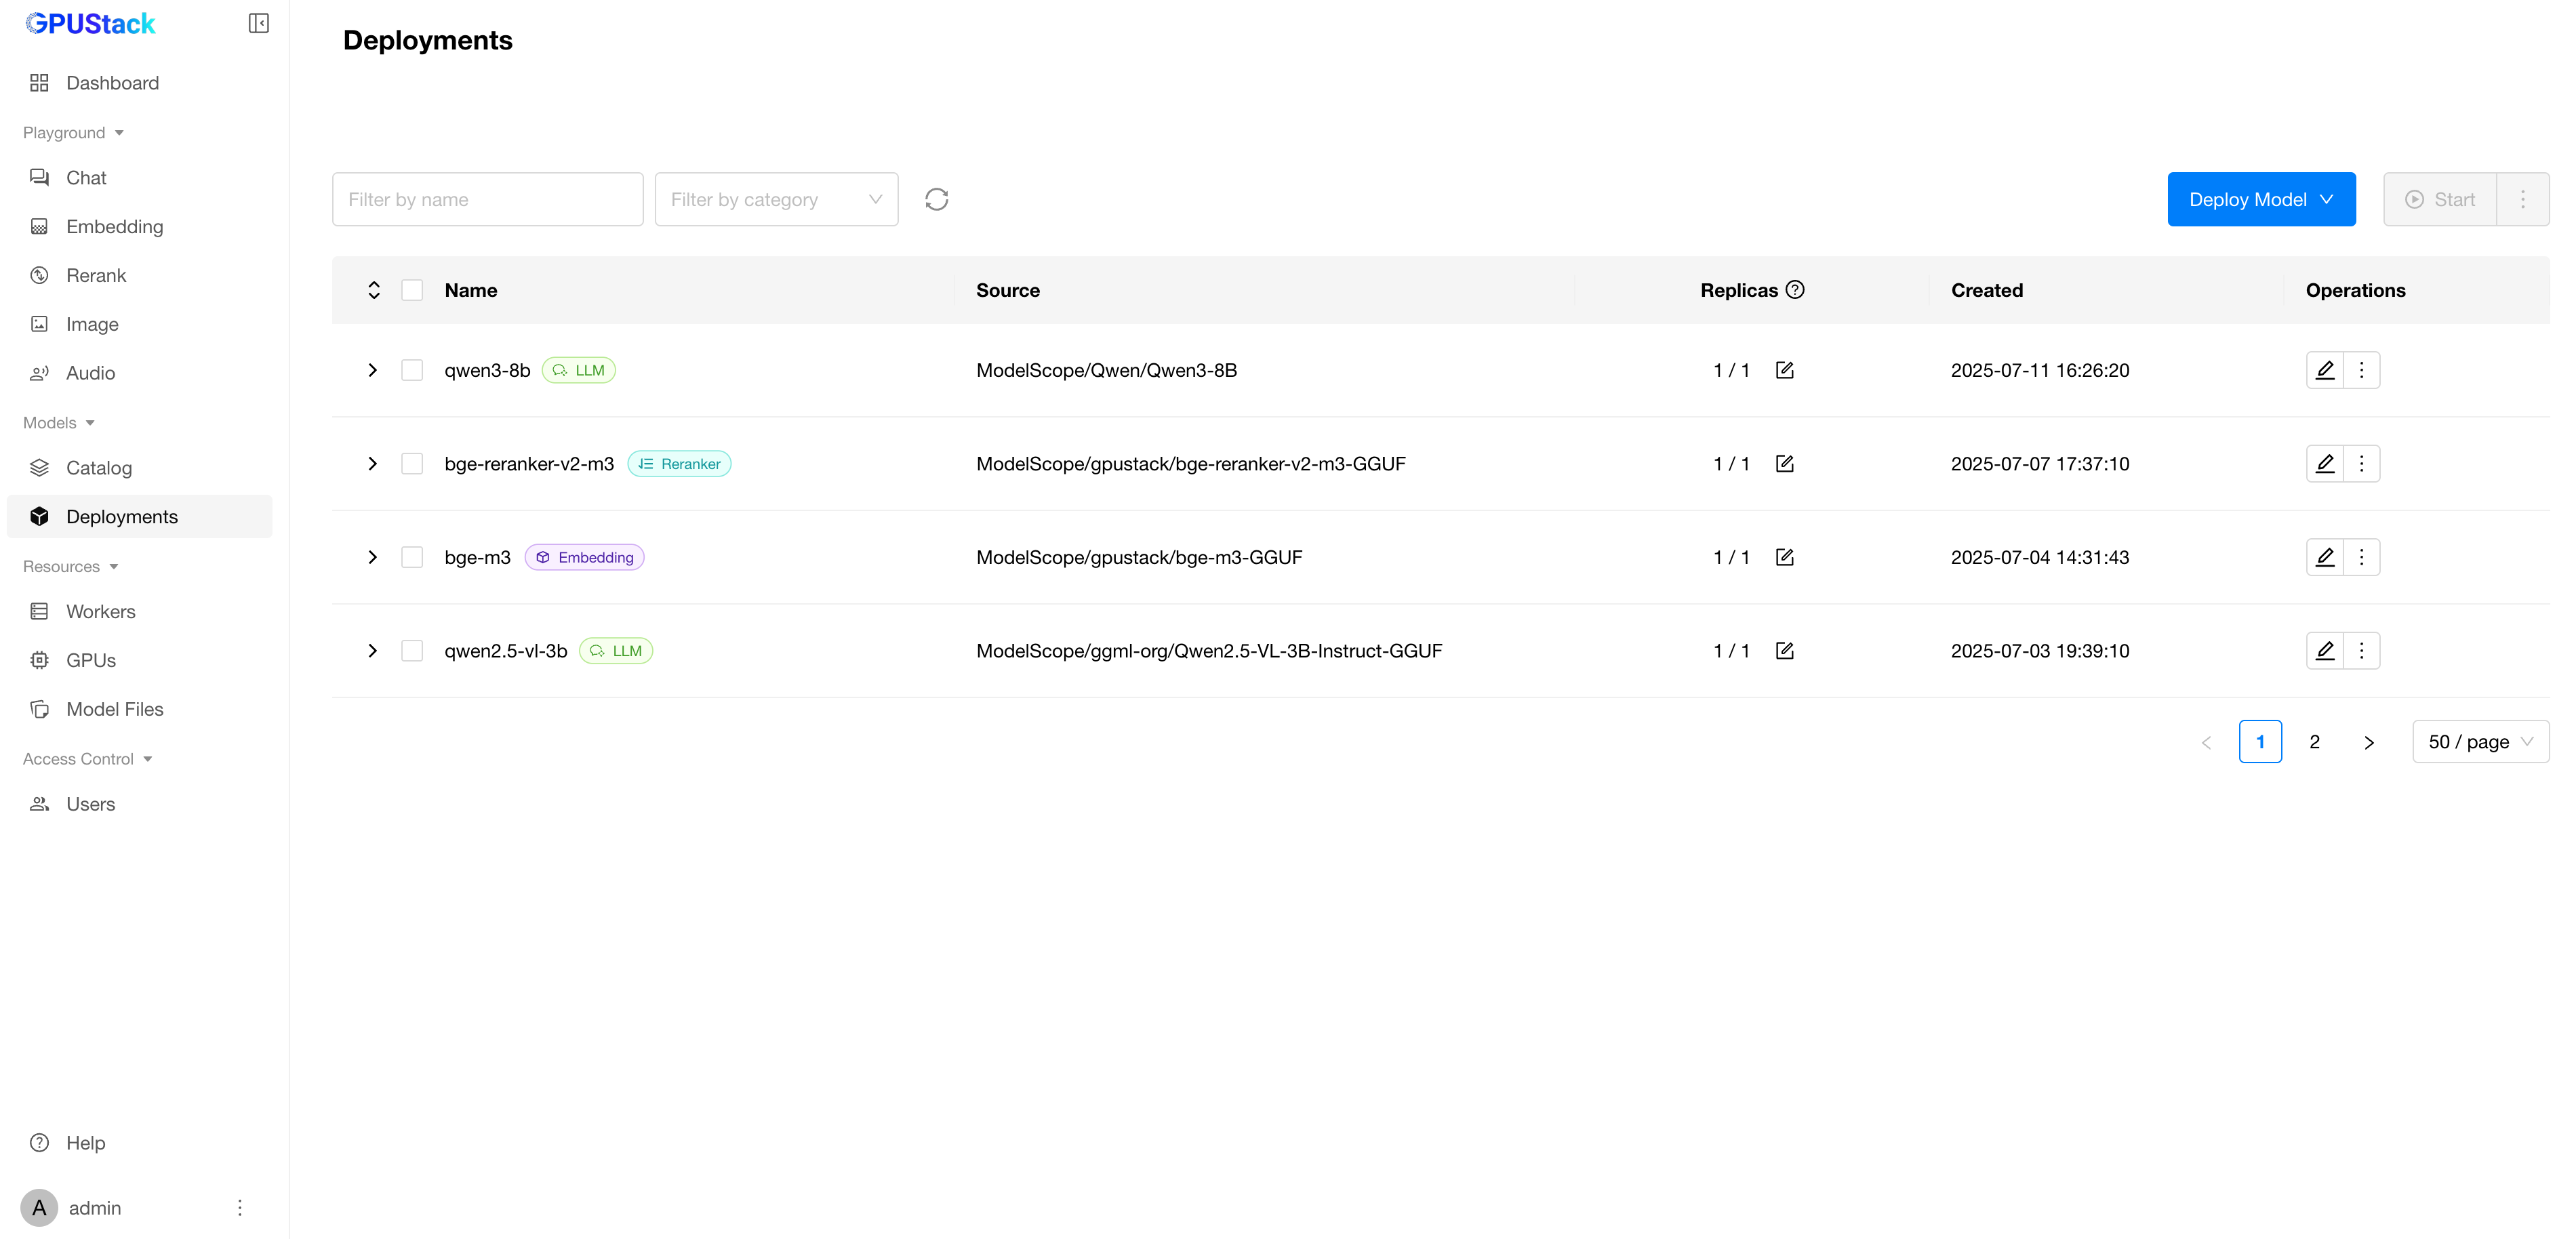
Deployments页面,点击Deploy Model部署所需模型,例如:
- qwen3-8b
- qwen2.5-vl-3b-instruct
- bge-m3
- bge-reranker-v2-m3
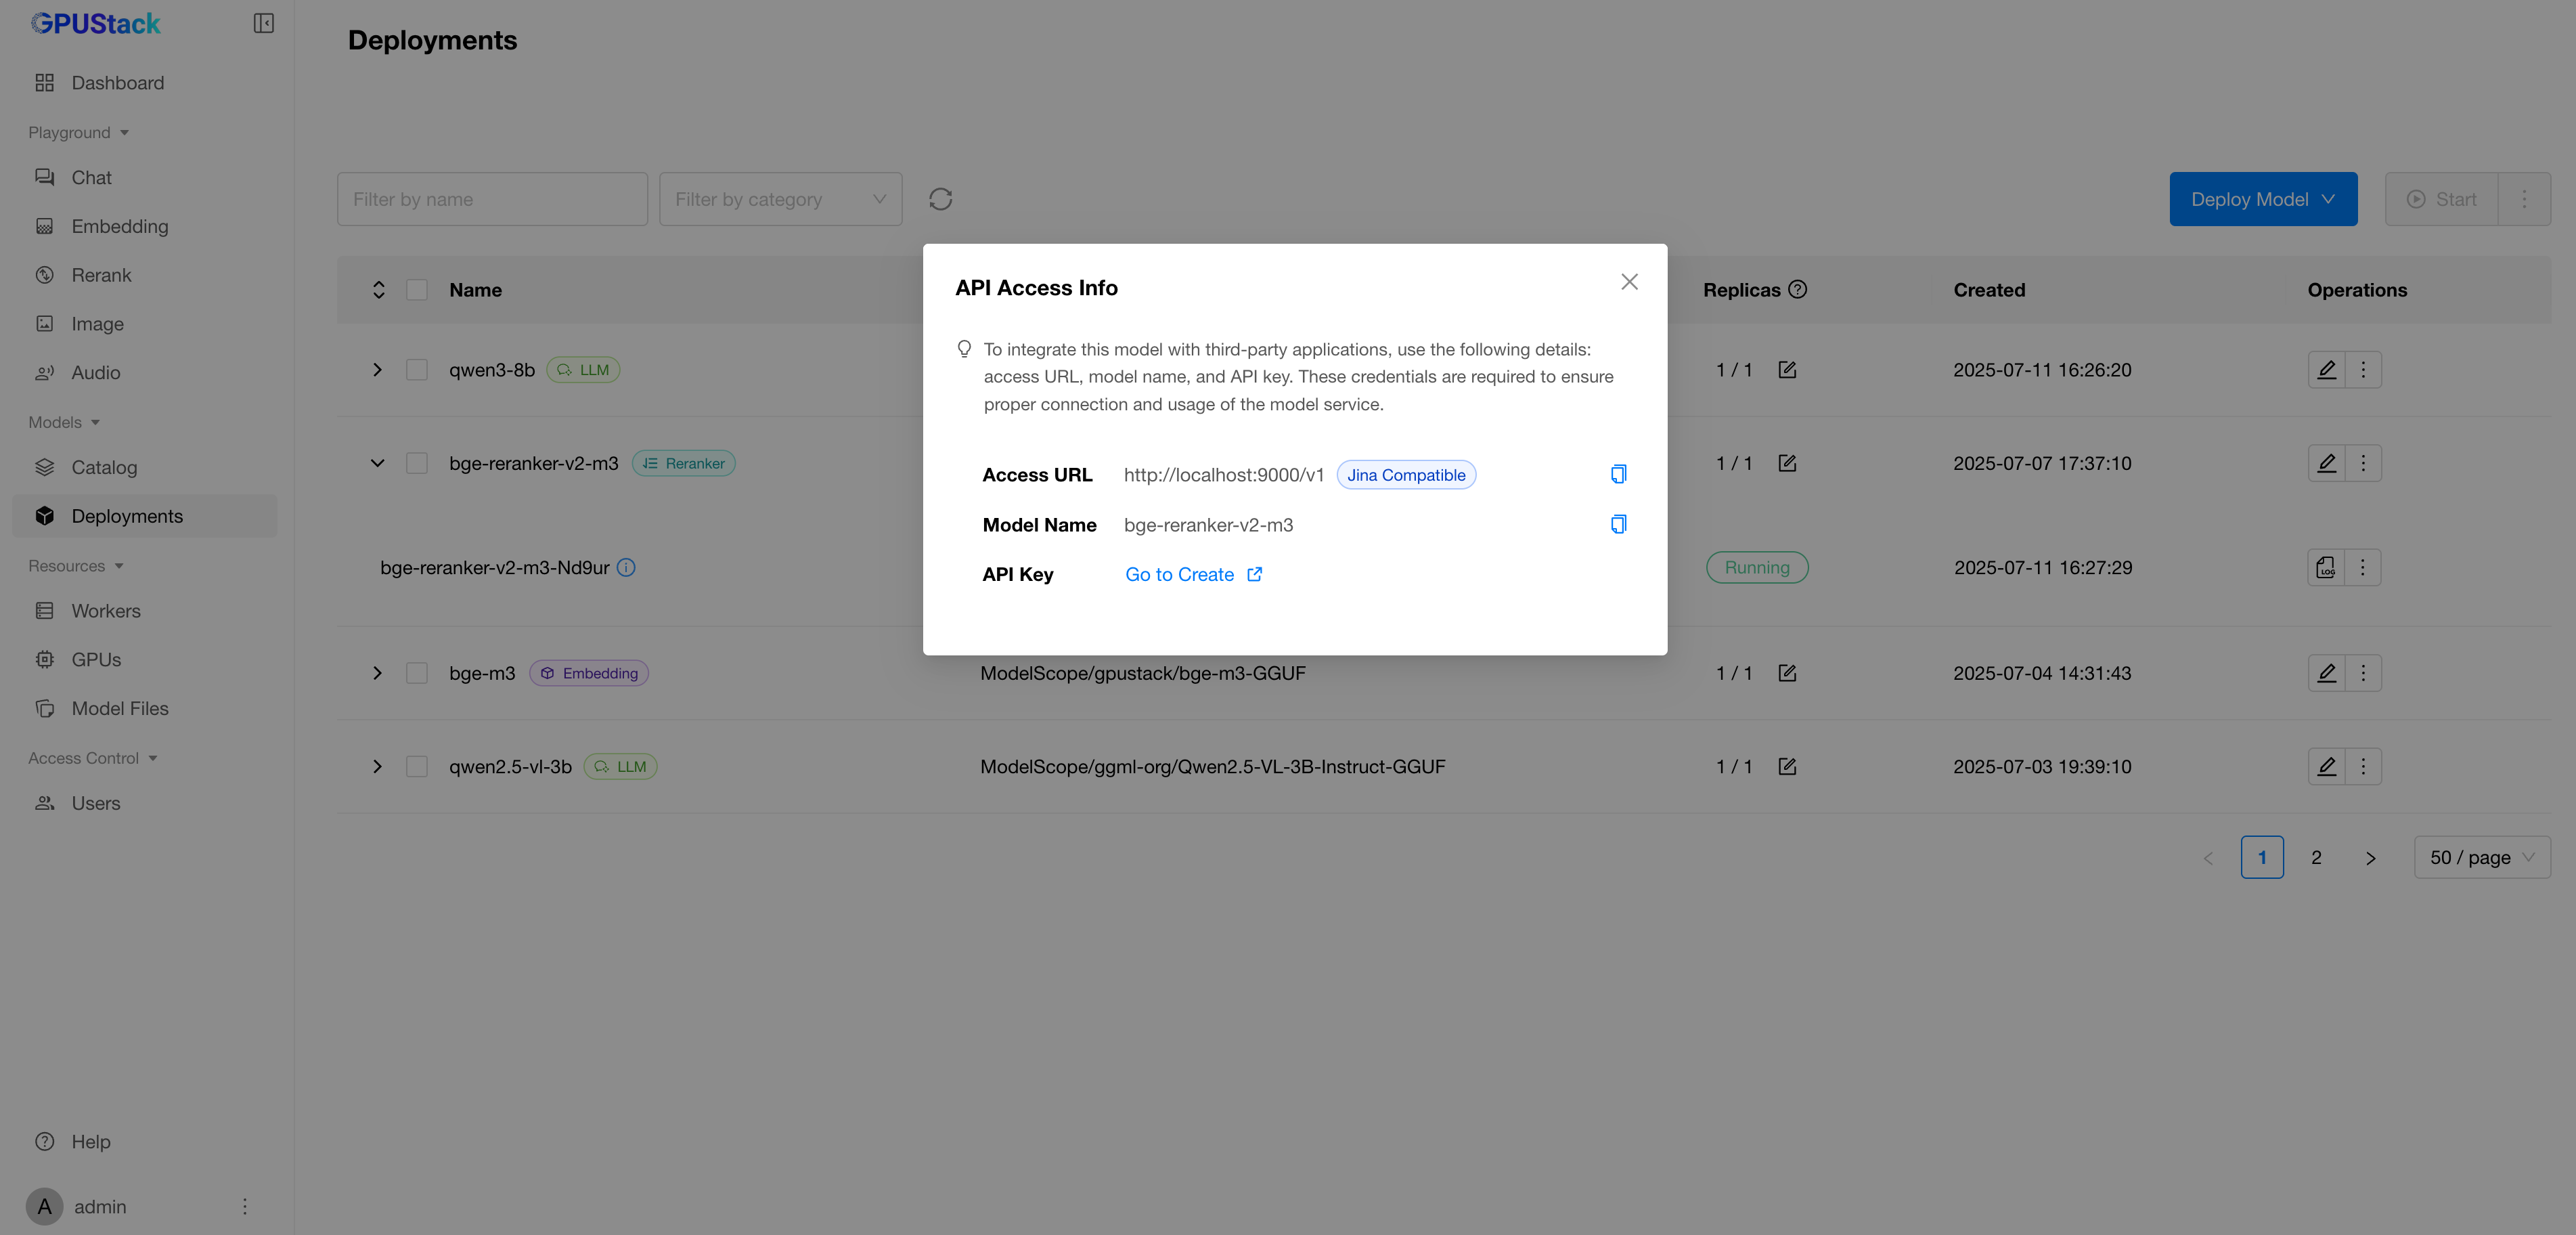
- 在模型的操作菜单中打开
API Access Info,查看接入信息。
创建 API 密钥
- 打开
Access Control>API Keys页面,点击New API Key。 - 填写名称,点击
Save。 - 复制 API 密钥并保存,供后续使用。
在 Dify 中接入 GPUStack
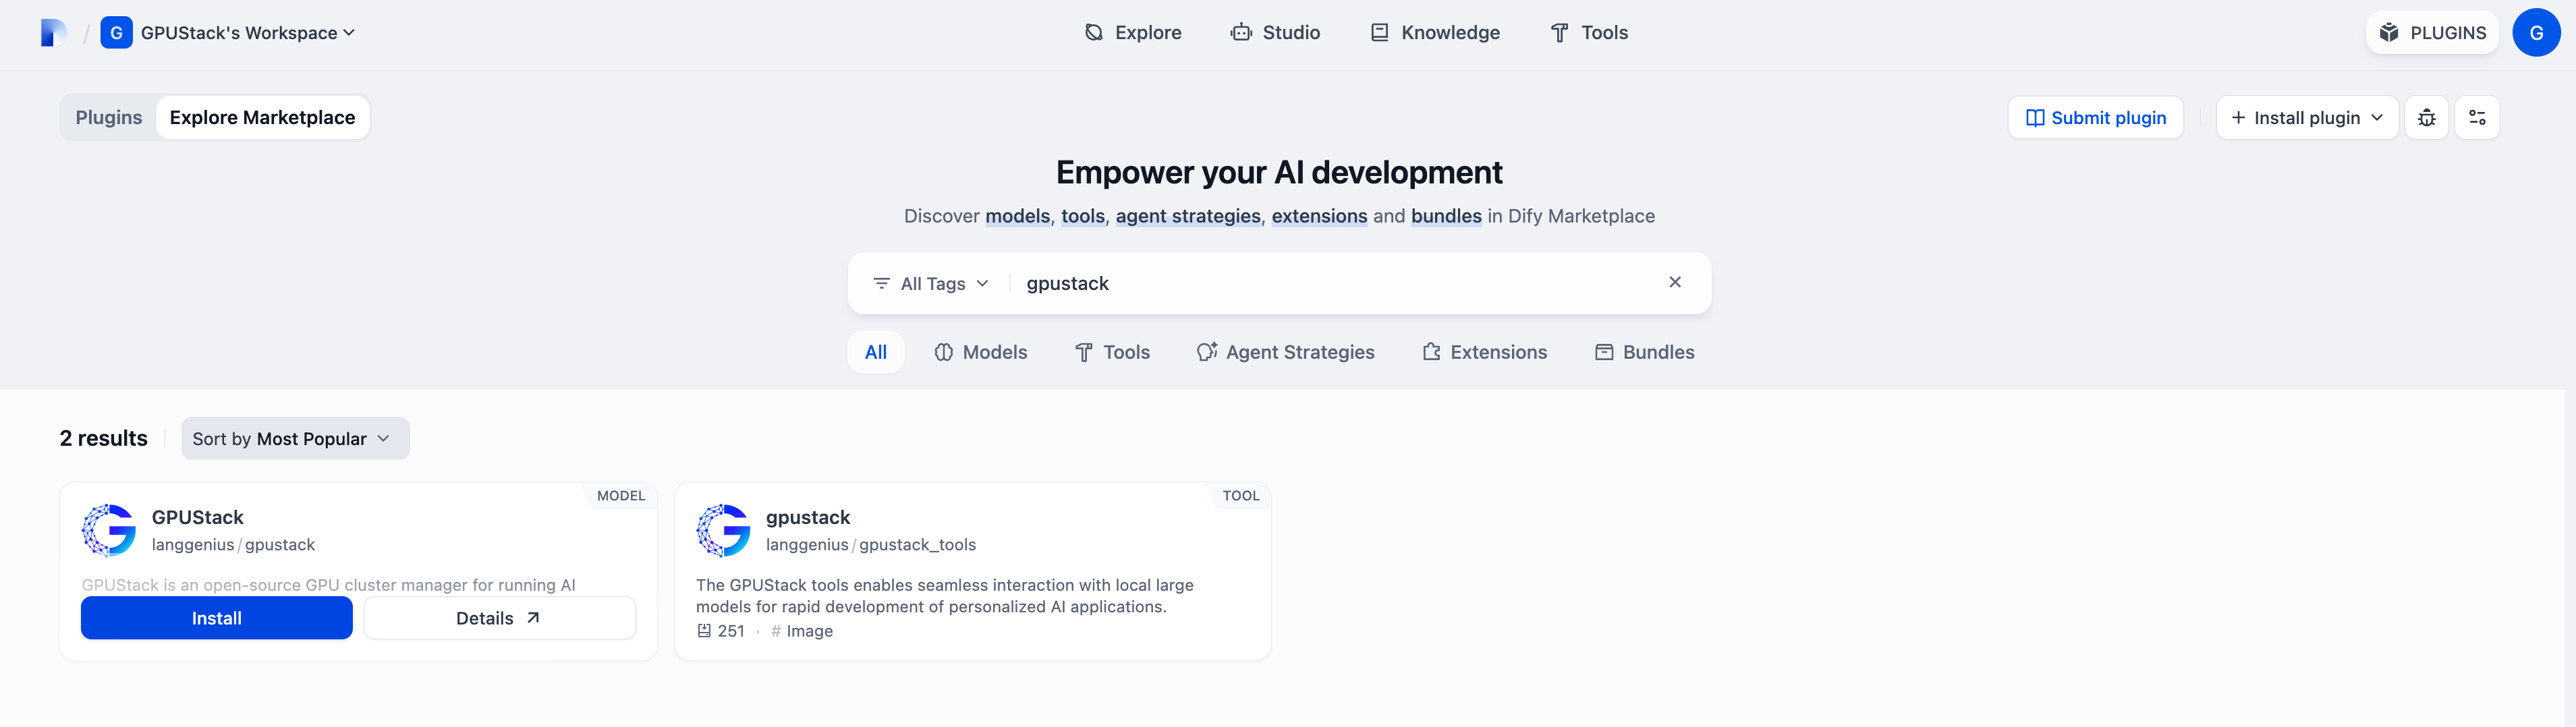
- 打开 Dify 界面,点击右上角
PLUGINS,选择Install from Marketplace,搜索并安装 GPUStack 插件。
- 安装后,进入
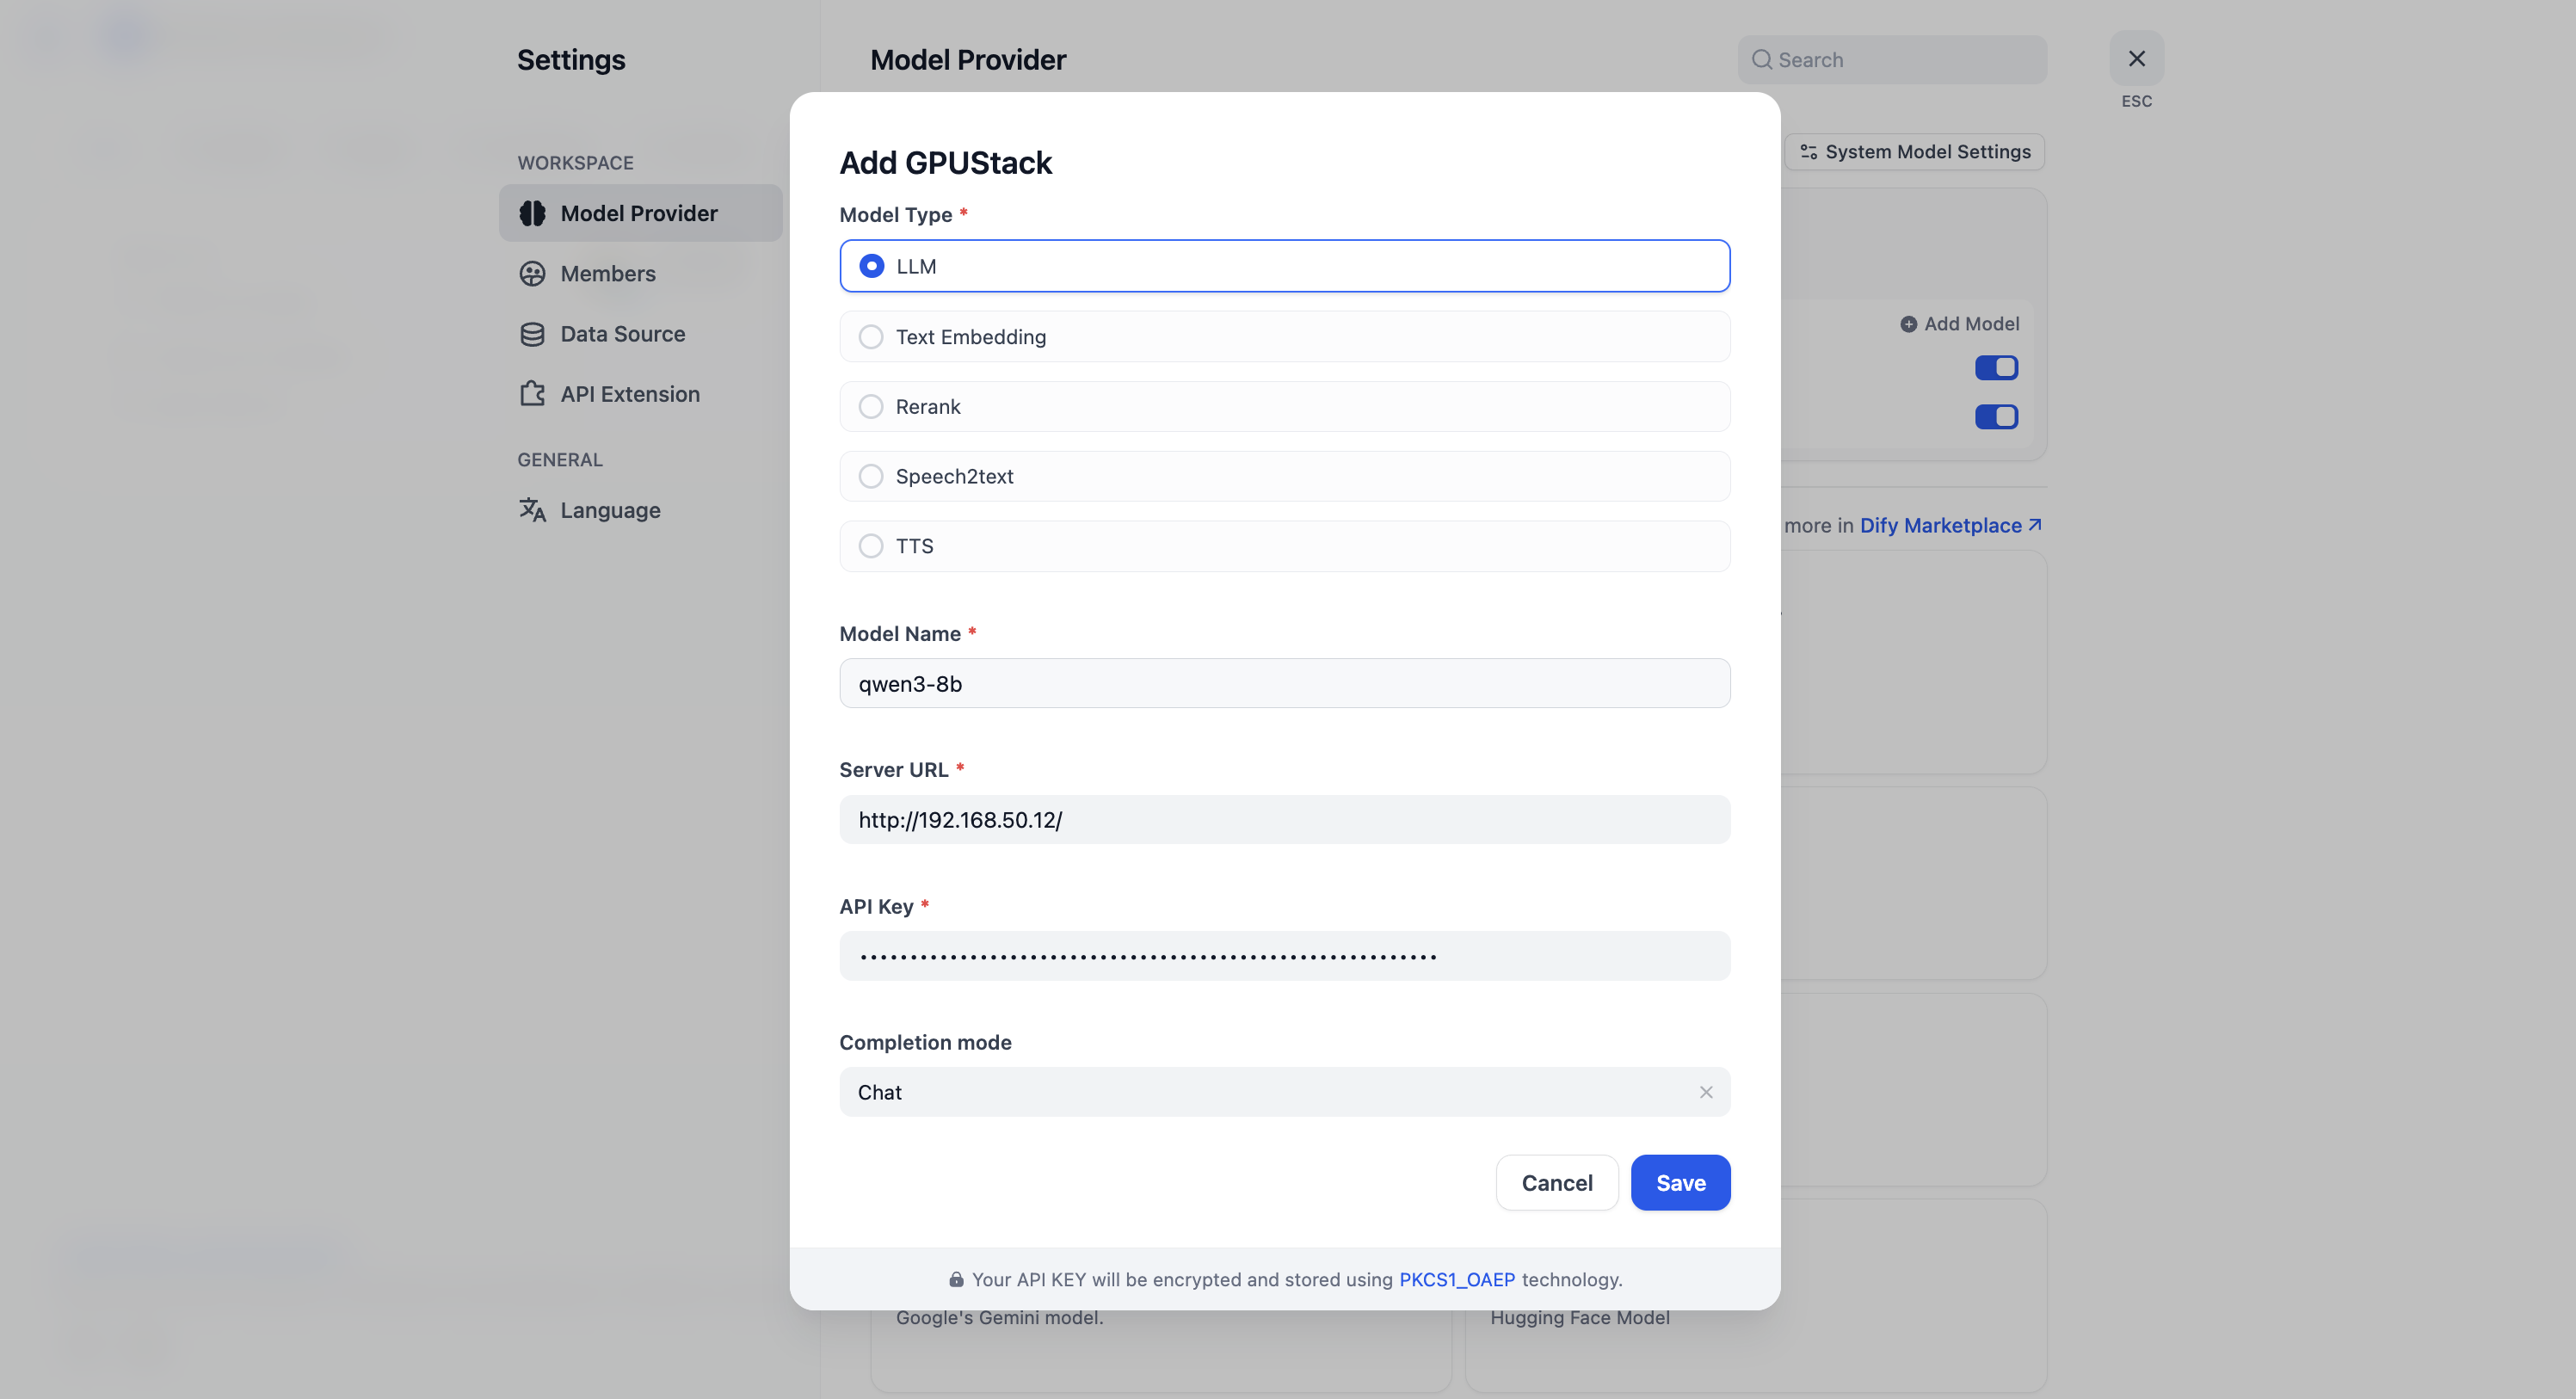
Settings > Model Provider > GPUStack,选择Add Model,填写:
- Model Type:按模型选择对应类型。
- Model Name:必须与 GPUStack 中部署的模型名称一致。
- Server URL:
http://your-gpustack-url。不要使用localhost,因为它指向容器内部网络。如使用自定义端口,请包含端口号。还需确认 Dify 容器内可以访问该 URL,可使用curl测试。 - API Key:填写前面复制的 API 密钥。
点击 Save 添加模型:
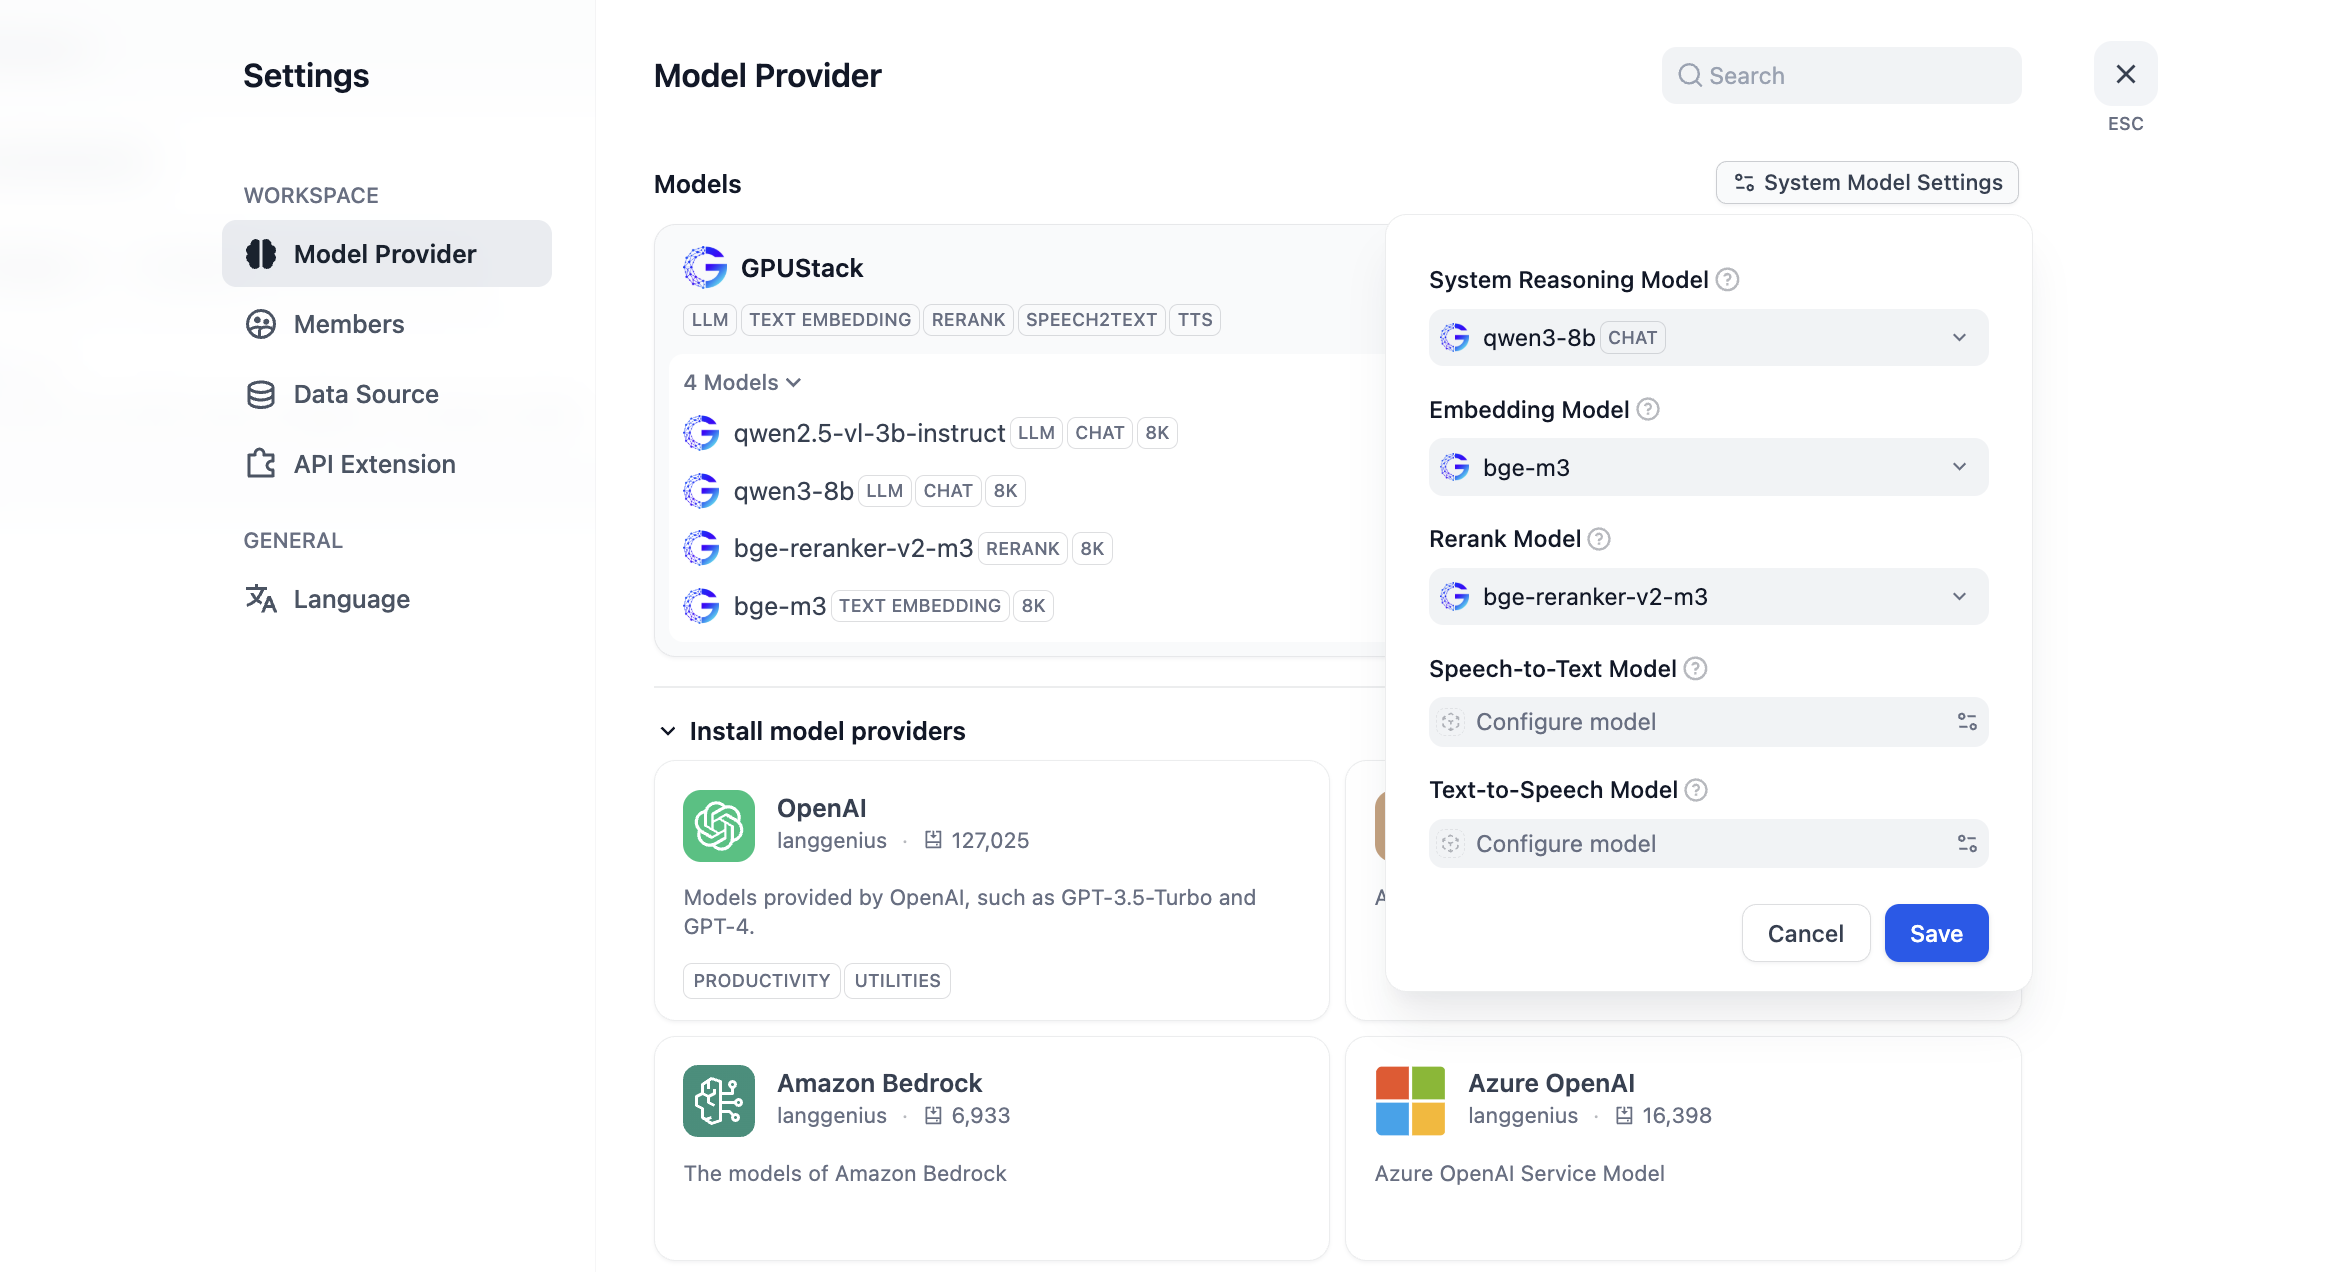
按需添加其他模型,然后在 System Model Settings 中选择已添加的模型并保存:
现在可以在 Studio 和 Knowledge 中使用模型。以下是一个简单示例:
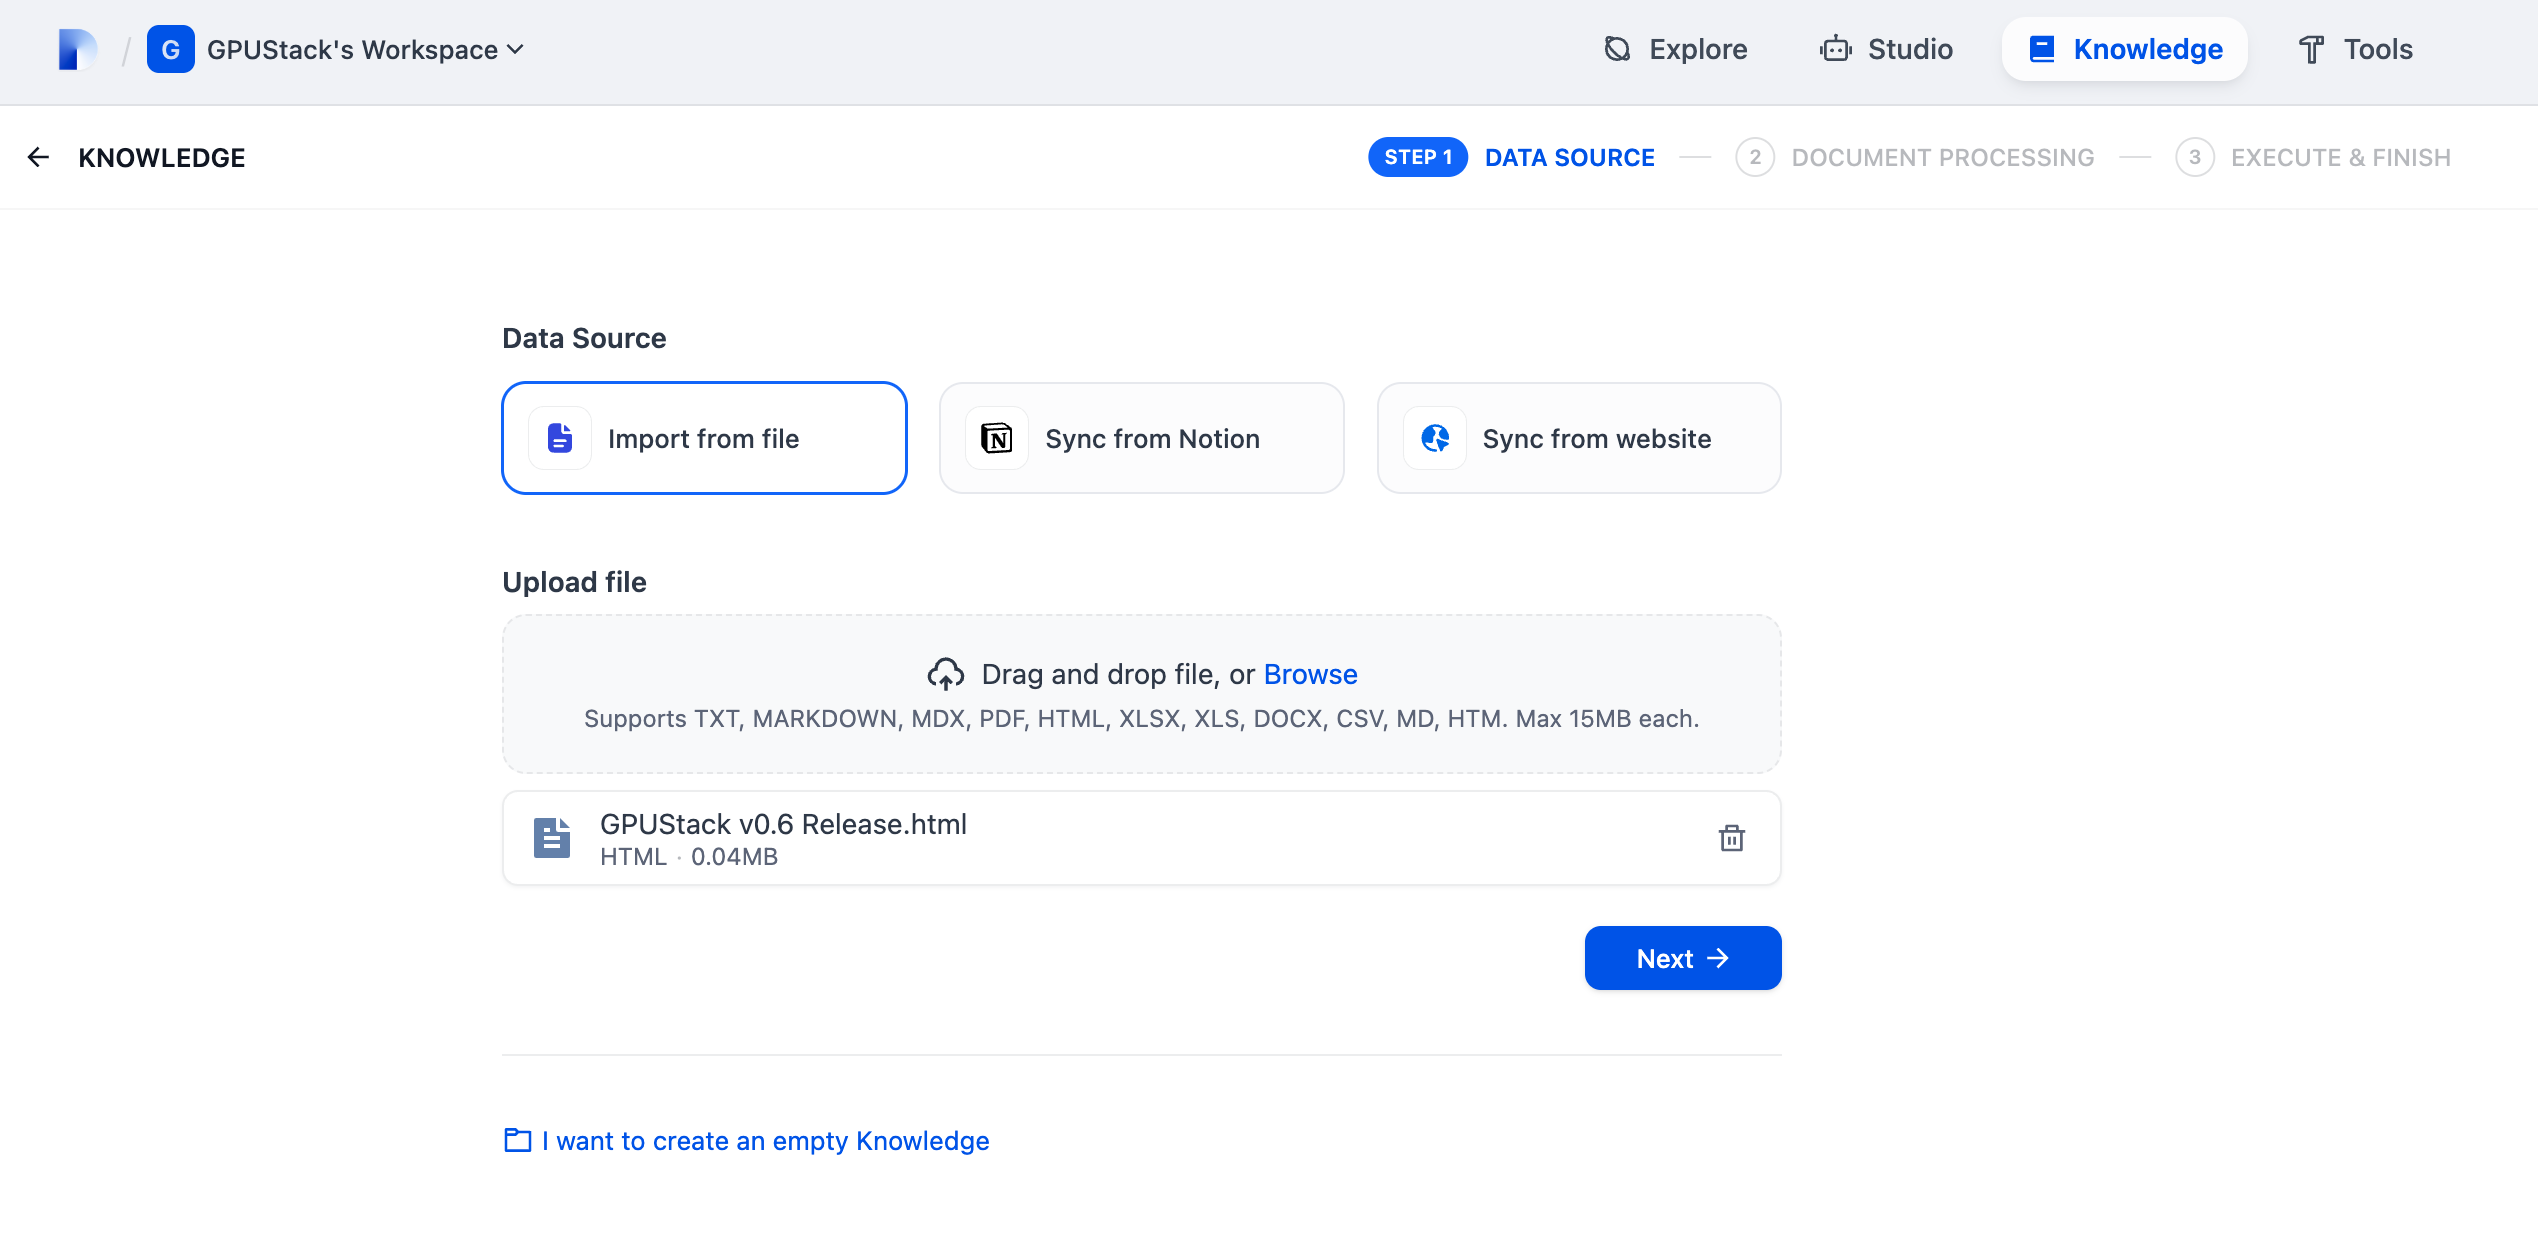
- 进入
Knowledge创建知识库,并上传文档:
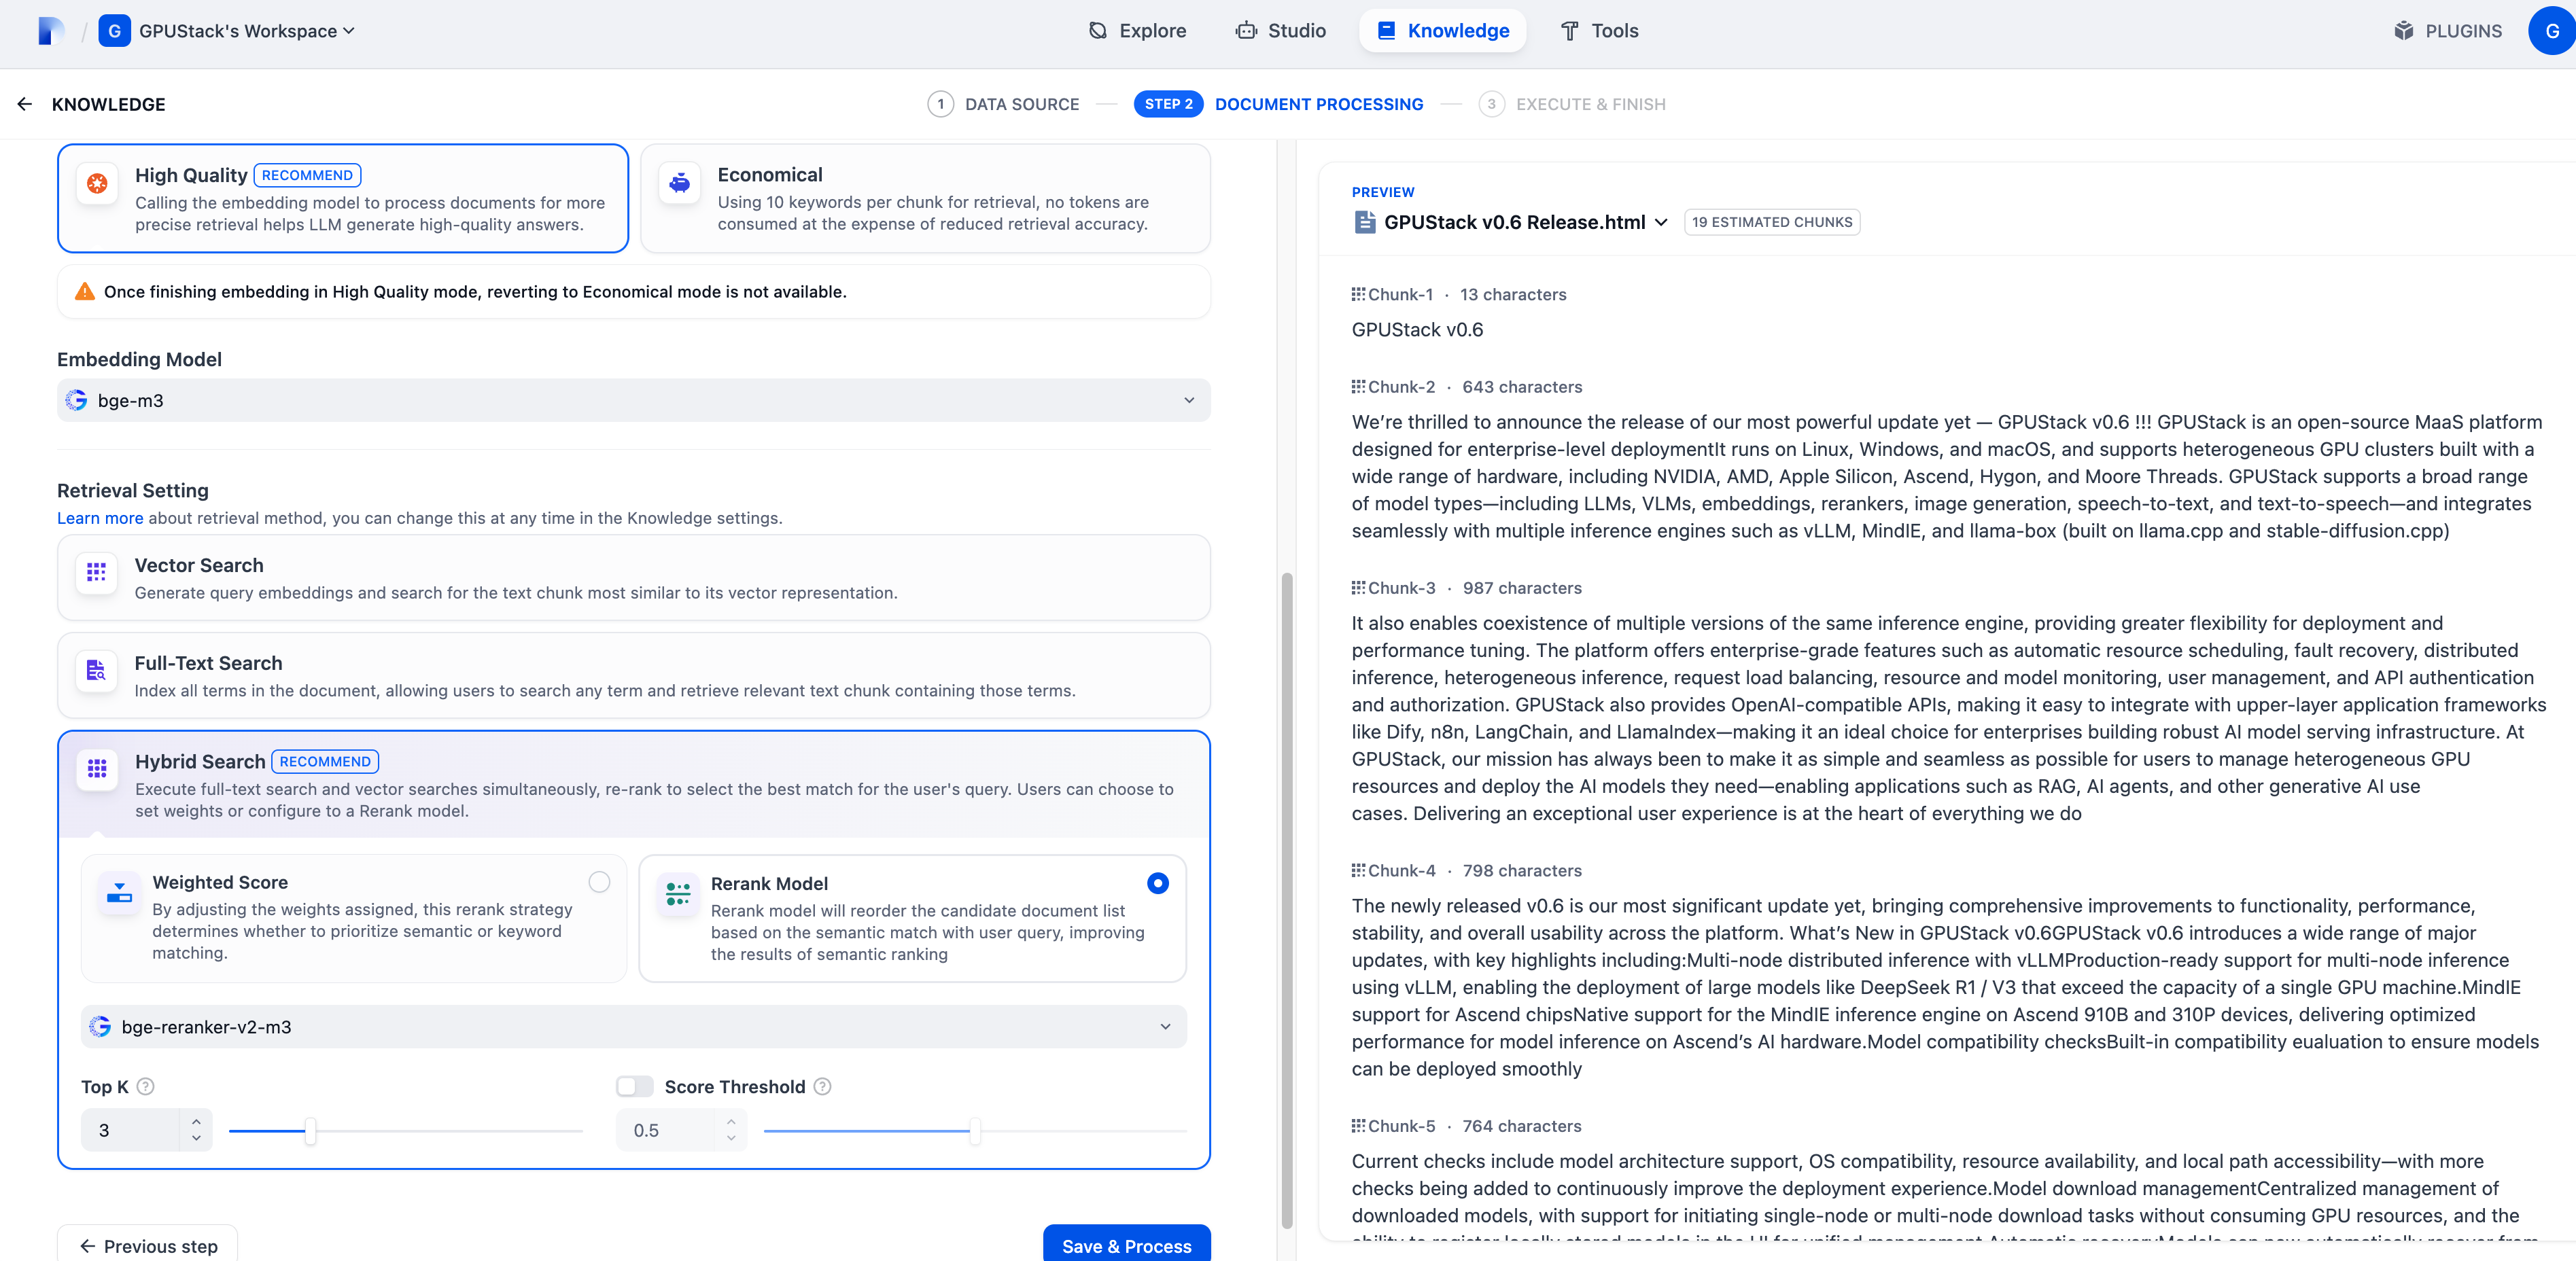
- 配置 Chunk Settings 和 Retrieval Settings,使用向量嵌入模型生成文档向量,使用重排序模型对检索结果排序。
- 文档导入成功后,在
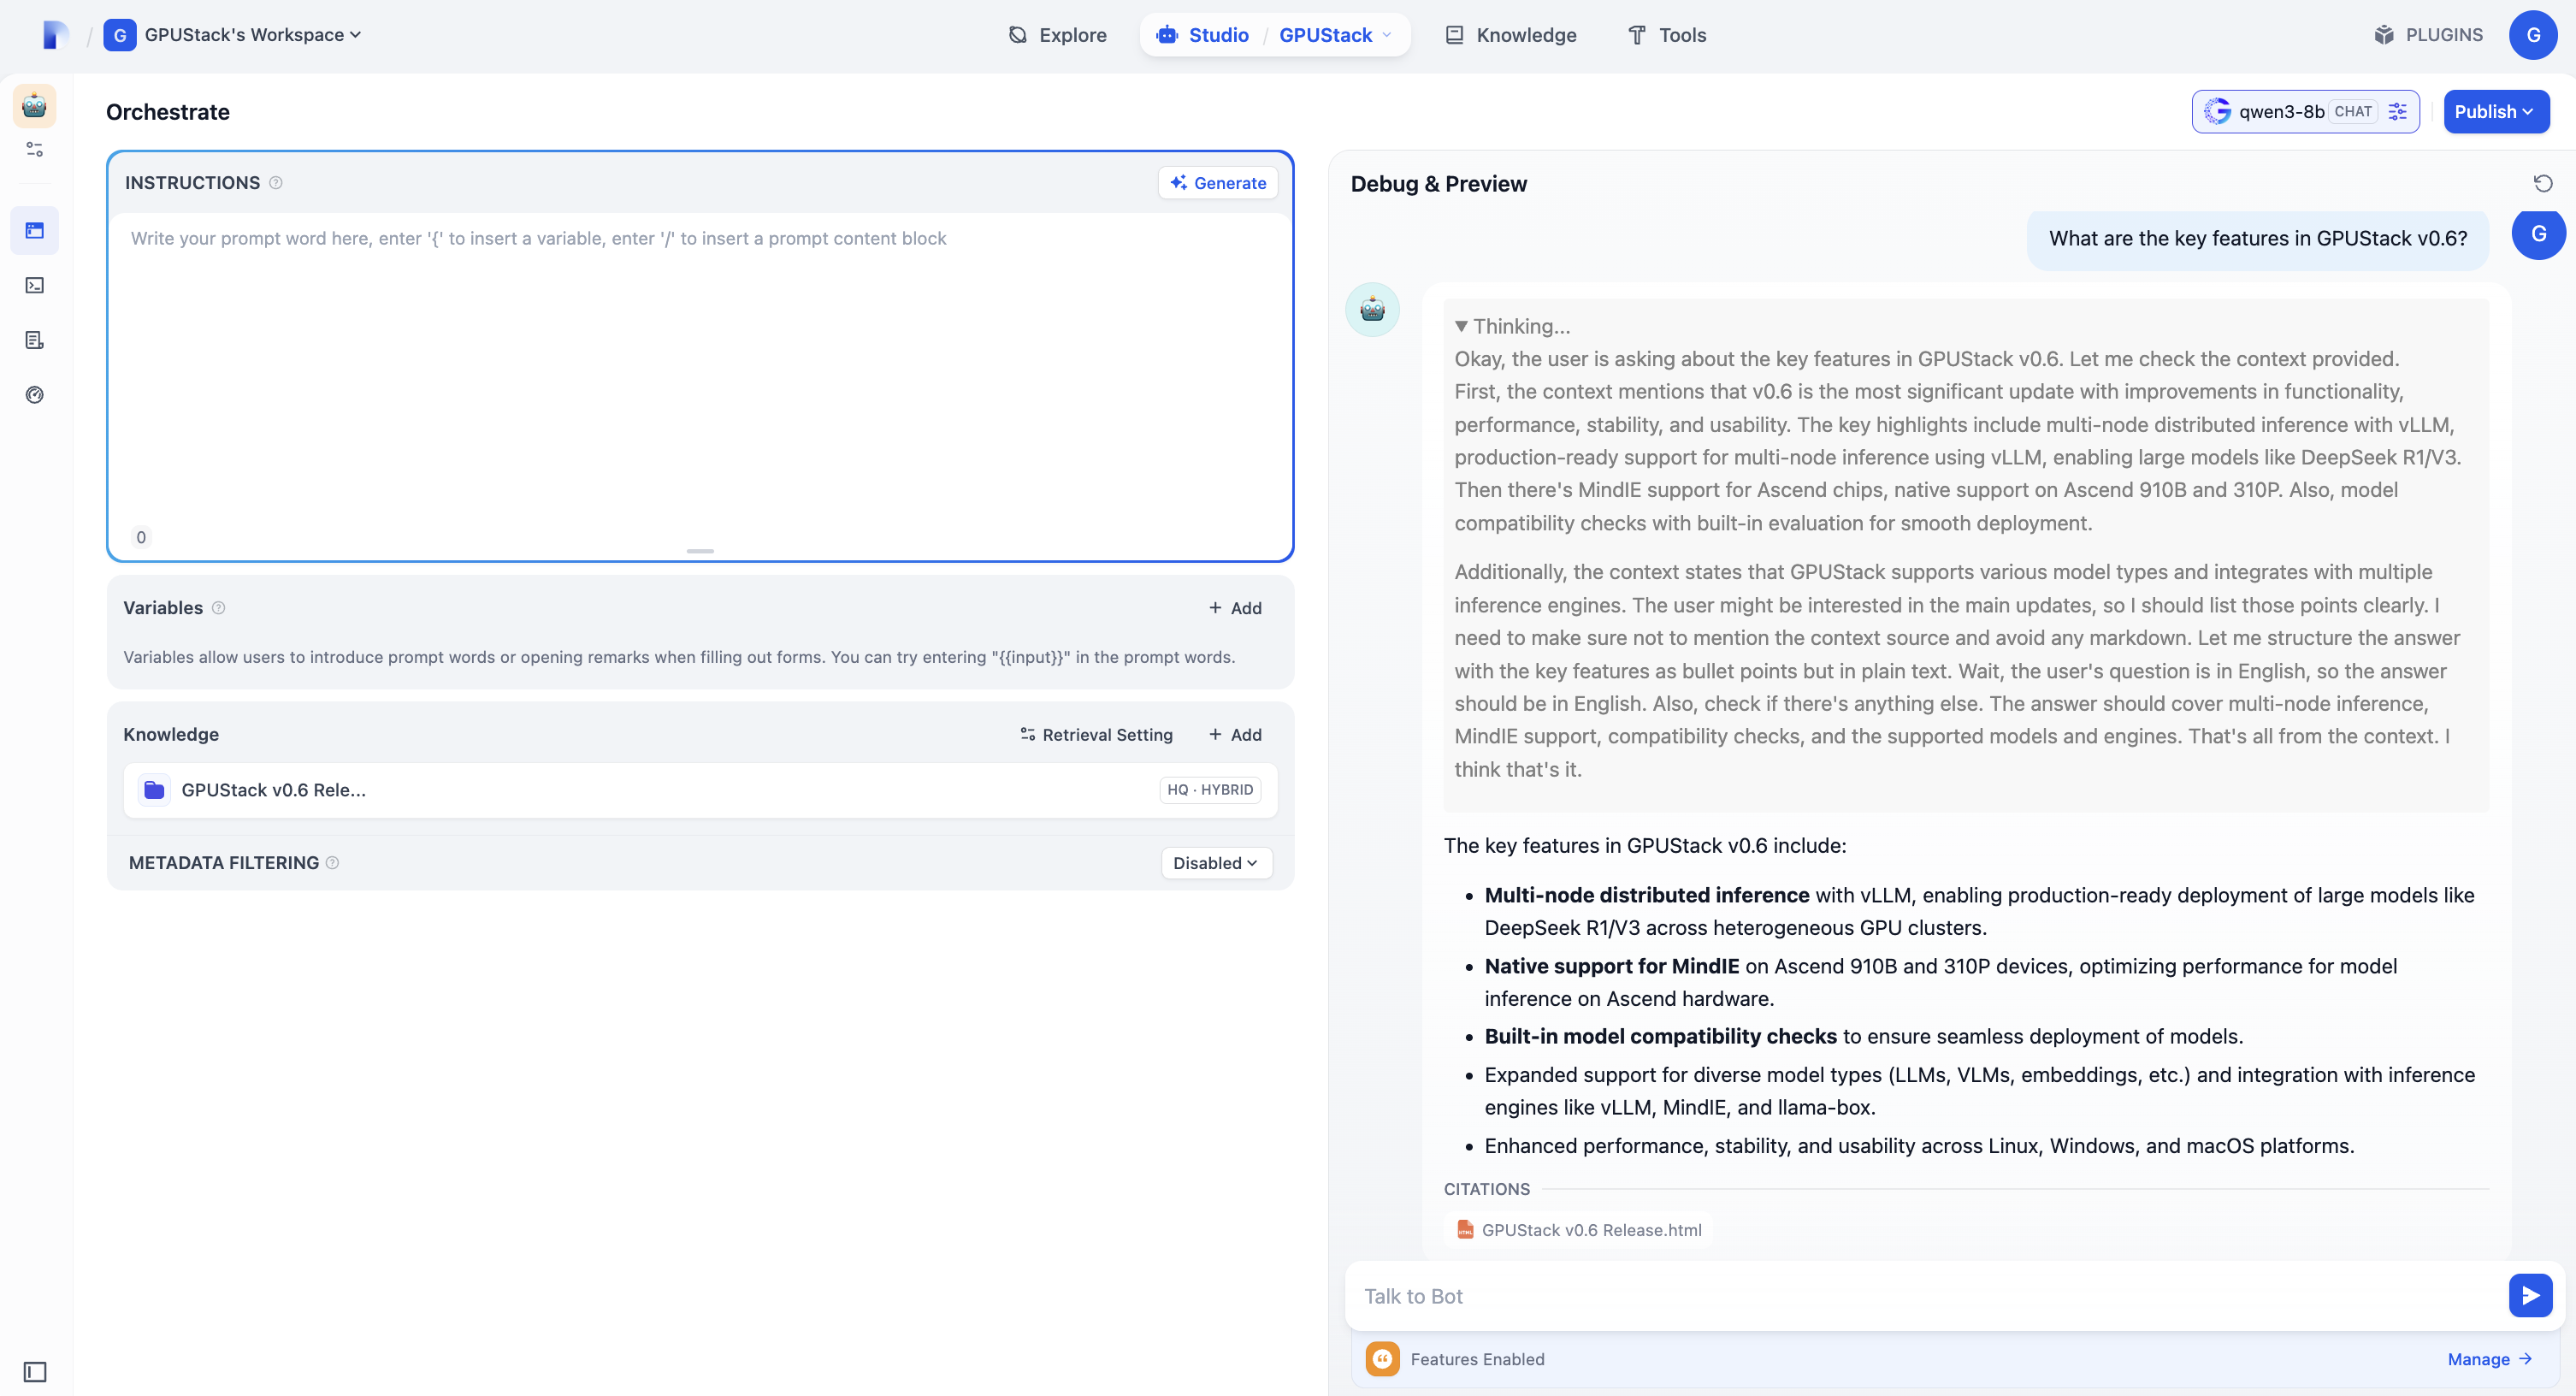
Studio创建应用,添加前面创建的知识库,选择对话模型并开始交互:
- 将模型切换为
qwen2.5-vl-3b-instruct,移除先前添加的知识库,启用Vision,然后在聊天中上传图片,使用多模态输入: