Özel Çıkarım Arka Uçlarını Kullanma
Bu kılavuz, doğrulanmış topluluk yapılandırmalarını kullanma ve kendi yapılandırmanızı sıfırdan oluşturma dahil olmak üzere GPUStack'e özel çıkarım arka uçlarının nasıl ekleneceğini açıklamaktadır.
Parametre açıklamaları için Kullanıcı Kılavuzu'e bakın.
Arka Uç Türleri
GPUStack üç tür çıkarım arka ucunu destekler:
- Yerleşik: GPUStack tarafından bakımı yapılan, farklı donanımlar için otomatik olarak optimize edilen önceden yapılandırılmış arka uçlar (vLLM, MindIE, VoxBox, SGLang...).
- Topluluk: Önceden doğrulanmış özel arka uç yapılandırmaları. Bunlar aslında manuel kurulumu basitleştirmek için "topluluk" etiketli CustomBackend'lerdir.
- Custom: Özel Docker imajları ve komutlarıyla kendinizi yapılandırdığınız arka uçlar.
Topluluk Arka Uçlarını Kullanma
Topluluk arka uçları, popüler çıkarım motorlarını eklemenin en hızlı yolunu sağlar.
Adımlar:
- Çıkarım Arka Uç sayfasına gidin → "Arka Uç Ekle"yi tıklayın
- "Topluluk" seçeneğini seçin
- "Topluluk Arka Uç Pazarı"na göz atın ve ihtiyacınız olan arka uçları etkinleştirin
Özel Arka Uçlar Oluşturma
Temel Adımlar
- Gerekli çıkarım arka ucu için Docker imajını hazırlayın
- Başlatma komutunu belirlemek için imajnün ENTRYPOINT veya CMD'sini anlayın
- Çıkarım Arka Uç sayfasına yapılandırma ekleme
- Modelleri dağıtın ve yeni eklenen arka ucu seçin
Örnek: TensorRT-LLM
Aşağıda, çıkarım arka ucunun nasıl ekleneceği ve kullanılacağını göstermek için örnek olarak TensorRT-LLM kullanılmaktadır.
Bu örnekler performans açısından optimize edilmiş yapılandırmalar değil, işlevsel gösterimlerdir. Daha iyi performans için her bir arka ucun ayarlamaya ilişkin resmi belgelerine bakın.
- TensorRT-LLM belgelerinde bağlantısı verilen sürüm sayfasında gerekli imajyü bulun.
- TensorRT-LLM imajları çıkarım hizmetini
trtllm-servekullanarak başlatmalıdır; aksi takdirde etkileşimli bir kabuk oturumu başlatırlar.run_command, dağıtım bir çalışan için planlandığında otomatik olarak gerçek değerlerle değiştirilen{{model_path}}ve{{port}}(ve isteğe bağlı olarak{{model_name}},{{worker_ip}},{{gpu_count}},{{gpu_ids}}) gibi yer tutucuları destekler.{{gpu_count}}ve{{gpu_ids}}, zamanlanan çalışana atanan GPU'ları yansıtır (özel arka uçlar tek bir çalışan üzerinde çalışır). -
Çıkarım Arka Uç sayfasına yapılandırma ekleyin; YAML içe aktarımı desteklenmektedir. Örnek:
-
Dağıtımlar sayfasında yeni eklenen arka ucu seçin ve modeli dağıtın.
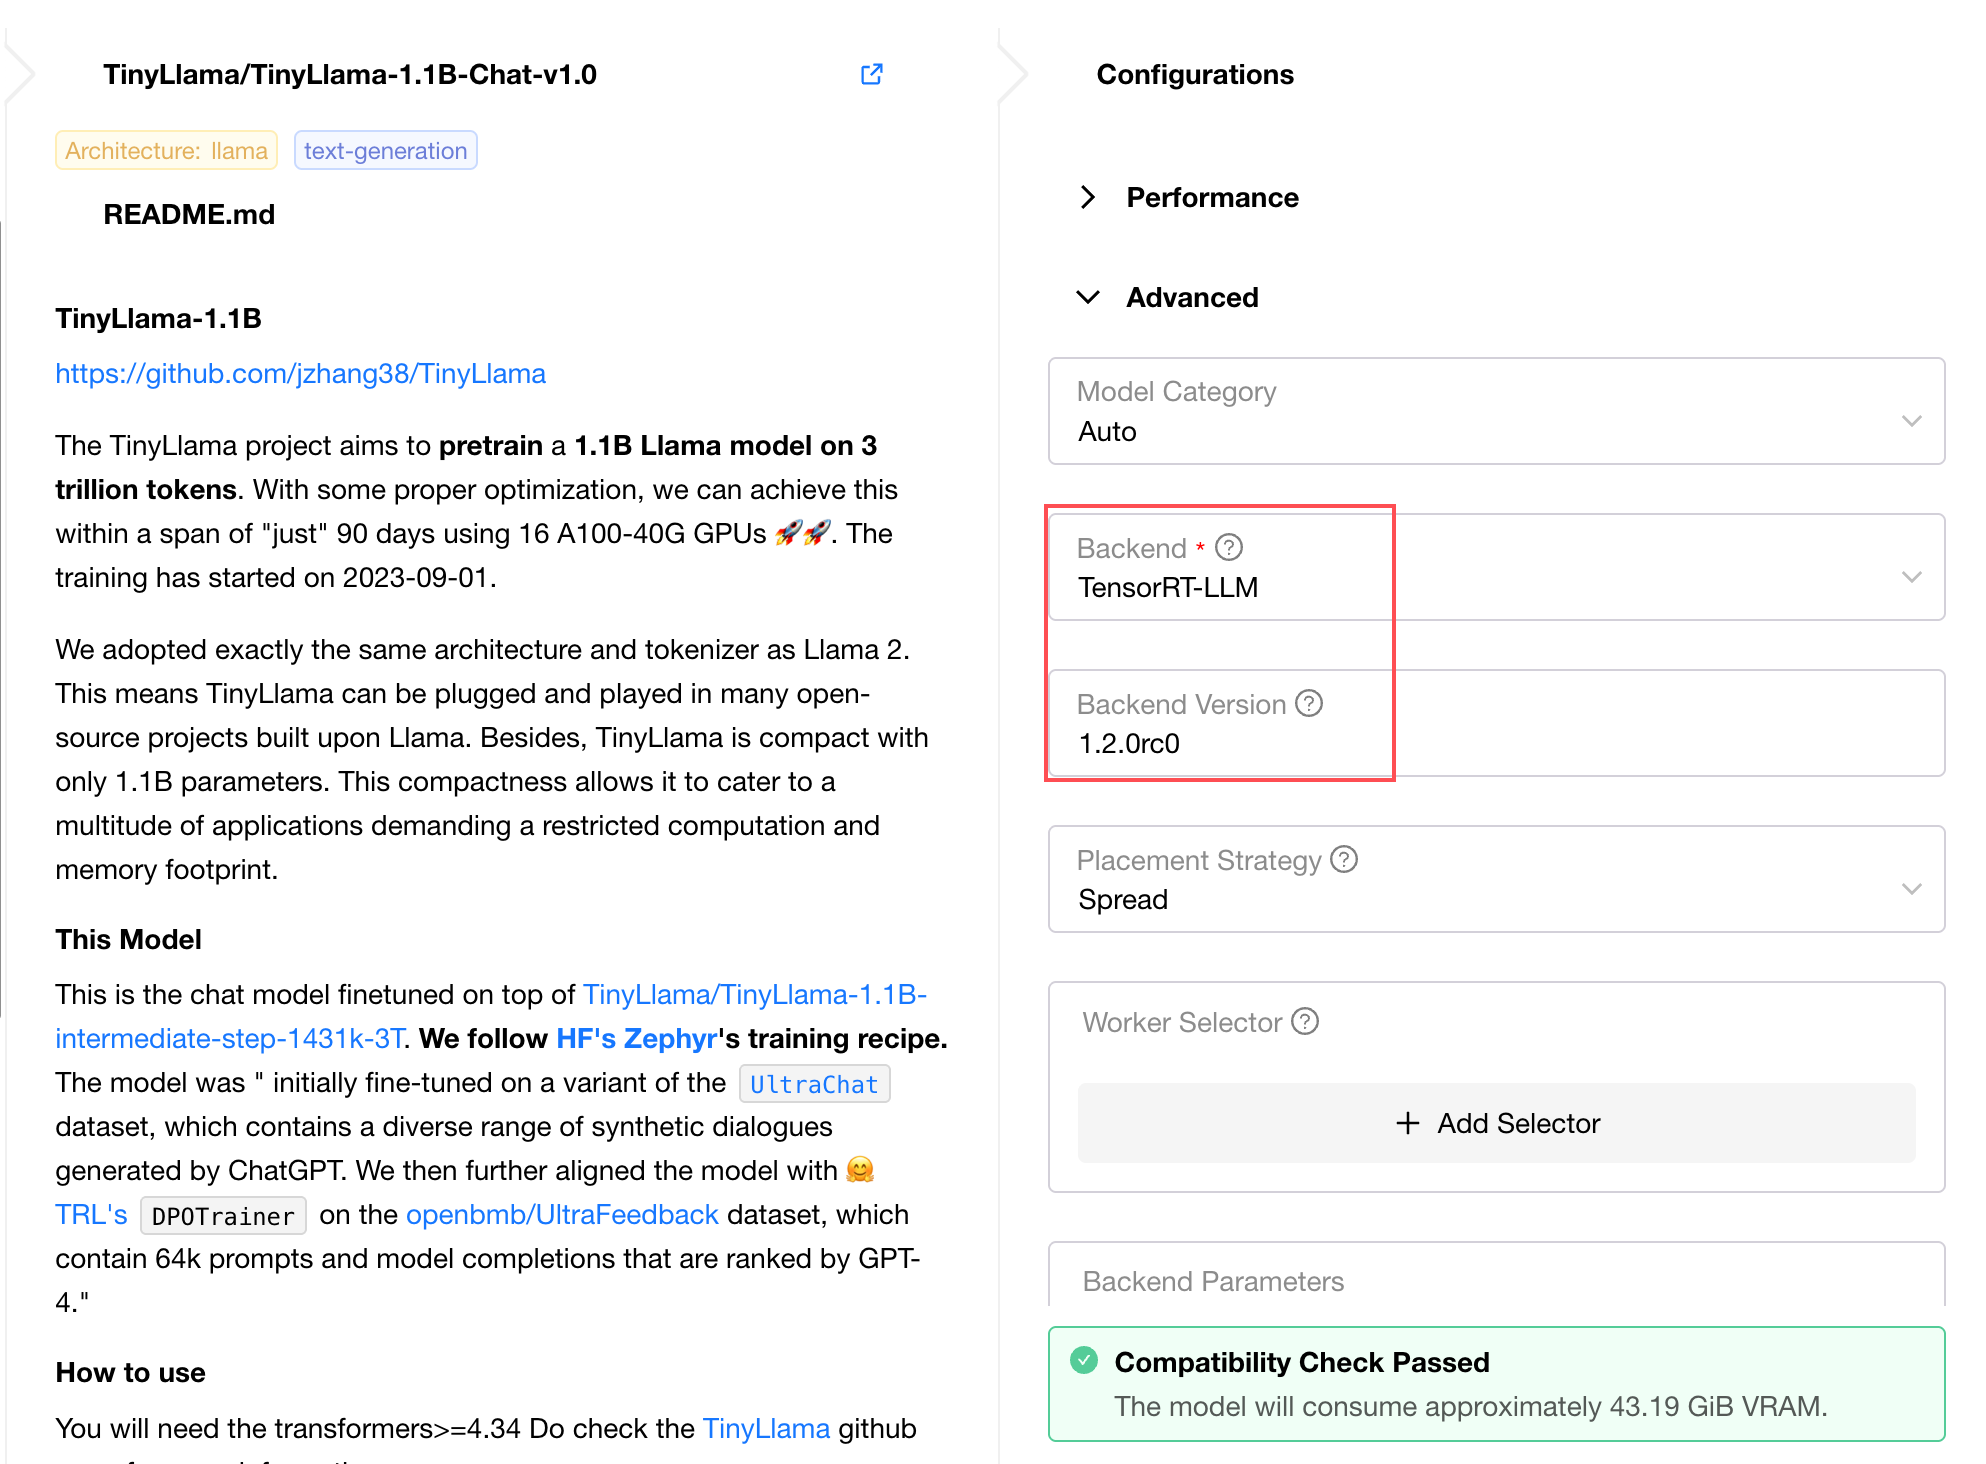
Sonuç
Çıkarım arka ucu hizmeti başladıktan sonra model_instance durumu RUNNING olur. 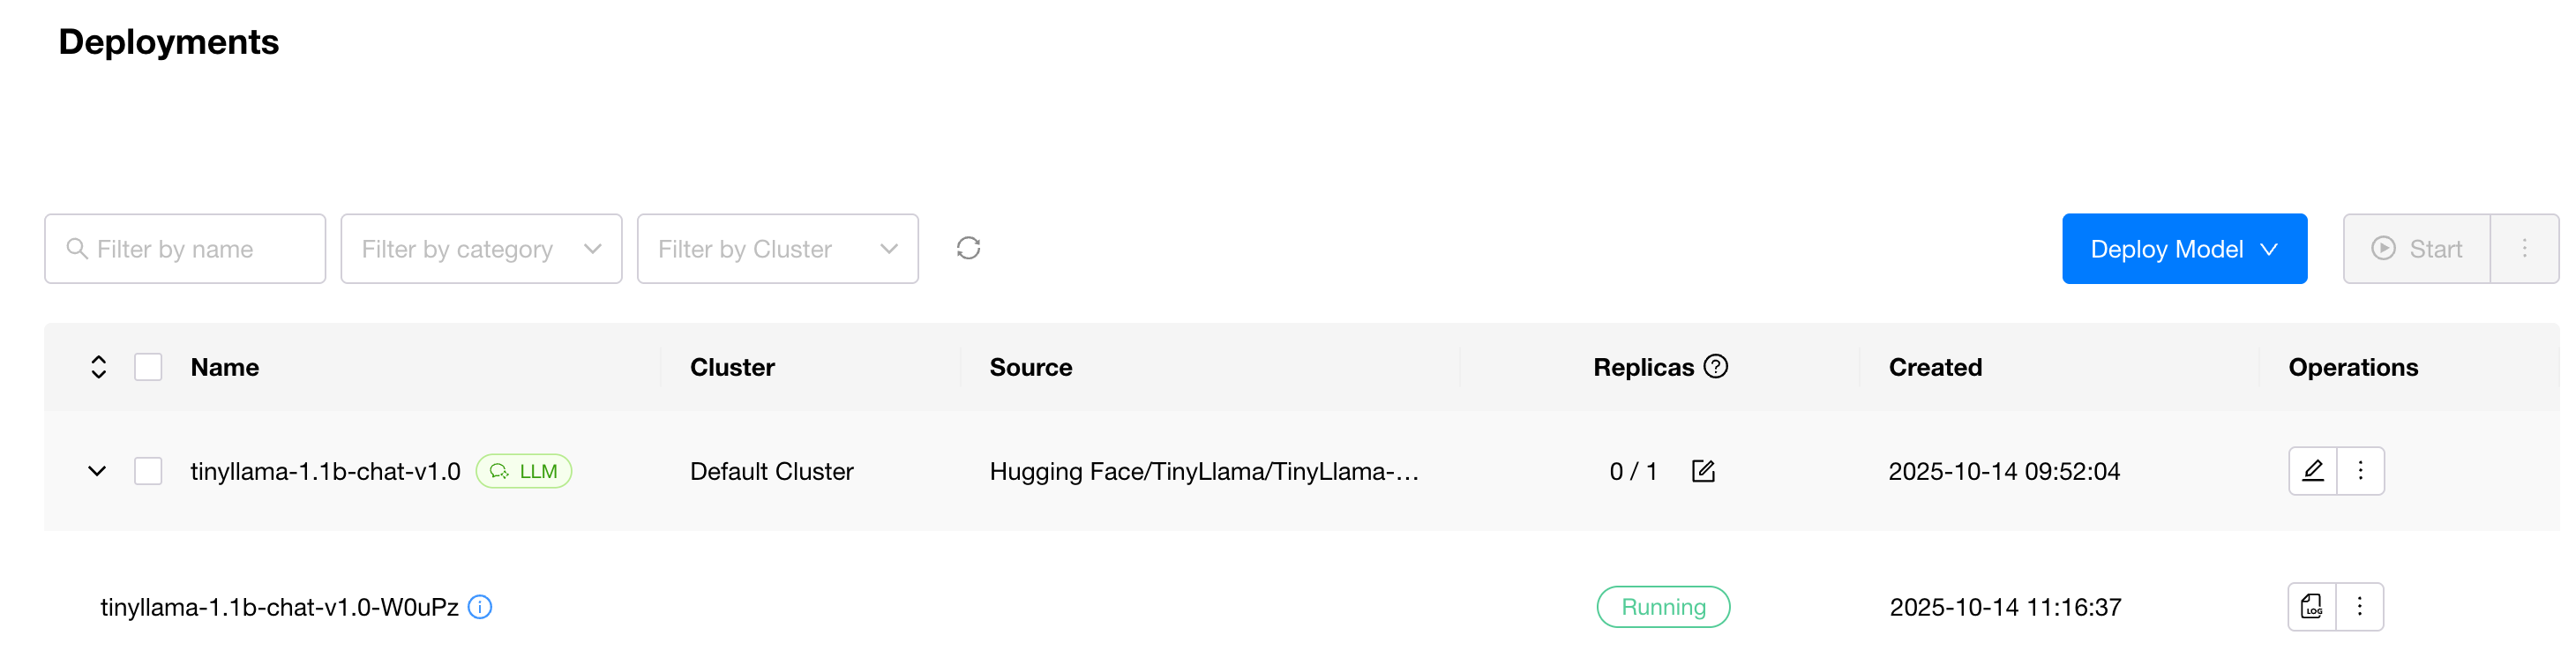 Oyun Alanında sohbetlere katılabilirsiniz.
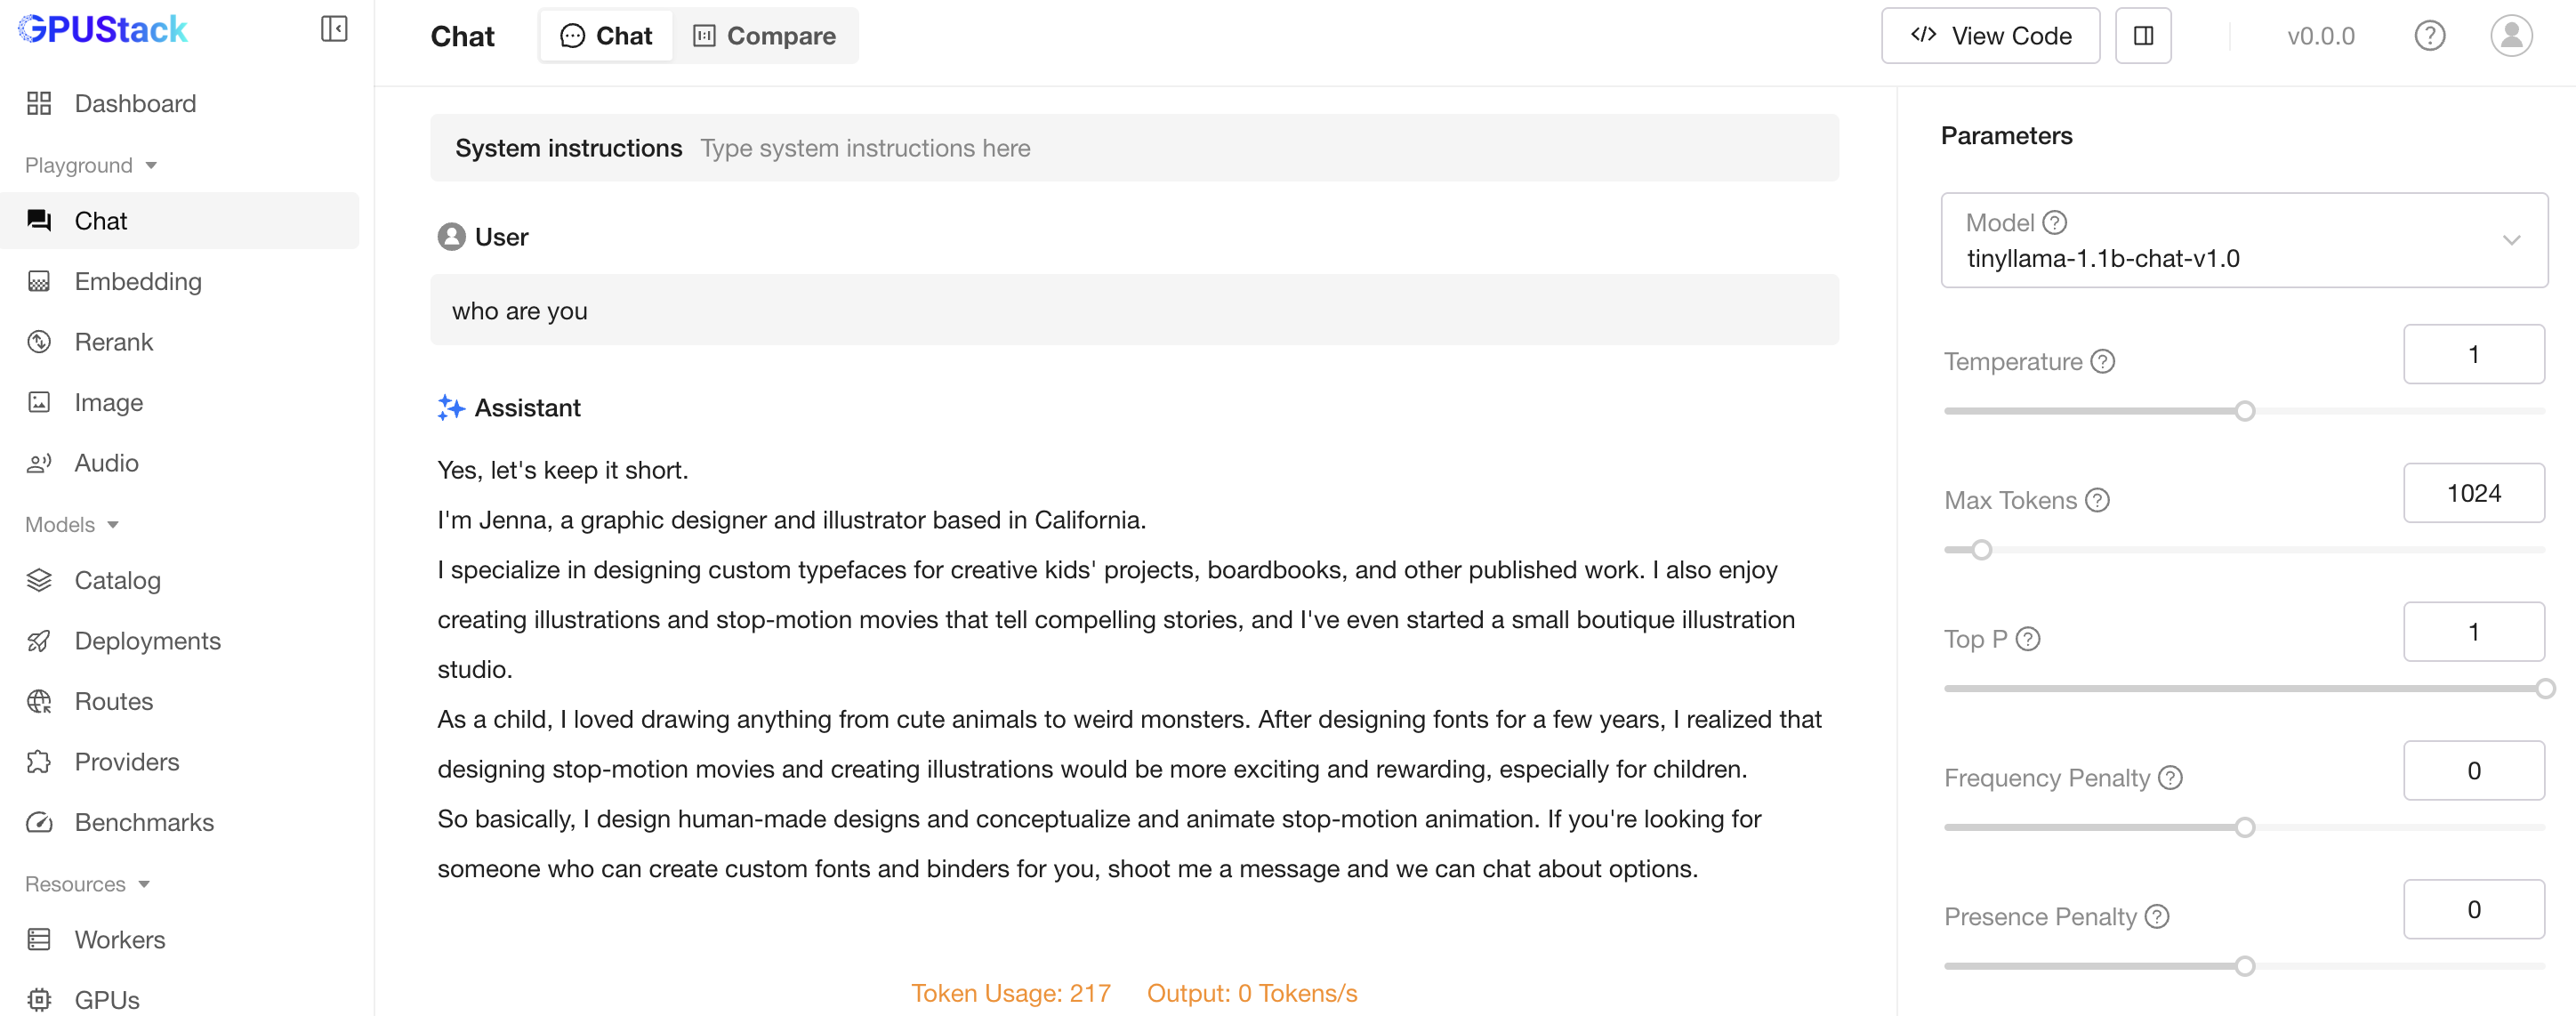
Gelişmiş Yapılandırma
Ortam Değişkenlerini Kullanma
Ortam değişkenleri, komutlarda değerleri sabit kodlamadan esnek yapılandırma sağlar:
Bu örnekte: - CACHE_DIR ve LOG_LEVEL arka uç düzeyinde tanımlanır - v1 sürümü, LOG_LEVEL değerini debug olarak geçersiz kılar - Her iki değişkene de komutta {{VAR_NAME}} sözdizimi kullanılarak başvurulur
Özel Giriş Noktası
Görüntü özel başlatma gerektirdiğinde kabın varsayılan giriş noktasını geçersiz kılın. Giriş noktalarını hem arka uç hem de sürüm düzeyinde ayarlayabilirsiniz: