Dağıtılmış vLLM ile DeepSeek R1 671B'yi Çalıştırma
Bu eğitim, bir GPUStack kümesinde Distributed vLLM kullanarak orijinal DeepSeek R1 671B'yi yapılandırma ve çalıştırma sürecinde size rehberlik eder. Modelin son derece büyük boyutundan dolayı, genellikle birden fazla çalışana dağıtılmış çıkarım yapılması gerekir.
GPUStack, vLLM kullanarak dağıtılmış çıkarımın kolay kurulumunu ve düzenlenmesini sağlayarak DeepSeek R1 gibi büyük modellerin minimum manuel yapılandırmayla çalıştırılmasını mümkün kılar.
Önkoşullar
Başlamadan önce aşağıdaki gereksinimlerin karşılandığından emin olun:
- Her biri gerekli GPU'larla donatılmış yeterli sayıda Linux düğümüne erişiminiz var. Örneğin:
| GPU | Düğüm Sayısı |
|---|---|
| H100/H800:8 | 2 |
| A100/A800-80GB:8 | 4 |
| A100/A800:8 | 8 |
- Optimum performans için NVLink veya InfiniBand gibi yüksek hızlı ara bağlantılar önerilir.
- Model dosyaları her düğümde aynı yola indirilmelidir. GPUStack anında model indirmeyi desteklerken, ağ hızına bağlı olarak zaman alıcı olabileceğinden ön indirme önerilir.
Not
- Bu eğitimde, her biri 8 A800-80GB GPU ile donatılmış ve 200G InfiniBand aracılığıyla bağlanan 4 düğümden oluşan bir kurulum varsayıyoruz.
- A100/A800 GPU'lar, orijinal olarak DeepSeek R1 tarafından kullanılan FP8 hassasiyetini desteklemez. Bu nedenle Unsloth'in BF16 versiyonunu kullanıyoruz.
Adım 1: GPUStack Sunucusunu Kurun
Installation'e göre GPUStack sunucusunu başlatmak için aşağıdaki komutu kullanabilirsiniz:
Not
/path/to/your/model'i gerçek yolla değiştirin.
GPUStack sunucusu açıldıktan ve çalışmaya başladıktan sonra, başlangıç yönetici şifresini almak için aşağıdaki komutları çalıştırın:
Adım 2: GPUStack Kullanıcı Arayüzü'ne erişin
admin kullanıcısını ve elde edilen şifreyi kullanarak GPUStack kullanıcı arayüzünde oturum açın.
Adım 3: GPUStack Workers'ı yükleyin
GPUStack kullanıcı arayüzünde Workers sayfasına gidin, işçi ekleme komutunu almak için Add Worker düğmesine tıklayın.
Ve ardından her çalışan düğümünde, bir GPUStack çalışanını başlatmak için çalışan ekleme komutunu çalıştırın:
Not
- Yer tutucu yollarını, IP adresini/ana bilgisayar adını ve küme belirtecini uygun şekilde değiştirin.
/path/to/your/model'i, sisteminizde DeepSeek R1 model dosyalarının depolandığı gerçek yolla değiştirin.
Tüm çalışanlar eklendikten sonra GPUStack kullanıcı arayüzüne geri dönün.
Tüm çalışanların Hazır durumda olduğunu ve GPU'larının listelendiğini doğrulamak için Workers sayfasına gidin.
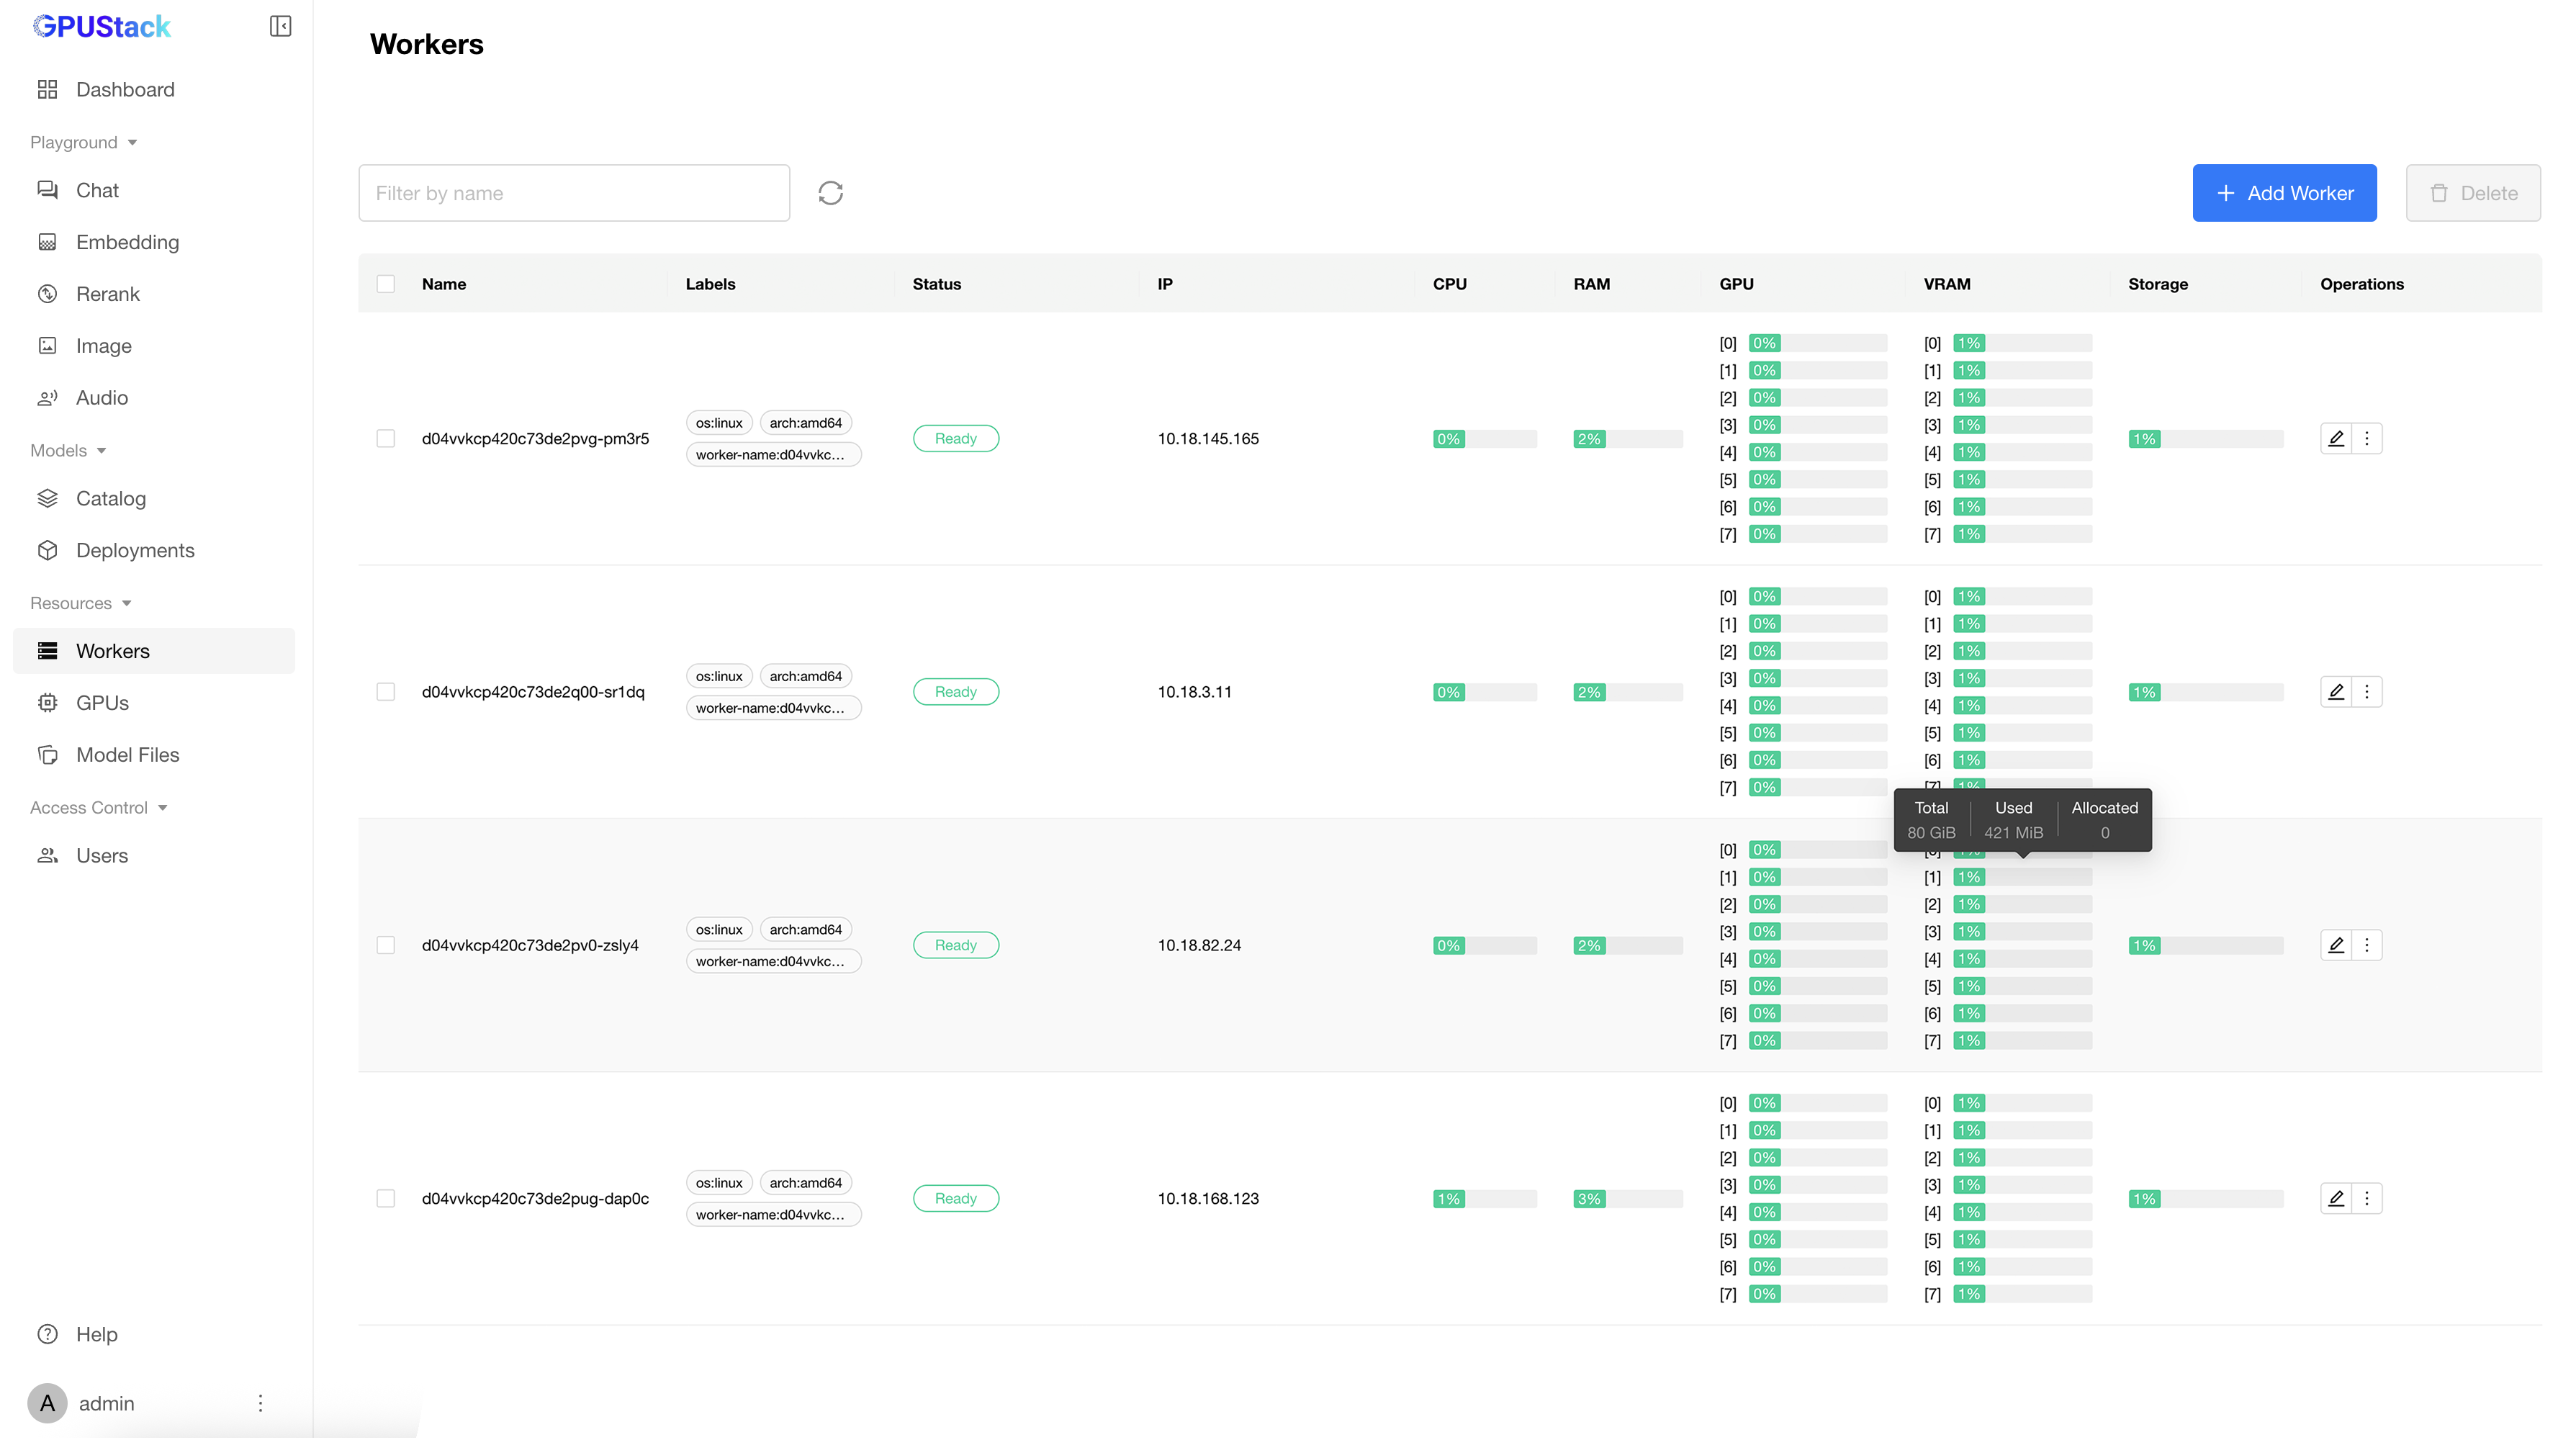
Adım 4: DeepSeek R1 Modelini Dağıtın
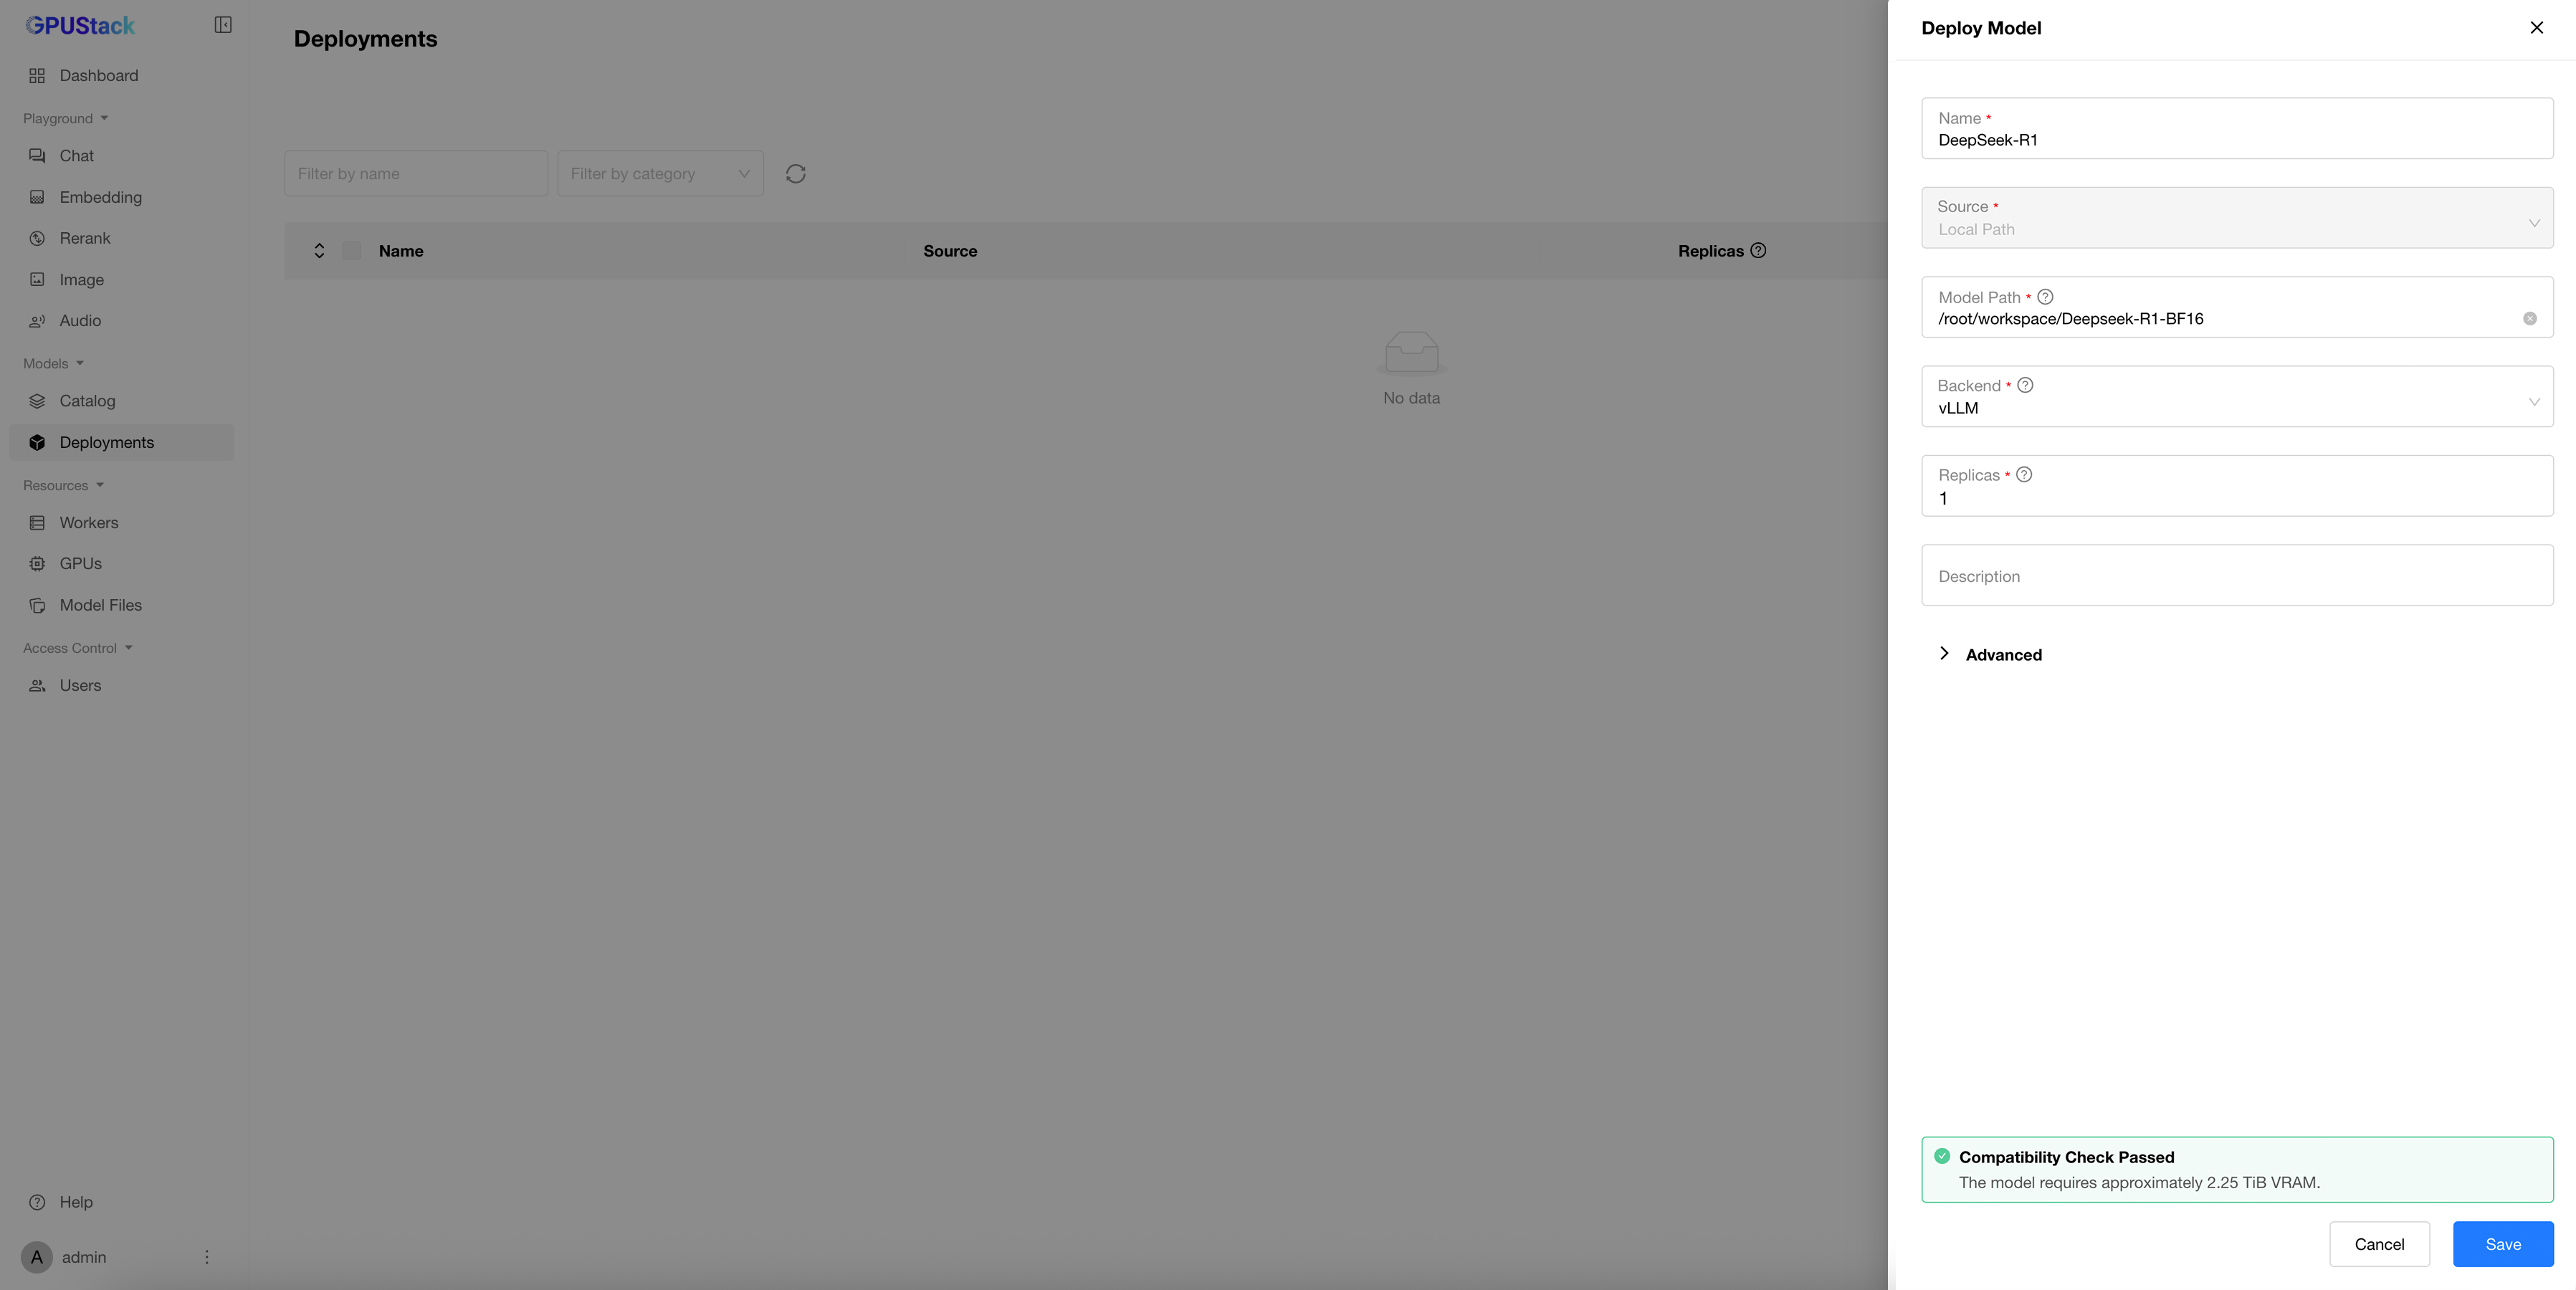
Deploymentssayfasına gidin.Deploy Model'a tıklayın.- Kaynağınız olarak
Local Path'ı seçin. Namealanına bir ad girin (ör.DeepSeek-R1).- Her çalışan düğümde DeepSeek R1 model dosyalarını içeren dizin olarak
Model Path'ı belirtin. Backend'ninvLLMolarak ayarlandığından emin olun.- Uyumluluk kontrolünü geçtikten sonra dağıtmak için
Saveseçeneğine tıklayın.
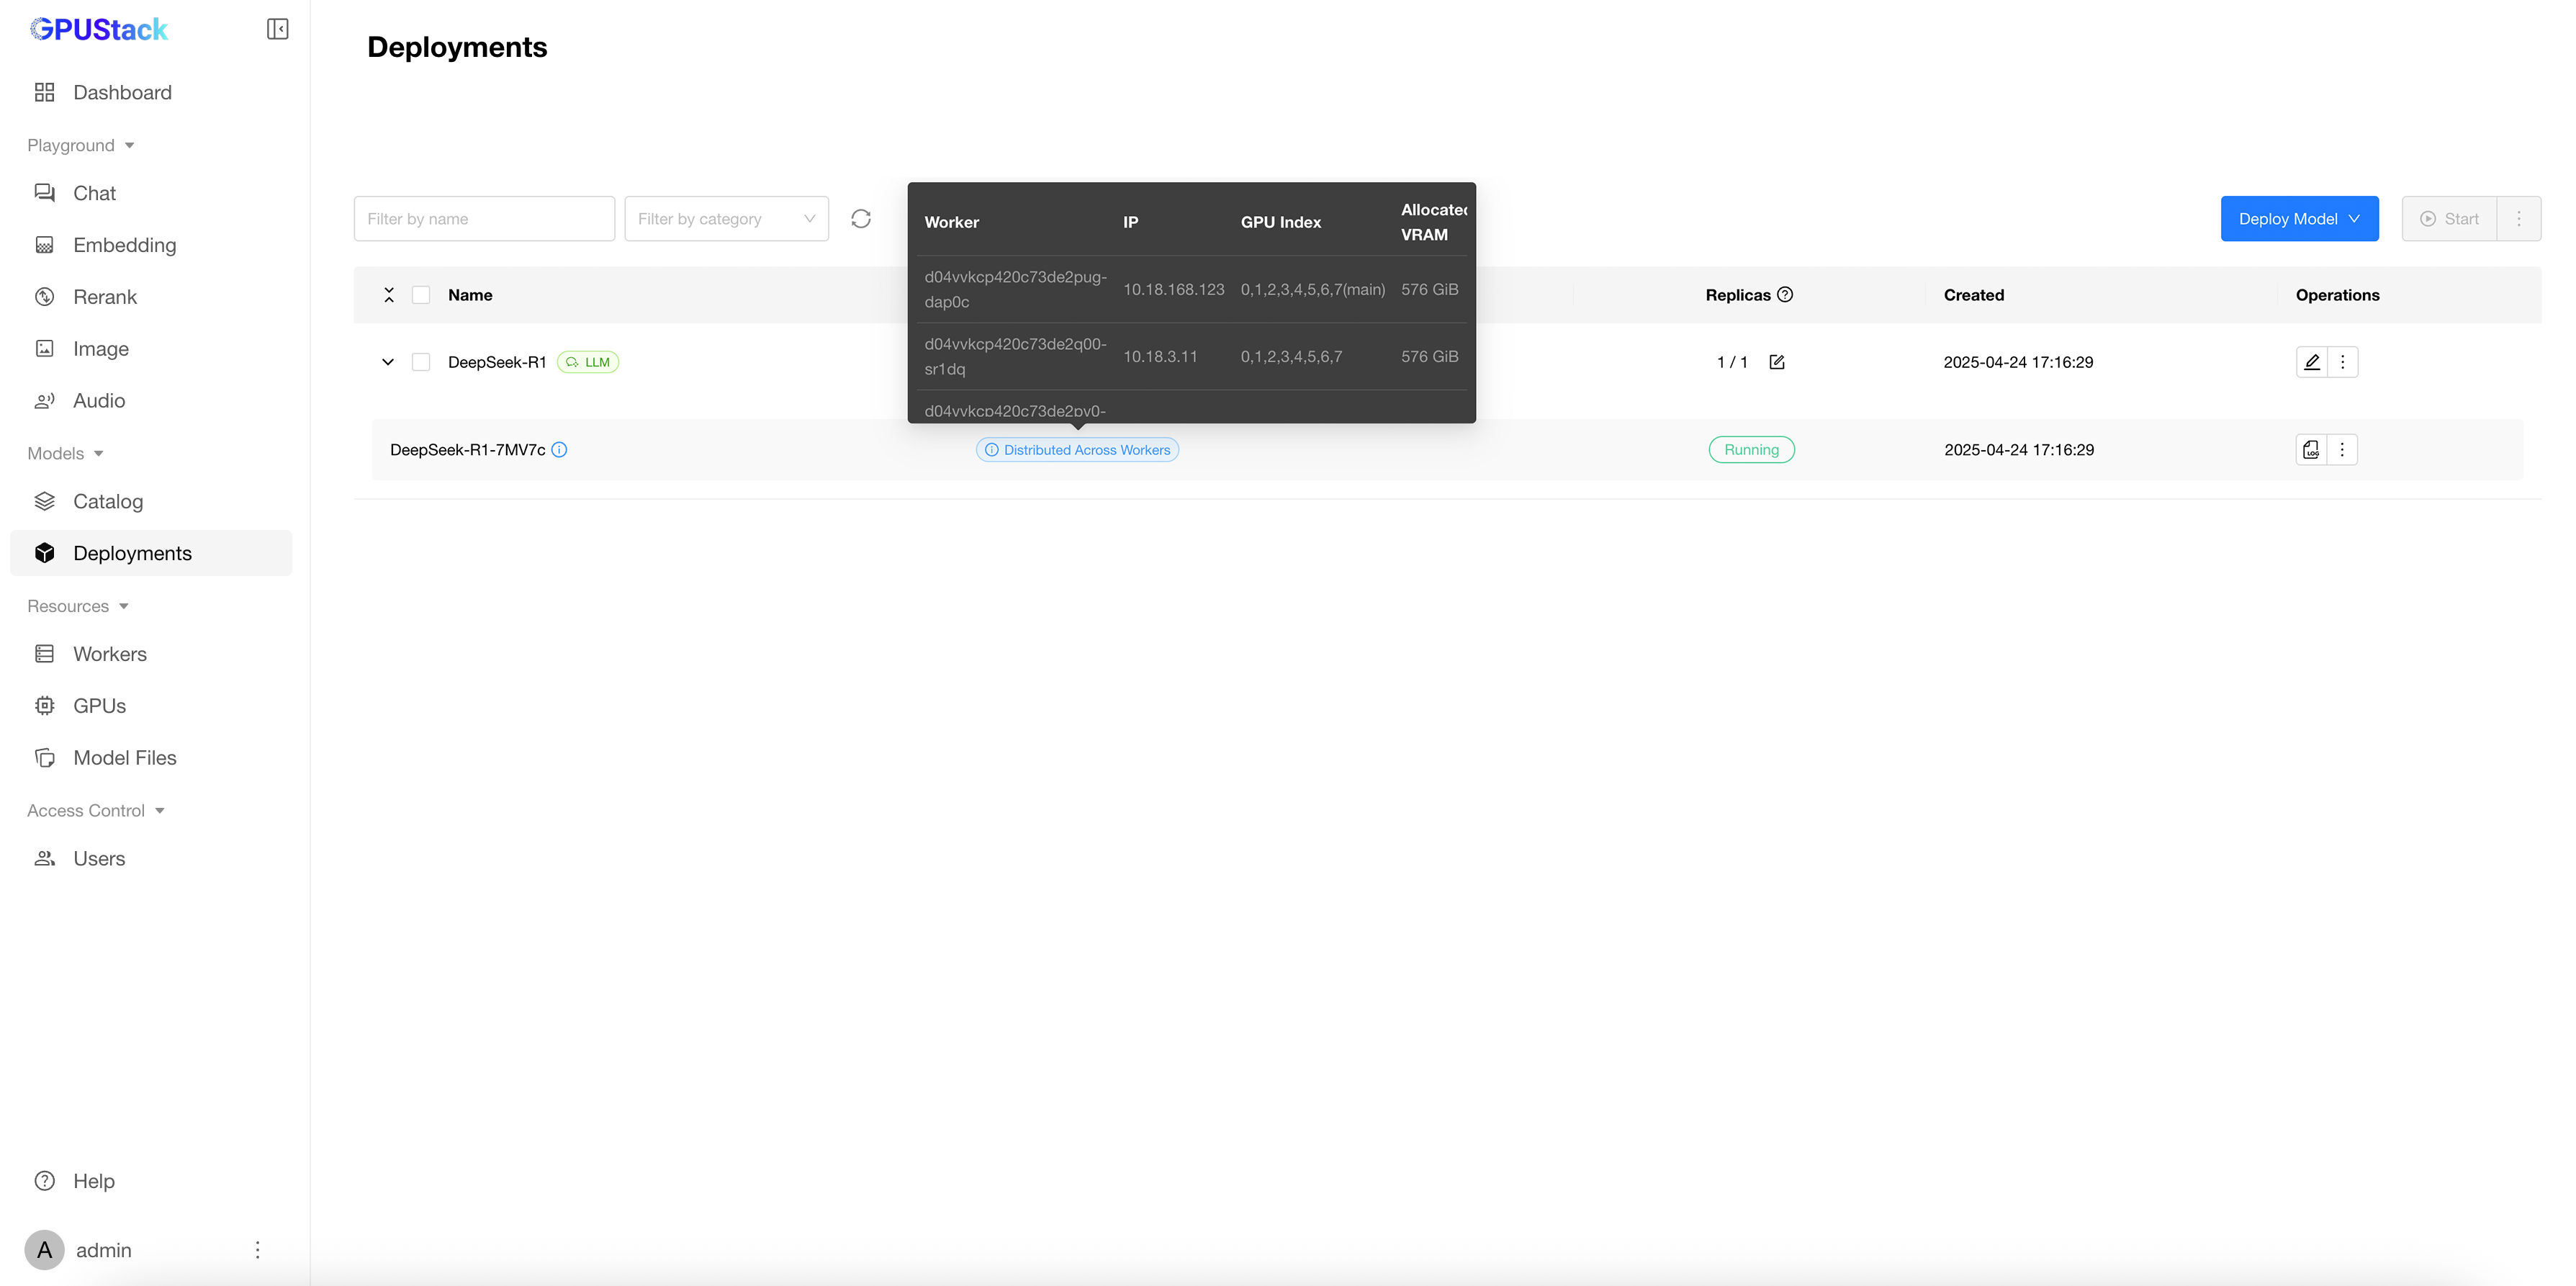
Adım 5: Dağıtımı İzleyin
Dağıtım durumunu Deployments sayfasından izleyebilirsiniz. GPU ve çalışan kullanımını görüntülemek için distributed across workers'in üzerine gelin. Model yükleme ilerlemesini gösteren gerçek zamanlı günlükleri görmek için View Logs'ye tıklayın. Modelin yüklenmesi birkaç dakika sürebilir.
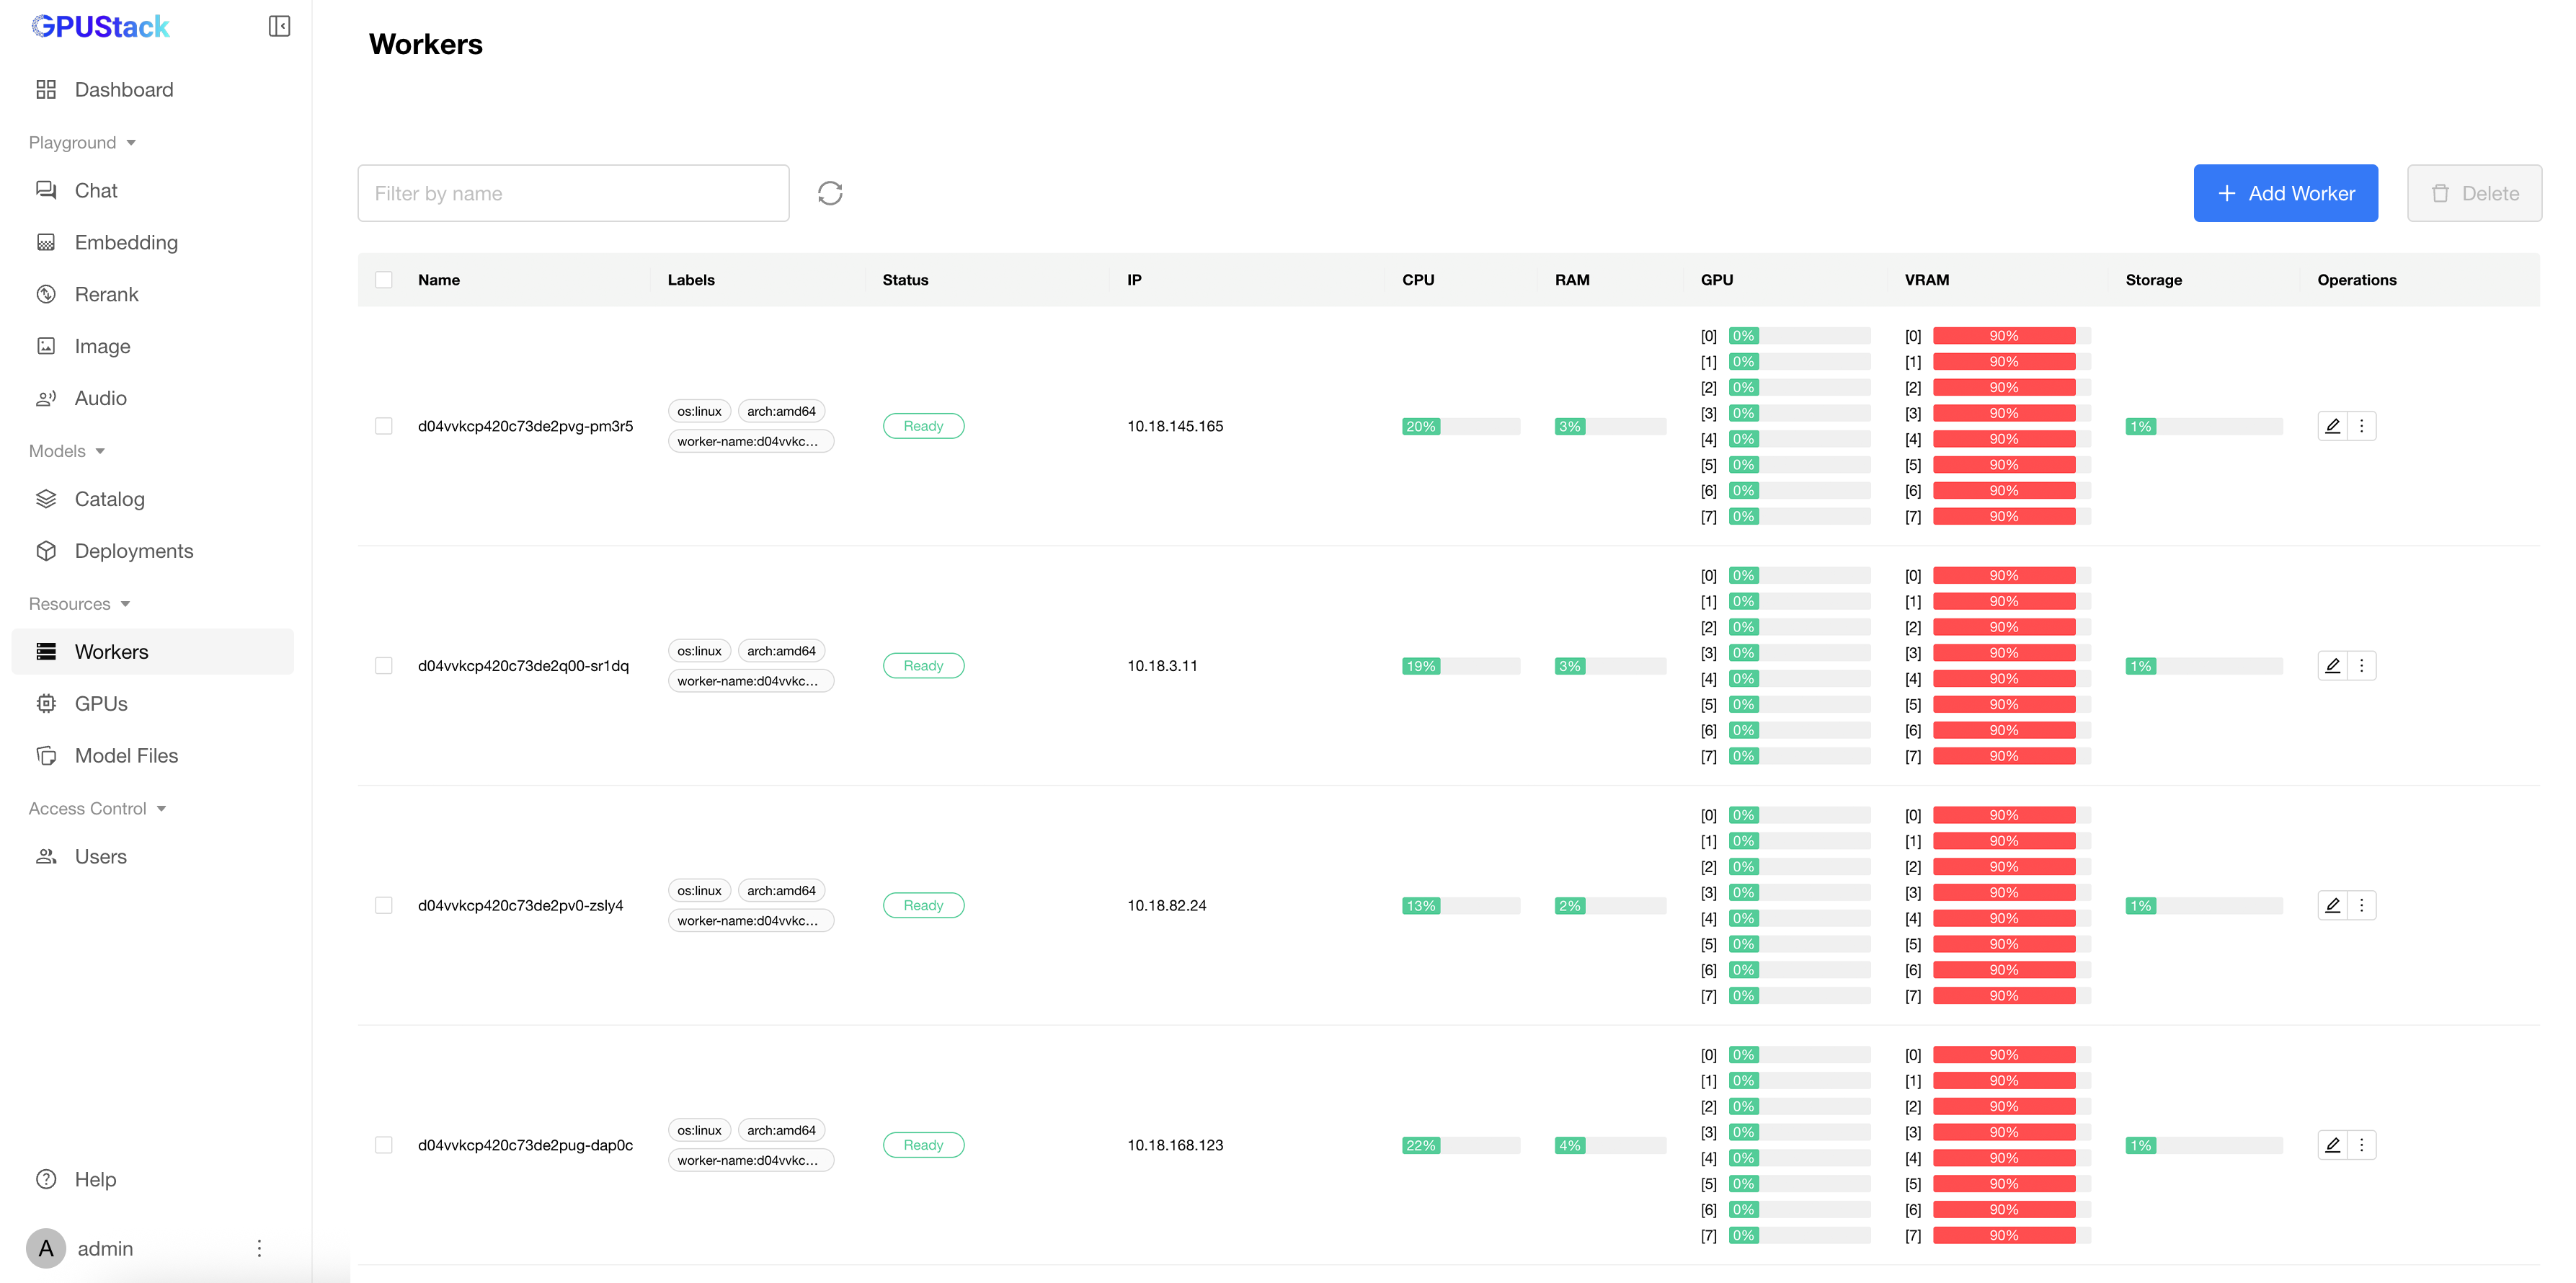
Model çalıştıktan sonra GPU kullanımını kontrol etmek için Workers sayfasına gidin. Varsayılan olarak vLLM, GPU belleğinin %90'ını kullanır. Bunu model yapılandırma ayarlarından ayarlayabilirsiniz.
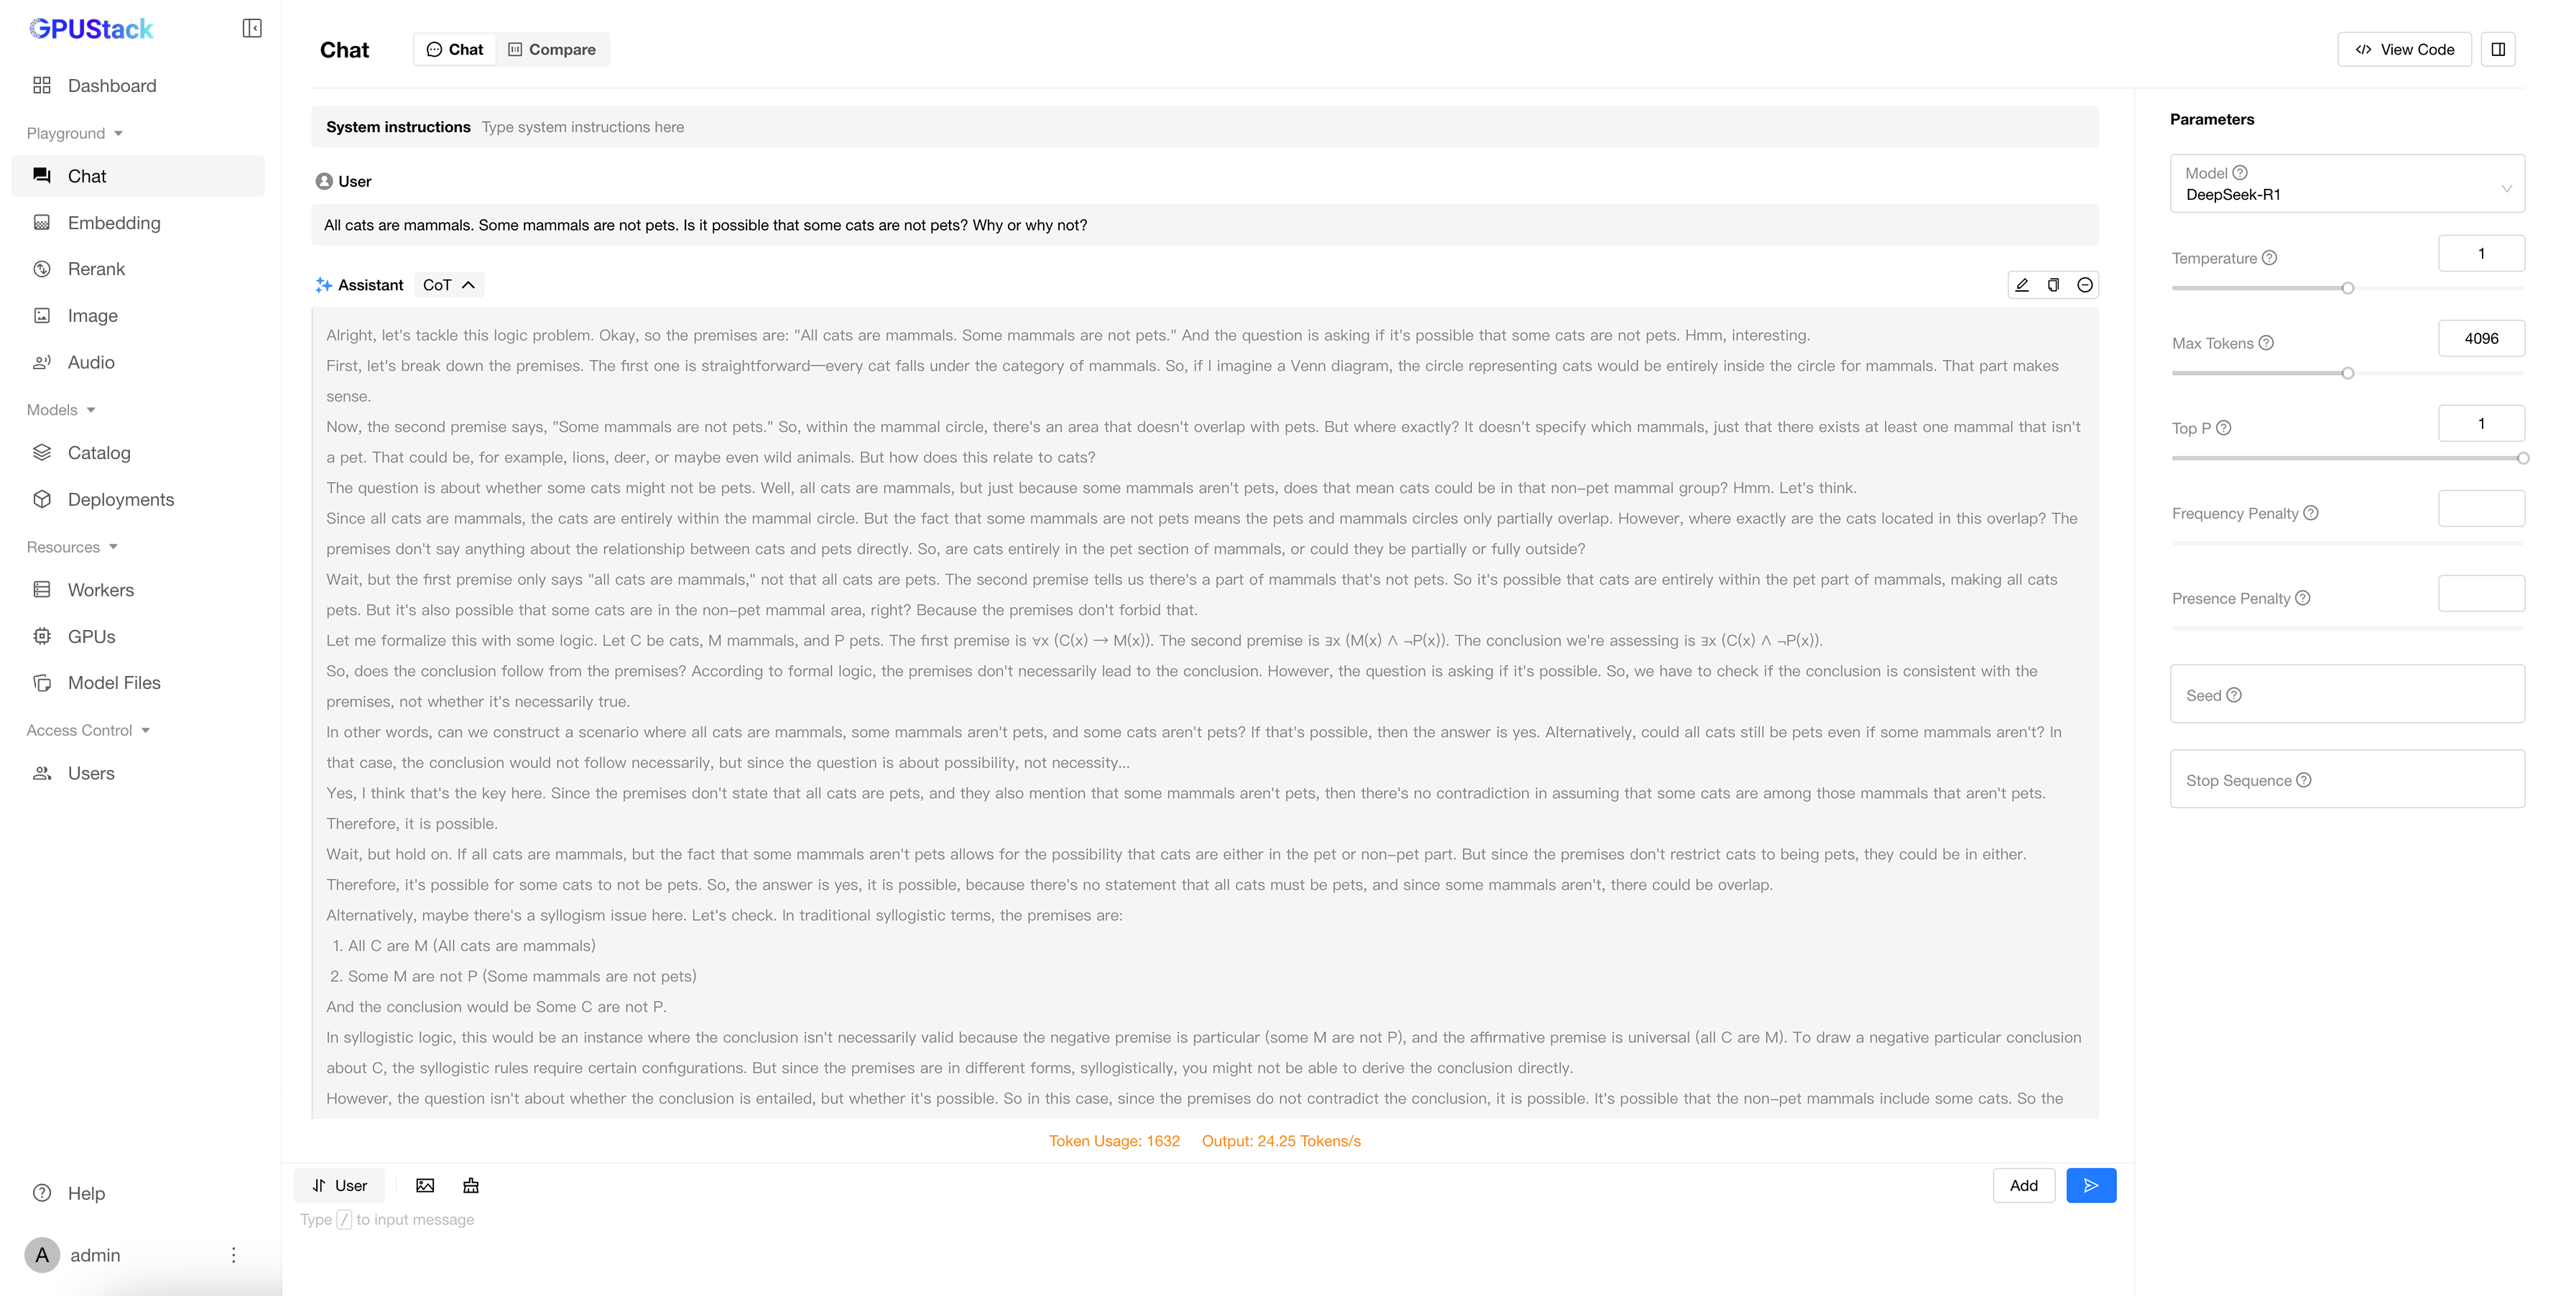
Adım 6: Çıkarımı Oyun Alanı Aracılığıyla Çalıştırın
Model dağıtıldıktan ve çalıştırıldıktan sonra GPUStack Playground'u kullanarak test edebilirsiniz.
Playground->Chatseçeneğine gidin.- Yalnızca bir model dağıtılırsa varsayılan olarak seçilecektir. Aksi takdirde,
DeepSeek-R1seçeneğini seçmek için açılır menüyü kullanın. - İstemleri girin ve modelle etkileşime geçin.
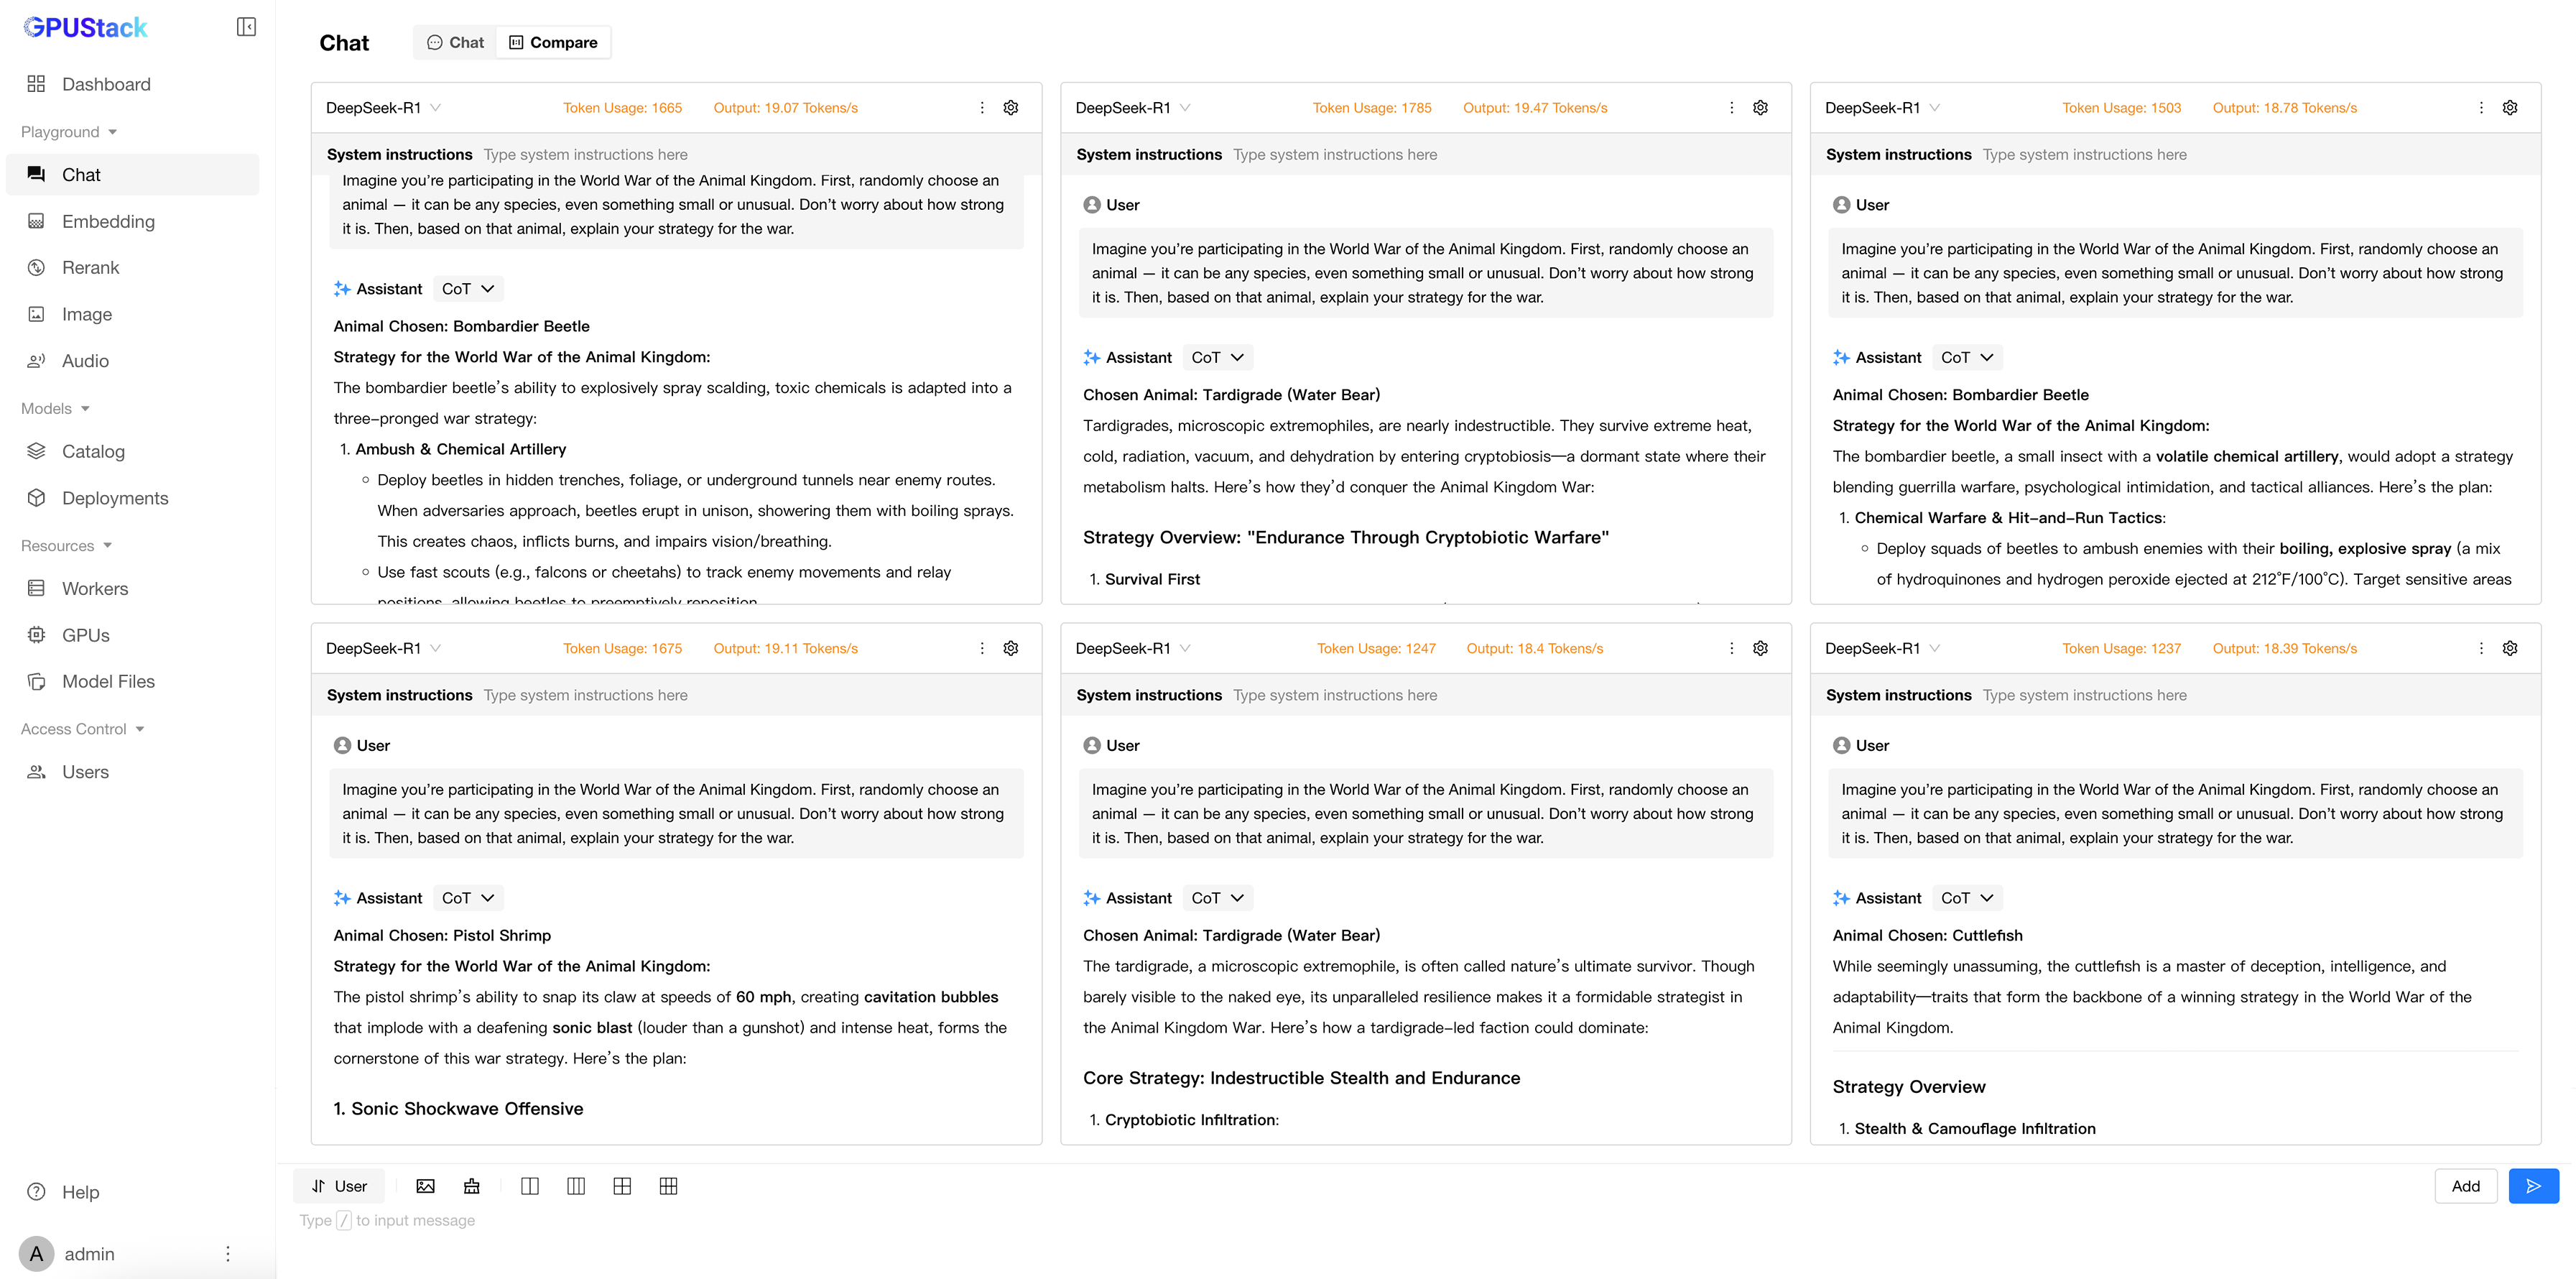
Eşzamanlı çıkarım senaryolarını test etmek için Compare sekmesini de kullanabilirsiniz.
Artık DeepSeek R1 671B'yi Dağıtılmış vLLM'yi kullanarak GPUStack kümesinde başarıyla dağıttınız ve çalıştırdınız. Modelin performansını ve yeteneklerini kendi uygulamalarınızda keşfedin.
Daha fazla yardım için GPUStack topluluğu veya destek ekibiyle iletişime geçmekten çekinmeyin.