Песочница аудио
Песочница аудио предназначена для тестирования API преобразования текста в речь (TTS) и речи в текст (STT) в GPUStack. Она позволяет интерактивно преобразовывать текст в аудио и аудио в текст, настраивать параметры и изучать примеры кода для интеграции с API.
Преобразование текста в речь
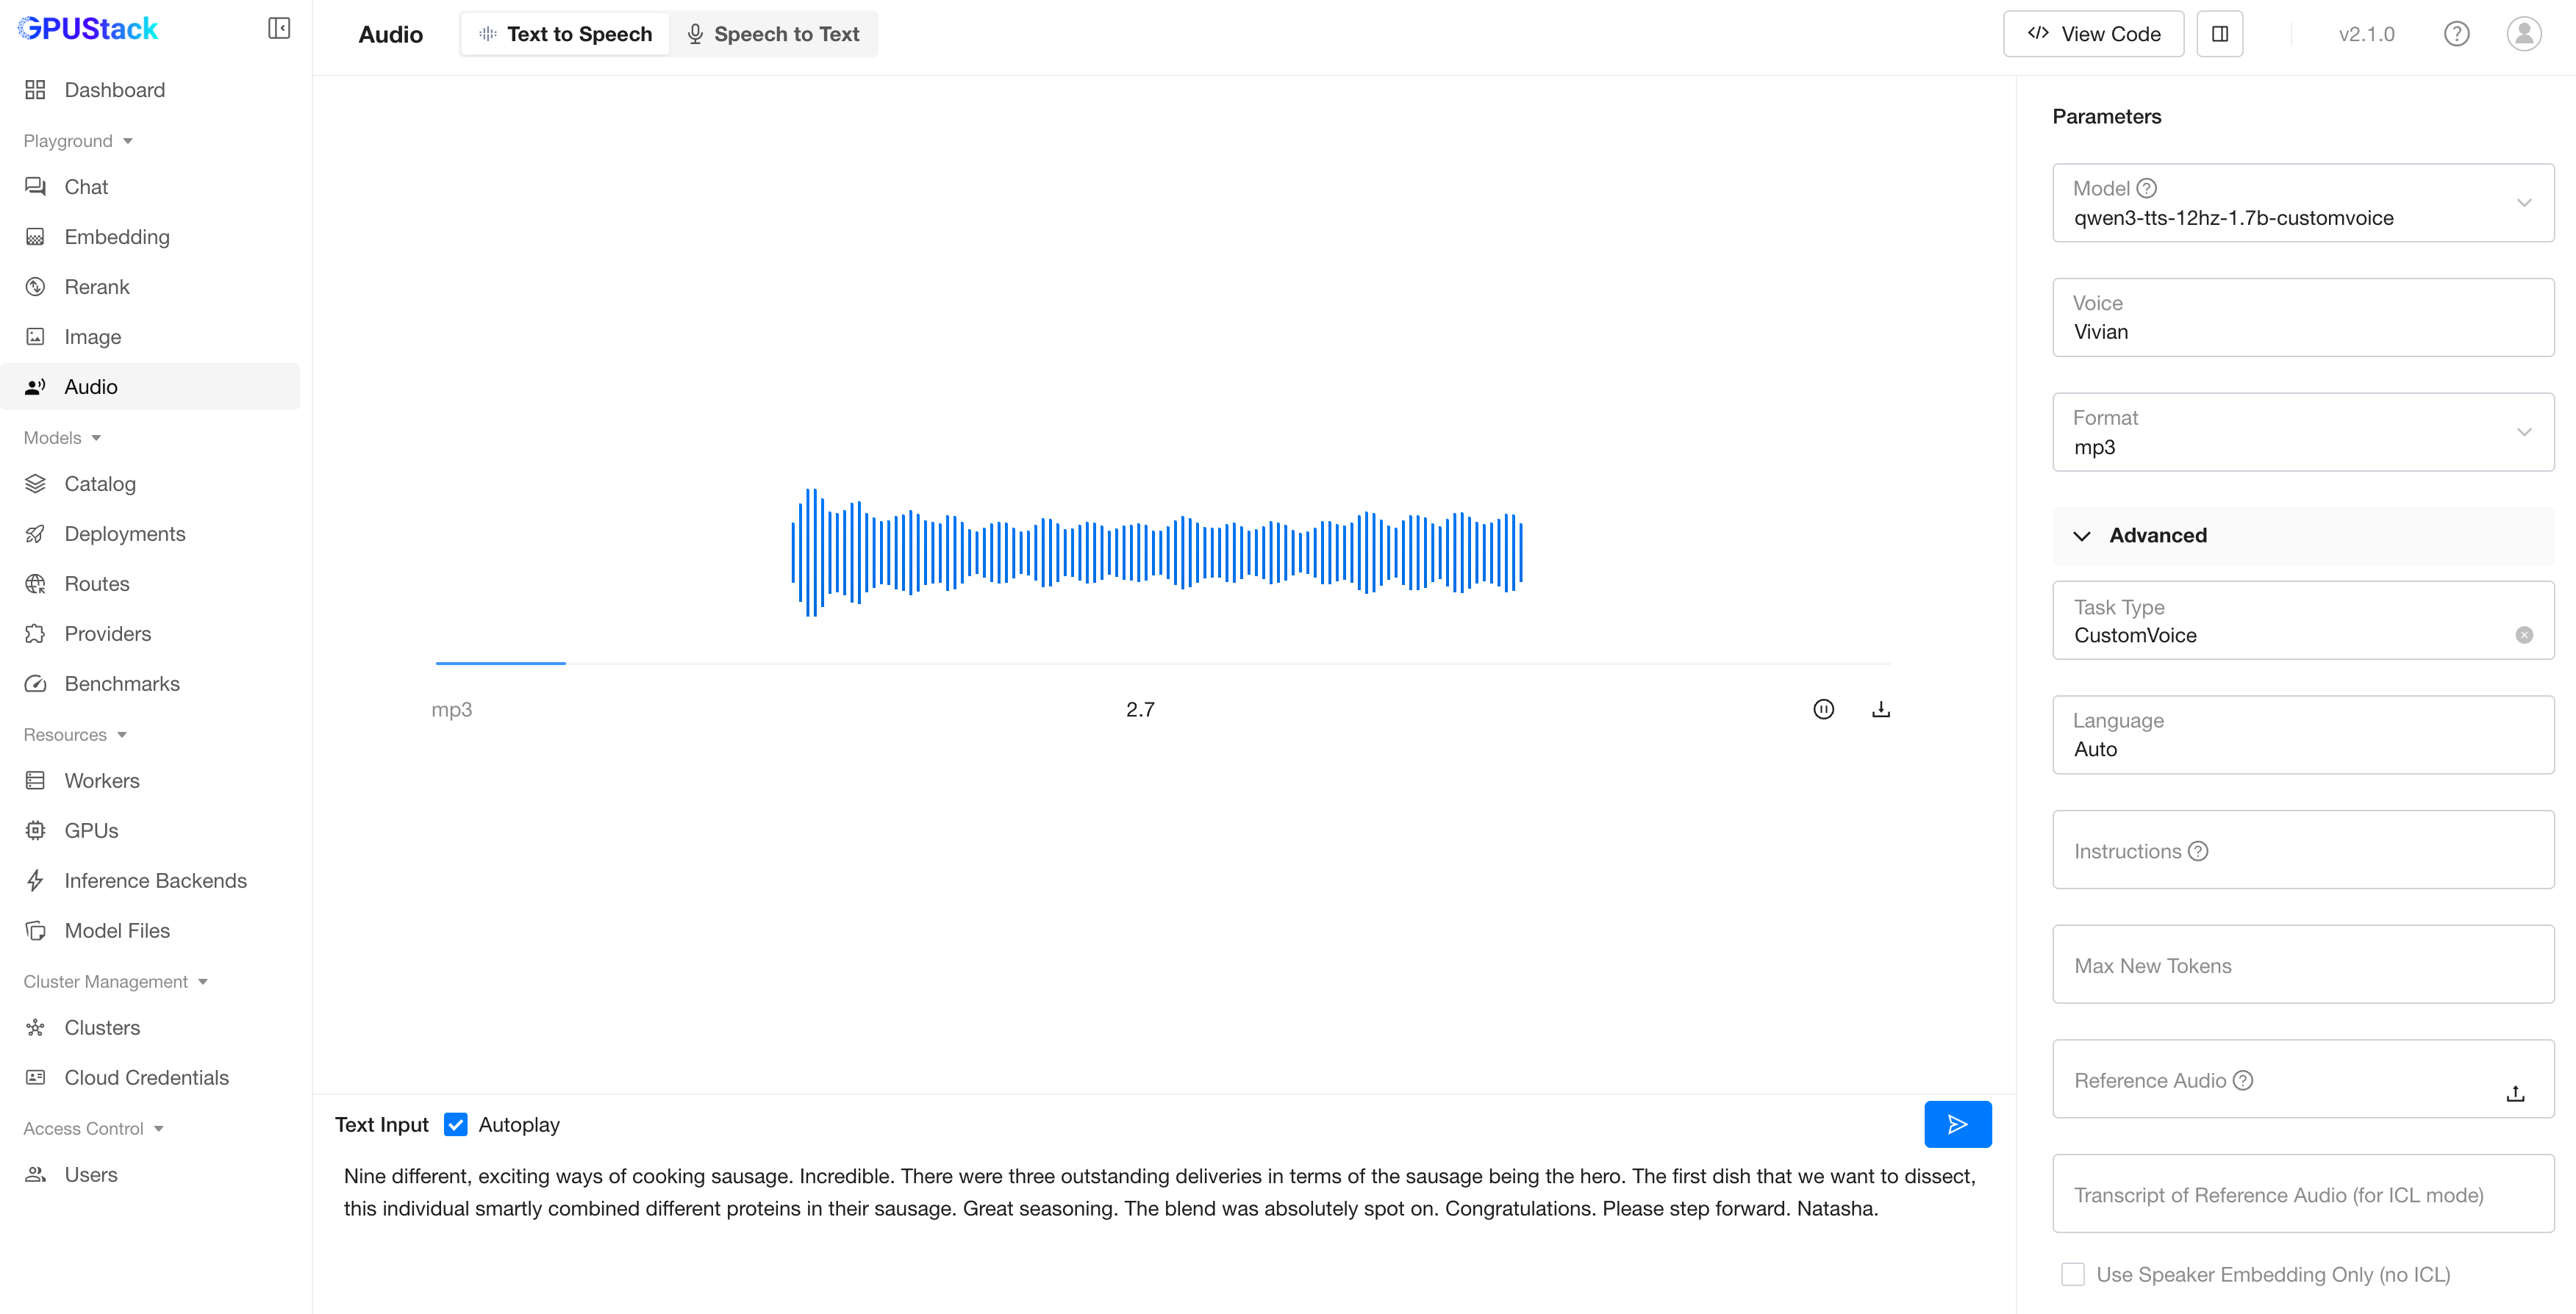
Для тестирования моделей TTS откройте вкладку «Text to Speech».
Ввод текста
Введите текст для преобразования, затем нажмите Submit, чтобы сгенерировать речь.
Выбор модели
Выберите доступную модель TTS в GPUStack из раскрывающегося списка моделей в правом верхнем углу песочницы.
Настройка параметров
Настройте голос и формат выходного аудио.
Совет
Набор поддерживаемых голосов зависит от модели.
Просмотр кода
Поэкспериментировав с текстом и параметрами, нажмите View Code, чтобы увидеть, как вызвать API с теми же входными данными. Доступны примеры на curl, Python и Node.js.
Преобразование речи в текст
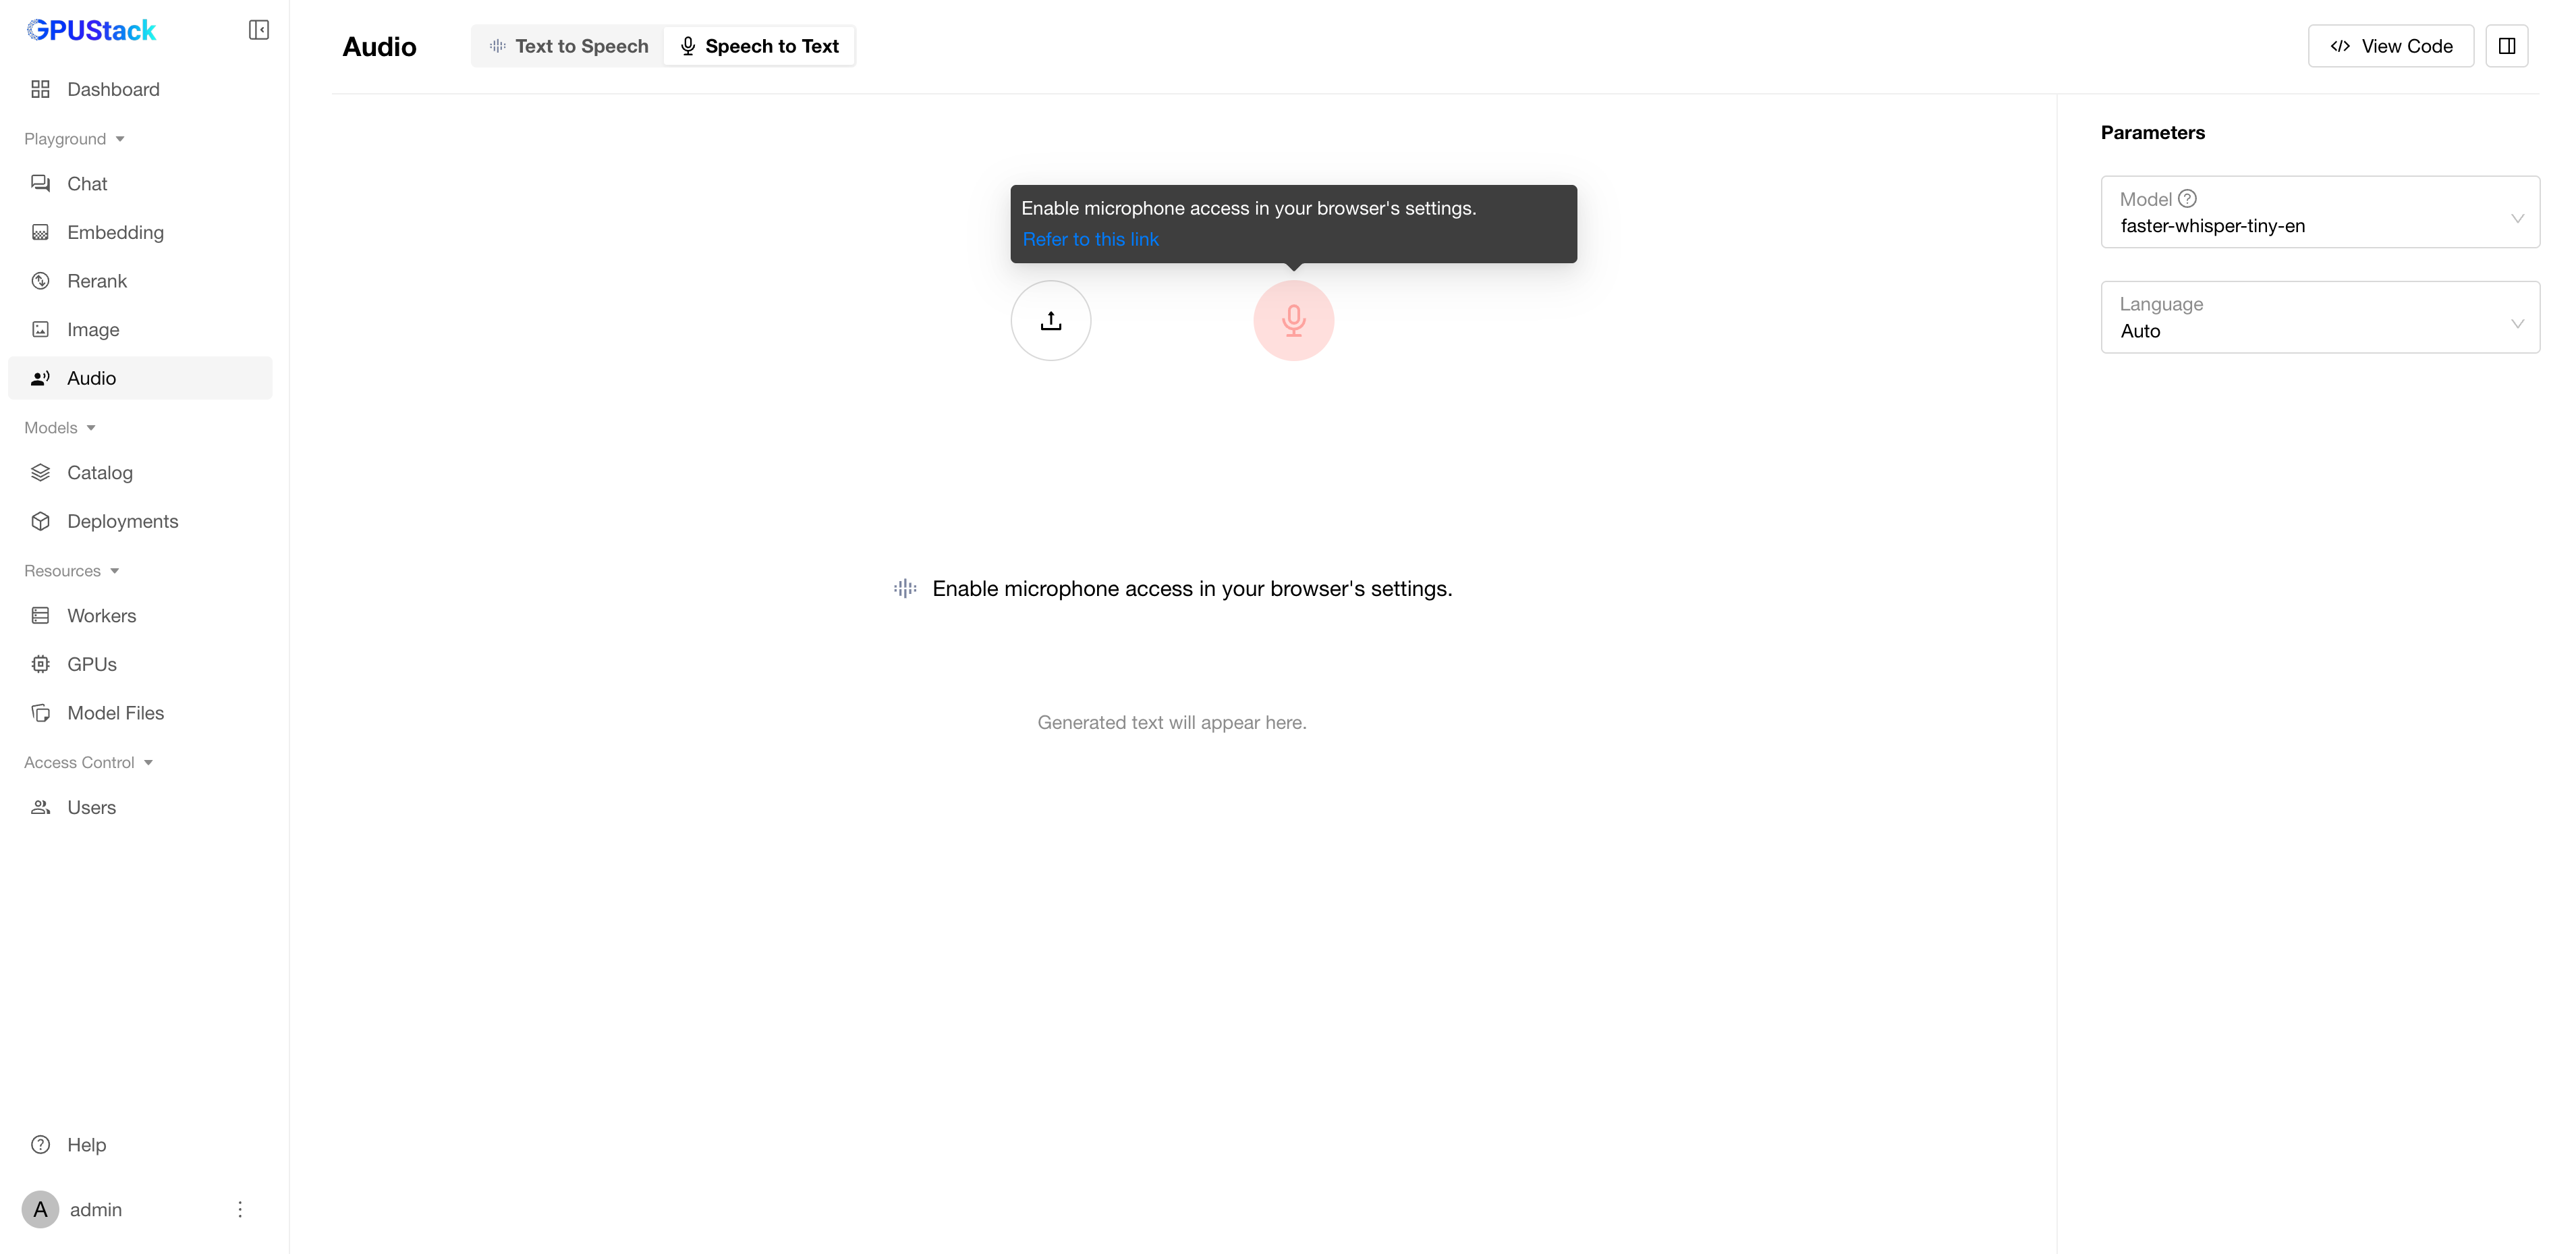
Для тестирования моделей STT откройте вкладку «Speech to Text».
Передача аудиофайла
Передать аудио для распознавания можно двумя способами:
- Загрузить аудиофайл
- Записать аудио в браузере
Примечание
Если запись в браузере недоступна, возможны следующие причины:
- При доступе через HTTPS или
http://localhostбраузеру необходимо разрешить использование микрофона. -
При доступе через
http://{host IP}URL необходимо добавить в список доверенных адресов браузера.Пример: В Chrome откройте
chrome://flags/, добавьте URL GPUStack в параметр «Insecure origins treated as secure» и включите его.
Выбор модели
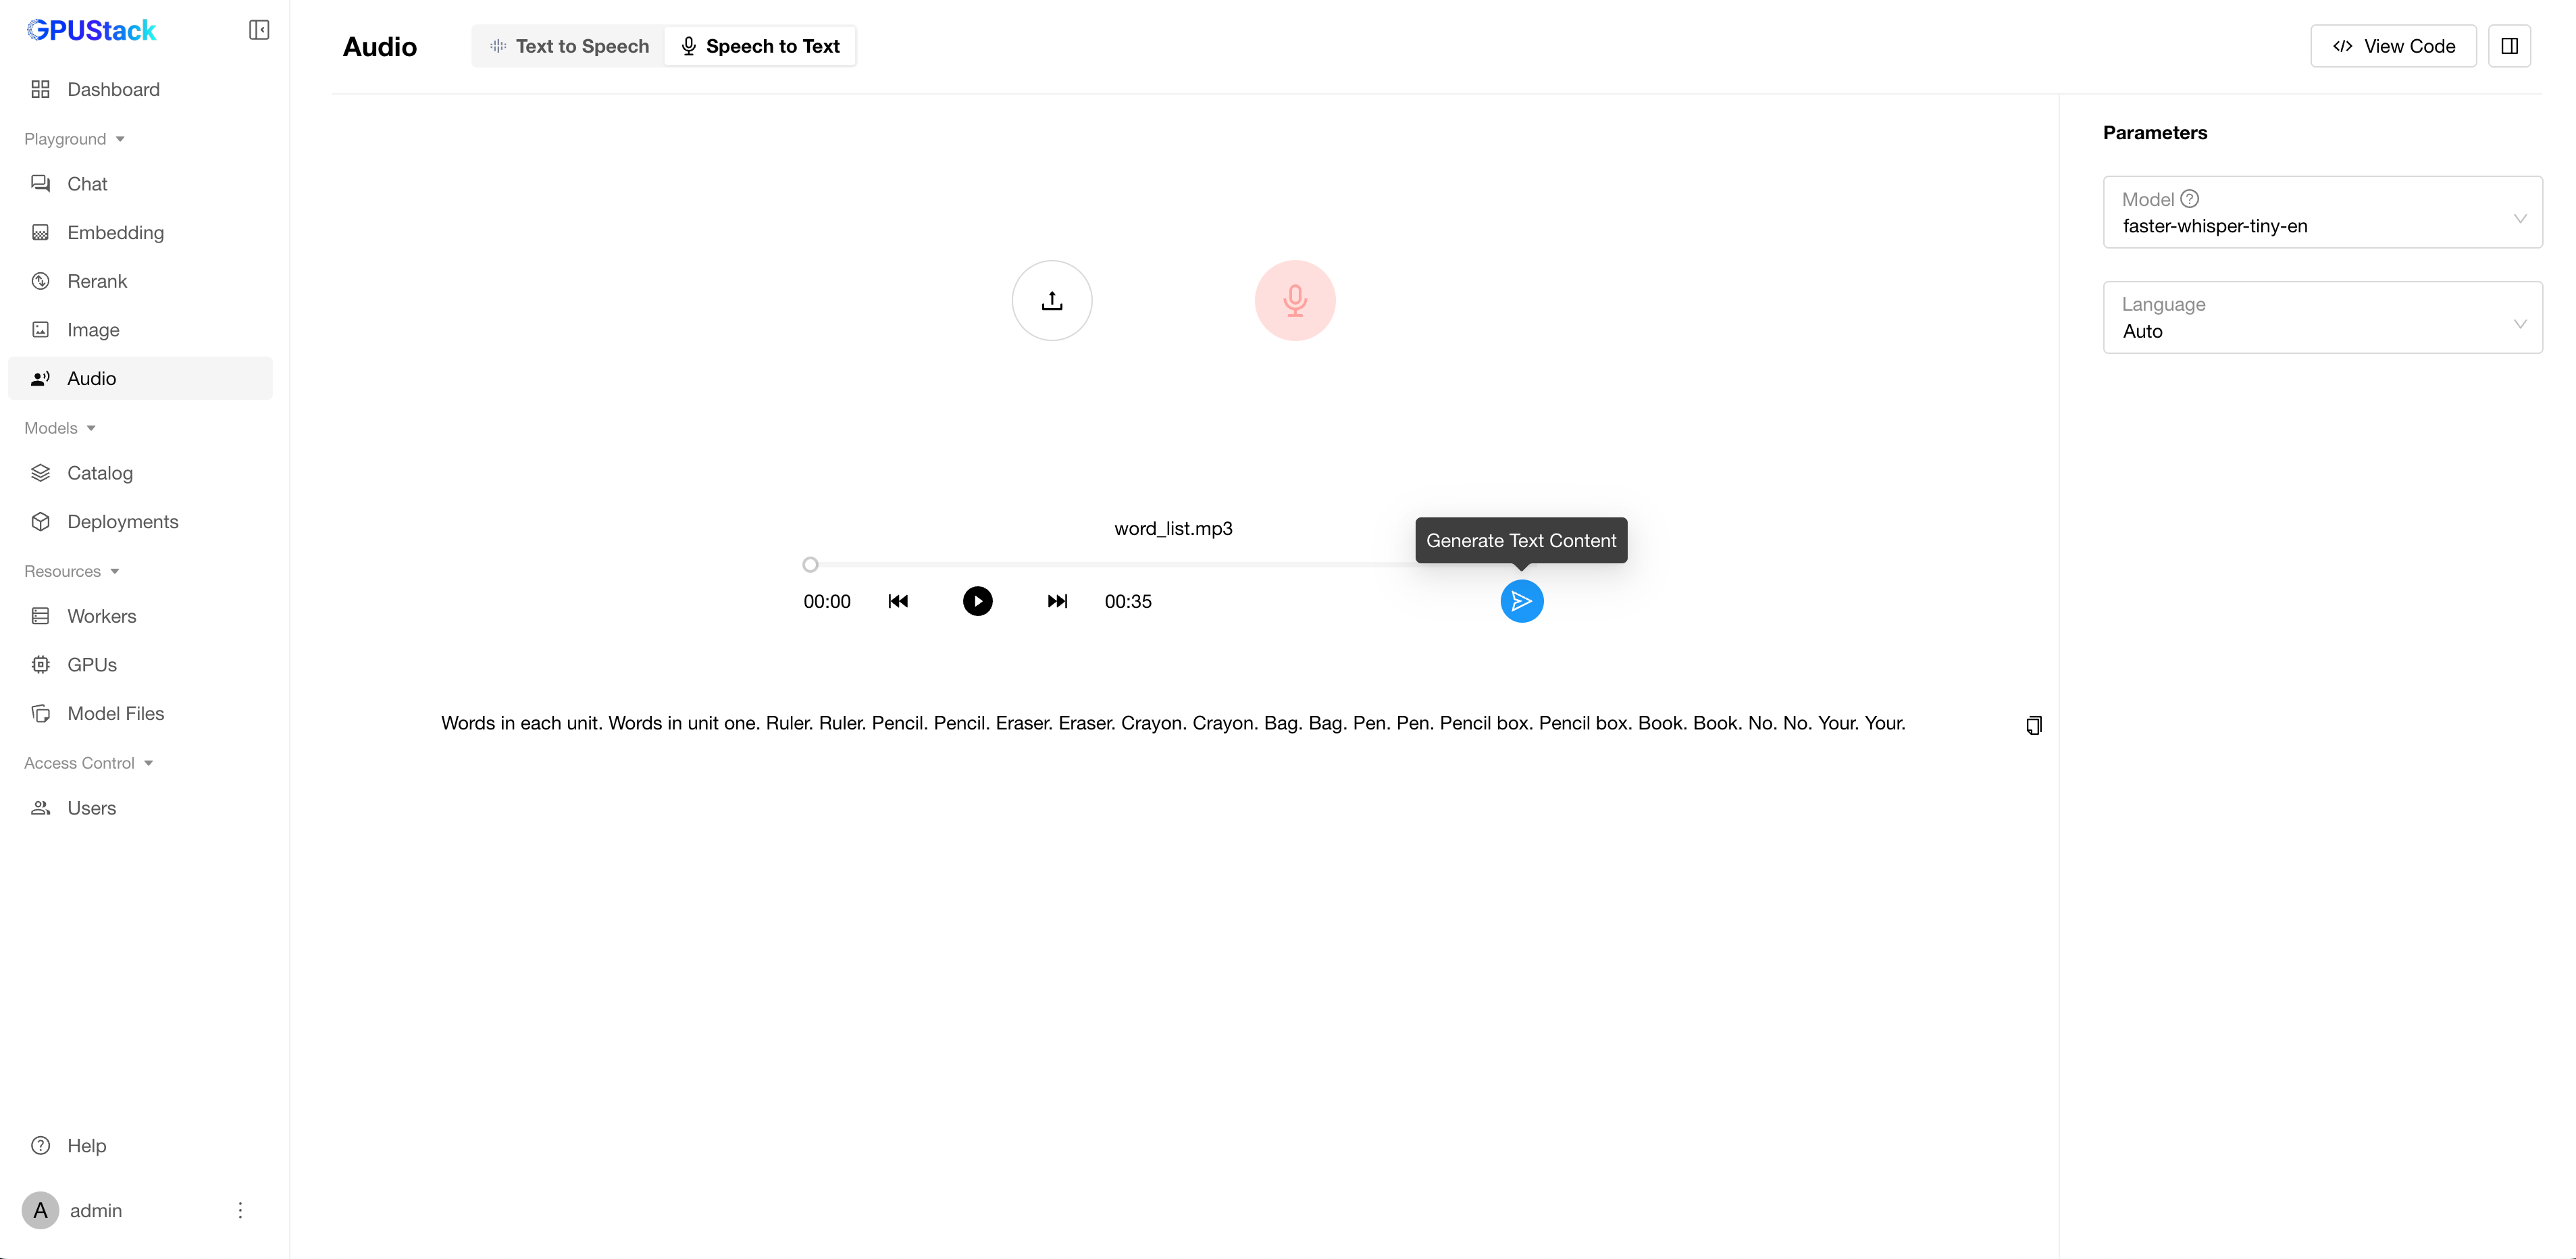
Выберите доступную модель STT в GPUStack из раскрывающегося списка моделей в правом верхнем углу песочницы.
Копирование текста
Скопируйте результат распознавания речи, созданный моделью.
Настройка параметров
Выберите язык аудиофайла, чтобы повысить точность распознавания.
Просмотр кода
Поэкспериментировав с аудиофайлами и параметрами, нажмите View Code, чтобы увидеть, как вызвать API с теми же входными данными. Доступны примеры на curl, Python и Node.js.