Использование пользовательских механизмов вывода
В этом руководстве объясняется, как добавлять собственные серверные части вывода в GPUStack, в том числе использовать проверенные конфигурации сообщества и создавать свои собственные с нуля.
Описание параметров см. в Руководстве пользователя.
Типы бэкэнда
GPUStack поддерживает три типа бэкендов вывода:
- Встроенный: предварительно настроенные серверные части (vLLM, MindIE, VoxBox, SGLang...), поддерживаемые GPUStack, автоматически оптимизированные для различного оборудования.
- Сообщество: предварительно проверенные пользовательские конфигурации серверной части. По сути, это CustomBackends, помеченные как «сообщество» для упрощения ручной настройки.
- Пользовательский: серверные части, которые вы настраиваете самостоятельно с помощью пользовательских образов и команд Docker.
Использование серверов сообщества
Серверные программы сообщества предоставляют самый быстрый способ добавления популярных механизмов вывода.
Шаги:
- Перейдите на страницу серверной части вывода → нажмите «Добавить серверную часть».
- Выберите опцию «Сообщество».
- Просмотрите «Backend Marketplace сообщества» и включите нужные вам бэкэнды.
Создание пользовательских бэкэндов
Основные шаги
- Подготовьте образ Docker для требуемого бэкэнда вывода.
- Изучите ENTRYPOINT или CMD образа, чтобы определить команду запуска.
- Добавьте конфигурацию на странице Inference Backend.
- Разверните модели и выберите вновь добавленный бэкэнд.
Пример: TensorRT-LLM.
Ниже в качестве примера используется TensorRT-LLM, иллюстрирующий, как добавлять и использовать серверную часть вывода.
Эти примеры представляют собой функциональные демонстрации, а не конфигурации, оптимизированные для производительности. Для повышения производительности обратитесь к официальной документации каждого бэкэнда для настройки.
- Найдите необходимое образ на странице выпуска, связанной с документацией TensorRT-LLM.
- Образы TensorRT-LLM должны запускать службу вывода с помощью
trtllm-serve; в противном случае они запускают интерактивный сеанс оболочки.run_commandподдерживает такие заполнители, как{{model_path}}и{{port}}(и дополнительно{{model_name}},{{worker_ip}},{{gpu_count}},{{gpu_ids}}), которые автоматически заменяются фактическими значениями, когда развертывание запланировано для работника.{{gpu_count}}и{{gpu_ids}}отражают графические процессоры, назначенные запланированному рабочему процессу (настраиваемые серверные части выполняются на одном рабочем процессе). -
Добавьте конфигурацию на странице Inference Backend; Поддерживается импорт YAML. Пример:
-
На странице «Развертывания» выберите недавно добавленный серверный компонент и разверните модель.
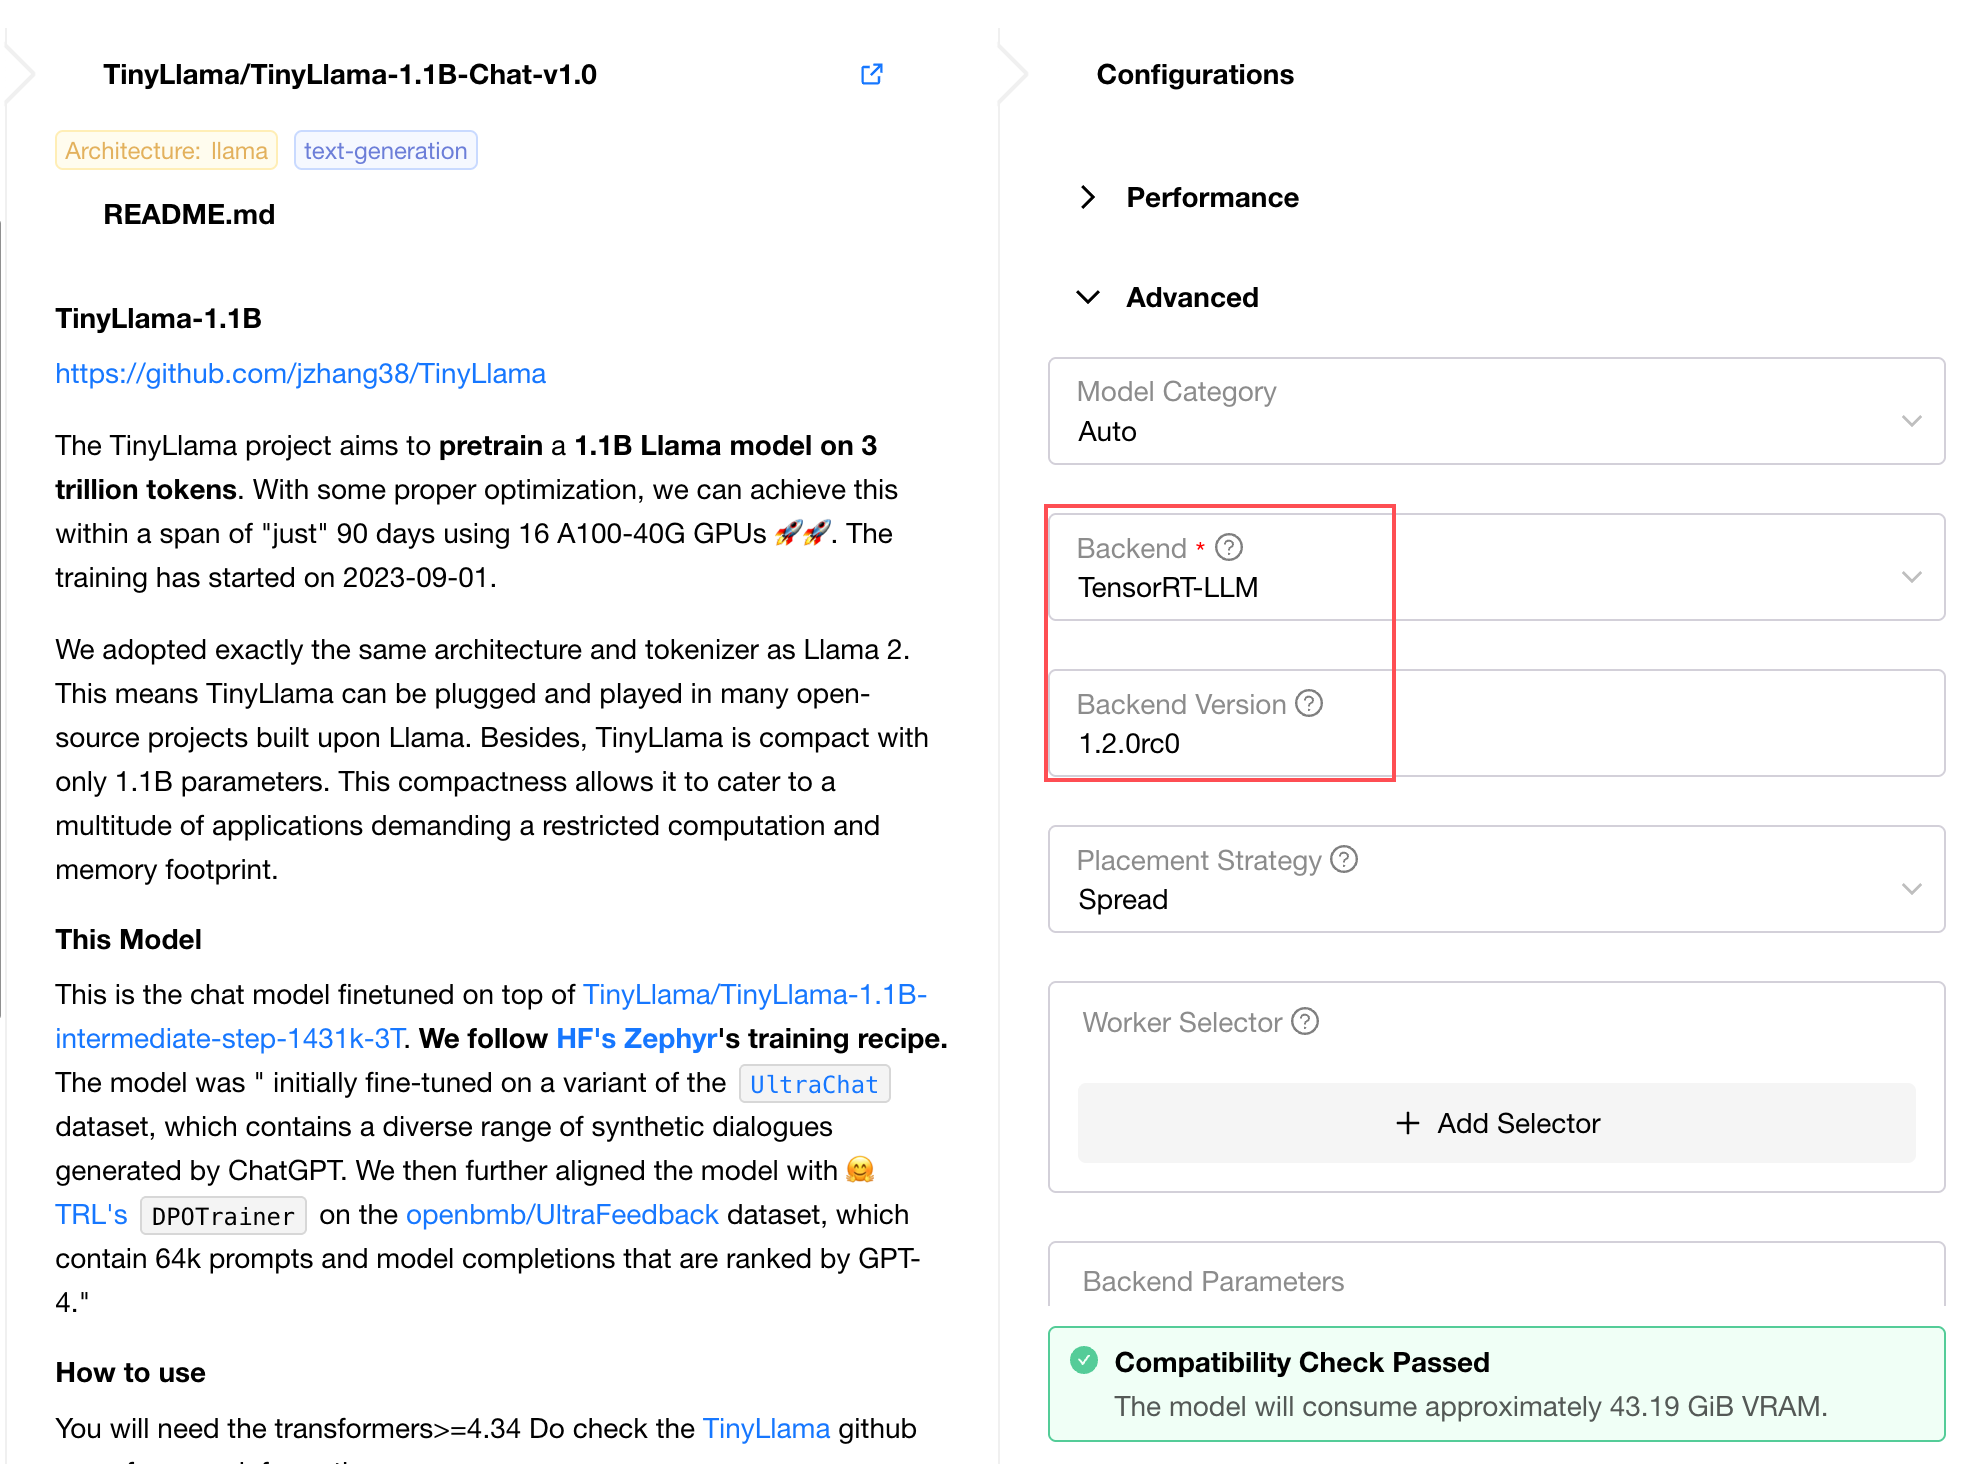
Результат
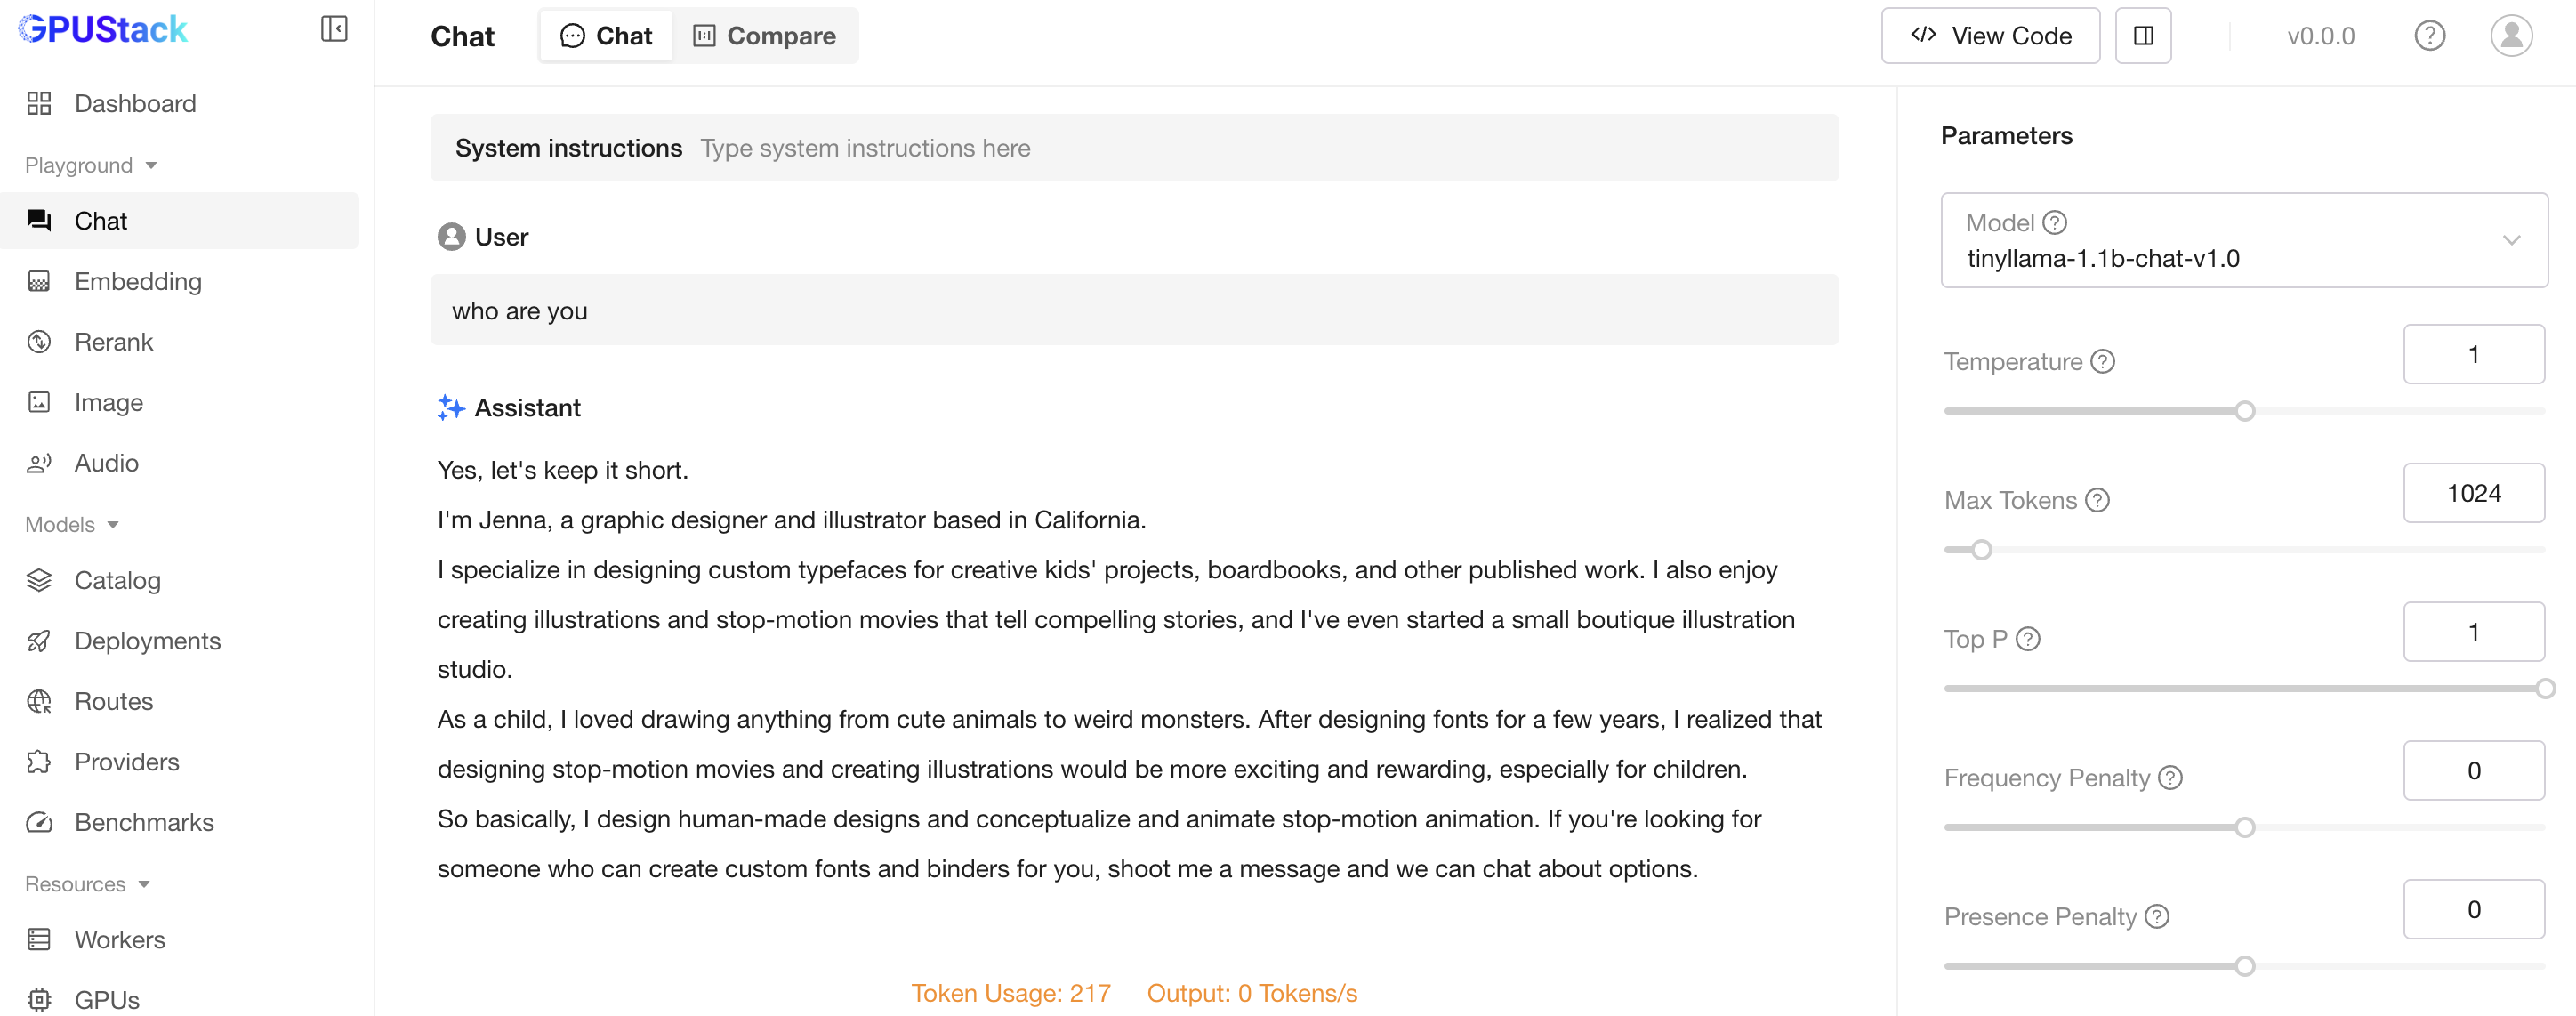
После запуска механизма вывода статус model_instance меняется на RUNNING. 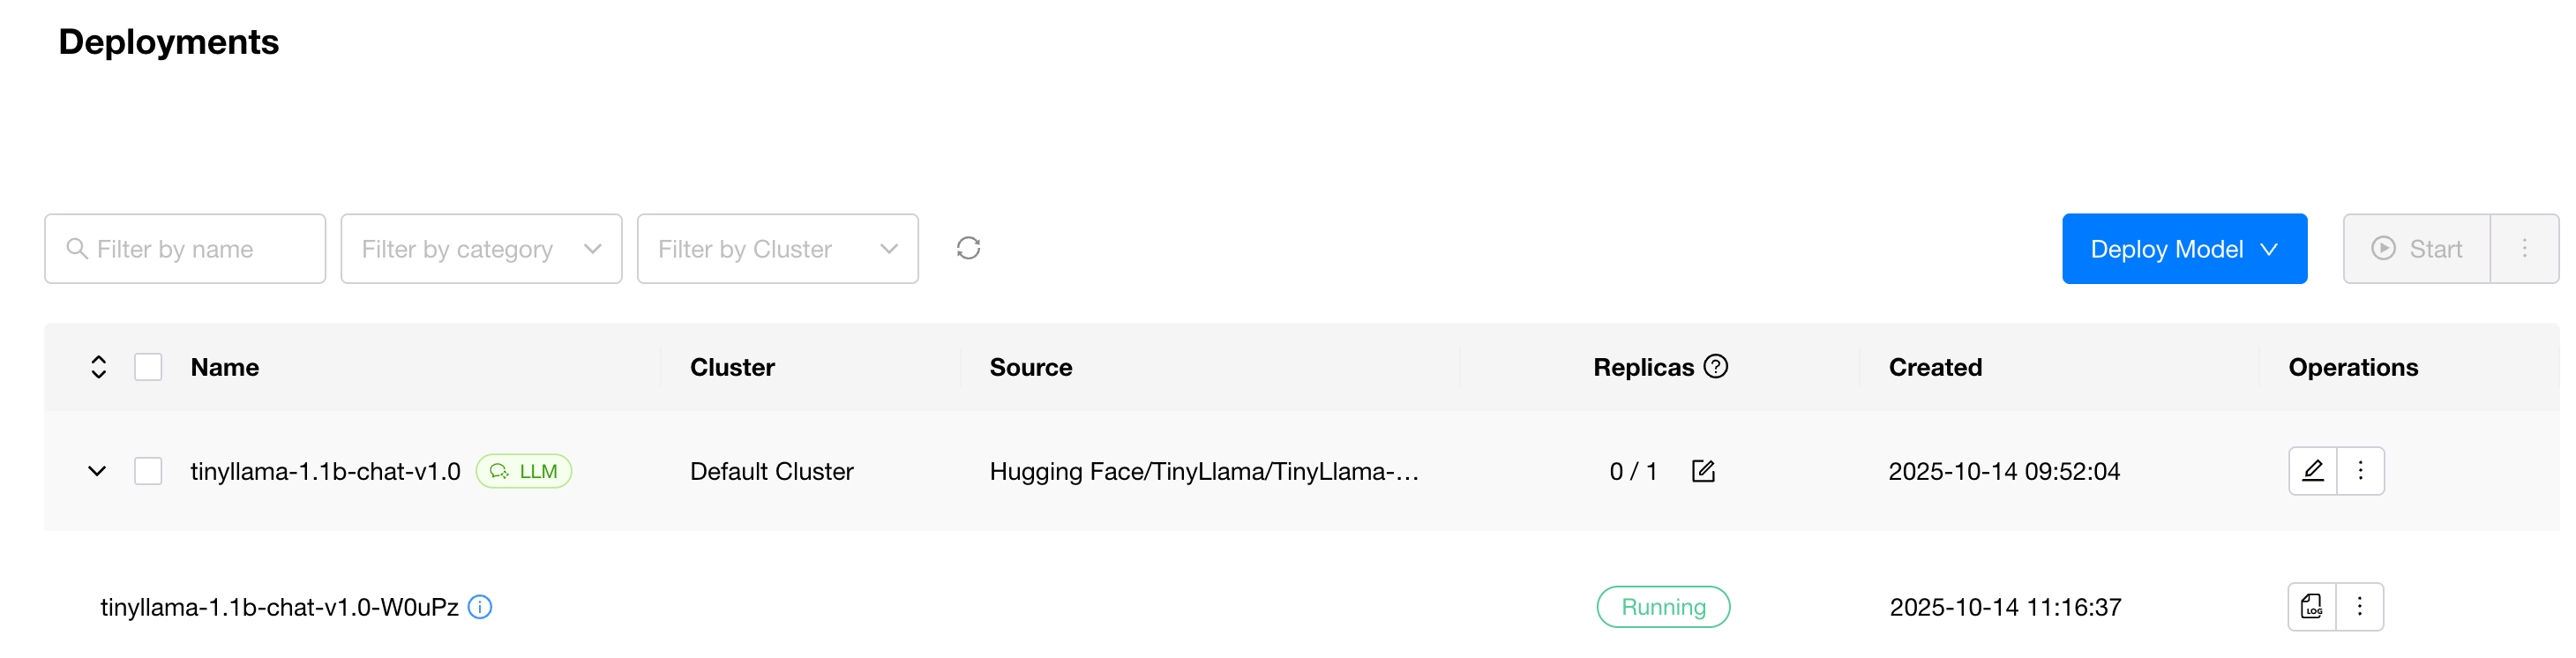 Вы можете участвовать в разговорах в Песочнице.
Расширенная конфигурация
Использование переменных среды
Переменные среды обеспечивают гибкую настройку без жесткого кодирования значений в командах:
В этом примере: - CACHE_DIR и LOG_LEVEL определены на уровне механизма вывода - Версия v1 переопределяет LOG_LEVEL на debug - Обе переменные упоминаются в команде с использованием синтаксиса {{VAR_NAME}}.
Пользовательская точка входа.
Переопределить точку входа контейнера по умолчанию, если образ требует пользовательской инициализации. Вы можете установить точки входа как на уровне серверной части, так и на уровне версии: