Запуск распределенной vLLM с помощью серверной части MultiProcessing.
Если одному рабочему процессу не хватает памяти графического процессора или вычислительных ресурсов для размещения модели, vLLM может разделить один экземпляр модели на несколько рабочих процессов для совместного вывода. GPUStack организует эти межузловые процессы как одиночный экземпляр модели и предоставляет только одну конечную точку, совместимую с OpenAI. vLLM предлагает два пути выполнения через параметр --distributed-executor-backend: ray и mp (MultiProcessing). В этом руководстве показано, как использовать серверную часть MP для выполнения распределенного вывода между несколькими рабочими процессами с комбинацией тензорного параллелизма (TP) и параллелизма данных (DP).
В этом руководстве вы узнаете, как включить распределенный логический вывод между работниками в GPUStack, явно выбрать серверную часть MP и объединить тензорный параллелизм с параллелизмом данных для развертывания одного экземпляра модели на двух узлах.
Примечание
- Серверная часть MP вступает в силу, когда вы явно устанавливаете
--distributed-executor-backend=mpвBackend Parametersили когда вы используете собственный образ (версия внутренней части с суффиксом-custom) с vLLM ≥0.18.0. Начиная с0.18.0, vLLM больше не зависит от Ray по умолчанию, поэтому GPUStack автоматически возвращается кmp, чтобы избежать сбоев при запуске. - Концептуальные различия между путями Ray и MP, безголовым последователем и топологиями
dp_only/mp_only/nestedсм. в разделеDistributed Inference Across Workersв Встроенные механизмы вывода. - Эта функция в настоящее время является экспериментальной.
Предварительные условия
Прежде чем начать, убедитесь, что у вас есть следующее:
- GPUStack установлен и работает.
- Не менее 2 узлов Linux, каждый из которых имеет одинаковое количество и одну и ту же модель графических процессоров. В этом руководстве в качестве примера используется 2 узла × 8 графических процессоров (всего 16 графических процессоров), применимых к ускорителям различных поставщиков, таких как NVIDIA, AMD и Ascend.
- Для повышения производительности рекомендуется использовать высокоскоростное соединение между узлами (например, NVLink или InfiniBand).
- Файлы модели должны быть доступны по одному и тому же пути на каждом участвующем узле. Используйте общую файловую систему или заранее загрузите файлы модели по одному и тому же пути на каждом узле.
- Выбранная модель подходит для компоновки
tensor-parallel-size=8,data-parallel-size=2(т. е. каждая реплика с параллельными данными занимает один полный узел с 8 графическими процессорами).
Примечание
В этом руководстве предполагается, что каждая реплика с параллельными данными (tensor-parallel-size=8) полностью занимает один узел с 8 графическими процессорами. Настройте --tensor-parallel-size и --data-parallel-size в соответствии с вашей моделью и оборудованием.
Шаг 1. Добавьте рабочие процессы GPUStack.
После Установка запустите команду соединения на каждом узле, чтобы добавить их в один и тот же кластер GPUStack.
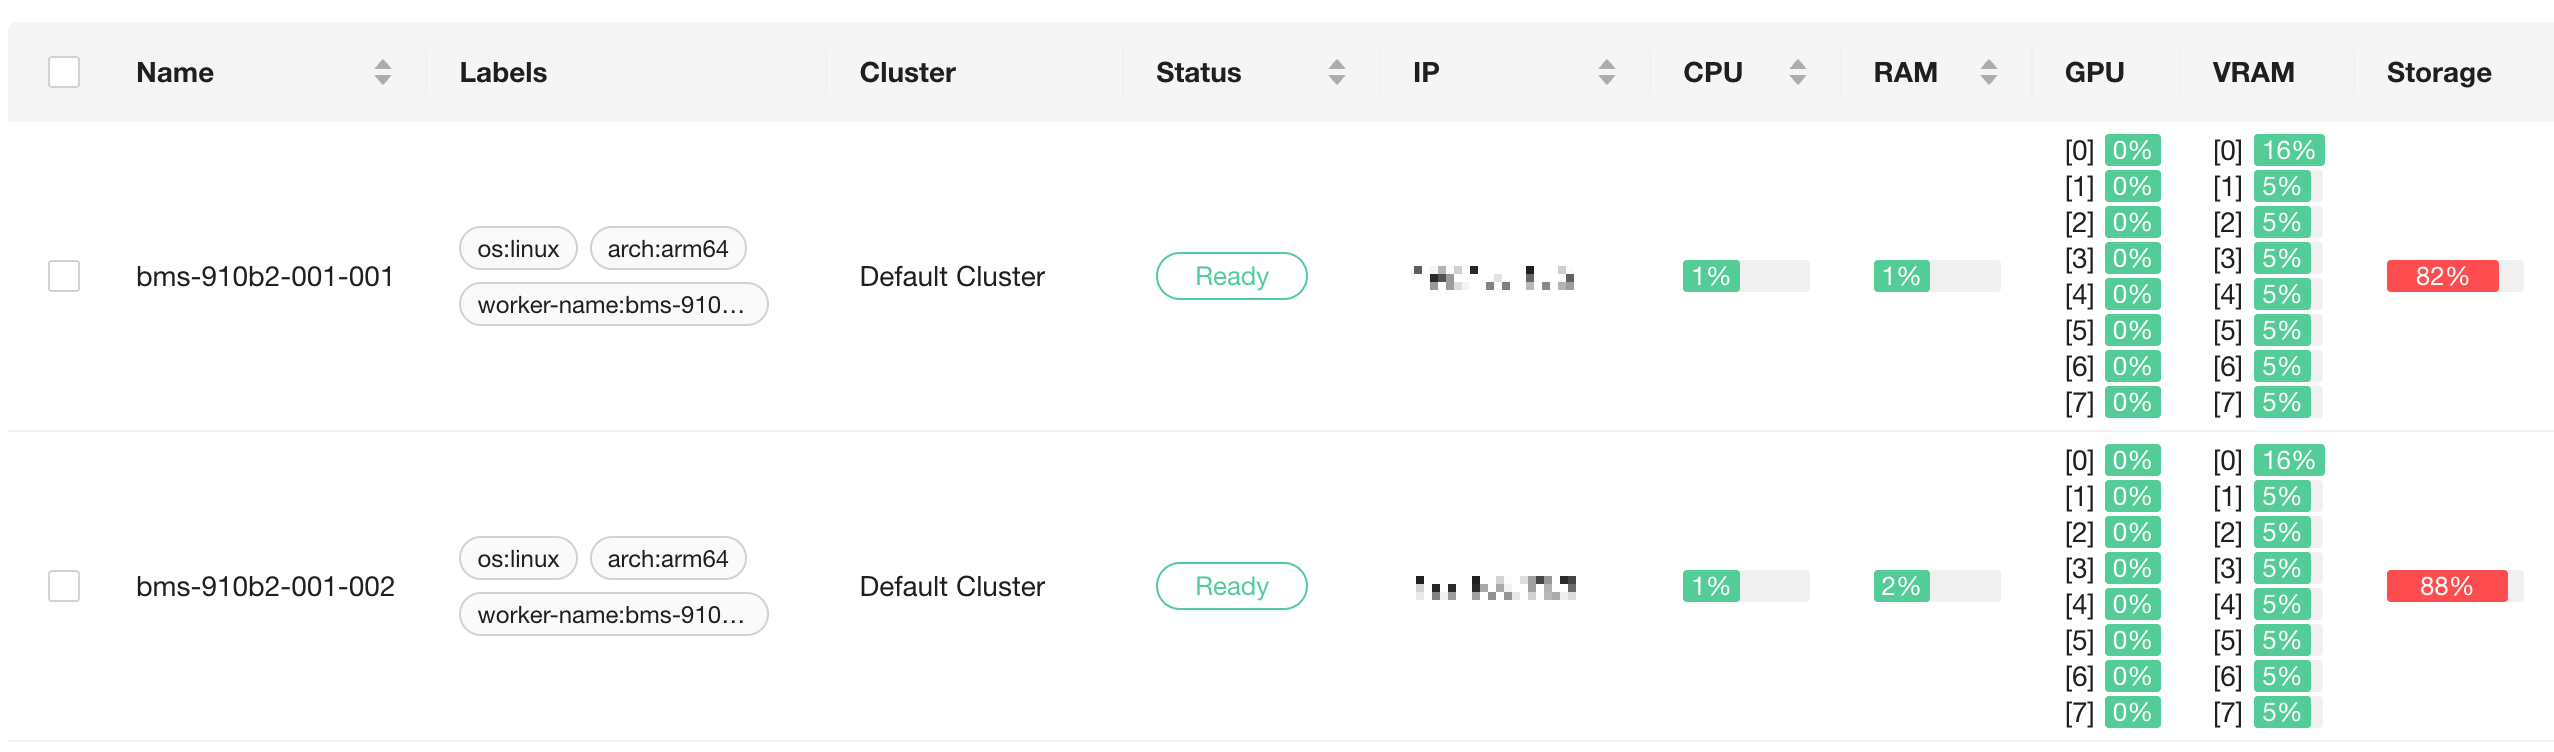
После их присоединения подтвердите на странице Workers пользовательского интерфейса GPUStack, что оба узла находятся в состоянии готовности и что их графические процессоры указаны в списке.
Шаг 2. Развертывание модели с помощью серверной части MP.
- Перейдите на страницу
Deployments. - Нажмите
Deploy Model, выберите источник модели (например,Local Path) и введите путь модели, одинаковый для всех узлов. - Убедитесь, что для
Backendустановлено значениеvLLM. - В дополнительных настройках установите флажок
Allow Distributed Inference Across Workers, чтобы включить распределенный вывод между работниками. -
Добавьте следующие параметры в
Backend Parameters: -
После прохождения проверки совместимости нажмите
Saveдля развертывания.
Разверните весь распределенный экземпляр как одно развертывание.
Мы рекомендуем развертывать распределенный экземпляр между узлами как одиночное развертывание. Когда вы создаете только одно развертывание, как описано выше, GPUStack:
- выберите графические процессоры для обоих рабочих процессов (16 в этом примере) и автоматически получите значение
--data-parallel-size-localдля каждого узла, поэтому вам не нужно устанавливать--data-parallel-size-localвручную; - внедрить параметры многоузловой топологии
--nnodes,--node-rank,--master-addrи--master-port; - автоматически добавляет
--headlessк экземплярам последователей, чтобы они участвовали только в распределенных вычислениях и не запускали конечную точку API. Ожидается появление--headlessв журналах подписчиков.
Когда автоматическое планирование не может быть выполнено
Если автоматическое планирование не может выделить ресурсы из-за невыполнения условия (например, память графического процессора не удовлетворяет gpu_memory_utilization), переключите Scheduling Mode на Manual или Specify GPU, а затем используйте GPU Selector, чтобы выбрать 8 графических процессоров на каждом из двух рабочих процессов (всего 16). См. Встроенные механизмы вывода для получения полных условий автоматического планирования.
Ручная настройка DP в отдельных развертываниях
Переменная GPUSTACK_MANUAL_DP, добавленная после GPUStack 2.3.1, позволяет вручную объединять несколько развертываний в группу DP при использовании новых версий vLLM MP. В разделе Environment Variables каждого развертывания задайте:
Например, для двух узлов с 8 GPU на каждом создайте два развертывания, вручную выберите для каждого 8 GPU соответствующего узла и задайте следующие Backend Parameters:
Замените <your-dp-coordinator-ip> на IP первого узла. Для второго развертывания используйте те же параметры, изменив --data-parallel-rank на 1. Дополнительно задавать GPUSTACK_SKIP_GPU_COUNT_CHECK не требуется.
Шаг 3. Мониторинг развертывания
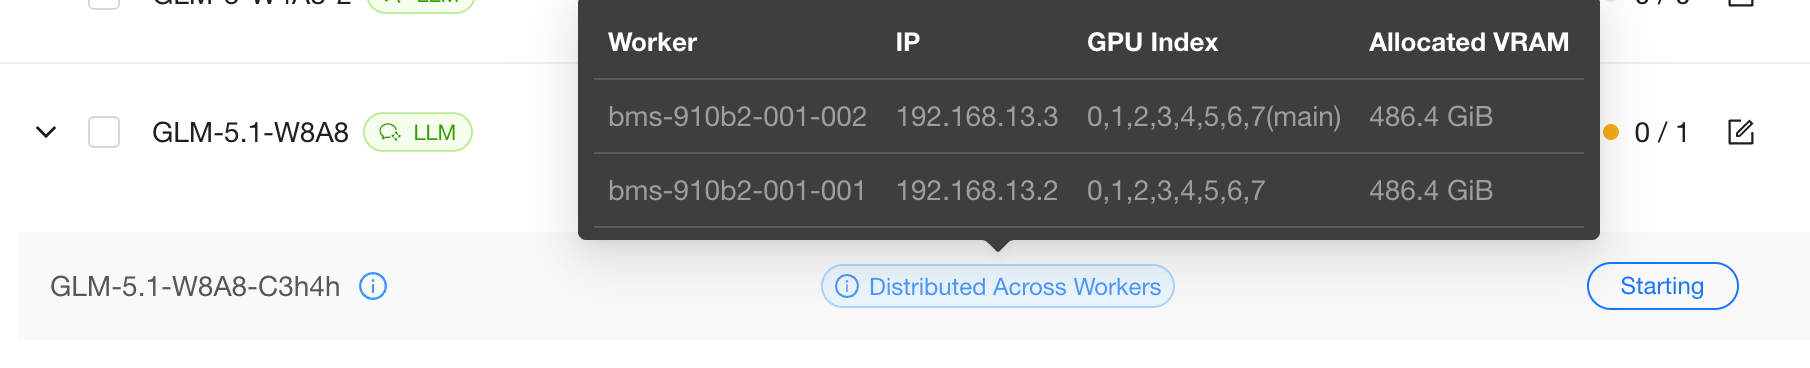
Отслеживайте статус развертывания на странице Deployments. Наведите указатель мыши на Distributed Across Workers, чтобы просмотреть использование графического процессора экземпляра для каждого рабочего процесса. Нажмите View Logs, чтобы просмотреть журналы в реальном времени:
- Экземпляр leader загружает модель и предоставляет конечную точку, совместимую с OpenAI;
- В журналах экземпляра follower указано
--headless, что означает, что он участвует только в распределенных вычислениях и не занимает порт API. Это ожидаемо.
Загрузка модели может занять несколько минут.
Шаг 4. Проверка через Песочницу.
После запуска развертывания проверьте его непосредственно в Песочнице GPUStack. Все внешние запросы поступают через лидера, который отправляет их последователям, поэтому их использование идентично развертыванию с одним работником:
- Перейдите к
Playground>Chat. - Если развернута только одна модель, она выбирается по умолчанию; в противном случае выберите свою модель в раскрывающемся меню в правом верхнем углу.
- Введите подсказку и взаимодействуйте с моделью.
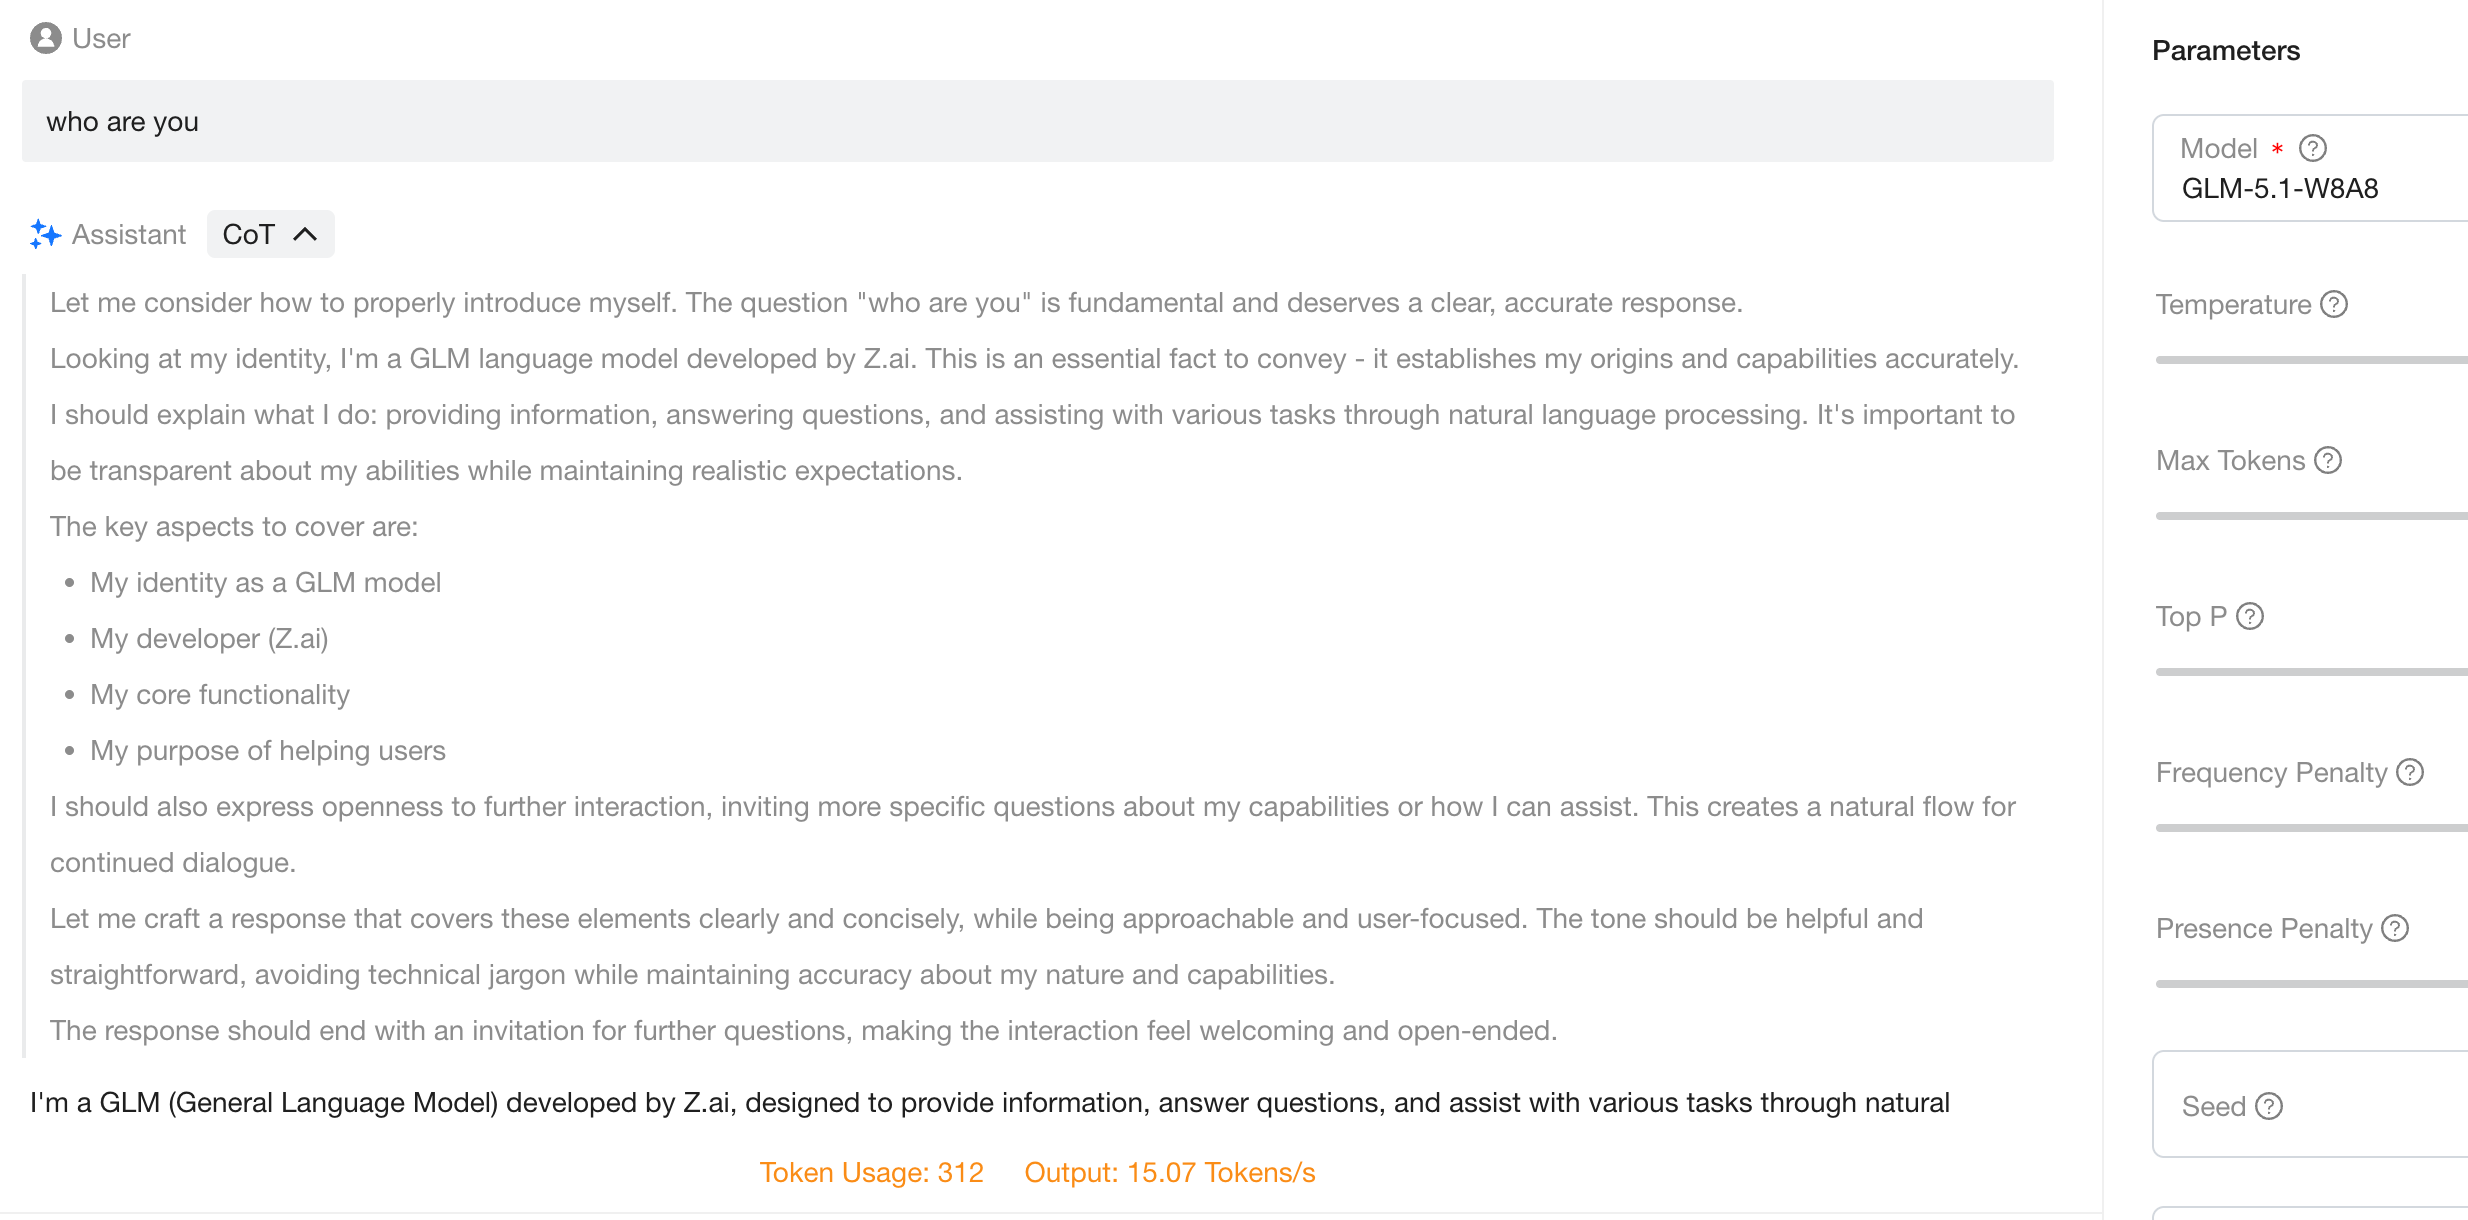
Теперь вы успешно развернули и запустили распределенный вывод на нескольких узлах в кластере GPUStack, используя серверную часть MP vLLM.
Если вам нужна дополнительная помощь, обращайтесь в сообщество GPUStack или в службу поддержки.