Оптимизация задержки Qwen3.5-9B Вывод
Рекомендуемая конфигурация для оптимизации задержки Qwen/Qwen3.5-9B на NVIDIA H100 80GB HBM3:
Команда обслуживания модели vllm serve Qwen/Qwen3.5-9B \
--reasoning-parser= qwen3 \
--max-model-len= 32768 \
--speculative-config={ "method" :"mtp" ,"num_speculative_tokens" :1} \
--language-model-only \
--performance-mode= interactivity
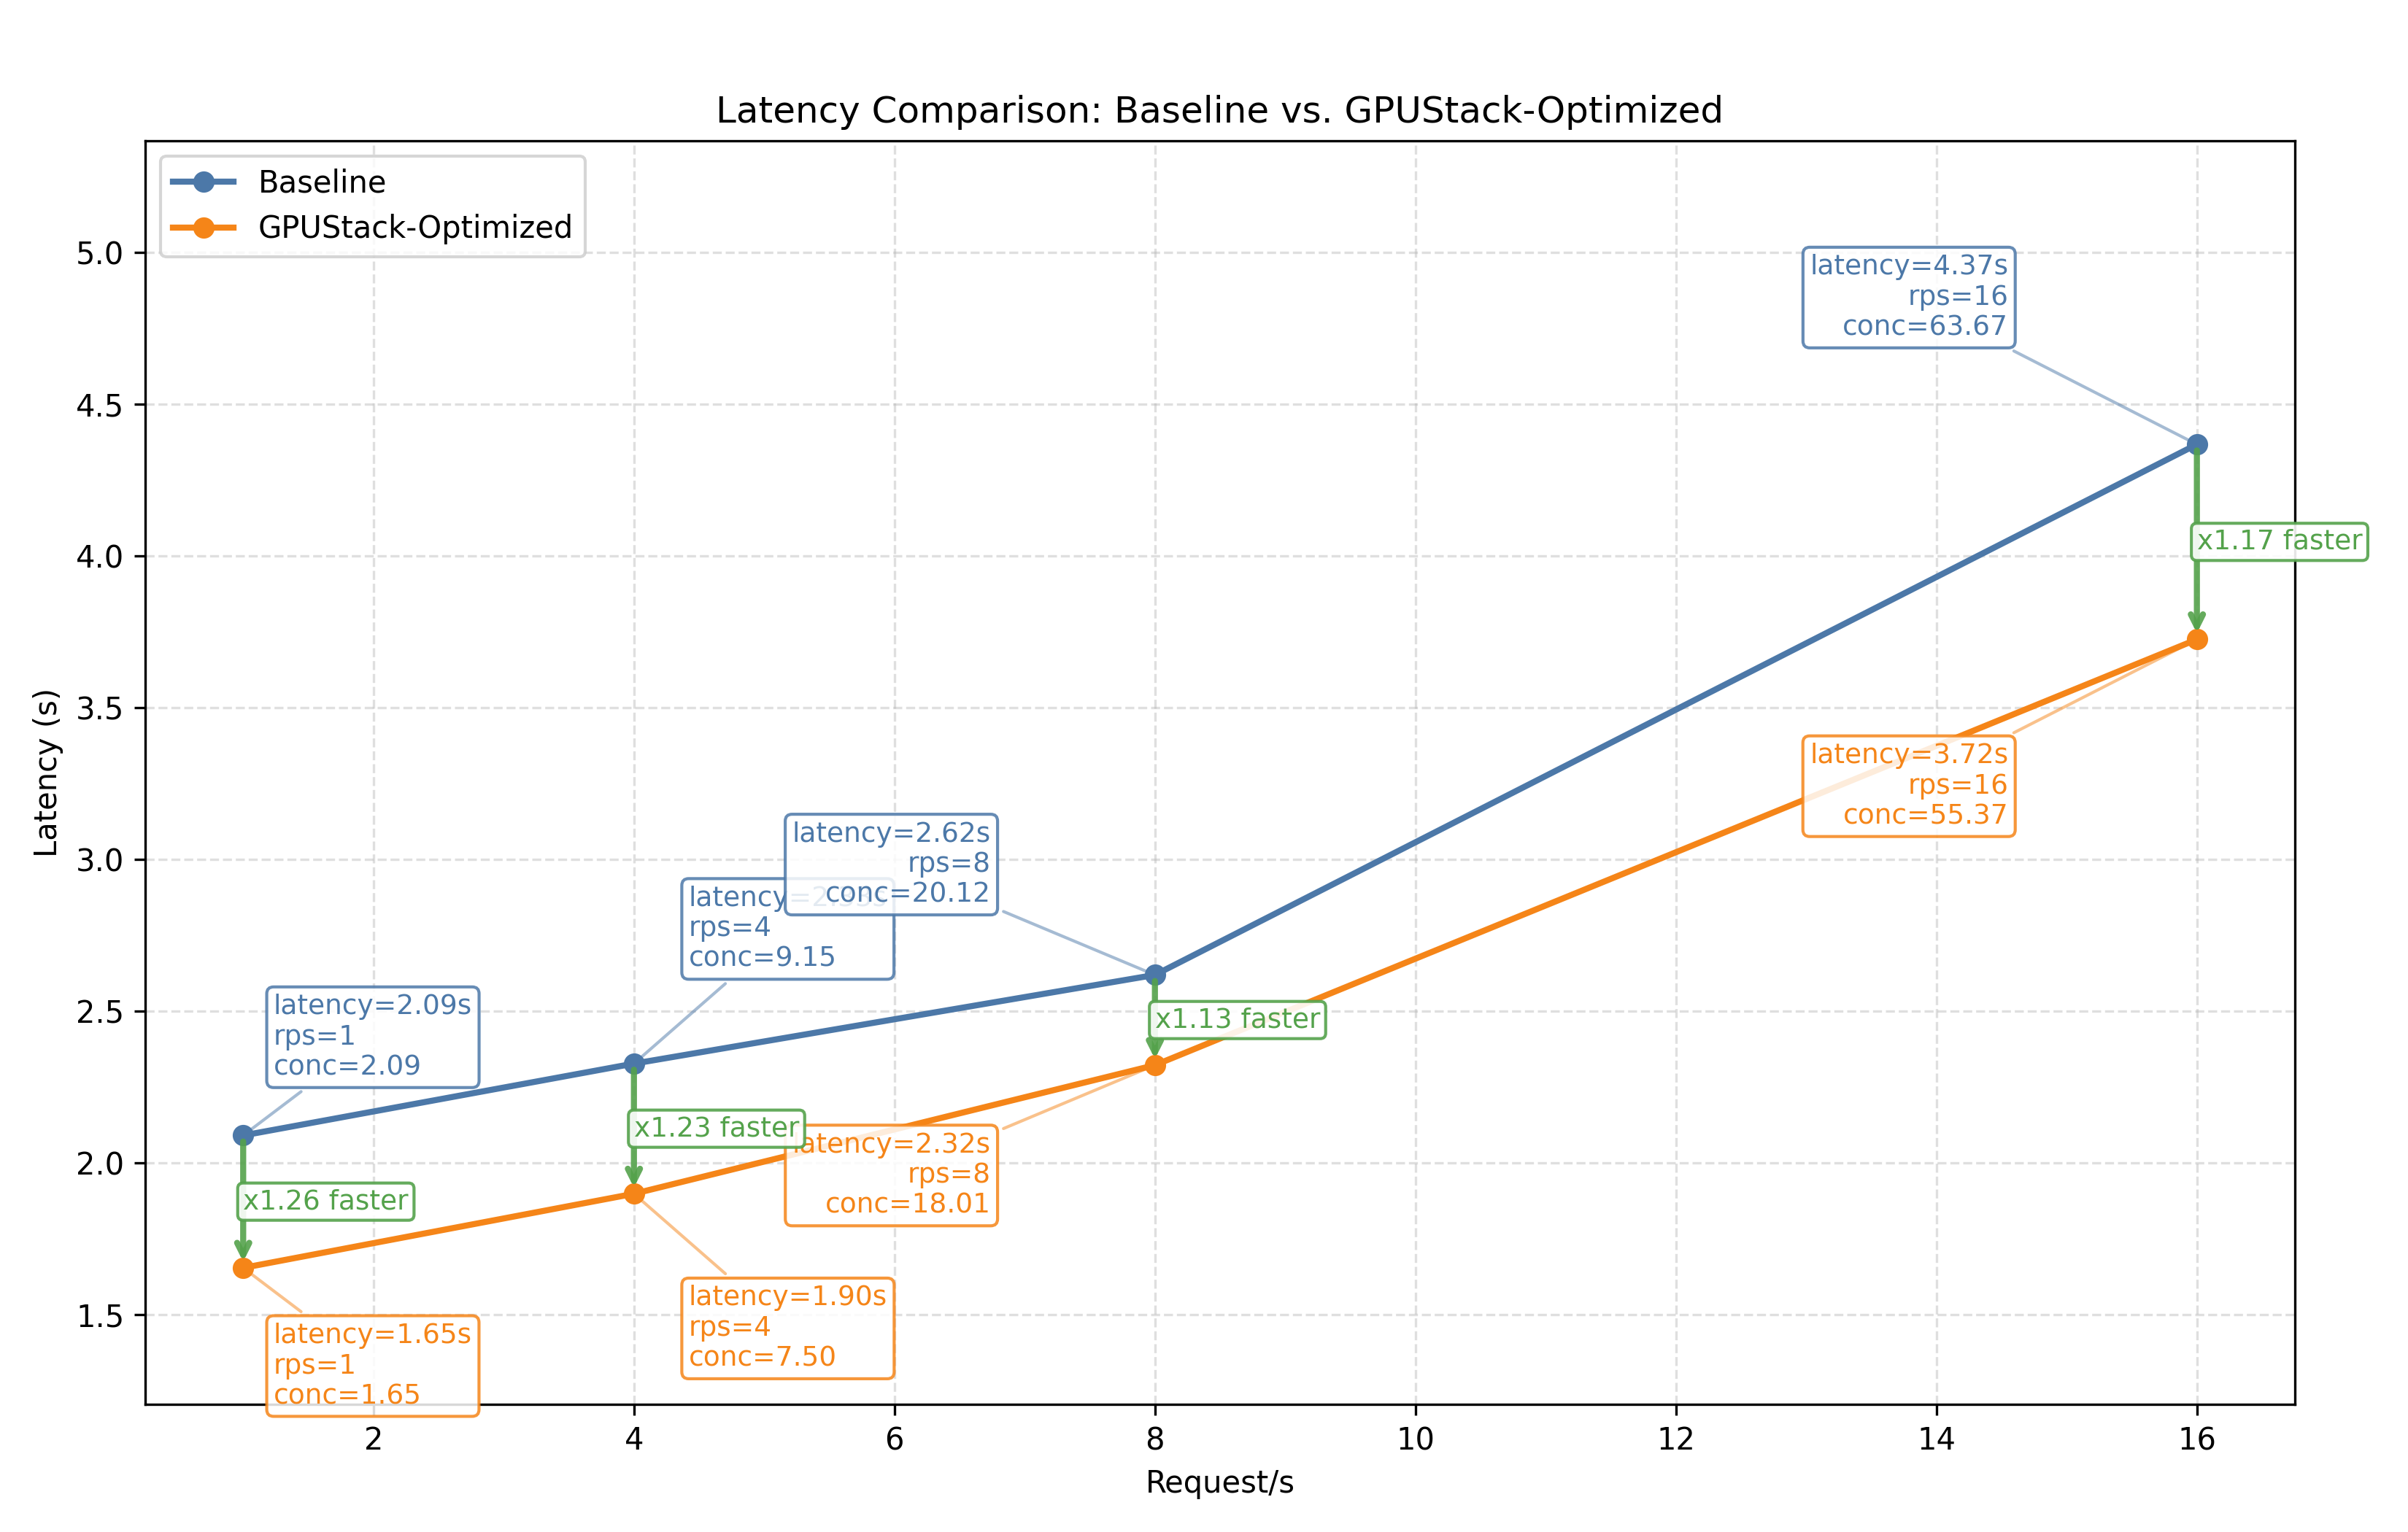
Сравнение результатов бенчмарков до и после оптимизации:
Сценарий бенчмарка Базовая конфигурация (vLLM без оптимизации) После оптимизации Rate 1 Средняя задержка: 2.09s/req Средняя задержка: 1.65s/req (1.26x faster) Rate 4 Средняя задержка: 2.33s/req Средняя задержка: 1.90s/req (1.23x faster) Rate 8 Средняя задержка: 2.62s/req Средняя задержка: 2.32s/req (1.13x faster) Rate 16 Средняя задержка: 4.37s/req Средняя задержка: 3.72s/req (1.17x faster)
Примечание
Наши бенчмарки не охватывают все возможные сочетания оптимизаций. Например, отправной точкой дальнейшей настройки становится движок инференса с лучшей производительностью при настройках по умолчанию. Такое отсечение вариантов даёт локальный оптимум, который может не совпадать с глобальным. Есть и другие методы оптимизации, зависящие от сценария использования: максимальный размер батча, настройки планировщика, расширенный KV-кэш, CUDA graph и т. д. Выводы этого документа могут служить отправной точкой для более целенаправленной оптимизации. Тесты проводились на определённых аппаратных и программных конфигурациях. Развитие движков инференса может привести к новым выводам. Квантизация может влиять на точность, однако для большинства моделей FP8 обеспечивает снижение точности менее чем на 1%. Подробности см. в результатах оценки . Поэтому для обслуживания с низкой задержкой настоятельно рекомендуется квантизация FP8. Спекулятивное декодирование может существенно уменьшить задержку при низкой конкурентности запросов. Однако ускорение зависит от распределения данных в бенчмарке и выбора черновой модели. Например, выбранная здесь черновая модель обучена на английских данных, поэтому для других языков результат может быть хуже оптимального. Если что-то упущено или требуется обновление с учётом новых изменений, сообщите нам .
Условия эксперимента Модель Qwen/Qwen3.5-9B
Оборудование NVIDIA H100 80GB HBM3
Версия движка vLLM v0.17.1 SGLang v0.5.9 Методика бенчмарка В этом проекте используется функция запуска бенчмарка GPUStack одним щелчком для нагрузок обслуживания моделей. Бенчмарки этого документа выполнялись именно таким способом.
Бенчмарки GPUStack реализованы на основе guidellm через проект-обёртку benchmark-runner .
Для перечисленных ниже конфигураций GPUStack выполняет развёртывание модели, отправку заданий бенчмарка и сбор результатов.
Профили бенчмарка ShareGPT 8RPS dataset_name : ShareGPT
request_rate : 8
total_requests : 1000
ShareGPT 1RPS dataset_name : ShareGPT
request_rate : 1
total_requests : 1000
ShareGPT 4RPS dataset_name : ShareGPT
request_rate : 4
total_requests : 1000
ShareGPT 16RPS dataset_name : ShareGPT
request_rate : 16
total_requests : 1000
Замена открытыми инструментами Если вы не используете GPUStack, его процесс запуска бенчмарков можно заменить прямыми командами guidellm benchmark.
Для профилей с dataset_name: ShareGPT:
guidellm benchmark \
--target ${ target } \
--profile constant \
--rate ${ request_rate } \
--max-requests ${ total_requests } \
--processor ${ model_path } \
--data ./ShareGPT_V3_unfiltered_cleaned_split.json
Результаты эксперимента Выбор движка инференса vLLM Профиль: ShareGPT 8RPS Параметры бэкенда: --reasoning-parser= qwen3
--max-model-len= 32768
Результат бенчмарка ============ Serving Benchmark Result ============
Successful requests: 1000
Maximum request concurrency: 31
Benchmark duration (s): 130.18
Total input tokens: 342058
Total generated tokens: 281412
Request throughput (req/s): 7.68
Output token throughput (tok/s): 2197.17
Peak output token throughput (tok/s): 2885041.51
Peak concurrent requests: 31.00
Total Token throughput (tok/s): 4867.84
----------------------Latency---------------------
Mean Latency(s): 2.62
Median Latency(s): 2.29
P95 Latency(s): 6.81
P99 Latency(s): 7.75
---------------Time to First Token----------------
Mean TTFT (ms): 41.12
Median TTFT (ms): 33.92
P95 TTFT (ms): 72.24
P99 TTFT (ms): 141.44
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms): 1.34
Median TPOT (ms): 0.11
P95 TPOT (ms): 9.18
P99 TPOT (ms): 10.07
---------------Inter-token Latency----------------
Mean ITL (ms): 1.19
Median ITL (ms): 0.00
P95 ITL (ms): 9.08
P99 ITL (ms): 10.04
==================================================
SGLang Профиль: ShareGPT 8RPS Параметры бэкенда: --reasoning-parser= qwen3
--context-length= 32768
Результат бенчмарка ============ Serving Benchmark Result ============
Successful requests: 1000
Maximum request concurrency: 96
Benchmark duration (s): 131.60
Total input tokens: 342058
Total generated tokens: 281412
Request throughput (req/s): 7.60
Output token throughput (tok/s): 2145.85
Peak output token throughput (tok/s): 33380.30
Peak concurrent requests: 96.00
Total Token throughput (tok/s): 4754.13
----------------------Latency---------------------
Mean Latency(s): 8.13
Median Latency(s): 6.94
P95 Latency(s): 20.20
P99 Latency(s): 26.21
---------------Time to First Token----------------
Mean TTFT (ms): 98.72
Median TTFT (ms): 51.48
P95 TTFT (ms): 212.72
P99 TTFT (ms): 460.47
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms): 28.88
Median TPOT (ms): 28.26
P95 TPOT (ms): 43.34
P99 TPOT (ms): 51.52
---------------Inter-token Latency----------------
Mean ITL (ms): 28.63
Median ITL (ms): 27.88
P95 ITL (ms): 43.23
P99 ITL (ms): 50.55
==================================================
Итог: vLLM Средняя задержка = 2.62s, SGLang Средняя задержка = 8.13s. vLLM быстрее на 5.51 s (3.10x быстрее). TTFT = 41.12 ms против 98.72 ms, снижение на 57.60 ms (2.40x быстрее); TPOT = 1.34 ms против 28.88 ms, снижение на 27.54 ms (21.62x быстрее). Кэш префиксов Профиль: ShareGPT 8RPS Параметры бэкенда: --reasoning-parser= qwen3
--max-model-len= 32768
--enable-prefix-caching
Результат бенчмарка ============ Serving Benchmark Result ============
Successful requests: 1000
Maximum request concurrency: 32
Benchmark duration (s): 130.23
Total input tokens: 342058
Total generated tokens: 281412
Request throughput (req/s): 7.68
Output token throughput (tok/s): 2212.47
Peak output token throughput (tok/s): 1443445.16
Peak concurrent requests: 32.00
Total Token throughput (tok/s): 4901.75
----------------------Latency---------------------
Mean Latency(s): 2.69
Median Latency(s): 2.36
P95 Latency(s): 6.95
P99 Latency(s): 7.94
---------------Time to First Token----------------
Mean TTFT (ms): 46.19
Median TTFT (ms): 34.75
P95 TTFT (ms): 90.30
P99 TTFT (ms): 233.30
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms): 1.38
Median TPOT (ms): 0.12
P95 TPOT (ms): 9.49
P99 TPOT (ms): 10.50
---------------Inter-token Latency----------------
Mean ITL (ms): 1.22
Median ITL (ms): 0.00
P95 ITL (ms): 9.35
P99 ITL (ms): 10.40
==================================================
Максимум токенов в батче 16k Профиль: ShareGPT 8RPS Параметры бэкенда: --reasoning-parser= qwen3
--max-model-len= 32768
--max-num-batched-tokens= 16384
Результат бенчмарка ============ Serving Benchmark Result ============
Successful requests: 1000
Maximum request concurrency: 31
Benchmark duration (s): 130.20
Total input tokens: 342058
Total generated tokens: 281412
Request throughput (req/s): 7.68
Output token throughput (tok/s): 2220.17
Peak output token throughput (tok/s): 2763536.75
Peak concurrent requests: 31.00
Total Token throughput (tok/s): 4918.81
----------------------Latency---------------------
Mean Latency(s): 2.64
Median Latency(s): 2.30
P95 Latency(s): 6.87
P99 Latency(s): 7.79
---------------Time to First Token----------------
Mean TTFT (ms): 42.05
Median TTFT (ms): 34.13
P95 TTFT (ms): 76.02
P99 TTFT (ms): 190.03
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms): 1.26
Median TPOT (ms): 0.11
P95 TPOT (ms): 9.19
P99 TPOT (ms): 10.11
---------------Inter-token Latency----------------
Mean ITL (ms): 1.11
Median ITL (ms): 0.00
P95 ITL (ms): 9.13
P99 ITL (ms): 10.04
==================================================
32k Профиль: ShareGPT 8RPS Параметры бэкенда: --reasoning-parser= qwen3
--max-model-len= 32768
--max-num-batched-tokens= 32768
Результат бенчмарка ============ Serving Benchmark Result ============
Successful requests: 1000
Maximum request concurrency: 31
Benchmark duration (s): 130.20
Total input tokens: 342058
Total generated tokens: 281412
Request throughput (req/s): 7.68
Output token throughput (tok/s): 2196.67
Peak output token throughput (tok/s): 1167858.46
Peak concurrent requests: 31.00
Total Token throughput (tok/s): 4866.73
----------------------Latency---------------------
Mean Latency(s): 2.64
Median Latency(s): 2.31
P95 Latency(s): 6.88
P99 Latency(s): 7.81
---------------Time to First Token----------------
Mean TTFT (ms): 41.88
Median TTFT (ms): 34.03
P95 TTFT (ms): 76.91
P99 TTFT (ms): 164.85
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms): 1.38
Median TPOT (ms): 0.11
P95 TPOT (ms): 9.34
P99 TPOT (ms): 10.14
---------------Inter-token Latency----------------
Mean ITL (ms): 1.23
Median ITL (ms): 0.00
P95 ITL (ms): 9.20
P99 ITL (ms): 10.09
==================================================
Итог: 16k Средняя задержка = 2.64s, 32k Средняя задержка = 2.64s. 16k быстрее на 0.00 s (1.00x быстрее). TTFT = 42.05 ms против 41.88 ms, увеличение на 0.17 ms (1.00x медленнее); TPOT = 1.26 ms против 1.38 ms, снижение на 0.12 ms (1.10x быстрее). Максимальное число последовательностей Последовательности 128 Профиль: ShareGPT 8RPS Параметры бэкенда: --reasoning-parser= qwen3
--max-model-len= 32768
--max-num-seqs= 128
Результат бенчмарка ============ Serving Benchmark Result ============
Successful requests: 1000
Maximum request concurrency: 31
Benchmark duration (s): 130.18
Total input tokens: 342058
Total generated tokens: 281412
Request throughput (req/s): 7.68
Output token throughput (tok/s): 2213.28
Peak output token throughput (tok/s): 3033763.06
Peak concurrent requests: 31.00
Total Token throughput (tok/s): 4903.53
----------------------Latency---------------------
Mean Latency(s): 2.66
Median Latency(s): 2.32
P95 Latency(s): 6.91
P99 Latency(s): 7.82
---------------Time to First Token----------------
Mean TTFT (ms): 44.11
Median TTFT (ms): 35.02
P95 TTFT (ms): 75.65
P99 TTFT (ms): 197.93
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms): 1.33
Median TPOT (ms): 0.11
P95 TPOT (ms): 9.53
P99 TPOT (ms): 10.28
---------------Inter-token Latency----------------
Mean ITL (ms): 1.17
Median ITL (ms): 0.00
P95 ITL (ms): 9.48
P99 ITL (ms): 10.23
==================================================
Последовательности 256 Профиль: ShareGPT 8RPS Параметры бэкенда: --reasoning-parser= qwen3
--max-model-len= 32768
--max-num-seqs= 256
Результат бенчмарка ============ Serving Benchmark Result ============
Successful requests: 1000
Maximum request concurrency: 31
Benchmark duration (s): 130.18
Total input tokens: 342058
Total generated tokens: 281412
Request throughput (req/s): 7.68
Output token throughput (tok/s): 2196.96
Peak output token throughput (tok/s): 1994998.46
Peak concurrent requests: 31.00
Total Token throughput (tok/s): 4867.37
----------------------Latency---------------------
Mean Latency(s): 2.64
Median Latency(s): 2.30
P95 Latency(s): 6.82
P99 Latency(s): 7.79
---------------Time to First Token----------------
Mean TTFT (ms): 42.97
Median TTFT (ms): 34.30
P95 TTFT (ms): 77.05
P99 TTFT (ms): 187.56
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms): 1.32
Median TPOT (ms): 0.11
P95 TPOT (ms): 9.23
P99 TPOT (ms): 10.28
---------------Inter-token Latency----------------
Mean ITL (ms): 1.17
Median ITL (ms): 0.00
P95 ITL (ms): 9.16
P99 ITL (ms): 10.16
==================================================
Итог: Seqs 256 Средняя задержка = 2.64s, Seqs 128 Средняя задержка = 2.66s. Seqs 256 быстрее на 0.02 s (1.01x быстрее). TTFT = 42.97 ms против 44.11 ms, снижение на 1.13 ms (1.03x быстрее); TPOT = 1.32 ms против 1.33 ms, снижение на 0.01 ms (1.01x быстрее). Спекулятивное декодирование Профиль: ShareGPT 8RPS Параметры бэкенда: --reasoning-parser= qwen3
--speculative-config={ "method" :"mtp" ,"num_speculative_tokens" :1}
--max-model-len= 32768
Результат бенчмарка ============ Serving Benchmark Result ============
Successful requests: 1000
Maximum request concurrency: 28
Benchmark duration (s): 129.03
Total input tokens: 342058
Total generated tokens: 281412
Request throughput (req/s): 7.75
Output token throughput (tok/s): 2224.24
Peak output token throughput (tok/s): 9620127.05
Peak concurrent requests: 28.00
Total Token throughput (tok/s): 4927.83
----------------------Latency---------------------
Mean Latency(s): 2.39
Median Latency(s): 2.08
P95 Latency(s): 6.12
P99 Latency(s): 7.17
---------------Time to First Token----------------
Mean TTFT (ms): 81.50
Median TTFT (ms): 55.93
P95 TTFT (ms): 96.41
P99 TTFT (ms): 788.19
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms): 1.29
Median TPOT (ms): 0.18
P95 TPOT (ms): 8.45
P99 TPOT (ms): 9.48
---------------Inter-token Latency----------------
Mean ITL (ms): 1.01
Median ITL (ms): 0.00
P95 ITL (ms): 8.31
P99 ITL (ms): 9.42
==================================================
Профиль: ShareGPT 8RPS Параметры бэкенда: --reasoning-parser= qwen3
--performance-mode= interactivity
--max-model-len= 32768
--speculative-config={ "method" :"mtp" ,"num_speculative_tokens" :1}
Результат бенчмарка ============ Serving Benchmark Result ============
Successful requests: 1000
Maximum request concurrency: 28
Benchmark duration (s): 129.07
Total input tokens: 342058
Total generated tokens: 281412
Request throughput (req/s): 7.75
Output token throughput (tok/s): 2214.80
Peak output token throughput (tok/s): 1904162.55
Peak concurrent requests: 28.00
Total Token throughput (tok/s): 4906.90
----------------------Latency---------------------
Mean Latency(s): 2.38
Median Latency(s): 2.09
P95 Latency(s): 6.09
P99 Latency(s): 7.20
---------------Time to First Token----------------
Mean TTFT (ms): 82.37
Median TTFT (ms): 55.71
P95 TTFT (ms): 96.16
P99 TTFT (ms): 960.28
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms): 1.42
Median TPOT (ms): 0.18
P95 TPOT (ms): 8.54
P99 TPOT (ms): 9.65
---------------Inter-token Latency----------------
Mean ITL (ms): 1.13
Median ITL (ms): 0.00
P95 ITL (ms): 8.39
P99 ITL (ms): 9.08
==================================================
Профиль: ShareGPT 8RPS Параметры бэкенда: --reasoning-parser= qwen3
--max-model-len= 32768
--speculative-config={ "method" :"mtp" ,"num_speculative_tokens" :1}
--language-model-only
--performance-mode= interactivity
Результат бенчмарка ============ Serving Benchmark Result ============
Successful requests: 1000
Maximum request concurrency: 27
Benchmark duration (s): 128.98
Total input tokens: 342058
Total generated tokens: 281412
Request throughput (req/s): 7.75
Output token throughput (tok/s): 2214.46
Peak output token throughput (tok/s): 4861500.66
Peak concurrent requests: 27.00
Total Token throughput (tok/s): 4906.15
----------------------Latency---------------------
Mean Latency(s): 2.32
Median Latency(s): 2.02
P95 Latency(s): 5.99
P99 Latency(s): 6.89
---------------Time to First Token----------------
Mean TTFT (ms): 80.63
Median TTFT (ms): 54.04
P95 TTFT (ms): 96.82
P99 TTFT (ms): 933.41
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms): 1.31
Median TPOT (ms): 0.17
P95 TPOT (ms): 8.19
P99 TPOT (ms): 9.47
---------------Inter-token Latency----------------
Mean ITL (ms): 1.02
Median ITL (ms): 0.00
P95 ITL (ms): 8.03
P99 ITL (ms): 8.91
==================================================
Сводка методов оптимизации Сценарий бенчмарка Группа После оптимизации Базовая конфигурация Сравнение ShareGPT 8RPS (r=8) Выбор движка инференса 2.62s 2.62s (1.00x faster) ShareGPT 8RPS (r=8) Кэш префиксов 2.69s 2.62s (1.03x slower) ShareGPT 8RPS (r=8) Максимум токенов в батче 2.64s 2.62s (1.01x slower) ShareGPT 8RPS (r=8) Максимальное число последовательностей 2.64s 2.62s (1.01x slower) ShareGPT 8RPS (r=8) Спекулятивное декодирование 2.39s 2.62s (1.09x faster) ShareGPT 8RPS (r=8) Спекулятивное декодирование && Режим производительности 2.38s 2.62s (1.10x faster) ShareGPT 8RPS (r=8) Спекулятивное декодирование && Режим производительности && Языковая модель 2.32s 2.62s (1.13x faster)
Другие сценарии бенчмарка Частота запросов 1 Базовые параметры бэкенда: --reasoning-parser= qwen3
--max-model-len= 32768
Результат базового бенчмарка ============ Serving Benchmark Result ============
Successful requests: 1000
Maximum request concurrency: 6
Benchmark duration (s): 1001.23
Total input tokens: 342058
Total generated tokens: 281412
Request throughput (req/s): 1.00
Output token throughput (tok/s): 281.69
Peak output token throughput (tok/s): 211793.17
Peak concurrent requests: 6.00
Total Token throughput (tok/s): 624.09
----------------------Latency---------------------
Mean Latency(s): 2.09
Median Latency(s): 1.85
P95 Latency(s): 5.42
P99 Latency(s): 6.27
---------------Time to First Token----------------
Mean TTFT (ms): 37.03
Median TTFT (ms): 31.51
P95 TTFT (ms): 63.17
P99 TTFT (ms): 95.35
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms): 0.94
Median TPOT (ms): 0.10
P95 TPOT (ms): 7.38
P99 TPOT (ms): 7.51
---------------Inter-token Latency----------------
Mean ITL (ms): 0.81
Median ITL (ms): 0.00
P95 ITL (ms): 7.34
P99 ITL (ms): 7.47
==================================================
Параметры бэкенда после оптимизации: --reasoning-parser= qwen3
--max-model-len= 32768
--speculative-config={ "method" :"mtp" ,"num_speculative_tokens" :1}
--language-model-only
--performance-mode= interactivity
Результат бенчмарка после оптимизации ============ Serving Benchmark Result ============
Successful requests: 1000
Maximum request concurrency: 5
Benchmark duration (s): 1000.35
Total input tokens: 342058
Total generated tokens: 281412
Request throughput (req/s): 1.00
Output token throughput (tok/s): 281.69
Peak output token throughput (tok/s): 271386.26
Peak concurrent requests: 5.00
Total Token throughput (tok/s): 624.08
----------------------Latency---------------------
Mean Latency(s): 1.65
Median Latency(s): 1.45
P95 Latency(s): 4.28
P99 Latency(s): 4.98
---------------Time to First Token----------------
Mean TTFT (ms): 54.58
Median TTFT (ms): 50.45
P95 TTFT (ms): 75.37
P99 TTFT (ms): 123.14
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms): 0.91
Median TPOT (ms): 0.15
P95 TPOT (ms): 5.90
P99 TPOT (ms): 6.22
---------------Inter-token Latency----------------
Mean ITL (ms): 0.72
Median ITL (ms): 0.00
P95 ITL (ms): 5.75
P99 ITL (ms): 6.14
==================================================
Частота запросов 4 Базовые параметры бэкенда: --reasoning-parser= qwen3
--max-model-len= 32768
Результат базового бенчмарка ============ Serving Benchmark Result ============
Successful requests: 1000
Maximum request concurrency: 15
Benchmark duration (s): 254.36
Total input tokens: 342058
Total generated tokens: 281412
Request throughput (req/s): 3.93
Output token throughput (tok/s): 1126.78
Peak output token throughput (tok/s): 800262.91
Peak concurrent requests: 15.00
Total Token throughput (tok/s): 2496.39
----------------------Latency---------------------
Mean Latency(s): 2.33
Median Latency(s): 2.06
P95 Latency(s): 5.96
P99 Latency(s): 6.94
---------------Time to First Token----------------
Mean TTFT (ms): 38.09
Median TTFT (ms): 31.67
P95 TTFT (ms): 67.05
P99 TTFT (ms): 109.44
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms): 1.15
Median TPOT (ms): 0.10
P95 TPOT (ms): 8.25
P99 TPOT (ms): 8.73
---------------Inter-token Latency----------------
Mean ITL (ms): 1.02
Median ITL (ms): 0.00
P95 ITL (ms): 8.19
P99 ITL (ms): 8.67
==================================================
Параметры бэкенда после оптимизации: --reasoning-parser= qwen3
--max-model-len= 32768
--speculative-config={ "method" :"mtp" ,"num_speculative_tokens" :1}
--language-model-only
--performance-mode= interactivity
Результат бенчмарка после оптимизации ============ Serving Benchmark Result ============
Successful requests: 1000
Maximum request concurrency: 13
Benchmark duration (s): 253.27
Total input tokens: 342058
Total generated tokens: 281412
Request throughput (req/s): 3.95
Output token throughput (tok/s): 1126.67
Peak output token throughput (tok/s): 996666.30
Peak concurrent requests: 13.00
Total Token throughput (tok/s): 2496.15
----------------------Latency---------------------
Mean Latency(s): 1.90
Median Latency(s): 1.66
P95 Latency(s): 4.91
P99 Latency(s): 5.82
---------------Time to First Token----------------
Mean TTFT (ms): 57.94
Median TTFT (ms): 52.57
P95 TTFT (ms): 77.15
P99 TTFT (ms): 112.48
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms): 0.97
Median TPOT (ms): 0.16
P95 TPOT (ms): 6.79
P99 TPOT (ms): 7.25
---------------Inter-token Latency----------------
Mean ITL (ms): 0.76
Median ITL (ms): 0.00
P95 ITL (ms): 6.64
P99 ITL (ms): 7.11
==================================================
Частота запросов 8 Базовые параметры бэкенда: --reasoning-parser= qwen3
--max-model-len= 32768
Результат базового бенчмарка ============ Serving Benchmark Result ============
Successful requests: 1000
Maximum request concurrency: 31
Benchmark duration (s): 130.18
Total input tokens: 342058
Total generated tokens: 281412
Request throughput (req/s): 7.68
Output token throughput (tok/s): 2197.17
Peak output token throughput (tok/s): 2885041.51
Peak concurrent requests: 31.00
Total Token throughput (tok/s): 4867.84
----------------------Latency---------------------
Mean Latency(s): 2.62
Median Latency(s): 2.29
P95 Latency(s): 6.81
P99 Latency(s): 7.75
---------------Time to First Token----------------
Mean TTFT (ms): 41.12
Median TTFT (ms): 33.92
P95 TTFT (ms): 72.24
P99 TTFT (ms): 141.44
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms): 1.34
Median TPOT (ms): 0.11
P95 TPOT (ms): 9.18
P99 TPOT (ms): 10.07
---------------Inter-token Latency----------------
Mean ITL (ms): 1.19
Median ITL (ms): 0.00
P95 ITL (ms): 9.08
P99 ITL (ms): 10.04
==================================================
Параметры бэкенда после оптимизации: --reasoning-parser= qwen3
--max-model-len= 32768
--speculative-config={ "method" :"mtp" ,"num_speculative_tokens" :1}
--language-model-only
--performance-mode= interactivity
Результат бенчмарка после оптимизации ============ Serving Benchmark Result ============
Successful requests: 1000
Maximum request concurrency: 27
Benchmark duration (s): 128.98
Total input tokens: 342058
Total generated tokens: 281412
Request throughput (req/s): 7.75
Output token throughput (tok/s): 2214.46
Peak output token throughput (tok/s): 4861500.66
Peak concurrent requests: 27.00
Total Token throughput (tok/s): 4906.15
----------------------Latency---------------------
Mean Latency(s): 2.32
Median Latency(s): 2.02
P95 Latency(s): 5.99
P99 Latency(s): 6.89
---------------Time to First Token----------------
Mean TTFT (ms): 80.63
Median TTFT (ms): 54.04
P95 TTFT (ms): 96.82
P99 TTFT (ms): 933.41
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms): 1.31
Median TPOT (ms): 0.17
P95 TPOT (ms): 8.19
P99 TPOT (ms): 9.47
---------------Inter-token Latency----------------
Mean ITL (ms): 1.02
Median ITL (ms): 0.00
P95 ITL (ms): 8.03
P99 ITL (ms): 8.91
==================================================
Частота запросов 16 Базовые параметры бэкенда: --reasoning-parser= qwen3
--max-model-len= 32768
Результат базового бенчмарка ============ Serving Benchmark Result ============
Successful requests: 1000
Maximum request concurrency: 97
Benchmark duration (s): 68.59
Total input tokens: 342058
Total generated tokens: 281412
Request throughput (req/s): 14.58
Output token throughput (tok/s): 4119.85
Peak output token throughput (tok/s): 4297231.71
Peak concurrent requests: 97.00
Total Token throughput (tok/s): 9127.56
----------------------Latency---------------------
Mean Latency(s): 4.37
Median Latency(s): 3.74
P95 Latency(s): 10.93
P99 Latency(s): 14.05
---------------Time to First Token----------------
Mean TTFT (ms): 63.36
Median TTFT (ms): 52.12
P95 TTFT (ms): 111.22
P99 TTFT (ms): 283.00
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms): 2.07
Median TPOT (ms): 0.17
P95 TPOT (ms): 16.46
P99 TPOT (ms): 18.09
---------------Inter-token Latency----------------
Mean ITL (ms): 1.85
Median ITL (ms): 0.00
P95 ITL (ms): 16.34
P99 ITL (ms): 17.94
==================================================
Параметры бэкенда после оптимизации: --reasoning-parser= qwen3
--max-model-len= 32768
--speculative-config={ "method" :"mtp" ,"num_speculative_tokens" :1}
--language-model-only
--performance-mode= interactivity
Результат бенчмарка после оптимизации ============ Serving Benchmark Result ============
Successful requests: 1000
Maximum request concurrency: 77
Benchmark duration (s): 67.27
Total input tokens: 342058
Total generated tokens: 281412
Request throughput (req/s): 14.86
Output token throughput (tok/s): 4191.07
Peak output token throughput (tok/s): 3207595.57
Peak concurrent requests: 77.00
Total Token throughput (tok/s): 9285.35
----------------------Latency---------------------
Mean Latency(s): 3.72
Median Latency(s): 3.31
P95 Latency(s): 9.44
P99 Latency(s): 11.45
---------------Time to First Token----------------
Mean TTFT (ms): 81.88
Median TTFT (ms): 66.01
P95 TTFT (ms): 149.68
P99 TTFT (ms): 375.11
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms): 1.92
Median TPOT (ms): 0.22
P95 TPOT (ms): 13.69
P99 TPOT (ms): 15.01
---------------Inter-token Latency----------------
Mean ITL (ms): 1.63
Median ITL (ms): 0.00
P95 ITL (ms): 13.50
P99 ITL (ms): 14.78
==================================================