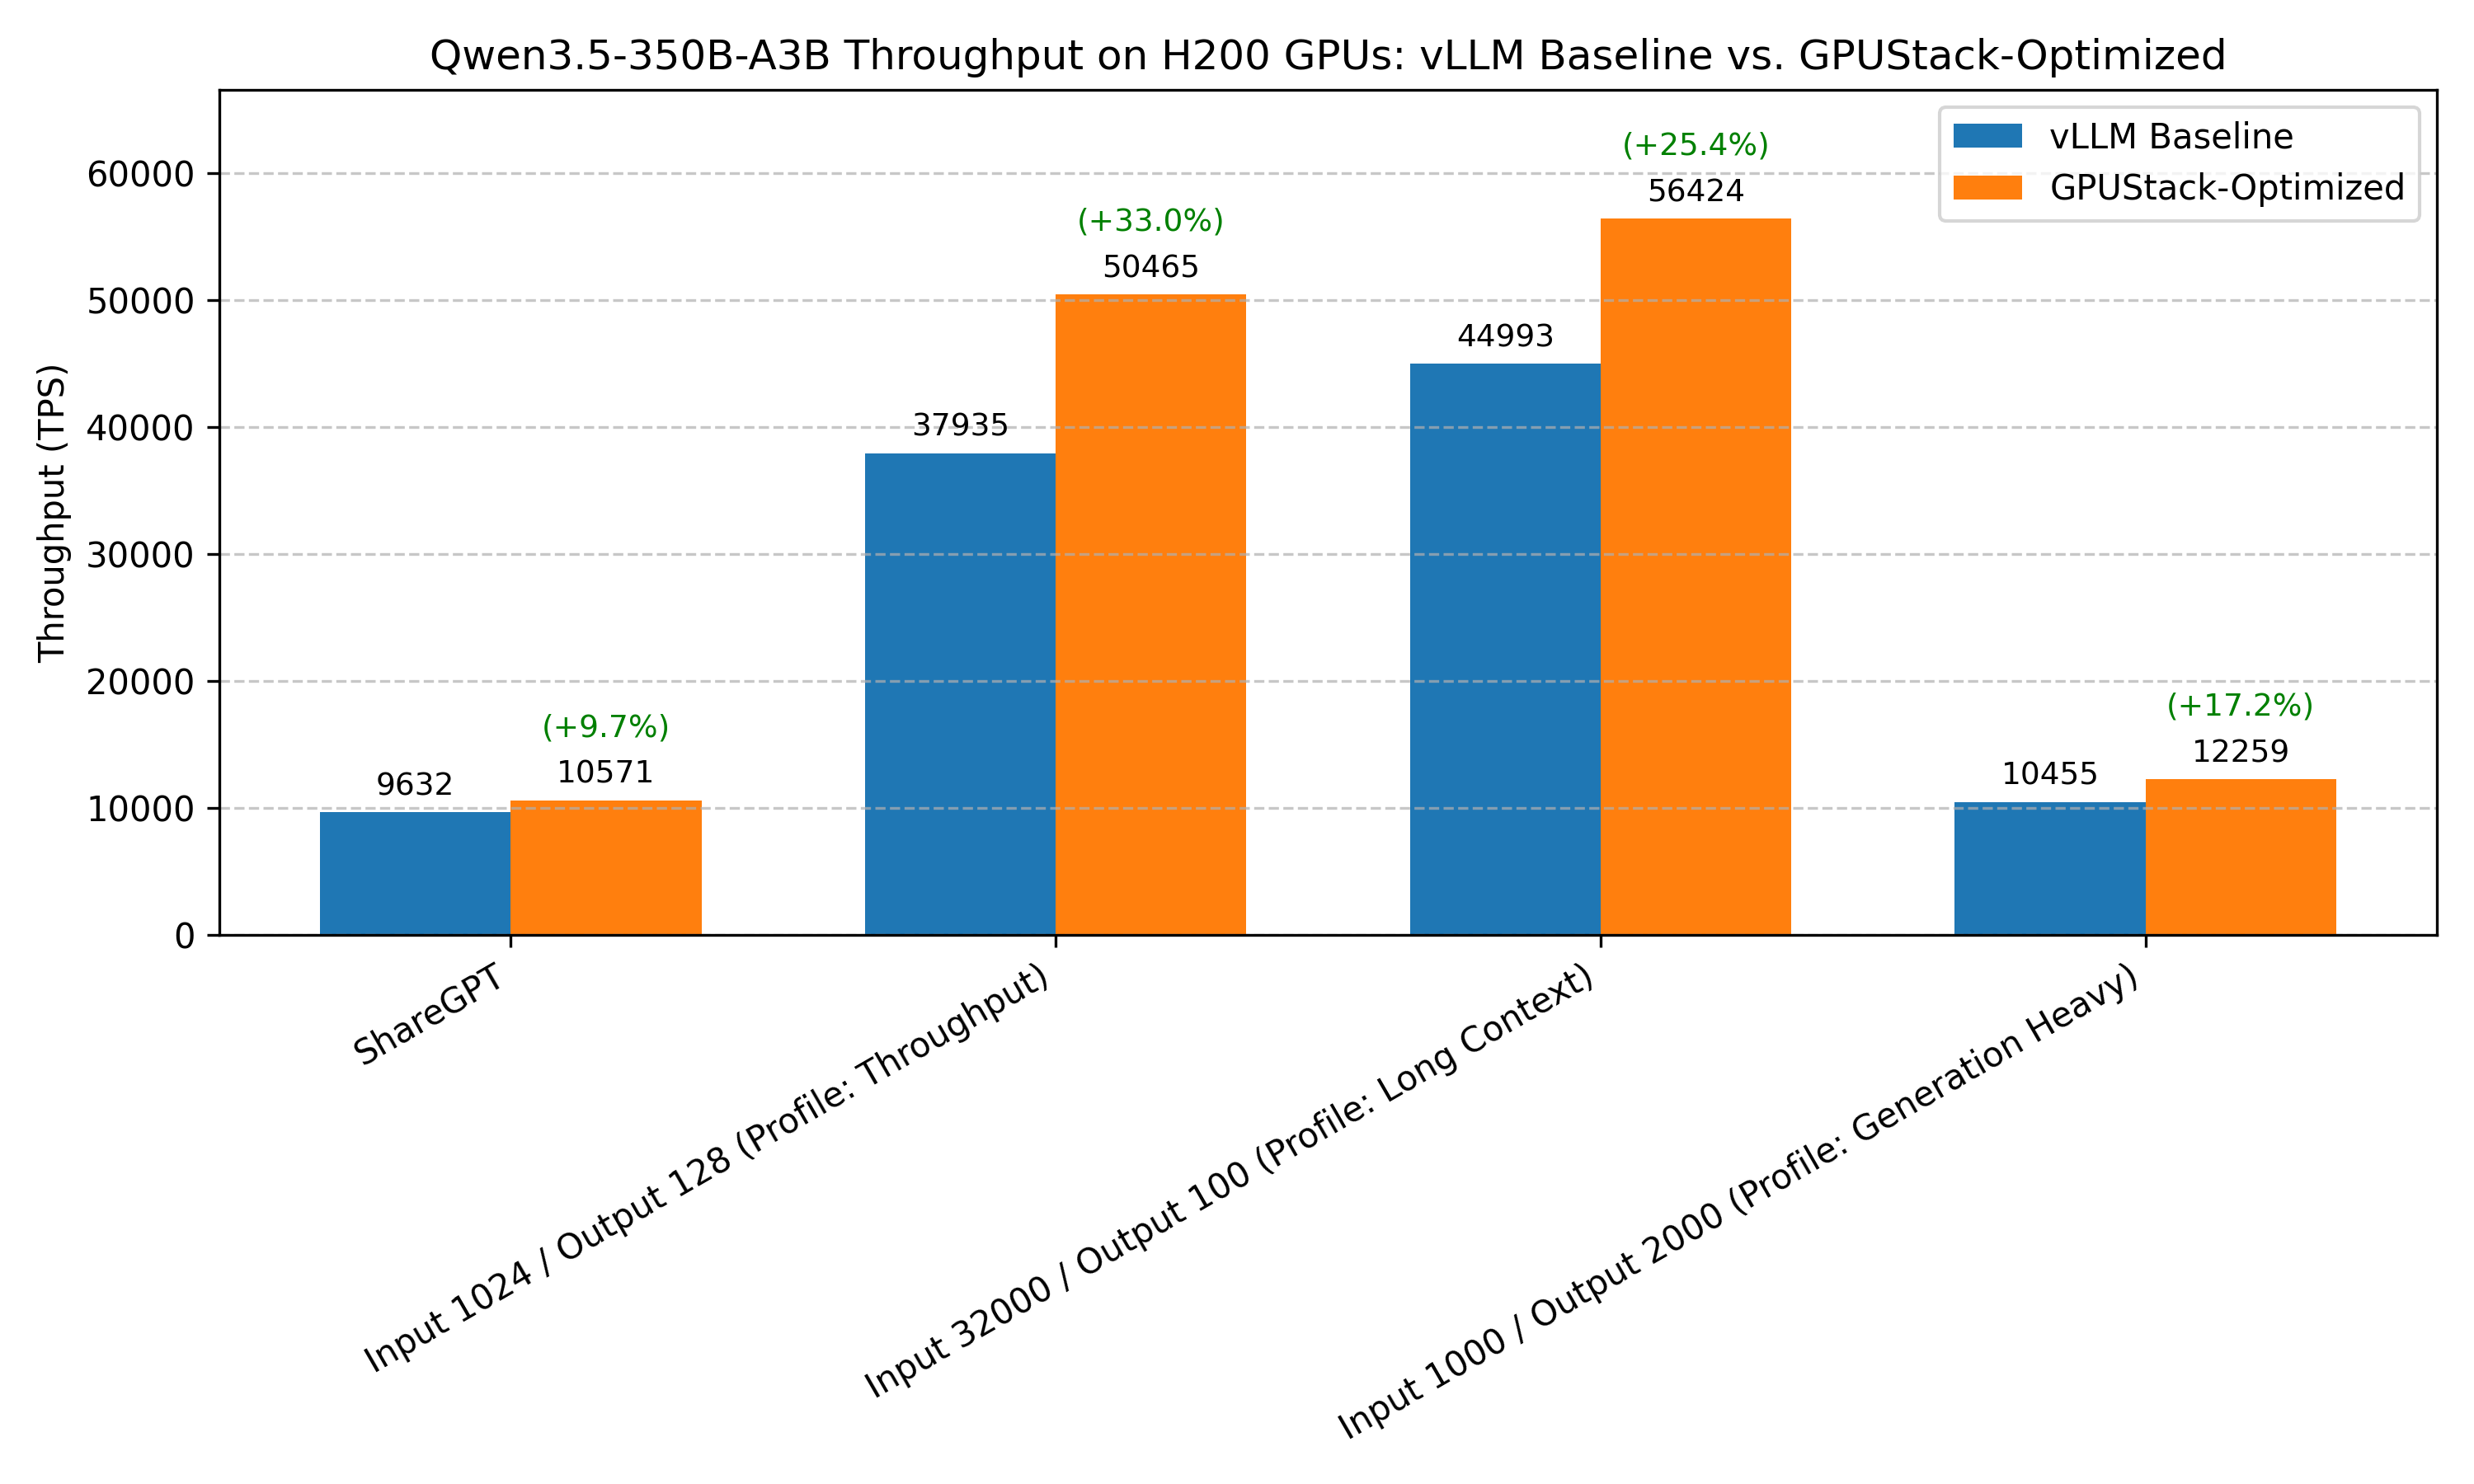
Оптимизация пропускной способности Qwen3.5-35B-A3B Вывод
Рекомендуемая конфигурация для оптимизации пропускной способности Qwen3.5-35B-A3B на NVIDIA H200:
Команда обслуживания модели vllm serve Qwen/Qwen3.5-35B-A3B-FP8 \
--reasoning-parser= qwen3 \
--performance-mode= throughput \
--max-model-len= 32768 \
--enable-prefix-caching
Сравнение результатов бенчмарков до и после оптимизации:
Сценарий бенчмарка базовая конфигурация (vLLM без оптимизации) После оптимизации Профиль ShareGPT Общий TPS: 9632.01 Среднее TPOT(ms): 25.89 Общий TPS: 10570.88 (+9.75%) Среднее TPOT(ms): 24.71 Профиль высокой пропускной способности Общий TPS: 37934.72 Среднее TPOT(ms): 45.39 Общий TPS: 50464.84 (+33.03%) Среднее TPOT(ms): 41.12 Профиль длинного контекста Общий TPS: 44993.20 Среднее TPOT(ms): 319.79 Общий TPS: 56424.42 (+25.41%) Среднее TPOT(ms): 227.43 Профиль интенсивной генерации Общий TPS: 10455.38 Среднее TPOT(ms): 2.48 Общий TPS: 12258.79 (+17.25%) Среднее TPOT(ms): 2.92
Примечание
Наши бенчмарки не охватывают все возможные сочетания оптимизаций. Например, отправной точкой дальнейшей настройки становится движок инференса с лучшей производительностью при настройках по умолчанию. Такое отсечение вариантов даёт локальный оптимум, который может не совпадать с глобальным. Есть и другие методы оптимизации, зависящие от сценария использования: максимальный размер батча, настройки планировщика, расширенный KV-кэш, CUDA graph и т. д. Выводы этого документа могут служить отправной точкой для более целенаправленной оптимизации. Тесты проводились на определённых аппаратных и программных конфигурациях. Развитие движков инференса может привести к новым выводам. Квантизация может влиять на точность, однако для большинства моделей FP8 обеспечивает снижение точности менее чем на 1%. Подробности см. в результатах оценки . Поэтому для обслуживания с низкой задержкой настоятельно рекомендуется квантизация FP8. Спекулятивное декодирование может существенно уменьшить задержку при низкой конкурентности запросов. Однако ускорение зависит от распределения данных в бенчмарке и выбора черновой модели. Например, выбранная здесь черновая модель обучена на английских данных, поэтому для других языков результат может быть хуже оптимального. Если что-то упущено или требуется обновление с учётом новых изменений, сообщите нам .
Условия эксперимента Модель Оборудование NVIDIA H200
Версия движка vLLM v0.17.1 SGLang v0.5.9 Методика бенчмарка В этом проекте используется функция запуска бенчмарка GPUStack одним щелчком для нагрузок обслуживания моделей. Бенчмарки этого документа выполнялись именно таким способом.
Бенчмарки GPUStack реализованы на основе guidellm через проект-обёртку benchmark-runner .
Для перечисленных ниже конфигураций GPUStack выполняет развёртывание модели, отправку заданий бенчмарка и сбор результатов.
Профили бенчмарка ShareGPT dataset_name : ShareGPT
request_rate : 1000
total_requests : 1000
Пропускная способность dataset_name : Random
dataset_input_tokens : 1024
dataset_output_tokens : 128
dataset_seed : 42
request_rate : 1000
total_requests : 1000
Длинный контекст dataset_name : Random
dataset_input_tokens : 32000
dataset_output_tokens : 100
dataset_seed : 42
request_rate : 1000
total_requests : 100
Интенсивная генерация dataset_name : Random
dataset_input_tokens : 1000
dataset_output_tokens : 2000
dataset_seed : 42
request_rate : 1000
total_requests : 200
Замена открытыми инструментами Если вы не используете GPUStack, его процесс запуска бенчмарков можно заменить прямыми командами guidellm benchmark.
Для профилей с dataset_name: ShareGPT:
guidellm benchmark \
--target ${ target } \
--profile constant \
--rate ${ request_rate } \
--max-requests ${ total_requests } \
--processor ${ model_path } \
--data ./ShareGPT_V3_unfiltered_cleaned_split.json
Для профилей с dataset_name: Random:
guidellm benchmark \
--target ${ target } \
--profile constant \
--rate ${ request_rate } \
--max-requests ${ total_requests } \
--processor ${ model_path } \
--data "prompt_tokens= ${ dataset_input_tokens } ,output_tokens= ${ dataset_output_tokens } " \
--random-seed ${ dataset_seed :- 42 }
Результаты эксперимента Базовая конфигурация движка инференса vLLM Профиль: ShareGPT Параметры бэкенда: --reasoning-parser= qwen3
--max-model-len= 32768
Результат бенчмарка ============ Serving Benchmark Result ============
Successful requests: 1000
Maximum request concurrency: 512
Benchmark duration (s): 70.72
Total input tokens: 342058
Total generated tokens: 281412
Request throughput (req/s): 14.14
Output token throughput (tok/s): 4347.55
Peak output token throughput (tok/s): 30810010.86
Peak concurrent requests: 512.00
Total Token throughput (tok/s): 9632.01
----------------------Latency---------------------
Mean Latency(s): 30.19
Median Latency(s): 27.48
P95 Latency(s): 60.73
P99 Latency(s): 65.37
---------------Time to First Token----------------
Mean TTFT (ms): 4072.64
Median TTFT (ms): 5786.23
P95 TTFT (ms): 9276.23
P99 TTFT (ms): 10204.44
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms): 25.89
Median TPOT (ms): 11.63
P95 TPOT (ms): 119.58
P99 TPOT (ms): 161.45
---------------Inter-token Latency----------------
Mean ITL (ms): 11.46
Median ITL (ms): 0.00
P95 ITL (ms): 101.72
P99 ITL (ms): 132.49
==================================================
SGLang Профиль: ShareGPT Параметры бэкенда: --reasoning-parser= qwen3
--context-length= 32768
Результат бенчмарка ============ Serving Benchmark Result ============
Successful requests: 1000
Maximum request concurrency: 512
Benchmark duration (s): 124.99
Total input tokens: 342058
Total generated tokens: 281412
Request throughput (req/s): 8.00
Output token throughput (tok/s): 2254.86
Peak output token throughput (tok/s): 125470.63
Peak concurrent requests: 512.00
Total Token throughput (tok/s): 4995.66
----------------------Latency---------------------
Mean Latency(s): 50.86
Median Latency(s): 53.56
P95 Latency(s): 82.38
P99 Latency(s): 95.75
---------------Time to First Token----------------
Mean TTFT (ms): 34359.37
Median TTFT (ms): 44424.39
P95 TTFT (ms): 50796.35
P99 TTFT (ms): 53280.79
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms): 180.73
Median TPOT (ms): 145.27
P95 TPOT (ms): 376.50
P99 TPOT (ms): 743.84
---------------Inter-token Latency----------------
Mean ITL (ms): 58.84
Median ITL (ms): 63.82
P95 ITL (ms): 70.78
P99 ITL (ms): 73.69
==================================================
Итог: vLLM Общий TPS = 9632.01, SGLang Общий TPS = 4995.66. vLLM быстрее на 4,636.35 tok/s (92.8%); Среднее TPOT = 25.89 ms против 180.73 ms, снижение на 154.84 ms (85.67%). Quantization Профиль: ShareGPT Параметры бэкенда: --reasoning-parser= qwen3
--max-model-len= 32768
Результат бенчмарка ============ Serving Benchmark Result ============
Successful requests: 1000
Maximum request concurrency: 512
Benchmark duration (s): 65.09
Total input tokens: 342058
Total generated tokens: 281412
Request throughput (req/s): 15.36
Output token throughput (tok/s): 4487.88
Peak output token throughput (tok/s): 22765417.84
Peak concurrent requests: 512.00
Total Token throughput (tok/s): 9942.93
----------------------Latency---------------------
Mean Latency(s): 28.47
Median Latency(s): 25.85
P95 Latency(s): 57.18
P99 Latency(s): 60.94
---------------Time to First Token----------------
Mean TTFT (ms): 4477.45
Median TTFT (ms): 6644.58
P95 TTFT (ms): 10070.32
P99 TTFT (ms): 10452.25
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms): 24.85
Median TPOT (ms): 12.27
P95 TPOT (ms): 105.60
P99 TPOT (ms): 155.56
---------------Inter-token Latency----------------
Mean ITL (ms): 8.97
Median ITL (ms): 0.00
P95 ITL (ms): 82.98
P99 ITL (ms): 122.57
==================================================
Кэш префиксов и Quantization Профиль: ShareGPT Параметры бэкенда: --reasoning-parser= qwen3
--enable-prefix-caching
--max-model-len= 32768
Результат бенчмарка ============ Serving Benchmark Result ============
Successful requests: 1000
Maximum request concurrency: 512
Benchmark duration (s): 66.14
Total input tokens: 342058
Total generated tokens: 281412
Request throughput (req/s): 15.12
Output token throughput (tok/s): 4666.64
Peak output token throughput (tok/s): 33515595.85
Peak concurrent requests: 512.00
Total Token throughput (tok/s): 10338.96
----------------------Latency---------------------
Mean Latency(s): 28.95
Median Latency(s): 26.27
P95 Latency(s): 58.15
P99 Latency(s): 61.94
---------------Time to First Token----------------
Mean TTFT (ms): 4274.88
Median TTFT (ms): 6301.11
P95 TTFT (ms): 9633.89
P99 TTFT (ms): 10096.50
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms): 24.69
Median TPOT (ms): 11.84
P95 TPOT (ms): 107.47
P99 TPOT (ms): 157.98
---------------Inter-token Latency----------------
Mean ITL (ms): 9.53
Median ITL (ms): 0.00
P95 ITL (ms): 85.45
P99 ITL (ms): 126.18
==================================================
Профиль: ShareGPT Параметры бэкенда: --reasoning-parser= qwen3
--performance-mode= throughput
--max-model-len= 32768
--enable-prefix-caching
Результат бенчмарка ============ Serving Benchmark Result ============
Successful requests: 1000
Maximum request concurrency: 512
Benchmark duration (s): 65.25
Total input tokens: 342058
Total generated tokens: 281412
Request throughput (req/s): 15.33
Output token throughput (tok/s): 4771.31
Peak output token throughput (tok/s): 41235027.15
Peak concurrent requests: 512.00
Total Token throughput (tok/s): 10570.88
----------------------Latency---------------------
Mean Latency(s): 28.45
Median Latency(s): 25.64
P95 Latency(s): 57.14
P99 Latency(s): 60.99
---------------Time to First Token----------------
Mean TTFT (ms): 4123.08
Median TTFT (ms): 6272.83
P95 TTFT (ms): 8823.87
P99 TTFT (ms): 9032.36
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms): 24.71
Median TPOT (ms): 11.49
P95 TPOT (ms): 108.44
P99 TPOT (ms): 153.41
---------------Inter-token Latency----------------
Mean ITL (ms): 10.10
Median ITL (ms): 0.00
P95 ITL (ms): 84.74
P99 ITL (ms): 124.30
==================================================
Профиль: ShareGPT Параметры бэкенда: --reasoning-parser= qwen3
--performance-mode= throughput
--max-model-len= 32768
--enable-prefix-caching
--kv-cache-dtype= fp8
Результат бенчмарка ============ Serving Benchmark Result ============
Successful requests: 1000
Maximum request concurrency: 512
Benchmark duration (s): 66.34
Total input tokens: 342058
Total generated tokens: 281412
Request throughput (req/s): 15.07
Output token throughput (tok/s): 4677.83
Peak output token throughput (tok/s): 34141109.18
Peak concurrent requests: 512.00
Total Token throughput (tok/s): 10363.77
----------------------Latency---------------------
Mean Latency(s): 28.91
Median Latency(s): 26.27
P95 Latency(s): 58.08
P99 Latency(s): 62.05
---------------Time to First Token----------------
Mean TTFT (ms): 4166.57
Median TTFT (ms): 6373.29
P95 TTFT (ms): 8930.75
P99 TTFT (ms): 9126.76
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms): 24.91
Median TPOT (ms): 11.41
P95 TPOT (ms): 111.86
P99 TPOT (ms): 156.62
---------------Inter-token Latency----------------
Mean ITL (ms): 10.14
Median ITL (ms): 0.00
P95 ITL (ms): 89.13
P99 ITL (ms): 125.58
==================================================
Спекулятивное декодирование и Quantization Профиль: ShareGPT Параметры бэкенда: --reasoning-parser= qwen3
--speculative-config={ "method" :"mtp" ,"num_speculative_tokens" :4}
--max-model-len= 32768
Результат бенчмарка ============ Serving Benchmark Result ============
Successful requests: 516
Maximum request concurrency: 512
Benchmark duration (s): 17.44
Total input tokens: 54307
Total generated tokens: 112466
Request throughput (req/s): 29.59
Output token throughput (tok/s): 10462.21
Peak output token throughput (tok/s): 19149104.07
Peak concurrent requests: 512.00
Total Token throughput (tok/s): 15514.15
----------------------Latency---------------------
Mean Latency(s): 16.92
Median Latency(s): 17.05
P95 Latency(s): 17.28
P99 Latency(s): 17.30
---------------Time to First Token----------------
Mean TTFT (ms): 1956.19
Median TTFT (ms): 0.00
P95 TTFT (ms): 7744.57
P99 TTFT (ms): 8032.17
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms): 66.41
Median TPOT (ms): 44.74
P95 TPOT (ms): 149.10
P99 TPOT (ms): 477.78
---------------Inter-token Latency----------------
Mean ITL (ms): 0.00
Median ITL (ms): 0.00
P95 ITL (ms): 0.00
P99 ITL (ms): 0.00
==================================================
Сводка методов оптимизации Сценарии бенчмарка После оптимизации Базовая конфигурация Quantization Общий TPS: 9942.93 (+3.23%) Среднее TPOT(ms): 24.85 Общий TPS: 9632.01 Среднее TPOT(ms): 25.89 Кэш префиксов && Quantization Общий TPS: 10338.96 (+7.34%) Среднее TPOT(ms): 24.69 Общий TPS: 9632.01 Среднее TPOT(ms): 25.89 Режим производительности && Кэш префиксов && Quantization Общий TPS: 10570.88 (+9.75%) Среднее TPOT(ms): 24.71 Общий TPS: 9632.01 Среднее TPOT(ms): 25.89 Тип данных KV-кэша && Режим производительности && Кэш префиксов && Quantization Общий TPS: 10363.77 (+7.60%,ниже предыдущего +9.75%; оптимизация не включена в итоговую команду) Среднее TPOT(ms): 24.91 Общий TPS: 9632.01 Среднее TPOT(ms): 25.89 Спекулятивное декодирование && Quantization Общий TPS: 15514.15 (Доля успешных запросов: 51.6%, оптимизация пропущена) Среднее TPOT(ms): 66.41 Общий TPS: 9632.01 Среднее TPOT(ms): 25.89
Другие сценарии бенчмарка ShareGPT Базовые параметры бэкенда: --reasoning-parser= qwen3
--max-model-len= 32768
Результат базового бенчмарка ============ Serving Benchmark Result ============
Successful requests: 1000
Maximum request concurrency: 512
Benchmark duration (s): 70.72
Total input tokens: 342058
Total generated tokens: 281412
Request throughput (req/s): 14.14
Output token throughput (tok/s): 4347.55
Peak output token throughput (tok/s): 30810010.86
Peak concurrent requests: 512.00
Total Token throughput (tok/s): 9632.01
----------------------Latency---------------------
Mean Latency(s): 30.19
Median Latency(s): 27.48
P95 Latency(s): 60.73
P99 Latency(s): 65.37
---------------Time to First Token----------------
Mean TTFT (ms): 4072.64
Median TTFT (ms): 5786.23
P95 TTFT (ms): 9276.23
P99 TTFT (ms): 10204.44
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms): 25.89
Median TPOT (ms): 11.63
P95 TPOT (ms): 119.58
P99 TPOT (ms): 161.45
---------------Inter-token Latency----------------
Mean ITL (ms): 11.46
Median ITL (ms): 0.00
P95 ITL (ms): 101.72
P99 ITL (ms): 132.49
==================================================
Параметры бэкенда после оптимизации: --reasoning-parser= qwen3
--performance-mode= throughput
--max-model-len= 32768
--enable-prefix-caching
Результат бенчмарка после оптимизации ============ Serving Benchmark Result ============
Successful requests: 1000
Maximum request concurrency: 512
Benchmark duration (s): 65.25
Total input tokens: 342058
Total generated tokens: 281412
Request throughput (req/s): 15.33
Output token throughput (tok/s): 4771.31
Peak output token throughput (tok/s): 41235027.15
Peak concurrent requests: 512.00
Total Token throughput (tok/s): 10570.88
----------------------Latency---------------------
Mean Latency(s): 28.45
Median Latency(s): 25.64
P95 Latency(s): 57.14
P99 Latency(s): 60.99
---------------Time to First Token----------------
Mean TTFT (ms): 4123.08
Median TTFT (ms): 6272.83
P95 TTFT (ms): 8823.87
P99 TTFT (ms): 9032.36
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms): 24.71
Median TPOT (ms): 11.49
P95 TPOT (ms): 108.44
P99 TPOT (ms): 153.41
---------------Inter-token Latency----------------
Mean ITL (ms): 10.10
Median ITL (ms): 0.00
P95 ITL (ms): 84.74
P99 ITL (ms): 124.30
==================================================
Профиль высокой пропускной способности Базовые параметры бэкенда: --reasoning-parser= qwen3
--max-model-len= 32768
Результат базового бенчмарка ============ Serving Benchmark Result ============
Successful requests: 1000
Maximum request concurrency: 512
Benchmark duration (s): 40.37
Total input tokens: 1033932
Total generated tokens: 128000
Request throughput (req/s): 24.77
Output token throughput (tok/s): 4178.94
Peak output token throughput (tok/s): 4782814.36
Peak concurrent requests: 512.00
Total Token throughput (tok/s): 37934.72
----------------------Latency---------------------
Mean Latency(s): 19.96
Median Latency(s): 20.63
P95 Latency(s): 32.86
P99 Latency(s): 34.01
---------------Time to First Token----------------
Mean TTFT (ms): 5809.82
Median TTFT (ms): 5564.25
P95 TTFT (ms): 14821.97
P99 TTFT (ms): 16424.58
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms): 45.39
Median TPOT (ms): 43.47
P95 TPOT (ms): 115.80
P99 TPOT (ms): 128.32
---------------Inter-token Latency----------------
Mean ITL (ms): 0.00
Median ITL (ms): 0.00
P95 ITL (ms): 0.00
P99 ITL (ms): 0.00
==================================================
Параметры бэкенда после оптимизации: --reasoning-parser= qwen3
--performance-mode= throughput
--max-model-len= 32768
--enable-prefix-caching
Результат бенчмарка после оптимизации ============ Serving Benchmark Result ============
Successful requests: 1000
Maximum request concurrency: 512
Benchmark duration (s): 33.09
Total input tokens: 1033932
Total generated tokens: 128000
Request throughput (req/s): 30.04
Output token throughput (tok/s): 5559.27
Peak output token throughput (tok/s): 8426225.08
Peak concurrent requests: 512.00
Total Token throughput (tok/s): 50464.84
----------------------Latency---------------------
Mean Latency(s): 16.41
Median Latency(s): 18.57
P95 Latency(s): 25.97
P99 Latency(s): 26.61
---------------Time to First Token----------------
Mean TTFT (ms): 5263.31
Median TTFT (ms): 5797.34
P95 TTFT (ms): 12306.78
P99 TTFT (ms): 13313.63
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms): 41.12
Median TPOT (ms): 45.29
P95 TPOT (ms): 96.15
P99 TPOT (ms): 104.01
---------------Inter-token Latency----------------
Mean ITL (ms): 0.00
Median ITL (ms): 0.00
P95 ITL (ms): 0.00
P99 ITL (ms): 0.00
==================================================
Профиль длинного контекста Базовые параметры бэкенда: --reasoning-parser= qwen3
--max-model-len= 32768
Результат базового бенчмарка ============ Serving Benchmark Result ============
Successful requests: 100
Maximum request concurrency: 100
Benchmark duration (s): 73.72
Total input tokens: 3200993
Total generated tokens: 10000
Request throughput (req/s): 1.36
Output token throughput (tok/s): 140.12
Peak output token throughput (tok/s): 309.07
Peak concurrent requests: 100.00
Total Token throughput (tok/s): 44993.20
----------------------Latency---------------------
Mean Latency(s): 47.26
Median Latency(s): 48.95
P95 Latency(s): 61.84
P99 Latency(s): 62.18
---------------Time to First Token----------------
Mean TTFT (ms): 31979.13
Median TTFT (ms): 31950.33
P95 TTFT (ms): 55557.79
P99 TTFT (ms): 57562.19
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms): 319.79
Median TPOT (ms): 319.50
P95 TPOT (ms): 555.58
P99 TPOT (ms): 575.62
---------------Inter-token Latency----------------
Mean ITL (ms): 0.00
Median ITL (ms): 0.00
P95 ITL (ms): 0.00
P99 ITL (ms): 0.00
==================================================
Параметры бэкенда после оптимизации: --reasoning-parser= qwen3
--performance-mode= throughput
--max-model-len= 32768
--enable-prefix-caching
Результат бенчмарка после оптимизации ============ Serving Benchmark Result ============
Successful requests: 100
Maximum request concurrency: 100
Benchmark duration (s): 59.32
Total input tokens: 3200993
Total generated tokens: 10000
Request throughput (req/s): 1.69
Output token throughput (tok/s): 175.72
Peak output token throughput (tok/s): 950.60
Peak concurrent requests: 100.00
Total Token throughput (tok/s): 56424.42
----------------------Latency---------------------
Mean Latency(s): 44.56
Median Latency(s): 46.68
P95 Latency(s): 51.00
P99 Latency(s): 51.33
---------------Time to First Token----------------
Mean TTFT (ms): 22743.47
Median TTFT (ms): 22414.07
P95 TTFT (ms): 42138.77
P99 TTFT (ms): 43901.20
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms): 227.43
Median TPOT (ms): 224.14
P95 TPOT (ms): 421.39
P99 TPOT (ms): 439.01
---------------Inter-token Latency----------------
Mean ITL (ms): 0.00
Median ITL (ms): 0.00
P95 ITL (ms): 0.00
P99 ITL (ms): 0.00
==================================================
Профиль интенсивной генерации Базовые параметры бэкенда: --reasoning-parser= qwen3
--max-model-len= 32768
Результат базового бенчмарка ============ Serving Benchmark Result ============
Successful requests: 200
Maximum request concurrency: 200
Benchmark duration (s): 57.74
Total input tokens: 201982
Total generated tokens: 400000
Request throughput (req/s): 3.45
Output token throughput (tok/s): 6947.30
Peak output token throughput (tok/s): 77961040.89
Peak concurrent requests: 200.00
Total Token throughput (tok/s): 10455.38
----------------------Latency---------------------
Mean Latency(s): 57.43
Median Latency(s): 57.45
P95 Latency(s): 57.54
P99 Latency(s): 57.57
---------------Time to First Token----------------
Mean TTFT (ms): 1915.55
Median TTFT (ms): 1956.25
P95 TTFT (ms): 3537.91
P99 TTFT (ms): 3608.07
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms): 2.48
Median TPOT (ms): 1.00
P95 TPOT (ms): 28.70
P99 TPOT (ms): 28.76
---------------Inter-token Latency----------------
Mean ITL (ms): 1.52
Median ITL (ms): 0.00
P95 ITL (ms): 26.98
P99 ITL (ms): 27.96
==================================================
Параметры бэкенда после оптимизации: --reasoning-parser= qwen3
--performance-mode= throughput
--max-model-len= 32768
--enable-prefix-caching
Результат бенчмарка после оптимизации ============ Serving Benchmark Result ============
Successful requests: 200
Maximum request concurrency: 200
Benchmark duration (s): 49.34
Total input tokens: 201982
Total generated tokens: 400000
Request throughput (req/s): 4.05
Output token throughput (tok/s): 8145.62
Peak output token throughput (tok/s): 100865026.05
Peak concurrent requests: 200.00
Total Token throughput (tok/s): 12258.79
----------------------Latency---------------------
Mean Latency(s): 49.16
Median Latency(s): 49.16
P95 Latency(s): 49.18
P99 Latency(s): 49.20
---------------Time to First Token----------------
Mean TTFT (ms): 1574.69
Median TTFT (ms): 1624.98
P95 TTFT (ms): 2718.49
P99 TTFT (ms): 2763.35
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms): 2.92
Median TPOT (ms): 0.82
P95 TPOT (ms): 24.58
P99 TPOT (ms): 24.59
---------------Inter-token Latency----------------
Mean ITL (ms): 2.14
Median ITL (ms): 0.00
P95 ITL (ms): 23.67
P99 ITL (ms): 23.99
==================================================