Перейти к содержанию

Оптимизация пропускной способности Qwen3-235B-A22B на NVIDIA H100 GPU

Вывод

qwen3-235b-a22b-h100

Рекомендуемая конфигурация для оптимизации пропускной способности Qwen3-235B-A22B-Instruct-2507 на H100 GPU:

Команда обслуживания модели
vllm serve Qwen/Qwen3-235B-A22B-Instruct-2507-FP8 -tp 4 --max-num-batched-tokens 16384

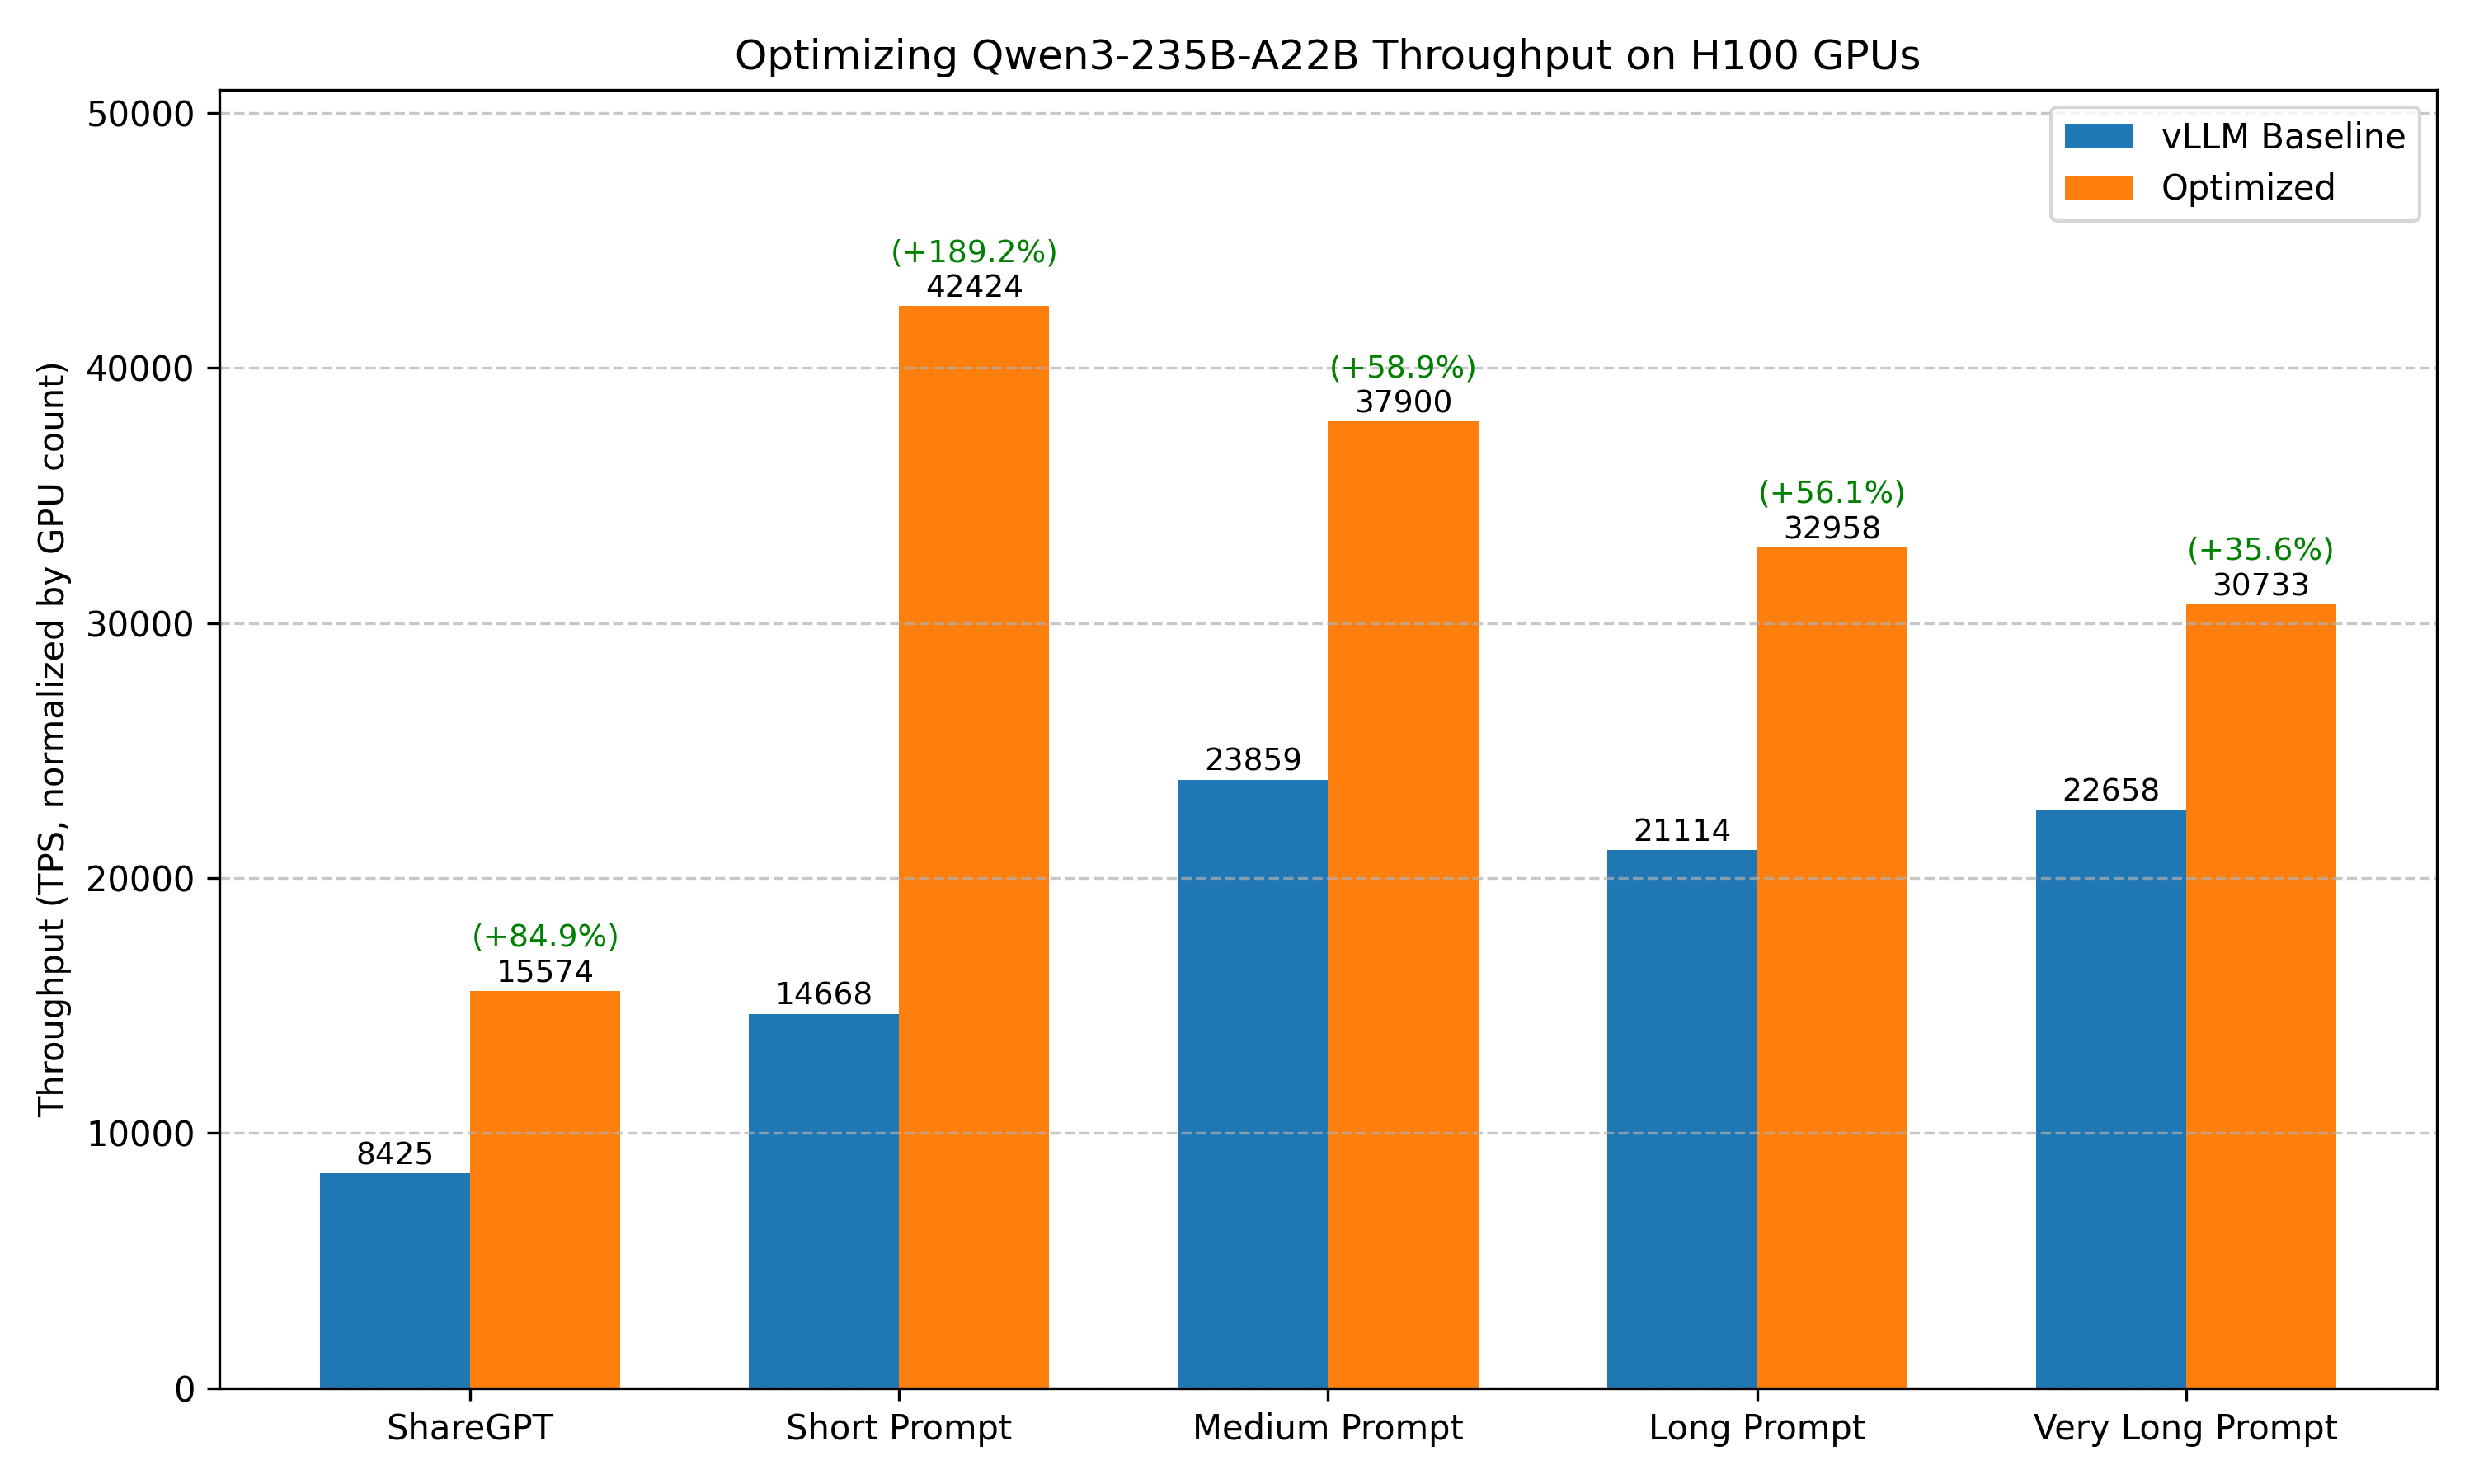
Сравнение результатов бенчмарков до и после оптимизации:

Сценарий бенчмарка базовая конфигурация (vLLM без оптимизации) После оптимизации
ShareGPT Общий TPS: 8424.86
Среднее TPOT(ms): 147.56
Общий TPS: 7787.17x2 (+84.9%)
Среднее TPOT(ms): 186.26
Короткий запрос Общий TPS: 14668.27
Среднее TPOT(ms): 212.98
Общий TPS: 21211.83x2 (+189.2%)
Среднее TPOT(ms): 125.18
Запрос средней длины Общий TPS: 23858.69
Среднее TPOT(ms): 101.08
Общий TPS: 18950.04x2 (+58.9%)
Среднее TPOT(ms): 125.93
Длинный запрос Общий TPS: 21113.53
Среднее TPOT(ms): 68.94
Общий TPS: 16478.79x2 (+56.1%)
Среднее TPOT(ms): 89.52
Очень длинный запрос Общий TPS: 22657.51
Среднее TPOT(ms): 132.10
Общий TPS: 15366.32x2 (+35.6%)
Среднее TPOT(ms): 194.60

Примечание

  1. Наши бенчмарки не охватывают все возможные сочетания оптимизаций. Например, отправной точкой дальнейшей настройки становится движок инференса с лучшей производительностью при настройках по умолчанию. Такое отсечение вариантов даёт локальный оптимум, который может не совпадать с глобальным.
  2. Есть и другие методы оптимизации, зависящие от сценария использования: максимальный размер батча, настройки планировщика, расширенный KV-кэш, CUDA graph, Torch Compile и т. д. Выводы этого документа могут служить отправной точкой для более целенаправленной оптимизации.
  3. Тесты проводились на определённых аппаратных и программных конфигурациях. Развитие движков инференса может привести к новым выводам.
  4. Квантизация может влиять на точность, однако для большинства моделей FP8 обеспечивает снижение точности менее чем на 1%. Подробности см. в результатах оценки. Поэтому для обслуживания с высокой пропускной способностью настоятельно рекомендуется квантизация FP8.

Если что-то упущено или требуется обновление с учётом новых изменений, сообщите нам.

Цель оптимизации

Высокая пропускная способность при высокой конкурентности запросов.

Условия эксперимента

Модель

Qwen3-235B-A22B-Instruct-2507

Оборудование

8 × NVIDIA H100 SXM GPU на одном узле.

Версия движка

  • vLLM: v0.11.0
  • SGLang: v0.5.5.post1

Набор данных бенчмарка

  1. ShareGPT
  2. Случайный набор данных с различной длиной последовательностей:
    • Очень длинный запрос: 32000 входных токенов, 100 выходных токенов
    • Длинный запрос: 4000 входных токенов, 200 выходных токенов
    • Запрос средней длины: 2000 входных токенов, 100 выходных токенов
    • Короткий запрос: 128 входных токенов, 4 выходных токенов

Скрипт бенчмарка

Для оценки производительности модели используется vLLM bench CLI. Бенчмарк запускается следующей командой:

1
2
3
4
5
6
7
8
# Prepare the ShareGPT dataset
wget https://huggingface.co/datasets/anon8231489123/ShareGPT_Vicuna_unfiltered/resolve/main/ShareGPT_V3_unfiltered_cleaned_split.json

# Benchmark on ShareGPT dataset
vllm bench serve --model Qwen/Qwen3-235B-A22B-Instruct-2507 --backend openai-chat --endpoint /v1/chat/completions --dataset-name sharegpt --dataset-path ShareGPT_V3_unfiltered_cleaned_split.json --num-prompts 1000

# Benchmark on random dataset (fixed seed for reproducibility)
vllm bench serve --model Qwen/Qwen3-235B-A22B-Instruct-2507 --backend openai-chat --endpoint /v1/chat/completions --dataset-name random --random-input-len 4000 --random-output-len 200 --num-prompts 500 --seed 42

Результаты эксперимента

1. Выбор движка инференса

vLLM

Скрипт обслуживания модели
vllm serve Qwen/Qwen3-235B-A22B-Instruct-2507 -tp 8
Результат бенчмарка
============ Serving Benchmark Result ============
Successful requests:                     984
Benchmark duration (s):                  48.28
Total input tokens:                      212894
Total generated tokens:                  193865
Request throughput (req/s):              20.38
Output token throughput (tok/s):         4015.36
Peak output token throughput (tok/s):    9638.00
Peak concurrent requests:                984.00
Total Token throughput (tok/s):          8424.86
---------------Time to First Token----------------
Mean TTFT (ms):                          8730.69
Median TTFT (ms):                        8707.89
P99 TTFT (ms):                           12940.37
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms):                          147.56
Median TPOT (ms):                        114.67
P99 TPOT (ms):                           342.35
---------------Inter-token Latency----------------
Mean ITL (ms):                           81.31
Median ITL (ms):                         51.14
P99 ITL (ms):                            677.61
==================================================
SGLang

Скрипт обслуживания модели
python3 -m sglang.launch_server --model-path Qwen/Qwen3-235B-A22B-Instruct-2507 --tp-size 8
Результат бенчмарка
============ Serving Benchmark Result ============
Successful requests:                     984
Benchmark duration (s):                  53.18
Total input tokens:                      214137
Total generated tokens:                  193829
Request throughput (req/s):              18.50
Output token throughput (tok/s):         3644.72
Peak output token throughput (tok/s):    8791.00
Peak concurrent requests:                984.00
Total Token throughput (tok/s):          7671.31
---------------Time to First Token----------------
Mean TTFT (ms):                          11715.28
Median TTFT (ms):                        6274.12
P99 TTFT (ms):                           32860.14
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms):                          178.35
Median TPOT (ms):                        102.70
P99 TPOT (ms):                           841.80
---------------Inter-token Latency----------------
Mean ITL (ms):                           88.35
Median ITL (ms):                         44.39
P99 ITL (ms):                            732.90
==================================================

Результат: vLLM (8424.86 tok/s) > SGLang (7671.31 tok/s)

2. Quantization в vLLM

Скрипт обслуживания модели
# TP8 only is not compatible with the model weight. Use EP as well.
vllm serve Qwen/Qwen3-235B-A22B-Instruct-2507-FP8 -tp 8 --enable-expert-parallel
Результат бенчмарка
============ Serving Benchmark Result ============
Successful requests:                     984
Benchmark duration (s):                  49.88
Total input tokens:                      211761
Total generated tokens:                  192350
Request throughput (req/s):              19.73
Output token throughput (tok/s):         3856.59
Peak output token throughput (tok/s):    9788.00
Peak concurrent requests:                984.00
Total Token throughput (tok/s):          8102.36
---------------Time to First Token----------------
Mean TTFT (ms):                          9755.64
Median TTFT (ms):                        9742.53
P99 TTFT (ms):                           14508.64
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms):                          169.52
Median TPOT (ms):                        129.08
P99 TPOT (ms):                           353.11
---------------Inter-token Latency----------------
Mean ITL (ms):                           88.39
Median ITL (ms):                         49.03
P99 ITL (ms):                            343.14
==================================================

3. Параллелизм в vLLM

TP4

Скрипт обслуживания модели
vllm serve Qwen/Qwen3-235B-A22B-Instruct-2507-FP8 -tp 4
Результат бенчмарка
============ Serving Benchmark Result ============
Successful requests:                     984
Benchmark duration (s):                  54.12
Total input tokens:                      212992
Total generated tokens:                  194446
Request throughput (req/s):              18.18
Output token throughput (tok/s):         3592.57
Peak output token throughput (tok/s):    8605.00
Peak concurrent requests:                984.00
Total Token throughput (tok/s):          7527.80
---------------Time to First Token----------------
Mean TTFT (ms):                          9924.69
Median TTFT (ms):                        9896.14
P99 TTFT (ms):                           15574.61
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms):                          169.20
Median TPOT (ms):                        121.96
P99 TPOT (ms):                           372.71
---------------Inter-token Latency----------------
Mean ITL (ms):                           89.89
Median ITL (ms):                         57.15
P99 ITL (ms):                            351.02
==================================================  

TP4+EP

Скрипт обслуживания модели
vllm serve Qwen/Qwen3-235B-A22B-Instruct-2507-FP8 -tp 4 --enable-expert-parallel
Результат бенчмарка
============ Serving Benchmark Result ============
Successful requests:                     984
Benchmark duration (s):                  57.08
Total input tokens:                      214311
Total generated tokens:                  192752
Request throughput (req/s):              17.24
Output token throughput (tok/s):         3376.99
Peak output token throughput (tok/s):    8005.00
Peak concurrent requests:                984.00
Total Token throughput (tok/s):          7131.69
---------------Time to First Token----------------
Mean TTFT (ms):                          10706.10
Median TTFT (ms):                        10676.53
P99 TTFT (ms):                           17226.88
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms):                          190.24
Median TPOT (ms):                        131.62
P99 TPOT (ms):                           432.31
---------------Inter-token Latency----------------
Mean ITL (ms):                           96.98
Median ITL (ms):                         60.65
P99 ITL (ms):                            408.09
==================================================

4. Бэкенд внимания в vLLM

По умолчанию используется FlashAttention.

FlashInfer

Скрипт обслуживания модели
VLLM_ATTENTION_BACKEND=FLASHINFER vllm serve Qwen/Qwen3-235B-A22B-Instruct-2507-FP8 -tp 4
Результат бенчмарка
# Crash

XFormers

Скрипт обслуживания модели
VLLM_ATTENTION_BACKEND=XFORMERS vllm serve Qwen/Qwen3-235B-A22B-Instruct-2507-FP8 -tp 4
Результат бенчмарка
# Crash on inference

5. Максимальное число токенов в батче в vLLM

Скрипт обслуживания модели
vllm serve Qwen/Qwen3-235B-A22B-Instruct-2507-FP8 -tp 4 --max-num-batched-tokens 16384
Результат бенчмарка
# --max-num-batched-tokens 16384
============ Serving Benchmark Result ============
Successful requests:                     984
Benchmark duration (s):                  52.46
Total input tokens:                      214381
Total generated tokens:                  194148
Request throughput (req/s):              18.76
Output token throughput (tok/s):         3700.75
Peak output token throughput (tok/s):    8574.00
Peak concurrent requests:                984.00
Total Token throughput (tok/s):          7787.17
---------------Time to First Token----------------
Mean TTFT (ms):                          9600.73
Median TTFT (ms):                        9525.78
P99 TTFT (ms):                           13887.13
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms):                          186.26
Median TPOT (ms):                        108.31
P99 TPOT (ms):                           634.48
---------------Inter-token Latency----------------
Mean ITL (ms):                           86.62
Median ITL (ms):                         56.97
P99 ITL (ms):                            632.37
==================================================

# --max-num-batched-tokens 32768
# Crash on inference

Сводка методов оптимизации

Метод оптимизации Прирост пропускной способности
Выбор движка -
Quantization -
Параллелизм +78.7%
Бэкенд внимания -
Максимальное число токенов в батче +3.4%

Другие сценарии бенчмарка

Мы дополнительно проверили оптимизированную конфигурацию на разных нагрузках, чтобы оценить её обобщаемость.

Базовый скрипт обслуживания модели
vllm serve Qwen/Qwen3-235B-A22B-Instruct-2507 -tp 8
Результаты базового бенчмарка
# random 32K input
============ Serving Benchmark Result ============
Successful requests:                     100
Benchmark duration (s):                  141.60
Total input tokens:                      3200000
Total generated tokens:                  8191
Request throughput (req/s):              0.71
Output token throughput (tok/s):         57.85
Peak output token throughput (tok/s):    346.00
Peak concurrent requests:                100.00
Total Token throughput (tok/s):          22657.51
---------------Time to First Token----------------
Mean TTFT (ms):                          70409.55
Median TTFT (ms):                        70737.29
P99 TTFT (ms):                           138084.17
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms):                          132.10
Median TPOT (ms):                        134.49
P99 TPOT (ms):                           182.76
---------------Inter-token Latency----------------
Mean ITL (ms):                           129.44
Median ITL (ms):                         23.29
P99 ITL (ms):                            376.34
==================================================

# random 4K input
============ Serving Benchmark Result ============
Successful requests:                     500
Benchmark duration (s):                  98.99
Total input tokens:                      1997942
Total generated tokens:                  92185
Request throughput (req/s):              5.05
Output token throughput (tok/s):         931.21
Peak output token throughput (tok/s):    2450.00
Peak concurrent requests:                500.00
Total Token throughput (tok/s):          21113.53
---------------Time to First Token----------------
Mean TTFT (ms):                          47811.58
Median TTFT (ms):                        48562.54
P99 TTFT (ms):                           93161.32
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms):                          68.94
Median TPOT (ms):                        72.58
P99 TPOT (ms):                           92.94
---------------Inter-token Latency----------------
Mean ITL (ms):                           68.75
Median ITL (ms):                         30.18
P99 ITL (ms):                            245.68
==================================================

# random 2K input
============ Serving Benchmark Result ============
Successful requests:                     500
Benchmark duration (s):                  43.91
Total input tokens:                      998175
Total generated tokens:                  49500
Request throughput (req/s):              11.39
Output token throughput (tok/s):         1127.26
Peak output token throughput (tok/s):    4021.00
Peak concurrent requests:                500.00
Total Token throughput (tok/s):          23858.69
---------------Time to First Token----------------
Mean TTFT (ms):                          21313.79
Median TTFT (ms):                        20242.32
P99 TTFT (ms):                           40939.00
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms):                          101.08
Median TPOT (ms):                        108.64
P99 TPOT (ms):                           125.24
---------------Inter-token Latency----------------
Mean ITL (ms):                           100.16
Median ITL (ms):                         35.94
P99 ITL (ms):                            244.64
==================================================

# random 128 input
============ Serving Benchmark Result ============
Successful requests:                     984
Benchmark duration (s):                  8.83
Total input tokens:                      125650
Total generated tokens:                  3936
Request throughput (req/s):              111.38
Output token throughput (tok/s):         445.53
Peak output token throughput (tok/s):    1489.00
Peak concurrent requests:                984.00
Total Token throughput (tok/s):          14668.27
---------------Time to First Token----------------
Mean TTFT (ms):                          7042.17
Median TTFT (ms):                        6882.45
P99 TTFT (ms):                           8721.24
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms):                          212.98
Median TPOT (ms):                        238.84
P99 TPOT (ms):                           242.28
---------------Inter-token Latency----------------
Mean ITL (ms):                           159.73
Median ITL (ms):                         235.21
P99 ITL (ms):                            250.35
==================================================
Скрипт обслуживания после оптимизации
vllm serve Qwen/Qwen3-235B-A22B-Instruct-2507-FP8 -tp 4 --max-num-batched-tokens 16384
Результаты бенчмарка после оптимизации
# random 32K input
============ Serving Benchmark Result ============
Successful requests:                     100
Benchmark duration (s):                  208.79
Total input tokens:                      3200000
Total generated tokens:                  8281
Request throughput (req/s):              0.48
Output token throughput (tok/s):         39.66
Peak output token throughput (tok/s):    277.00
Peak concurrent requests:                100.00
Total Token throughput (tok/s):          15366.32
---------------Time to First Token----------------
Mean TTFT (ms):                          103754.50
Median TTFT (ms):                        103784.48
P99 TTFT (ms):                           205204.25
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms):                          194.60
Median TPOT (ms):                        194.50
P99 TPOT (ms):                           277.94
---------------Inter-token Latency----------------
Mean ITL (ms):                           193.15
Median ITL (ms):                         27.60
P99 ITL (ms):                            1117.34
==================================================

# random 4K input
============ Serving Benchmark Result ============
Successful requests:                     500
Benchmark duration (s):                  126.76
Total input tokens:                      1997942
Total generated tokens:                  90966
Request throughput (req/s):              3.94
Output token throughput (tok/s):         717.60
Peak output token throughput (tok/s):    2139.00
Peak concurrent requests:                500.00
Total Token throughput (tok/s):          16478.79
---------------Time to First Token----------------
Mean TTFT (ms):                          60513.14
Median TTFT (ms):                        61048.35
P99 TTFT (ms):                           120001.31
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms):                          89.52
Median TPOT (ms):                        94.78
P99 TPOT (ms):                           121.95
---------------Inter-token Latency----------------
Mean ITL (ms):                           89.17
Median ITL (ms):                         34.82
P99 ITL (ms):                            642.94
==================================================

# random 2K input
============ Serving Benchmark Result ============
Successful requests:                     500
Benchmark duration (s):                  55.28
Total input tokens:                      998175
Total generated tokens:                  49471
Request throughput (req/s):              9.04
Output token throughput (tok/s):         894.84
Peak output token throughput (tok/s):    3723.00
Peak concurrent requests:                500.00
Total Token throughput (tok/s):          18950.04
---------------Time to First Token----------------
Mean TTFT (ms):                          26860.95
Median TTFT (ms):                        26155.54
P99 TTFT (ms):                           51773.01
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms):                          125.93
Median TPOT (ms):                        140.65
P99 TPOT (ms):                           152.49
---------------Inter-token Latency----------------
Mean ITL (ms):                           124.89
Median ITL (ms):                         39.21
P99 ITL (ms):                            632.84
==================================================

# random 128 input
============ Serving Benchmark Result ============
Successful requests:                     984
Benchmark duration (s):                  6.11
Total input tokens:                      125650
Total generated tokens:                  3936
Request throughput (req/s):              161.07
Output token throughput (tok/s):         644.28
Peak output token throughput (tok/s):    3676.00
Peak concurrent requests:                984.00
Total Token throughput (tok/s):          21211.83
---------------Time to First Token----------------
Mean TTFT (ms):                          5621.51
Median TTFT (ms):                        5525.90
P99 TTFT (ms):                           5803.57
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms):                          125.18
Median TPOT (ms):                        152.34
P99 TPOT (ms):                           182.84
---------------Inter-token Latency----------------
Mean ITL (ms):                           93.89
Median ITL (ms):                         110.55
P99 ITL (ms):                            243.41
==================================================