Перейти к содержанию

Оптимизация пропускной способности GPT-OSS-120B на NVIDIA A100 GPU

Вывод

gpt-oss-120b-a100

Рекомендуемая конфигурация для оптимизации пропускной способности GPT-OSS-120B на A100 GPU:

Команда обслуживания модели
vllm serve openai/gpt-oss-120b --max-model-len 32768 --async-scheduling --max-num-batched-tokens 4096

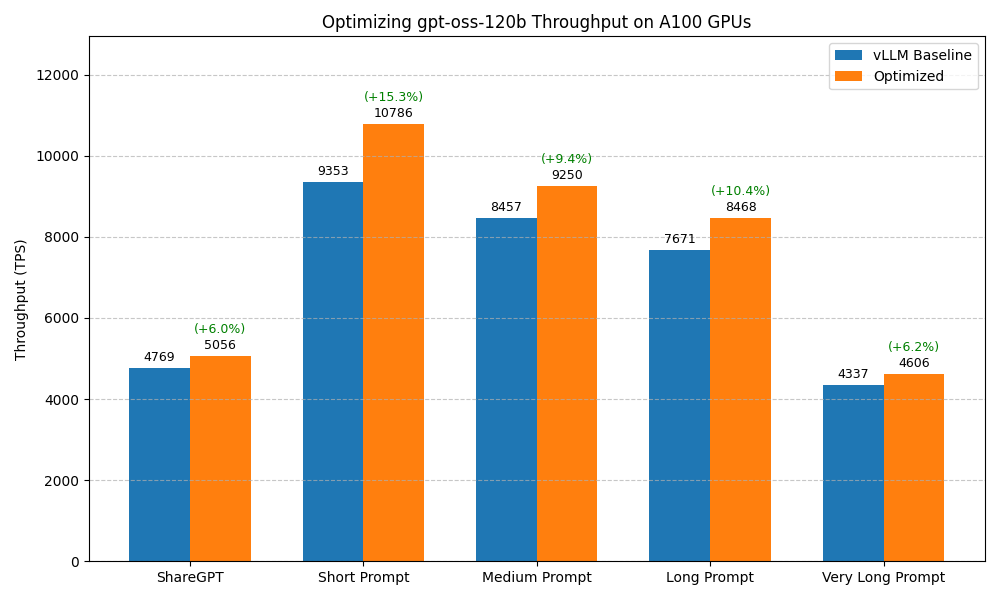
Сравнение результатов бенчмарков до и после оптимизации:

Сценарий бенчмарка базовая конфигурация (vLLM без оптимизации) После оптимизации
ShareGPT Общий TPS: 4768.75
Среднее TPOT(ms): 97.57
Общий TPS: 5055.82 (+6.0%)
Среднее TPOT(ms): 94.55
Короткий запрос Общий TPS: 9353.12
Среднее TPOT(ms): 182.75
Общий TPS: 10785.60 (+15.3%)
Среднее TPOT(ms): 301.66
Запрос средней длины Общий TPS: 8456.65
Среднее TPOT(ms): 131.94
Общий TPS: 9249.89 (+9.4%)
Среднее TPOT(ms): 117.85
Длинный запрос Общий TPS: 7671.00
Среднее TPOT(ms): 112.18
Общий TPS: 8468.21 (+10.4%)
Среднее TPOT(ms): 99.77
Очень длинный запрос Общий TPS: 4337.21
Среднее TPOT(ms): 224.58
Общий TPS: 4605.91 (+6.2%)
Среднее TPOT(ms): 201.61

Примечание

  1. Наши бенчмарки не охватывают все возможные сочетания оптимизаций. Например, отправной точкой дальнейшей настройки становится движок инференса с лучшей производительностью при настройках по умолчанию. Такое отсечение вариантов даёт локальный оптимум, который может не совпадать с глобальным.
  2. Есть и другие методы оптимизации, зависящие от сценария использования: максимальный размер батча, настройки планировщика, расширенный KV-кэш, CUDA graph, Torch Compile и т. д. Выводы этого документа могут служить отправной точкой для более целенаправленной оптимизации.
  3. Тесты проводились на определённых аппаратных и программных конфигурациях. Развитие движков инференса может привести к новым выводам.

Если что-то упущено или требуется обновление с учётом новых изменений, сообщите нам.

Цель оптимизации

Высокая пропускная способность при высокой конкурентности запросов.

Условия эксперимента

Модель

GPT-OSS-120B

Оборудование

2 × NVIDIA A100 SXM 80GB GPU на одном узле.

Версия движка

  • vLLM: v0.11.0
  • SGLang: v0.5.3
  • TensorRT-LLM: v1.2.0rc0

Набор данных бенчмарка

  1. ShareGPT
  2. Случайный набор данных с различной длиной последовательностей:
    • Очень длинный запрос: 32000 входных токенов, 100 выходных токенов
    • Длинный запрос: 4000 входных токенов, 200 выходных токенов
    • Запрос средней длины: 2000 входных токенов, 100 выходных токенов
    • Короткий запрос: 128 входных токенов, 4 выходных токенов

Скрипт бенчмарка

Для оценки производительности модели используется vLLM bench CLI. Бенчмарк запускается следующей командой:

1
2
3
4
5
6
7
8
# Prepare the ShareGPT dataset
wget https://huggingface.co/datasets/anon8231489123/ShareGPT_Vicuna_unfiltered/resolve/main/ShareGPT_V3_unfiltered_cleaned_split.json

# Benchmark on ShareGPT dataset
vllm bench serve --model openai/gpt-oss-120b --backend openai-chat --endpoint /v1/chat/completions --dataset-name sharegpt --dataset-path ShareGPT_V3_unfiltered_cleaned_split.json --num-prompts 1000

# Benchmark on random dataset (fixed seed for reproducibility)
vllm bench serve --model openai/gpt-oss-120b --backend openai-chat --endpoint /v1/chat/completions --dataset-name random --random-input-len 4000 --random-output-len 200 --num-prompts 500 --seed 42

Результаты эксперимента

1. Выбор движка инференса

vLLM

Скрипт обслуживания модели
vllm serve openai/gpt-oss-120b --max-model-len 32768
Результат бенчмарка
============ Serving Benchmark Result ============
Successful requests:                     1000
Benchmark duration (s):                  86.39
Total input tokens:                      215312
Total generated tokens:                  196656
Request throughput (req/s):              11.58
Output token throughput (tok/s):         2276.40
Peak output token throughput (tok/s):    3572.00
Peak concurrent requests:                1000.00
Total Token throughput (tok/s):          4768.75
---------------Time to First Token----------------
Mean TTFT (ms):                          25918.79
Median TTFT (ms):                        24822.43
P99 TTFT (ms):                           59731.55
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms):                          97.57
Median TPOT (ms):                        90.70
P99 TPOT (ms):                           206.31
---------------Inter-token Latency----------------
Mean ITL (ms):                           86.67
Median ITL (ms):                         70.10
P99 ITL (ms):                            210.76
==================================================
SGLang

Скрипт обслуживания модели
python3 -m sglang.launch_server --model-path openai/gpt-oss-120b --host 0.0.0.0 --port 8000 
Результат бенчмарка
============ Serving Benchmark Result ============
Successful requests:                     1000
Benchmark duration (s):                  597.93
Total input tokens:                      215312
Total generated tokens:                  197133
Request throughput (req/s):              1.67
Output token throughput (tok/s):         329.69
Peak output token throughput (tok/s):    1865.00
Peak concurrent requests:                1000.00
Total Token throughput (tok/s):          689.79
---------------Time to First Token----------------
Mean TTFT (ms):                          275030.66
Median TTFT (ms):                        270126.72
P99 TTFT (ms):                           550929.50
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms):                          765.78
Median TPOT (ms):                        486.18
P99 TPOT (ms):                           6656.59
---------------Inter-token Latency----------------
Mean ITL (ms):                           458.97
Median ITL (ms):                         112.65
P99 ITL (ms):                            6667.80
==================================================

TensorRT-LLM

Скрипт обслуживания модели
trtllm-serve openai/gpt-oss-120b --max_seq_len 32768
Результат бенчмарка
NotImplementedError: WFP4A16 MoE is unsupported on SM80.

Результат: vLLM (4768.75 tok/s) > SGLang(689.79 tok/s) > TensorRT-LLM (Не поддерживается)

2. Асинхронное планирование в vLLM

Скрипт обслуживания модели
vllm serve openai/gpt-oss-120b --max-model-len 32768 --async-scheduling
Результат бенчмарка
============ Serving Benchmark Result ============
Successful requests:                     1000
Benchmark duration (s):                  82.35
Total input tokens:                      215312
Total generated tokens:                  195312
Request throughput (req/s):              12.14
Output token throughput (tok/s):         2371.67
Peak output token throughput (tok/s):    3615.00
Peak concurrent requests:                1000.00
Total Token throughput (tok/s):          4986.20
---------------Time to First Token----------------
Mean TTFT (ms):                          24787.19
Median TTFT (ms):                        23575.09
P99 TTFT (ms):                           56631.39
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms):                          92.70
Median TPOT (ms):                        86.19
P99 TPOT (ms):                           203.05
---------------Inter-token Latency----------------
Mean ITL (ms):                           82.31
Median ITL (ms):                         65.76
P99 ITL (ms):                            205.68
==================================================

Результат: включение асинхронного планирования повысило пропускную способность с 4768.75 tok/s до 4986.20 tok/s.

3. Параллелизм в vLLM

TP2

Скрипт обслуживания модели
vllm serve openai/gpt-oss-120b --max-model-len 32768 --async-scheduling -tp 2
Результат бенчмарка
============ Serving Benchmark Result ============
Successful requests:                     1000
Benchmark duration (s):                  52.10
Total input tokens:                      215312
Total generated tokens:                  196156
Request throughput (req/s):              19.19
Output token throughput (tok/s):         3765.02
Peak output token throughput (tok/s):    5687.00
Peak concurrent requests:                1000.00
Total Token throughput (tok/s):          7897.72
---------------Time to First Token----------------
Mean TTFT (ms):                          16190.50
Median TTFT (ms):                        15435.84
P99 TTFT (ms):                           36099.41
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms):                          57.98
Median TPOT (ms):                        53.39
P99 TPOT (ms):                           132.88
---------------Inter-token Latency----------------
Mean ITL (ms):                           51.20
Median ITL (ms):                         40.51
P99 ITL (ms):                            134.62
==================================================

4. Бэкенд внимания в vLLM

По умолчанию используется FlashAttention.

FlashInfer

Скрипт обслуживания модели
VLLM_ATTENTION_BACKEND=FLASHINFER vllm serve openai/gpt-oss-120b --max-model-len 32768
Результат бенчмарка
RuntimeError: Worker failed with error 'FlashInfer backend currently does not support attention sinks, please use trtllm on blackwell or flash attention on earlier GPUs.', please check the stack trace above for the root cause

5. Максимальное число токенов в батче в vLLM

Скрипт обслуживания модели
vllm serve openai/gpt-oss-120b --max-model-len 32768 --async-scheduling --max-num-batched-tokens 4096
Результат бенчмарка
# --max-num-batched-tokens 4096
============ Serving Benchmark Result ============
Successful requests:                     1000
Benchmark duration (s):                  81.24
Total input tokens:                      215312
Total generated tokens:                  195400
Request throughput (req/s):              12.31
Output token throughput (tok/s):         2405.35
Peak output token throughput (tok/s):    3767.00
Peak concurrent requests:                1000.00
Total Token throughput (tok/s):          5055.82
---------------Time to First Token----------------
Mean TTFT (ms):                          24102.33
Median TTFT (ms):                        23200.31
P99 TTFT (ms):                           55834.89
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms):                          94.55
Median TPOT (ms):                        84.96
P99 TPOT (ms):                           332.44
---------------Inter-token Latency----------------
Mean ITL (ms):                           81.69
Median ITL (ms):                         65.37
P99 ITL (ms):                            263.32
==================================================
# --max-num-batched-tokens 8192
============ Serving Benchmark Result ============
Successful requests:                     1000
Benchmark duration (s):                  81.65
Total input tokens:                      215312
Total generated tokens:                  196734
Request throughput (req/s):              12.25
Output token throughput (tok/s):         2409.38
Peak output token throughput (tok/s):    4073.00
Peak concurrent requests:                1000.00
Total Token throughput (tok/s):          5046.28
---------------Time to First Token----------------
Mean TTFT (ms):                          24118.79
Median TTFT (ms):                        22914.78
P99 TTFT (ms):                           56155.47
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms):                          95.68
Median TPOT (ms):                        85.26
P99 TPOT (ms):                           379.93
---------------Inter-token Latency----------------
Mean ITL (ms):                           81.81
Median ITL (ms):                         65.77
P99 ITL (ms):                            232.43
==================================================

Результат: увеличение max-num-batched-tokens повысило пропускную способность с 4986.20 tok/s до 5046.28 tok/s.

Сводка методов оптимизации

Метод оптимизации Прирост пропускной способности
Выбор движка -
Асинхронное планирование +4.6%
Параллелизм -
Бэкенд внимания -
Максимальное число токенов в батче +1.2%

Другие сценарии бенчмарка

Мы дополнительно проверили оптимизированную конфигурацию на разных нагрузках, чтобы оценить её обобщаемость.

Базовый скрипт обслуживания модели
vllm serve openai/gpt-oss-120b --max-model-len 32768
Результаты базового бенчмарка
# random 32K input
============ Serving Benchmark Result ============
Successful requests:                     100
Benchmark duration (s):                  740.10
Total input tokens:                      3200000
Total generated tokens:                  9988
Request throughput (req/s):              0.14
Output token throughput (tok/s):         13.50
Peak output token throughput (tok/s):    176.00
Peak concurrent requests:                100.00
Total Token throughput (tok/s):          4337.21
---------------Time to First Token----------------
Mean TTFT (ms):                          368856.64
Median TTFT (ms):                        368713.30
P99 TTFT (ms):                           730947.33
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms):                          224.58
Median TPOT (ms):                        228.19
P99 TPOT (ms):                           231.28
---------------Inter-token Latency----------------
Mean ITL (ms):                           233.21
Median ITL (ms):                         24.23
P99 ITL (ms):                            676.79
==================================================

# random 4K input
============ Serving Benchmark Result ============
Successful requests:                     500
Benchmark duration (s):                  269.39
Total input tokens:                      1999249
Total generated tokens:                  67259
Request throughput (req/s):              1.86
Output token throughput (tok/s):         249.67
Peak output token throughput (tok/s):    1146.00
Peak concurrent requests:                500.00
Total Token throughput (tok/s):          7671.00
---------------Time to First Token----------------
Mean TTFT (ms):                          133561.13
Median TTFT (ms):                        134006.62
P99 TTFT (ms):                           263106.36
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms):                          112.18
Median TPOT (ms):                        114.77
P99 TPOT (ms):                           136.26
---------------Inter-token Latency----------------
Mean ITL (ms):                           117.62
Median ITL (ms):                         27.99
P99 ITL (ms):                            353.98
==================================================

# random 2K input
============ Serving Benchmark Result ============
Successful requests:                     500
Benchmark duration (s):                  123.94
Total input tokens:                      999120
Total generated tokens:                  48981
Request throughput (req/s):              4.03
Output token throughput (tok/s):         395.21
Peak output token throughput (tok/s):    1696.00
Peak concurrent requests:                500.00
Total Token throughput (tok/s):          8456.65
---------------Time to First Token----------------
Mean TTFT (ms):                          61328.02
Median TTFT (ms):                        61764.97
P99 TTFT (ms):                           120670.44
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms):                          131.94
Median TPOT (ms):                        138.30
P99 TPOT (ms):                           150.84
---------------Inter-token Latency----------------
Mean ITL (ms):                           139.51
Median ITL (ms):                         214.02
P99 ITL (ms):                            432.26
==================================================

# random 128 input
============ Serving Benchmark Result ============
Successful requests:                     1000
Benchmark duration (s):                  14.09
Total input tokens:                      127755
Total generated tokens:                  4000
Request throughput (req/s):              70.99
Output token throughput (tok/s):         283.95
Peak output token throughput (tok/s):    273.00
Peak concurrent requests:                1000.00
Total Token throughput (tok/s):          9353.12
---------------Time to First Token----------------
Mean TTFT (ms):                          7813.18
Median TTFT (ms):                        7750.58
P99 TTFT (ms):                           13935.99
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms):                          182.75
Median TPOT (ms):                        189.53
P99 TPOT (ms):                           193.12
---------------Inter-token Latency----------------
Mean ITL (ms):                           274.25
Median ITL (ms):                         196.02
P99 ITL (ms):                            386.54
==================================================

# ShareGPT batch size 4
============ Serving Benchmark Result ============
Successful requests:                     100
Maximum request concurrency:             4
Benchmark duration (s):                  66.52
Total input tokens:                      22946
Total generated tokens:                  21691
Request throughput (req/s):              1.50
Output token throughput (tok/s):         326.09
Peak output token throughput (tok/s):    368.00
Peak concurrent requests:                11.00
Total Token throughput (tok/s):          671.05
---------------Time to First Token----------------
Mean TTFT (ms):                          61.91
Median TTFT (ms):                        61.55
P99 TTFT (ms):                           112.05
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms):                          11.67
Median TPOT (ms):                        11.44
P99 TPOT (ms):                           15.03
---------------Inter-token Latency----------------
Mean ITL (ms):                           11.74
Median ITL (ms):                         11.14
P99 ITL (ms):                            38.75
==================================================  
Скрипт обслуживания после оптимизации
vllm serve openai/gpt-oss-120b --max-model-len 32768 --async-scheduling --max-num-batched-tokens 4096
Результаты бенчмарка после оптимизации
# random 32K input
============ Serving Benchmark Result ============
Successful requests:                     100
Benchmark duration (s):                  696.89
Total input tokens:                      3200000
Total generated tokens:                  9828
Request throughput (req/s):              0.14
Output token throughput (tok/s):         14.10
Peak output token throughput (tok/s):    196.00
Peak concurrent requests:                100.00
Total Token throughput (tok/s):          4605.91
---------------Time to First Token----------------
Mean TTFT (ms):                          346799.49
Median TTFT (ms):                        346737.12
P99 TTFT (ms):                           687309.14
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms):                          201.61
Median TPOT (ms):                        203.58
P99 TPOT (ms):                           271.48
---------------Inter-token Latency----------------
Mean ITL (ms):                           209.02
Median ITL (ms):                         20.50
P99 ITL (ms):                            1206.69
==================================================

# random 4K input
============ Serving Benchmark Result ============
Successful requests:                     500
Benchmark duration (s):                  244.13
Total input tokens:                      1999249
Total generated tokens:                  68059
Request throughput (req/s):              2.05
Output token throughput (tok/s):         278.79
Peak output token throughput (tok/s):    1289.00
Peak concurrent requests:                500.00
Total Token throughput (tok/s):          8468.21
---------------Time to First Token----------------
Mean TTFT (ms):                          121158.11
Median TTFT (ms):                        121158.59
P99 TTFT (ms):                           238837.53
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms):                          99.77
Median TPOT (ms):                        102.46
P99 TPOT (ms):                           122.61
---------------Inter-token Latency----------------
Mean ITL (ms):                           104.98
Median ITL (ms):                         25.69
P99 ITL (ms):                            397.17
==================================================

# random 2K input
============ Serving Benchmark Result ============
Successful requests:                     500
Benchmark duration (s):                  113.32
Total input tokens:                      999120
Total generated tokens:                  49103
Request throughput (req/s):              4.41
Output token throughput (tok/s):         433.30
Peak output token throughput (tok/s):    1893.00
Peak concurrent requests:                500.00
Total Token throughput (tok/s):          9249.89
---------------Time to First Token----------------
Mean TTFT (ms):                          55458.38
Median TTFT (ms):                        56144.82
P99 TTFT (ms):                           110079.18
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms):                          117.85
Median TPOT (ms):                        125.32
P99 TPOT (ms):                           135.13
---------------Inter-token Latency----------------
Mean ITL (ms):                           125.08
Median ITL (ms):                         31.45
P99 ITL (ms):                            575.36
==================================================

# random 128 input
============ Serving Benchmark Result ============
Successful requests:                     1000
Benchmark duration (s):                  12.22
Total input tokens:                      127755
Total generated tokens:                  4000
Request throughput (req/s):              81.86
Output token throughput (tok/s):         327.44
Peak output token throughput (tok/s):    360.00
Peak concurrent requests:                1000.00
Total Token throughput (tok/s):          10785.60
---------------Time to First Token----------------
Mean TTFT (ms):                          6900.44
Median TTFT (ms):                        6888.59
P99 TTFT (ms):                           11990.00
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms):                          301.66
Median TPOT (ms):                        320.19
P99 TPOT (ms):                           323.93
---------------Inter-token Latency----------------
Mean ITL (ms):                           452.71
Median ITL (ms):                         327.62
P99 ITL (ms):                            652.15
==================================================

# ShareGPT batch size 4
============ Serving Benchmark Result ============
Successful requests:                     100
Maximum request concurrency:             4
Benchmark duration (s):                  62.98
Total input tokens:                      22946
Total generated tokens:                  21691
Request throughput (req/s):              1.59
Output token throughput (tok/s):         344.39
Peak output token throughput (tok/s):    387.00
Peak concurrent requests:                11.00
Total Token throughput (tok/s):          708.71
---------------Time to First Token----------------
Mean TTFT (ms):                          71.15
Median TTFT (ms):                        70.23
P99 TTFT (ms):                           131.39
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms):                          11.03
Median TPOT (ms):                        10.78
P99 TPOT (ms):                           15.48
---------------Inter-token Latency----------------
Mean ITL (ms):                           11.07
Median ITL (ms):                         10.49
P99 ITL (ms):                            36.80
==================================================