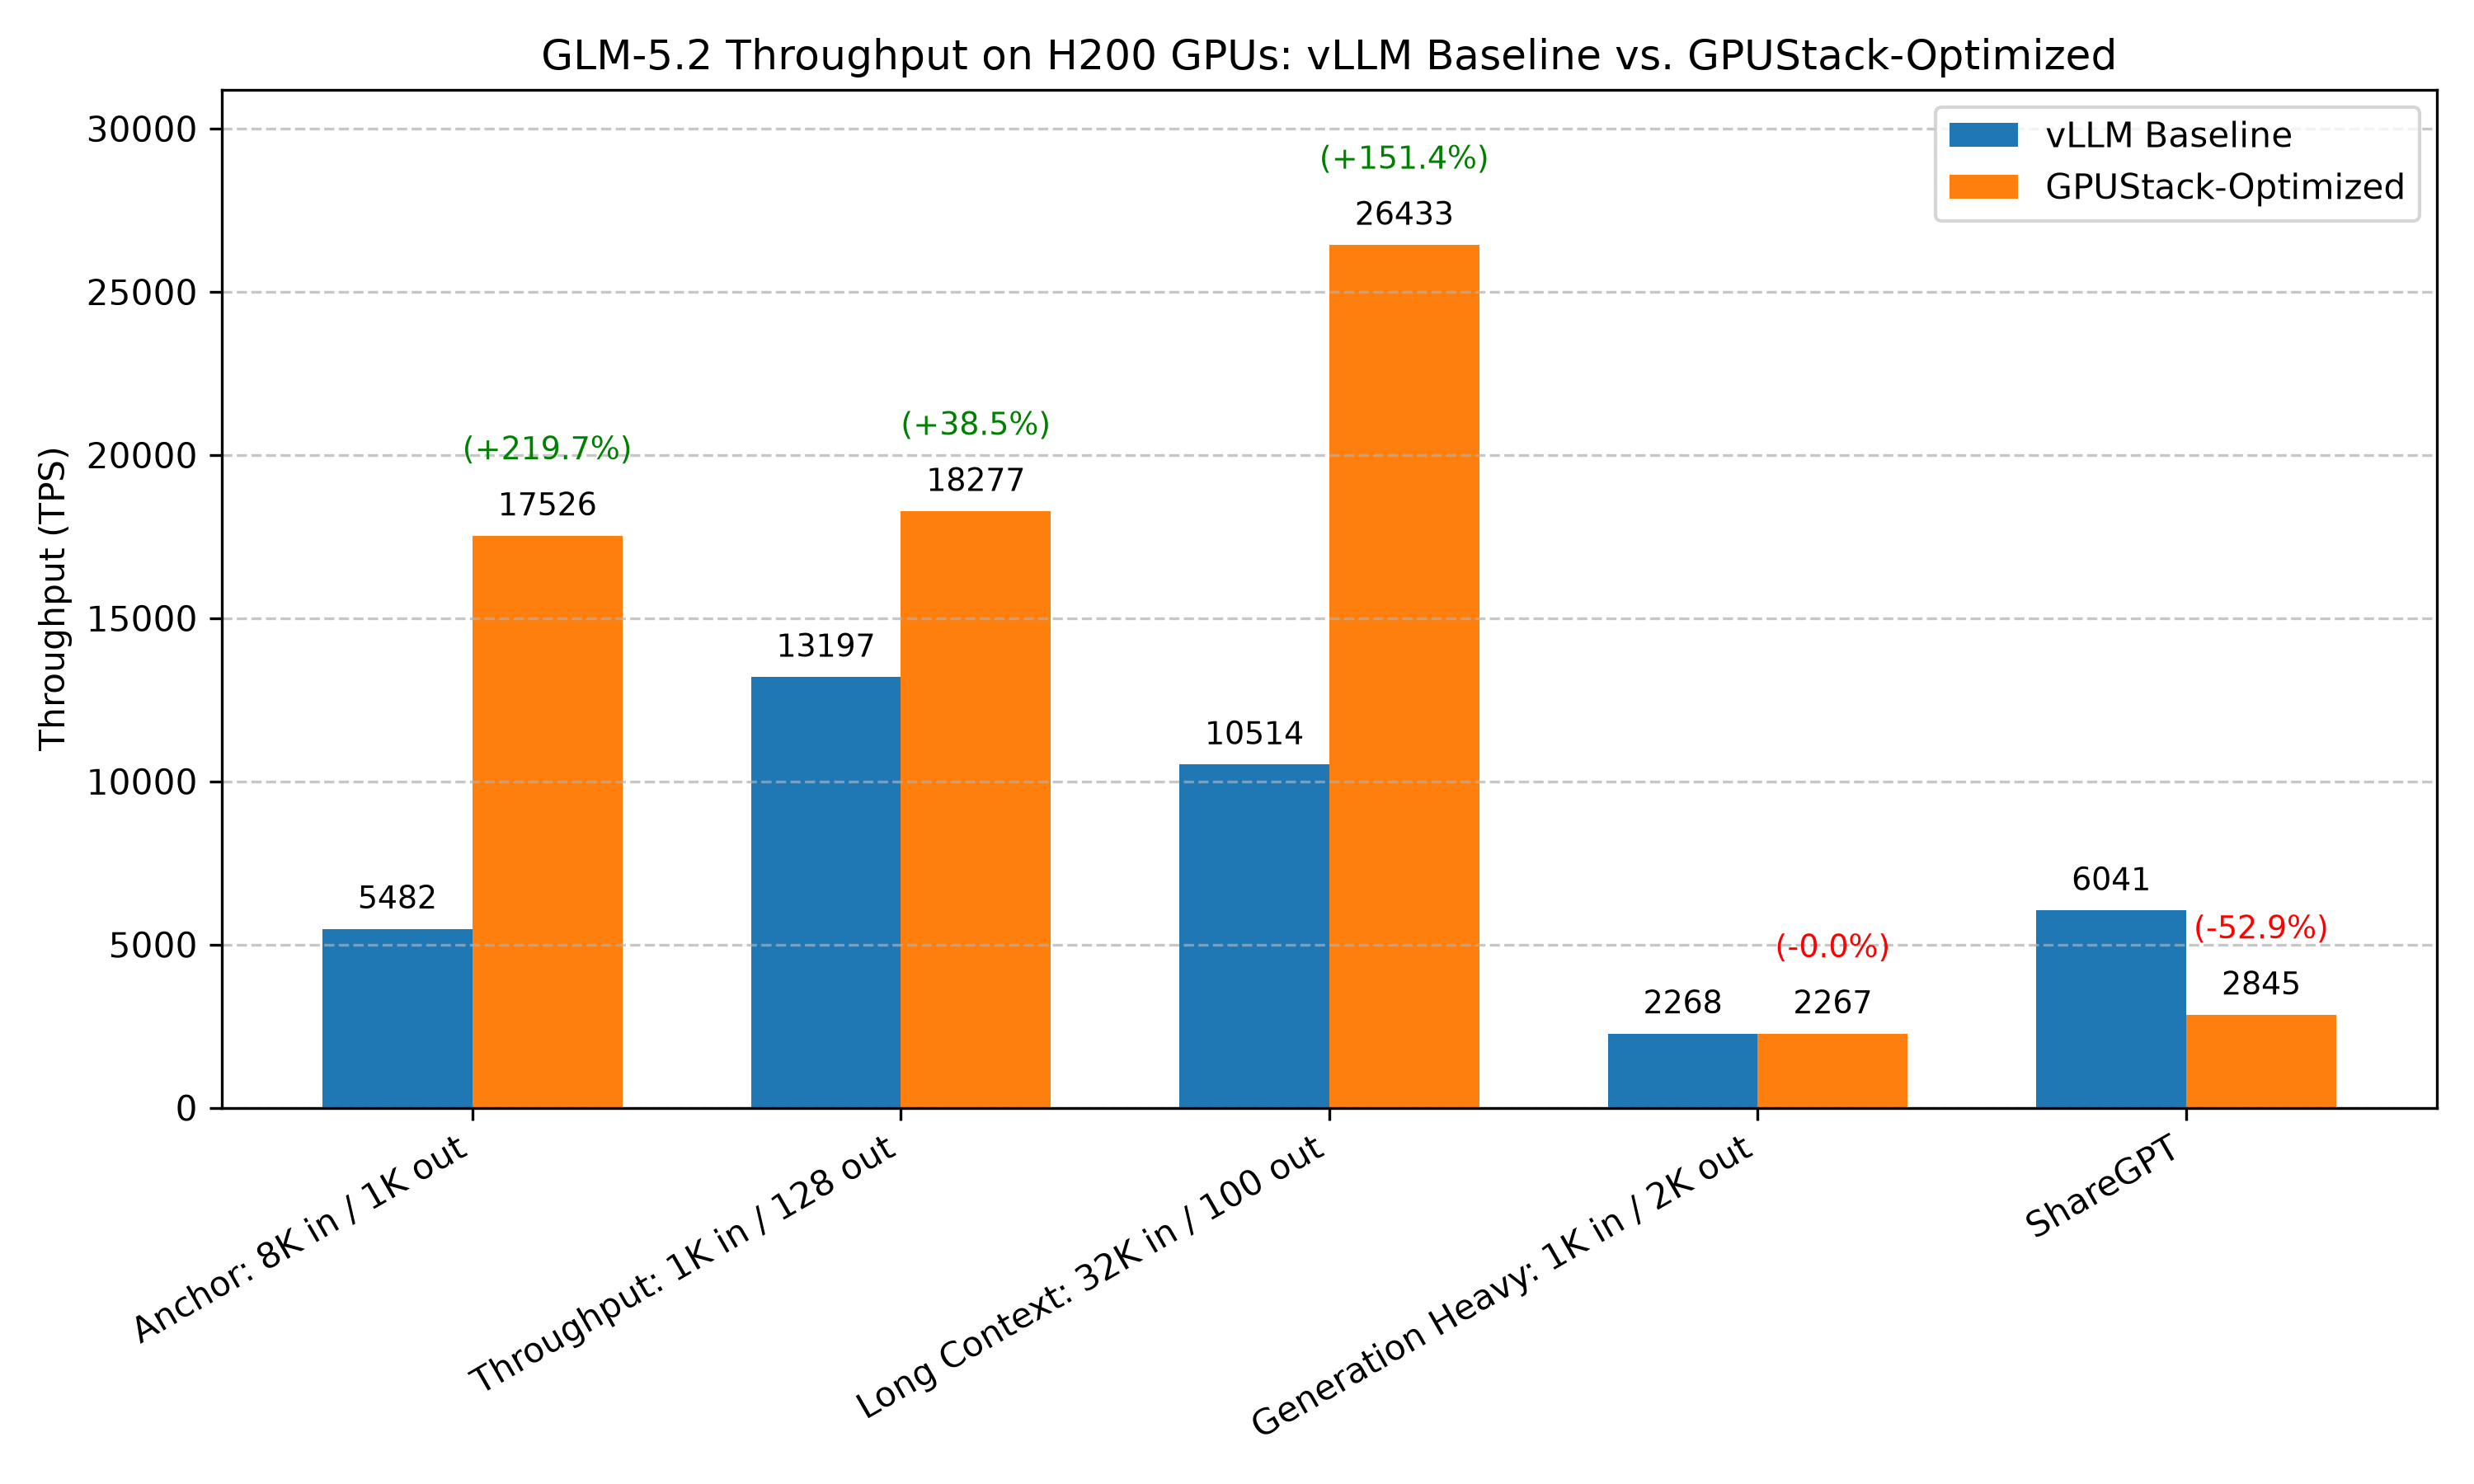
Общий TPS: 17525.76 (+219.70%) Среднее TPOT(ms): 217.89
Короткий контекст (1K входных / 128 выходных)
Общий TPS: 13196.90 Среднее TPOT(ms): 316.73
Общий TPS: 18276.60 (+38.49%) Среднее TPOT(ms): 211.06
Длинный контекст (32K входных / 100 выходных)
Общий TPS: 10513.68 Среднее TPOT(ms): 1320.02
Общий TPS: 26433.15 (+151.42%) Среднее TPOT(ms): 537.26
Интенсивная генерация (1K входных / 2K выходных)
Общий TPS: 2268.18 Среднее TPOT(ms): 42.11
Общий TPS: 2267.33 (-0.04%) Среднее TPOT(ms): 46.54
ShareGPT
Общий TPS: 6040.94 Среднее TPOT(ms): 149.24
Общий TPS: 2845.48 (-52.90%) Среднее TPOT(ms): 331.21
Примечание
Наши бенчмарки не охватывают все возможные сочетания оптимизаций. Например, отправной точкой дальнейшей настройки становится движок инференса с лучшей производительностью при настройках по умолчанию. Такое отсечение вариантов даёт локальный оптимум, который может не совпадать с глобальным.
Есть и другие методы оптимизации, зависящие от сценария использования: максимальный размер батча, настройки планировщика, расширенный KV-кэш, CUDA graph и т. д. Выводы этого документа могут служить отправной точкой для более целенаправленной оптимизации.
Тесты проводились на определённых аппаратных и программных конфигурациях. Развитие движков инференса может привести к новым выводам.
Квантизация может влиять на точность, однако для большинства моделей FP8 обеспечивает снижение точности менее чем на 1%. Подробности см. в результатах оценки. Поэтому для обслуживания с низкой задержкой настоятельно рекомендуется квантизация FP8.
Рекомендуемая конфигурация настроена на высокую конкурентность и входы средней или большой длины (опорная нагрузка: 8K входных / 1K выходных токенов). В диалоговых нагрузках с короткими входами и выходами, таких как ShareGPT, она уступает обычному тензорному параллелизму: оптимизации DP-attention и DeepEP рассчитаны на длинные последовательности, а короткие запросы не компенсируют их накладные расходы (см. ShareGPT в разделе других бенчмарков). Этот компромисс подходит целевому применению GLM-5.2: сильные возможности программирования делают обслуживание агентов разработки основным сценарием, где контекст преимущественно длинный — именно на него и рассчитана эта конфигурация.
Если что-то упущено или требуется обновление с учётом новых изменений, сообщите нам.
Условия эксперимента
Модель
zai-org/GLM-5.2-FP8
Оборудование
NVIDIA H200x8
Версия движка
vLLM v0.24.0
SGLang v0.5.14
Методика бенчмарка
В этом проекте используется функция запуска бенчмарка GPUStack одним щелчком для нагрузок обслуживания моделей. Бенчмарки этого документа выполнялись именно таким способом.
============ Serving Benchmark Result ============
Successful requests:                     1000
Maximum request concurrency:             512
Benchmark duration (s):                  1425.58
Total input tokens:                      8204000
Total generated tokens:                  1024000
Request throughput (req/s):              0.70
Output token throughput (tok/s):         719.90
Peak output token throughput (tok/s):    36770.60
Peak concurrent requests:                512.00
Total Token throughput (tok/s):          6487.53
----------------------Latency---------------------
Mean Latency(s):                          553.77
Median Latency(s):                        674.98
P95 Latency(s):                           738.28
P99 Latency(s):                           1087.06
---------------Time to First Token----------------
Mean TTFT (ms):                          499353.08
Median TTFT (ms):                        640537.31
P95 TTFT (ms):                           692823.09
P99 TTFT (ms):                           694859.54
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms):                          540.79
Median TPOT (ms):                        659.16
P95 TPOT (ms):                           720.97
P99 TPOT (ms):                           1061.58
---------------Inter-token Latency----------------
Mean ITL (ms):                           53.19
Median ITL (ms):                         41.87
P95 ITL (ms):                            53.14
P99 ITL (ms):                            661.38
==================================================
Итог: SGLang Общий TPS = 6487.53, vLLM Общий TPS = 5481.90. SGLang быстрее на 1005.62 tok/s (18.34%); Среднее TPOT = 540.79 ms против 636.24 ms, снижение на 95.45 ms (15.00%).
============ Serving Benchmark Result ============
Successful requests:                     1000
Maximum request concurrency:             512
Benchmark duration (s):                  1430.76
Total input tokens:                      8204000
Total generated tokens:                  1024000
Request throughput (req/s):              0.70
Output token throughput (tok/s):         724.90
Peak output token throughput (tok/s):    36964.00
Peak concurrent requests:                512.00
Total Token throughput (tok/s):          6532.56
----------------------Latency---------------------
Mean Latency(s):                          546.29
Median Latency(s):                        710.24
P95 Latency(s):                           716.16
P99 Latency(s):                           716.23
---------------Time to First Token----------------
Mean TTFT (ms):                          509145.51
Median TTFT (ms):                        672291.77
P95 TTFT (ms):                           682441.07
P99 TTFT (ms):                           682611.26
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms):                          533.49
Median TPOT (ms):                        693.59
P95 TPOT (ms):                           699.37
P99 TPOT (ms):                           699.44
---------------Inter-token Latency----------------
Mean ITL (ms):                           36.31
Median ITL (ms):                         35.36
P95 ITL (ms):                            40.52
P99 ITL (ms):                            40.69
==================================================
Итог: TP + DP + DP-Attention Общий TPS = 7011.17, TP + DP-Attention Общий TPS = 6371.59. TP + DP + DP-Attention быстрее на 639.58 tok/s (10.04%); Среднее TPOT = 497.48 ms против 553.48 ms, снижение на 56.00 ms (10.12%).
============ Serving Benchmark Result ============
Successful requests:                     1000
Maximum request concurrency:             512
Benchmark duration (s):                  688.60
Total input tokens:                      8204000
Total generated tokens:                  1024000
Request throughput (req/s):              1.45
Output token throughput (tok/s):         1527.01
Peak output token throughput (tok/s):    46500.08
Peak concurrent requests:                512.00
Total Token throughput (tok/s):          13760.98
----------------------Latency---------------------
Mean Latency(s):                          273.29
Median Latency(s):                        272.67
P95 Latency(s):                           362.52
P99 Latency(s):                           488.73
---------------Time to First Token----------------
Mean TTFT (ms):                          201642.60
Median TTFT (ms):                        219374.83
P95 TTFT (ms):                           293139.84
P99 TTFT (ms):                           297529.93
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms):                          266.89
Median TPOT (ms):                        266.28
P95 TPOT (ms):                           354.02
P99 TPOT (ms):                           477.28
---------------Inter-token Latency----------------
Mean ITL (ms):                           70.04
Median ITL (ms):                         65.72
P95 ITL (ms):                            85.73
P99 ITL (ms):                            276.51
==================================================
Итог: 0.85 Общий TPS = 13760.98, auto Общий TPS = 5881.79. 0.85 быстрее на 7879.19 tok/s (133.96%); Среднее TPOT = 266.89 ms против 594.26 ms, снижение на 327.38 ms (55.09%).
============ Serving Benchmark Result ============
Successful requests:                     1000
Maximum request concurrency:             512
Benchmark duration (s):                  689.11
Total input tokens:                      8204000
Total generated tokens:                  1024000
Request throughput (req/s):              1.45
Output token throughput (tok/s):         1526.75
Peak output token throughput (tok/s):    52394.68
Peak concurrent requests:                512.00
Total Token throughput (tok/s):          13758.60
----------------------Latency---------------------
Mean Latency(s):                          273.27
Median Latency(s):                        272.75
P95 Latency(s):                           362.79
P99 Latency(s):                           489.22
---------------Time to First Token----------------
Mean TTFT (ms):                          201640.48
Median TTFT (ms):                        219319.19
P95 TTFT (ms):                           293076.86
P99 TTFT (ms):                           297429.96
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms):                          266.86
Median TPOT (ms):                        266.36
P95 TPOT (ms):                           354.28
P99 TPOT (ms):                           477.76
---------------Inter-token Latency----------------
Mean ITL (ms):                           70.02
Median ITL (ms):                         65.70
P95 ITL (ms):                            85.80
P99 ITL (ms):                            276.29
==================================================
Итог: default Общий TPS = 13760.98, 8K Общий TPS = 13758.60. default быстрее на 2.37 tok/s (0.02%); Среднее TPOT = 266.89 ms против 266.86 ms, увеличение на 0.03 ms (0.01% медленнее).
Нехватка памяти при большом блоке prefill
Установка --chunked-prefill-size в 16384 или 32768 вызывает сбой из-за нехватки памяти в этой конфигурации. Больший размер блока увеличивает резерв для активаций, который планировщик памяти вычитает из бюджета KV-кэша; оставшейся памяти недостаточно для весов FP8 размера ~700B вместе с KV-кэшем. Работают только 8192 и значение по умолчанию; различие между ними находится в пределах шума. При входе 8K размер блока prefill не даёт прироста пропускной способности, поэтому в рекомендуемой конфигурации оставлен по умолчанию.
============ Serving Benchmark Result ============
Successful requests:                     1000
Maximum request concurrency:             512
Benchmark duration (s):                  666.14
Total input tokens:                      8204000
Total generated tokens:                  1024000
Request throughput (req/s):              1.50
Output token throughput (tok/s):         1581.39
Peak output token throughput (tok/s):    38164.10
Peak concurrent requests:                512.00
Total Token throughput (tok/s):          14251.08
----------------------Latency---------------------
Mean Latency(s):                          265.47
Median Latency(s):                        292.45
P95 Latency(s):                           368.40
P99 Latency(s):                           482.40
---------------Time to First Token----------------
Mean TTFT (ms):                          203755.52
Median TTFT (ms):                        239495.62
P95 TTFT (ms):                           301525.04
P99 TTFT (ms):                           304478.79
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms):                          259.25
Median TPOT (ms):                        285.59
P95 TPOT (ms):                           359.76
P99 TPOT (ms):                           471.09
---------------Inter-token Latency----------------
Mean ITL (ms):                           60.33
Median ITL (ms):                         54.22
P95 ITL (ms):                            70.59
P99 ITL (ms):                            291.22
==================================================
Итог: max-running 256 Общий TPS = 14451.05, max-running 64 Общий TPS = 9959.18. max-running 256 быстрее на 4491.87 tok/s (45.10%); Среднее TPOT = 255.63 ms против 359.30 ms, снижение на 103.67 ms (28.85%).
============ Serving Benchmark Result ============
Successful requests:                     1000
Maximum request concurrency:             512
Benchmark duration (s):                  2722.41
Total input tokens:                      8204000
Total generated tokens:                  1024000
Request throughput (req/s):              0.37
Output token throughput (tok/s):         378.79
Peak output token throughput (tok/s):    63639.56
Peak concurrent requests:                512.00
Total Token throughput (tok/s):          3413.56
----------------------Latency---------------------
Mean Latency(s):                          1084.11
Median Latency(s):                        1206.16
P95 Latency(s):                           1510.02
P99 Latency(s):                           1897.83
---------------Time to First Token----------------
Mean TTFT (ms):                          773983.92
Median TTFT (ms):                        924140.14
P95 TTFT (ms):                           1214572.96
P99 TTFT (ms):                           1217017.99
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms):                          1058.70
Median TPOT (ms):                        1177.89
P95 TPOT (ms):                           1474.63
P99 TPOT (ms):                           1853.35
---------------Inter-token Latency----------------
Mean ITL (ms):                           303.15
Median ITL (ms):                         277.82
P95 ITL (ms):                            294.11
P99 ITL (ms):                            1229.38
==================================================
Итог: auto Общий TPS = 14451.05, normal Общий TPS = 3413.56. auto быстрее на 11037.49 tok/s (323.34%); Среднее TPOT = 255.63 ms против 1058.70 ms, снижение на 803.07 ms (75.85%).
============ Serving Benchmark Result ============
Successful requests:                     1000
Maximum request concurrency:             512
Benchmark duration (s):                  539.39
Total input tokens:                      8204000
Total generated tokens:                  1024000
Request throughput (req/s):              1.85
Output token throughput (tok/s):         1944.77
Peak output token throughput (tok/s):    60301.69
Peak concurrent requests:                512.00
Total Token throughput (tok/s):          17525.76
----------------------Latency---------------------
Mean Latency(s):                          223.12
Median Latency(s):                        219.64
P95 Latency(s):                           327.25
P99 Latency(s):                           327.80
---------------Time to First Token----------------
Mean TTFT (ms):                          143076.43
Median TTFT (ms):                        151142.06
P95 TTFT (ms):                           234645.47
P99 TTFT (ms):                           239552.62
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms):                          217.89
Median TPOT (ms):                        214.49
P95 TPOT (ms):                           319.58
P99 TPOT (ms):                           320.12
---------------Inter-token Latency----------------
Mean ITL (ms):                           78.24
Median ITL (ms):                         74.83
P95 ITL (ms):                            105.11
P99 ITL (ms):                            217.21
==================================================
Итог: fp8_e4m3 Общий TPS = 17525.76, bf16 Общий TPS = 14451.05. fp8_e4m3 быстрее на 3074.72 tok/s (21.28%); Среднее TPOT = 217.89 ms против 255.63 ms, снижение на 37.74 ms (14.76%).
Проверка точности KV-кэша FP8 (GSM8K)
На Hopper KV-кэш FP8 не используется по умолчанию (SGLang автоматически выбирает bf16); он повышает пропускную способность только при ограничении KV-кэшем — высокой конкурентности и длинном контексте. Чтобы проверить отсутствие ухудшения качества, мы провели контрольный тест GSM8K (200 примеров, режим размышлений выключен, жадное декодирование):
Тип данных KV
Оценка GSM8K
bf16
0.975
fp8_e4m3
0.980
Разница находится в пределах шума (~1 вопрос / 200), то есть измеримого снижения точности не обнаружено. Тем не менее проверьте точность на своей нагрузке, особенно с длинным контекстом, где ошибка квантизации FP8 может накапливаться.
Сводка методов оптимизации
Сценарии бенчмарка
После оптимизации
Базовая конфигурация
Выбор движка инференса
Общий TPS: 6487.53 (+18.34%) Среднее TPOT(ms): 540.79
Общий TPS: 5481.90 Среднее TPOT(ms): 636.24
Стратегия параллелизма
Общий TPS: 7011.17 (+27.90%) Среднее TPOT(ms): 497.48
Общий TPS: 5481.90 Среднее TPOT(ms): 636.24
Доля памяти
Общий TPS: 13760.98 (+151.03%) Среднее TPOT(ms): 266.89
Общий TPS: 5481.90 Среднее TPOT(ms): 636.24
Размер блока prefill
Общий TPS: 13760.98 (+151.03%) Среднее TPOT(ms): 266.89
Общий TPS: 5481.90 Среднее TPOT(ms): 636.24
DeepEP и максимум одновременных запросов
Общий TPS: 14451.05 (+163.61%) Среднее TPOT(ms): 255.63
Общий TPS: 5481.90 Среднее TPOT(ms): 636.24
Режим DeepEP
Общий TPS: 14451.05 (+163.61%) Среднее TPOT(ms): 255.63
Общий TPS: 5481.90 Среднее TPOT(ms): 636.24
Тип данных KV-кэша
Общий TPS: 17525.76 (+219.70%) Среднее TPOT(ms): 217.89