カスタム推論バックエンドの利用
このガイドでは、GPUStack にカスタム推論バックエンドを追加する方法を説明します。検証済みのコミュニティ設定の利用と、独自の設定の作成を扱います。
パラメーターの説明は、ユーザーガイドをご覧ください。
バックエンドの種類
GPUStack は、3 種類の推論バックエンドに対応します。
- 組み込み:GPUStack が管理する事前設定済みのバックエンド(vLLM、MindIE、VoxBox、SGLang など)。ハードウェアに応じて自動最適化されます。
- コミュニティ:検証済みのカスタムバックエンド設定。実体は「community」ラベル付きの CustomBackend で、手動セットアップを簡単にします。
- カスタム:独自の Docker イメージとコマンドで設定するバックエンド。
コミュニティバックエンドの利用
コミュニティバックエンドなら、一般的な推論エンジンを素早く追加できます。
手順:
- Inference Backend ページで「Add Backend」をクリックします。
- 「Community」を選択します。
- 「Community Backend Marketplace」を参照し、必要なバックエンドを有効化します。
カスタムバックエンドの作成
基本手順
- 必要な推論バックエンドの Docker イメージを用意します。
- イメージの ENTRYPOINT または CMD を理解し、起動コマンドを決定します。
- Inference Backend ページで設定を追加します。
- モデルのデプロイ時に、新しいバックエンドを選択します。
例:TensorRT-LLM
TensorRT-LLM を例に、バックエンドの追加と利用を説明します。
以下は機能の実演用であり、性能を最適化した設定ではありません。性能調整は各バックエンドの公式ドキュメントを確認してください。
- TensorRT-LLM ドキュメントからリンクされたリリースページで、必要なイメージを探します。
- TensorRT-LLM イメージは、
trtllm-serveで推論サービスを起動する必要があります。指定しないと対話シェルになります。run_commandは{{model_path}}、{{port}}(必要に応じて{{model_name}}、{{worker_ip}}、{{gpu_count}}、{{gpu_ids}})などのプレースホルダーに対応し、ワーカーへの配置時に実際の値へ置換されます。{{gpu_count}}と{{gpu_ids}}は配置先ワーカーに割り当てられた GPU を示します(カスタムバックエンドは単一ワーカーで動作します)。 -
Inference Backend ページで設定を追加します。YAML のインポートにも対応しています。例:
-
Deployments ページで新しいバックエンドを選び、モデルをデプロイします。
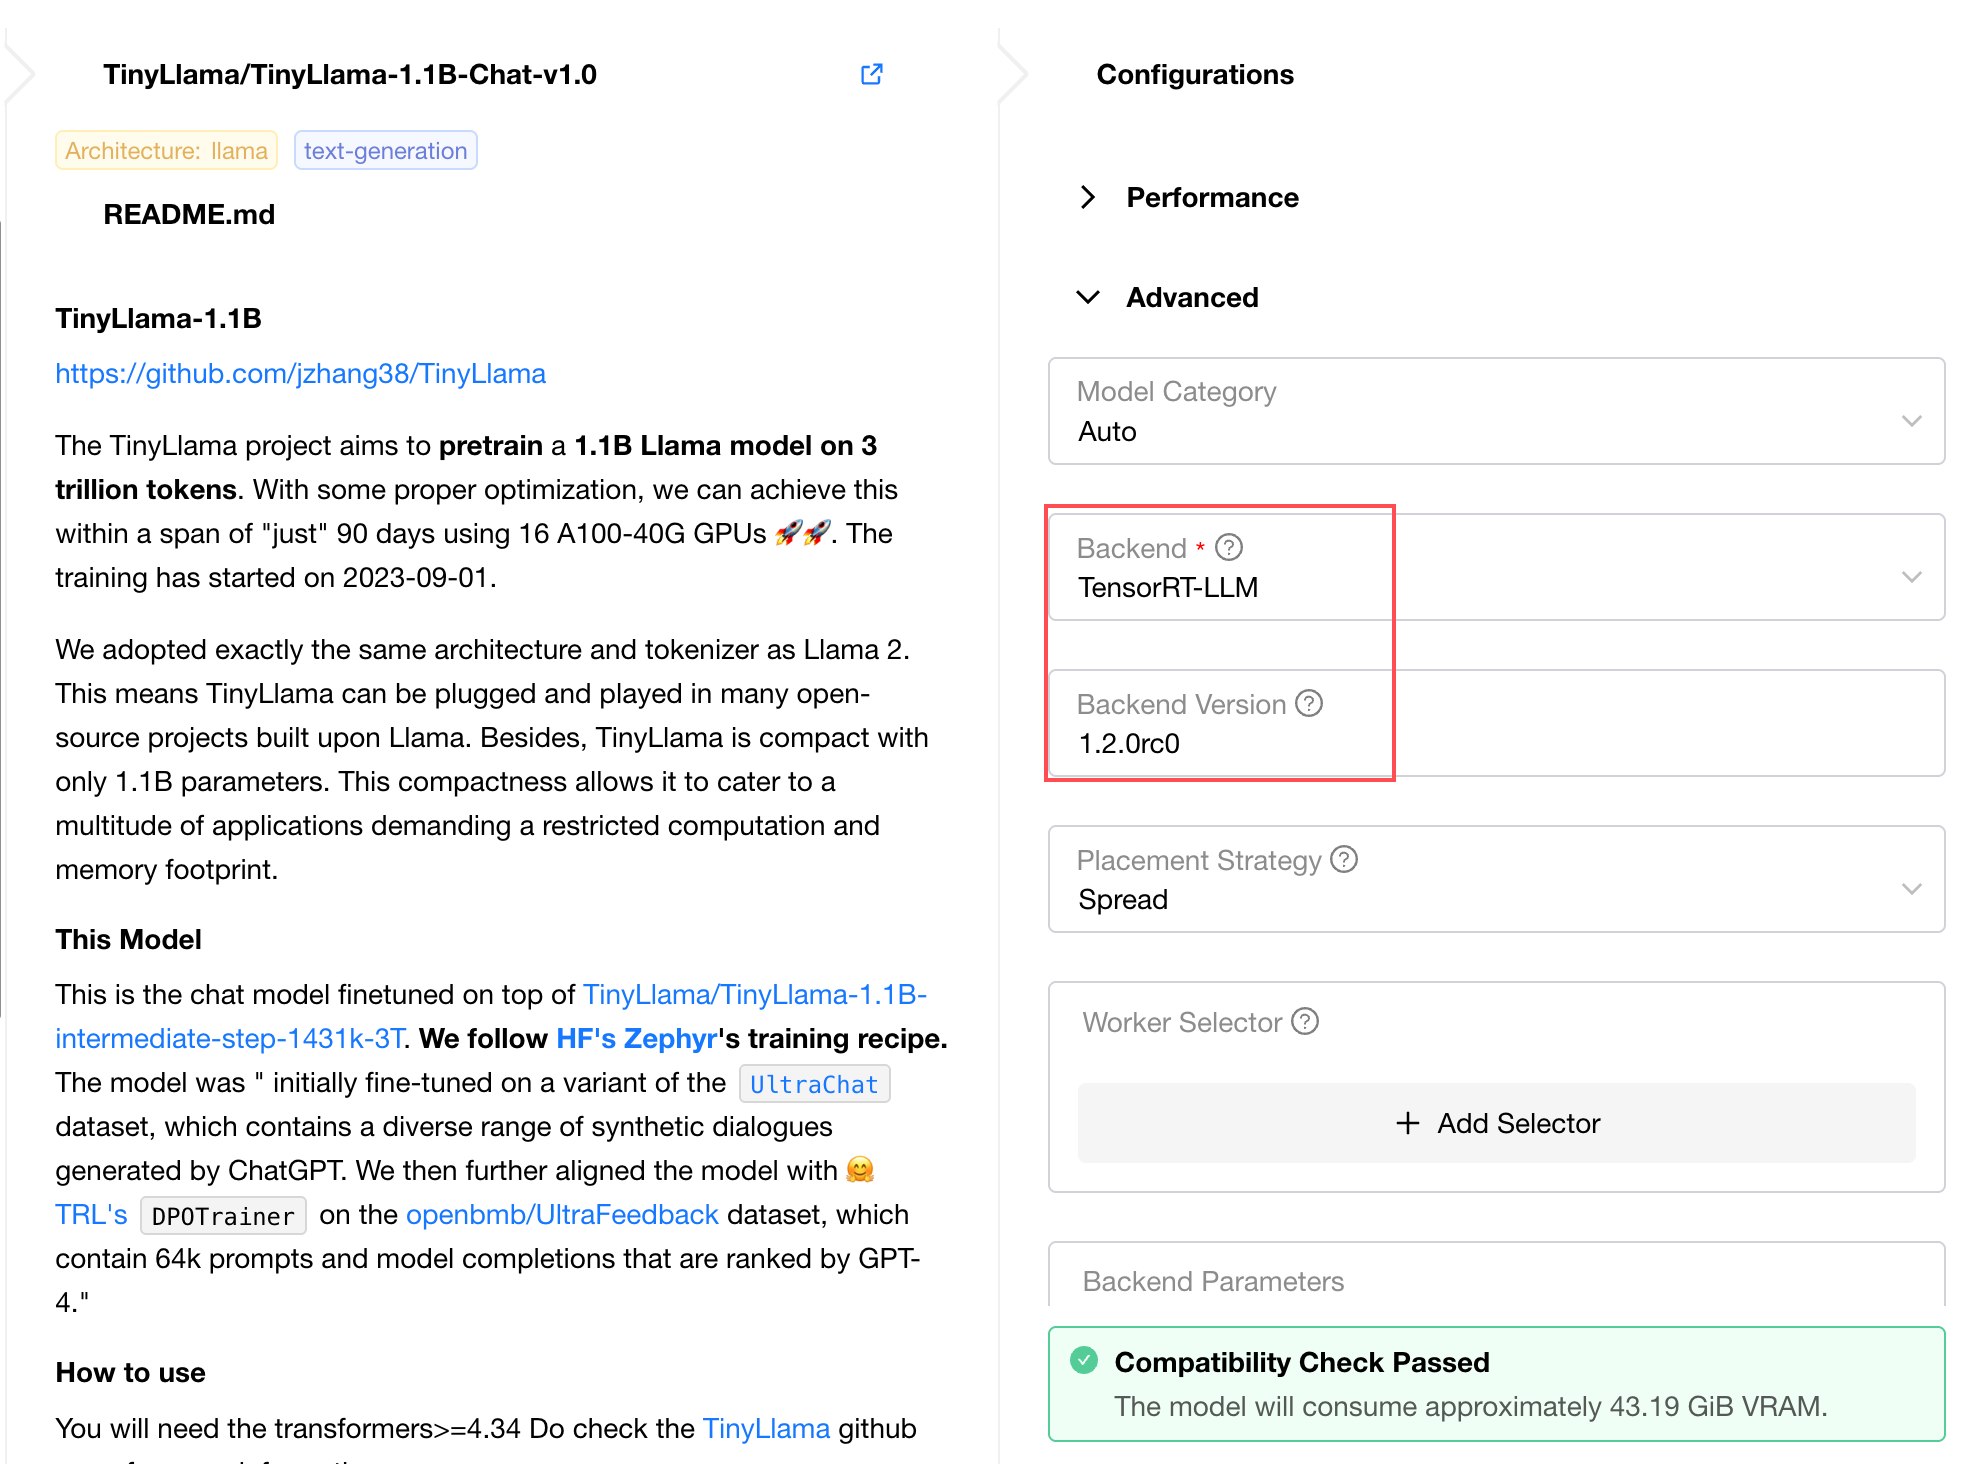
結果
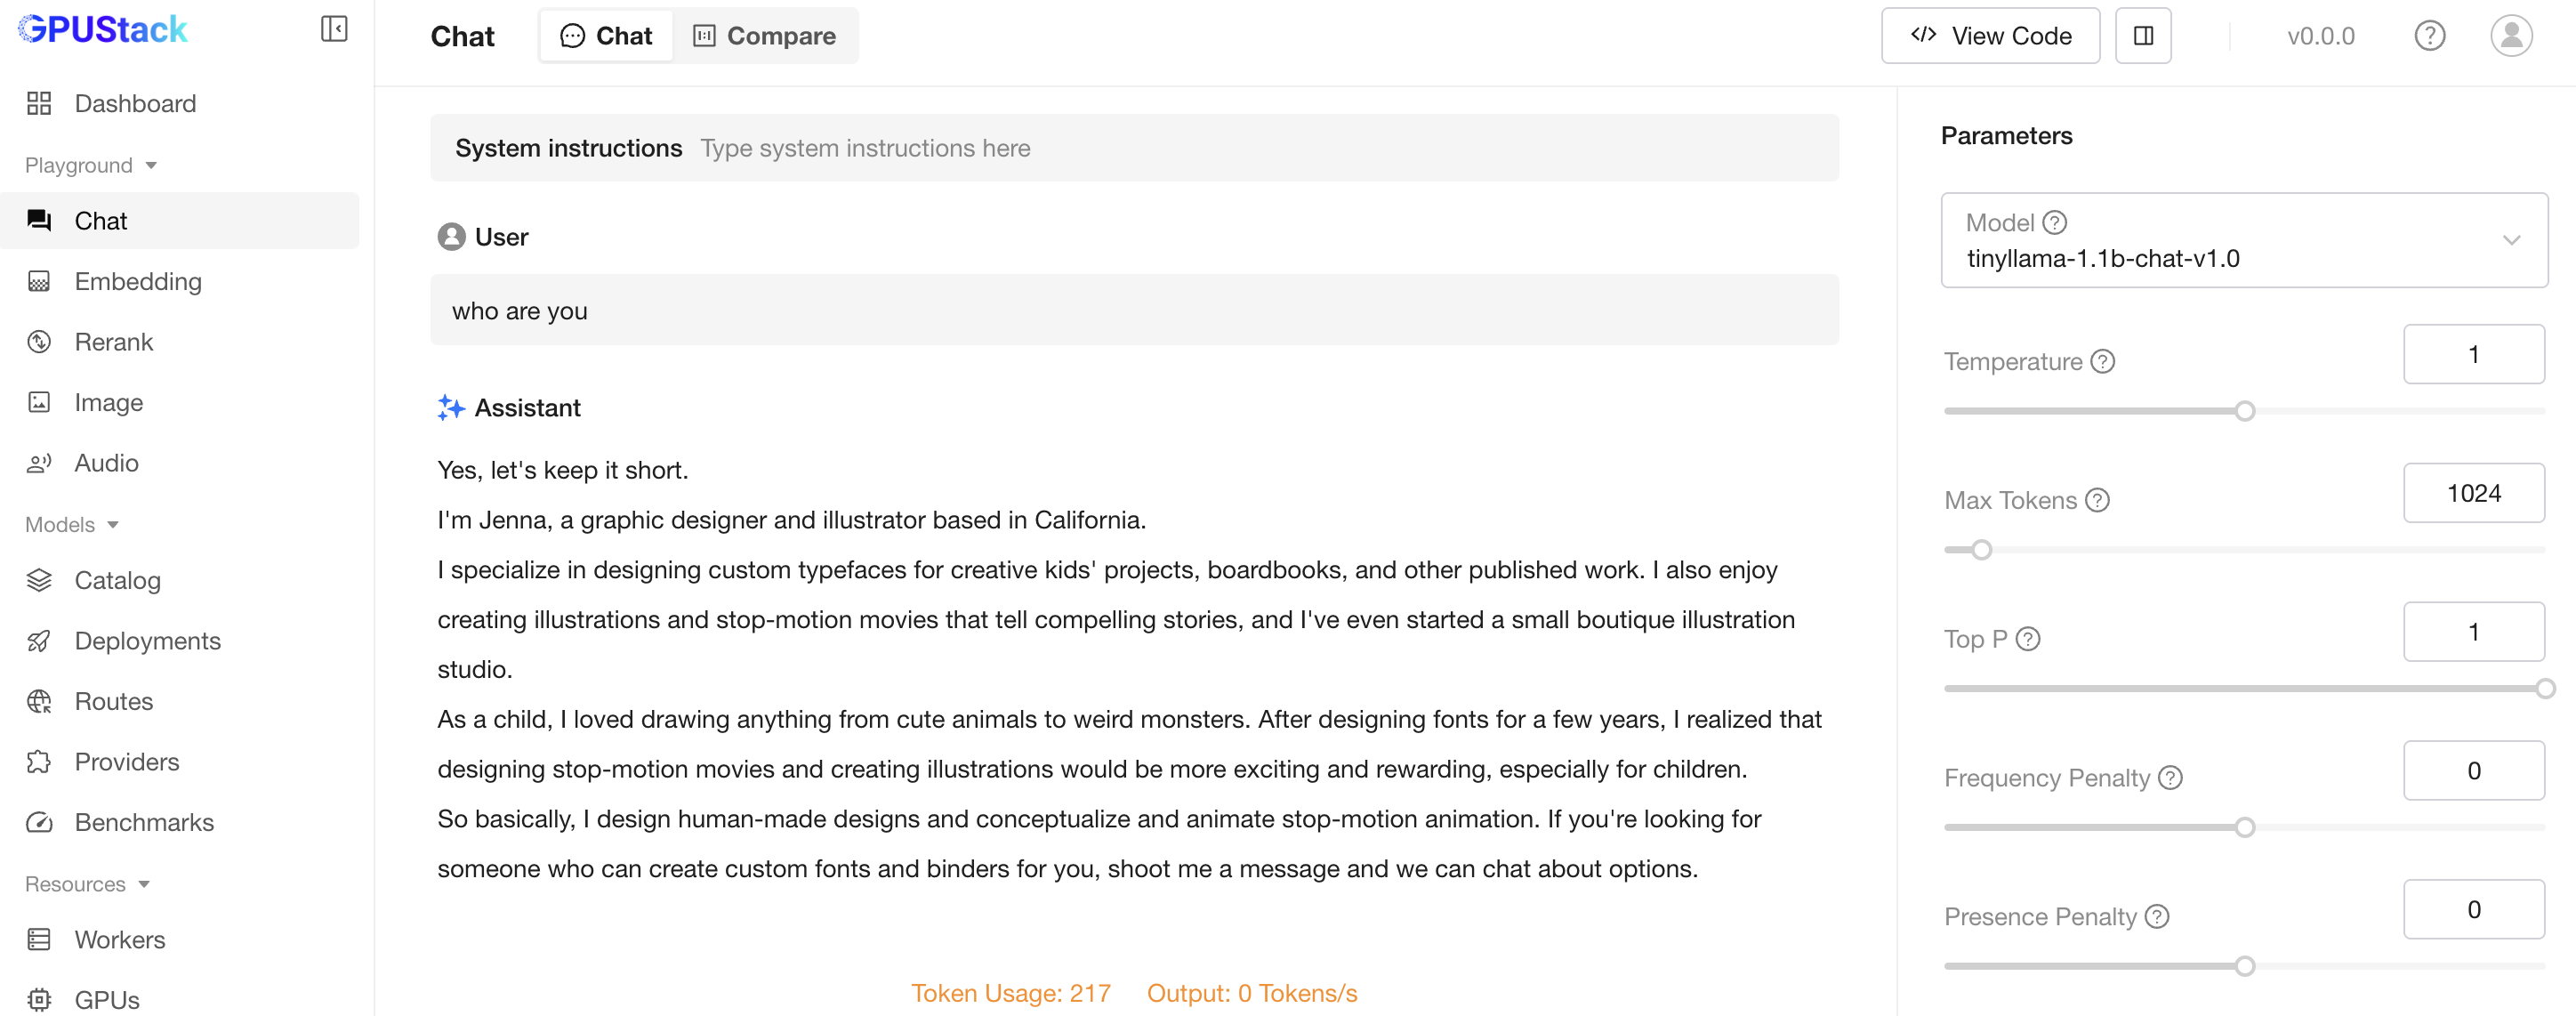
推論バックエンドのサービスが起動すると、model_instance の状態が RUNNING になります。 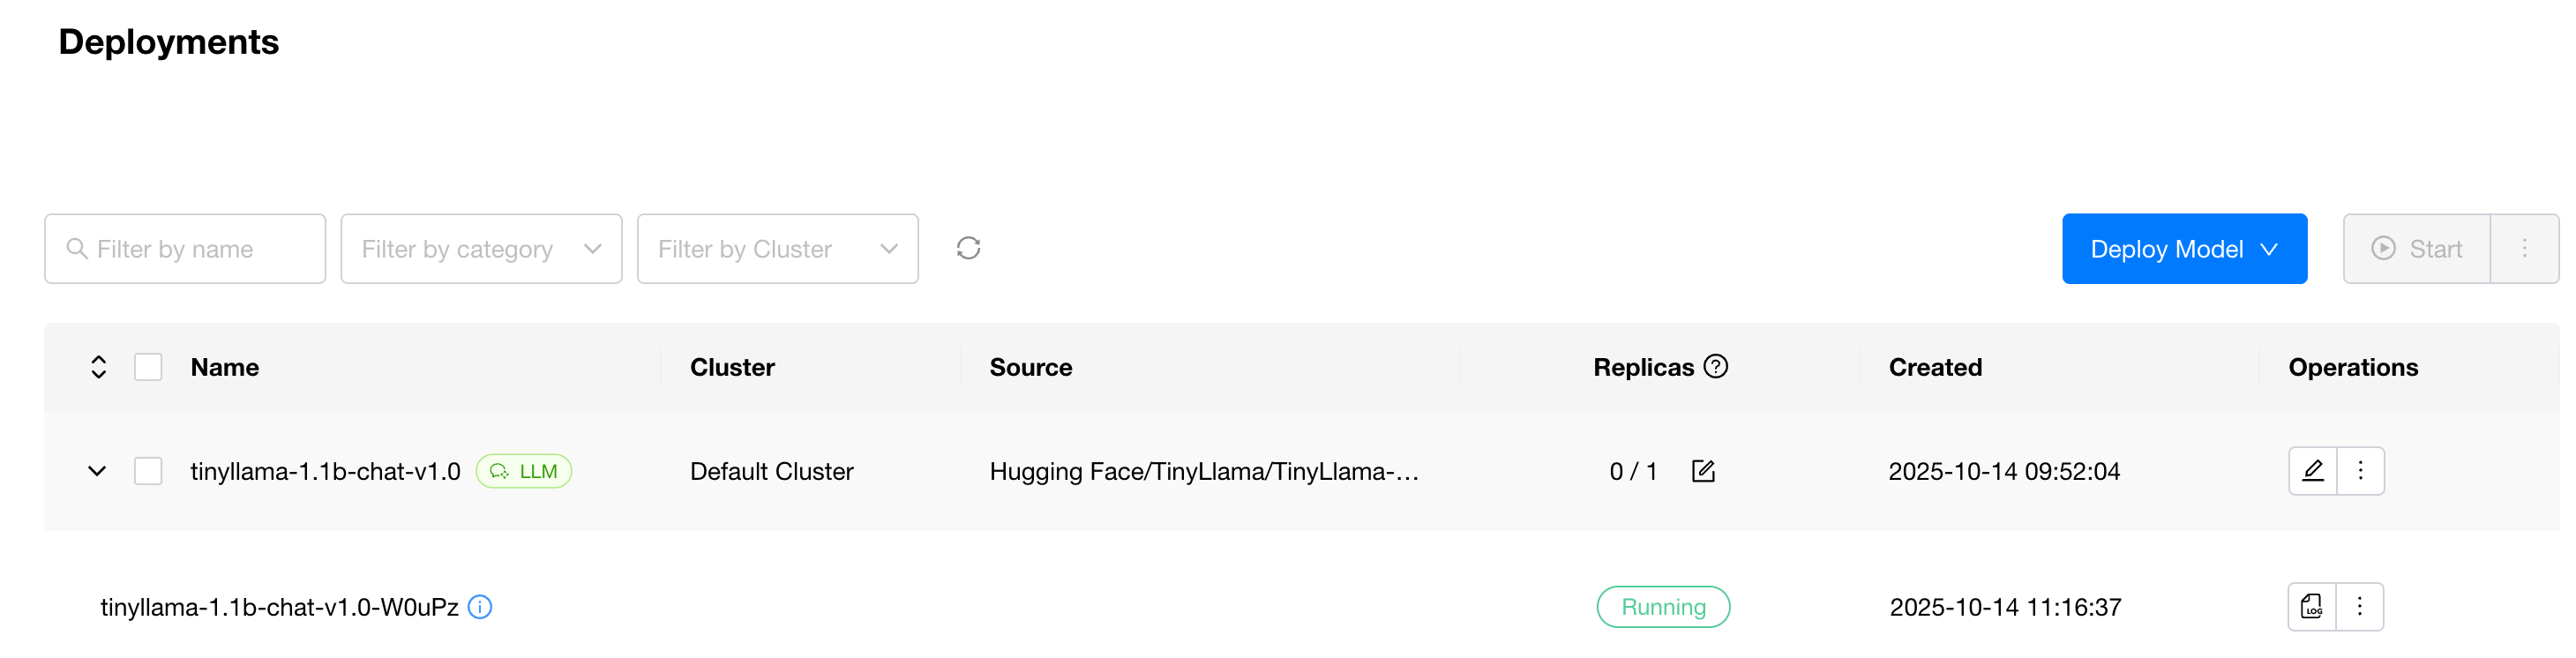 Playground で会話できます。
高度な設定
環境変数の使用
環境変数を使うと、コマンドに値を埋め込まず柔軟に設定できます。
この例では: - バックエンドレベルで CACHE_DIR と LOG_LEVEL を定義します。 - バージョン v1 が LOG_LEVEL を debug に上書きします。 - コマンド内では両方とも {{VAR_NAME}} 構文で参照します。
カスタムエントリーポイント
独自の初期化が必要なイメージでは、デフォルトのエントリーポイントを上書きします。バックエンドとバージョンの両レベルで設定できます。