LoRA アダプターによるモデル提供
LoRA(Low-Rank Adaptation)は、小さなアダプターファイルを読み込むことで、全重みを再学習せずに基盤モデルを特定分野に適応させる、パラメーター効率の高いファインチューニング手法です。
GPUStack は、デプロイ済みの基盤 LLM に複数の LoRA アダプターをマウントし、各アダプターのモデルルートを自動作成できます。呼び出し側は、OpenAI 互換の model フィールドを対応するルート名にするだけで、要求ごとに切り替えられます。各調整モデルに別の GPU を割り当てる必要はありません。
このチュートリアルでは、vLLM、SGLang、Ascend MindIE で単一の基盤モデルに複数アダプターを追加し、OpenAI 互換 API から指定して呼び出す方法を説明します。
注記
LoRA は現在、vLLM、SGLang、Ascend MindIE にのみ対応しています。ほかのバックエンドでは lora_list を無視します。
前提条件
次の条件を満たしていることを確認します。
- GPUStack がインストール済みで稼働していること。
- GPU を搭載した Linux ワーカーノードがあること。基盤モデルは
Qwen3-8Bのため、8B モデルの提供に十分なメモリー(例:24 GB 以上)が必要です。2 つのアダプターは同じインスタンスを共有し、追加メモリーは少量です。 - モデルとアダプターのファイルを取得するために Hugging Face にアクセスできること。
この例では、単一の基盤モデルに 2 つの LoRA アダプターをマウントし、要求ごとの切り替えを確認します。設定は次のとおりです。
| 項目 | このチュートリアルの値 |
|---|---|
| モデルソース | Hugging Face |
| バックエンド | vLLM |
| 基盤モデル | Qwen/Qwen3-8B |
| LoRA アダプター 1 | AMaslovskyi/qwen-devops-foundation-lora(名前は devops) |
| LoRA アダプター 2 | XinyuanWang/qwen3-8b-medical-lora(名前は medical) |
両アダプターは Qwen/Qwen3-8B を基盤モデルとして宣言しています。これは必須条件で、1 つのデプロイメントにマウントする全アダプターは同じ基盤モデルを使う必要があります。
ヒント
この例を完了した後は、ソースを ModelScope や Local Path、バックエンドを SGLang や Ascend MindIE に置き換え、独自の基盤モデルとアダプターを使えます。バックエンドごとの差異は、バックエンドの互換性と制限をご覧ください。
手順 1:LoRA アダプター付き基盤モデルのデプロイ
DeploymentsページでDeploy Modelをクリックし、ソースにHugging Faceを選択します。- 検索欄に
Qwen/Qwen3-8Bと入力し、結果から選択します。 - バックエンドを
vLLMにします。 -
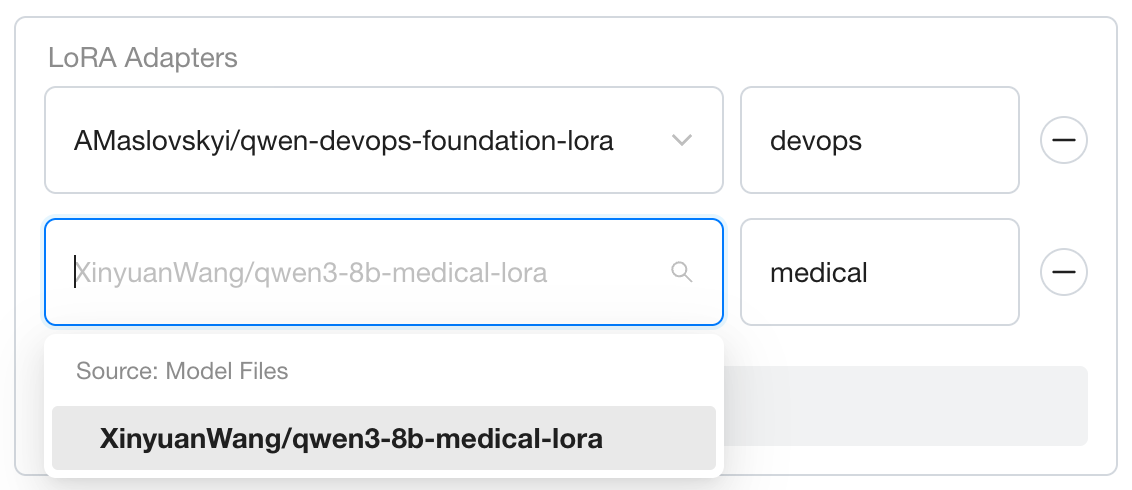
Advancedを展開し、LoRA Adaptersに最初のアダプターを追加します。- アダプターのドロップダウンで
AMaslovskyi/qwen-devops-foundation-loraを入力・選択します。 LoRA nameにdevopsを入力します。
- アダプターのドロップダウンで
-
2 つ目のアダプターを追加します。
- アダプターのドロップダウンで
XinyuanWang/qwen3-8b-medical-loraを入力・選択します。 LoRA nameにmedicalを入力します。
- アダプターのドロップダウンで
-
Saveをクリックしてデプロイを完了します。
注記
基盤モデルの接頭辞を付けず、アダプター名(devops、medical)だけを入力します。GPUStack は完全な識別子(qwen3-8b:devops、qwen3-8b:medical)を自動生成します。これは各アダプターを呼ぶモデルルート名でもあります(手順 2を参照)。
ヒント
各アダプターの LoRA name は一意にします。追加する場合は同じ手順を繰り返します。目的のアダプターが一覧にない場合は、Hugging Face または ModelScope で実際に LoRA アダプターが含まれることを確認し、完全なリポジトリ ID を検索欄に貼り付けて選択します。
手順 2:LoRA アダプターの呼び出し
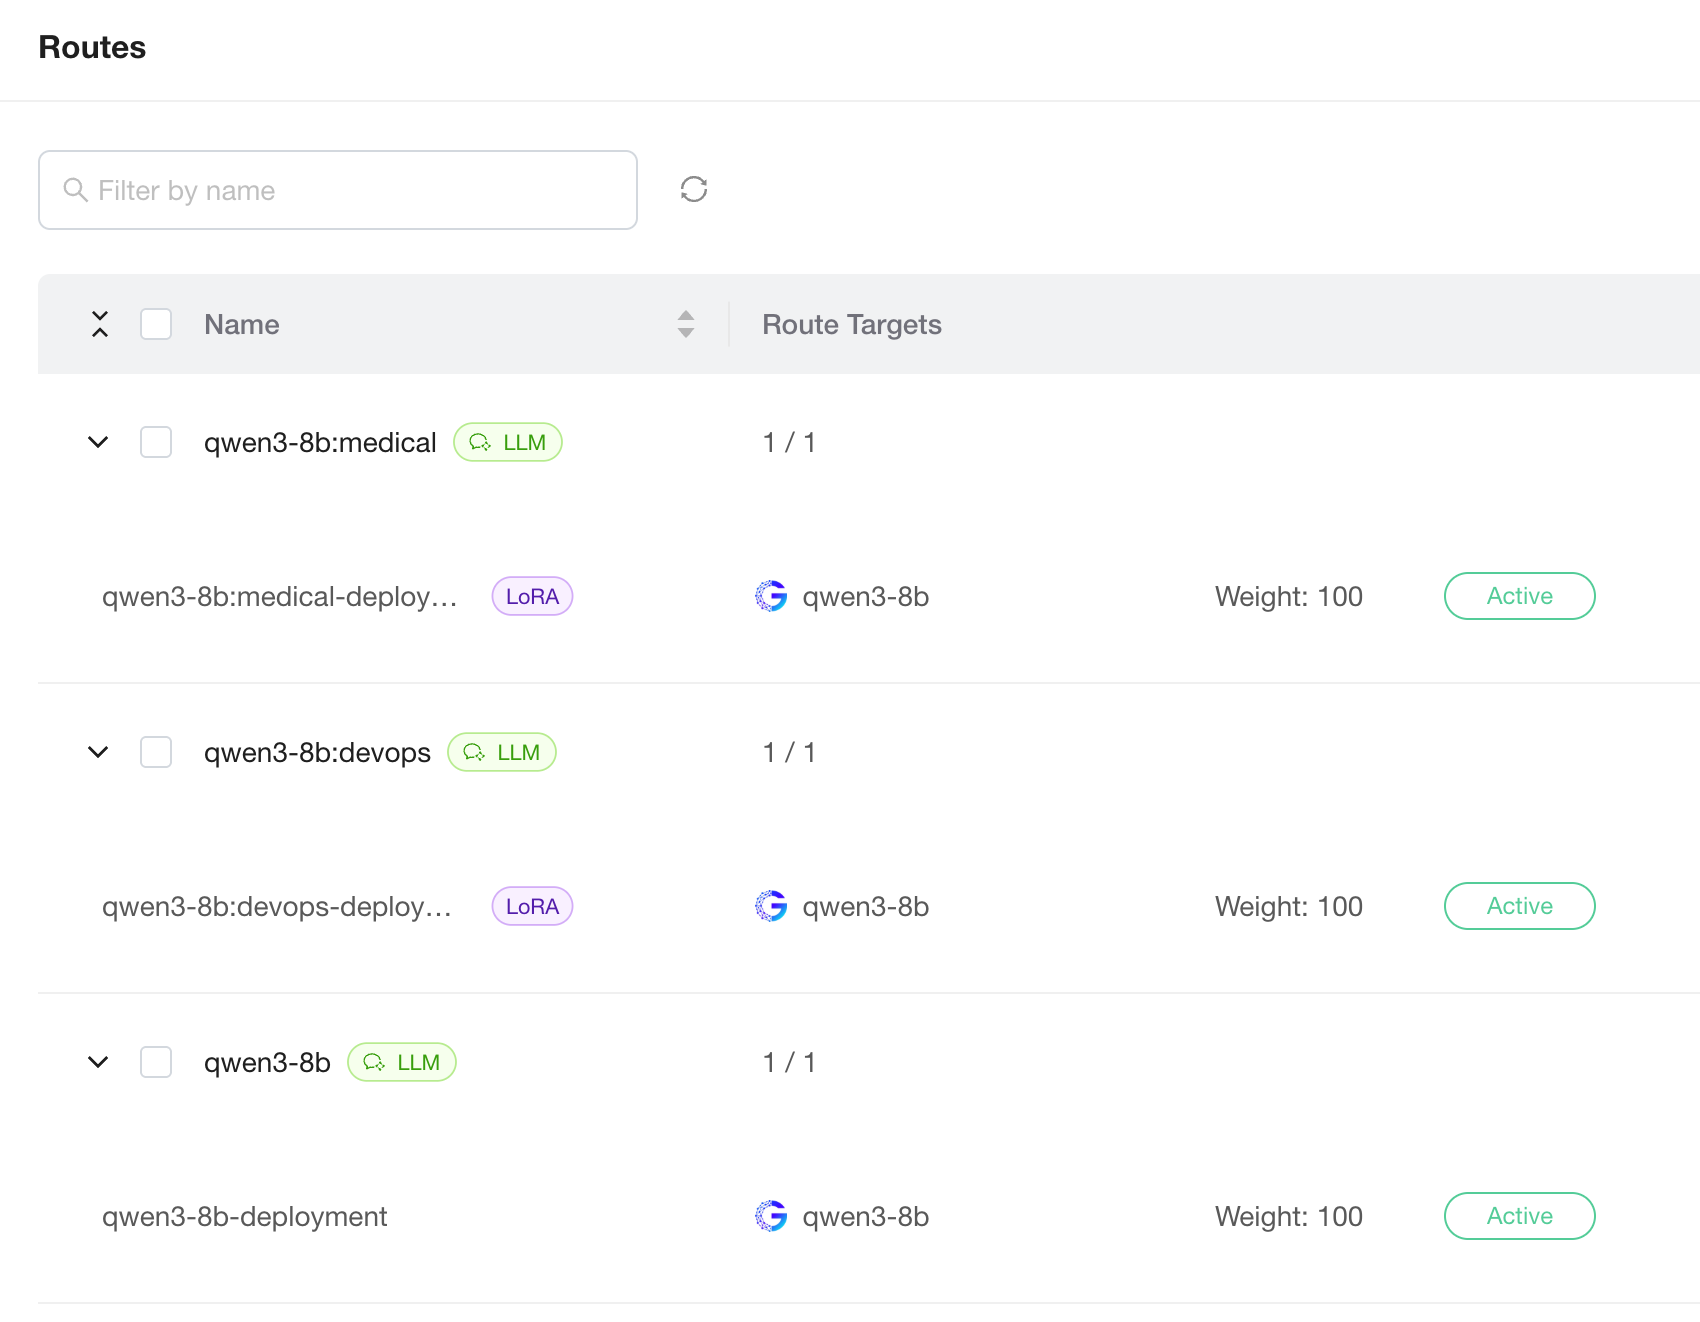
デプロイ後、GPUStack は各 LoRA アダプターに <base-model-name>:<adapter-name> 形式のモデルルートを作成します。この例では基盤の qwen3-8b と、qwen3-8b:devops、qwen3-8b:medical の 3 ルートになります。Model Routes ページでは基盤モデルのルートと並び、識別しやすい LoRA バッジが付きます。
Playground のモデル選択には、基盤モデルと各アダプターが表示されます。切り替えると対応するアダプターへ要求を送ります。OpenAI 互換 API でも model に基盤モデル名かアダプターのルート名を指定します。すべてが同じ GPU インスタンスを共有するため、モデルの交換よりはるかに低コストで切り替えられます。
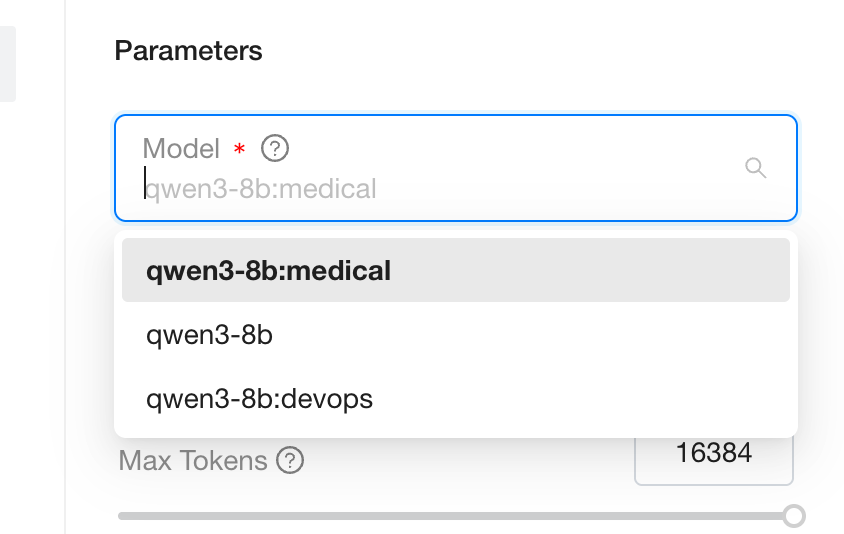
たとえば、model を変えるだけで同じプロンプトを別の調整モデルへ送れます。まず DevOps アダプターに Kubernetes の質問を送ります。
次に、model の値だけを変更して、医療アダプターへ臨床的な質問を送ります。
<your-gpustack-server> をサーバーアドレス、<your-api-key> を API Keys ページで作ったキーに置き換えます。"model": "qwen3-8b" を指定すると、アダプターなしの基盤モデルを使います。
手順 3:LoRA アダプターの管理
デプロイ後にも LoRA の設定を調整できます。
- 追加:デプロイ済みモデルを編集・保存します。すでに
Runningのインスタンスでは、再起動後に新しいアダプターがマウント・提供されます。 - 削除:モデル設定から該当項目を削除します。使用する
Runningインスタンスがなくなったら、対応するモデルルートを自動削除します。 - 名前の競合:異なる基盤モデルのアダプターが同じモデルルート名になる場合、保存は競合エラーで拒否されます。どちらかのアダプターを改名してください。
バックエンドの互換性と制限
LoRA のサポートにはバックエンドごとの違いがあります。
| バックエンド | LoRA の起動引数・設定 | 主な制限 |
|---|---|---|
vLLM | --enable-lora、--max-loras、--lora-modules | --max-loras は lora_list の長さから自動設定します。基盤モデルの起動後はアダプター数が固定され、変更にはインスタンスの再起動が必要です。 |
SGLang | --enable-lora、--lora-paths name=path、--max-loras-per-batch | 1 バッチで同時に有効化できる数は --max-loras-per-batch で制限されます。 |
Ascend MindIE | 設定ファイル内の maxLoras / maxLoraRank / LoraModules | maxLoraRank のデフォルトは 64 で、より高ランクのアダプターは起動できません。maxLoras=0 はマウント数に自動設定されます。 |
GPUStack が自動注入するため、通常は Backend Parameters への再指定は不要です。maxLoraRank を増やすなどデフォルトを上書きする場合のみ、Advanced → Backend Parameters に追加します。
すべての詳細と制限は、各バックエンドの公式ドキュメントをご覧ください。
- vLLM:LoRA アダプター
- SGLang:LoRA の提供
- Ascend MindIE:Multi-LoRA(中国語のみ)