MultiProcessing バックエンドによる分散 vLLM の実行
1 台のワーカーではモデルを動かす GPU メモリーや計算能力が足りない場合、vLLM はモデルインスタンスを複数のワーカーに分割して協調推論できます。GPUStack はノードをまたぐプロセスを単一のモデルインスタンスとして管理し、1 つの OpenAI 互換エンドポイントだけを公開します。vLLM は --distributed-executor-backend で ray と mp(MultiProcessing)の実行方式を選べます。この例では MP バックエンドで、テンソル並列(TP)とデータ並列(DP)を組み合わせて複数ワーカーで分散推論します。
このチュートリアルでは、GPUStack でワーカー間の分散推論を有効化し、MP バックエンドを明示的に選び、テンソル並列とデータ並列を組み合わせて単一モデルインスタンスを 2 ノードに配置します。
注記
- MP バックエンドは、
Backend Parametersに--distributed-executor-backend=mpを明示指定した場合、または vLLM ≥0.18.0のカスタムイメージ(-custom接尾辞のバックエンドバージョン)で有効です。0.18.0以降の vLLM はデフォルトで Ray に依存しないため、GPUStack は起動失敗を避けて自動でmpに切り替えます。 - Ray と MP の違い、headless のフォロワー、
dp_only/mp_only/nestedトポロジーについては、組み込み推論バックエンドのDistributed Inference Across Workersをご覧ください。 - この機能は現在実験的です。
前提条件
開始前に、次の条件を満たしていることを確認します。
- GPUStack がインストール済みで稼働していること。
- 同じ型・同じ数の GPU を持つ Linux ノードが 2 台以上あること。この例は 2 ノード ×8 GPU(合計 16 GPU)で、NVIDIA、AMD、Ascend など各ベンダーのアクセラレーターに適用できます。
- 高性能を得るため、NVLink や InfiniBand などの高速なノード間接続を推奨します。
- すべての参加ノードで同じパスからモデルファイルにアクセスできること。共有ファイルシステムを使用するか、各ノードの同じパスに事前取得します。
tensor-parallel-size=8、data-parallel-size=2(各 DP レプリカが 8 GPU ノードを丸ごと使用)の配置に適したモデルを選択すること。
注記
この例では、各 DP レプリカ(tensor-parallel-size=8)が 8 GPU ノード全体を占有します。モデルとハードウェアに応じて --tensor-parallel-size と --data-parallel-size を調整します。
手順 1:GPUStack ワーカーの追加
インストールに従って各ノードで参加コマンドを実行し、同じ GPUStack クラスターに追加します。
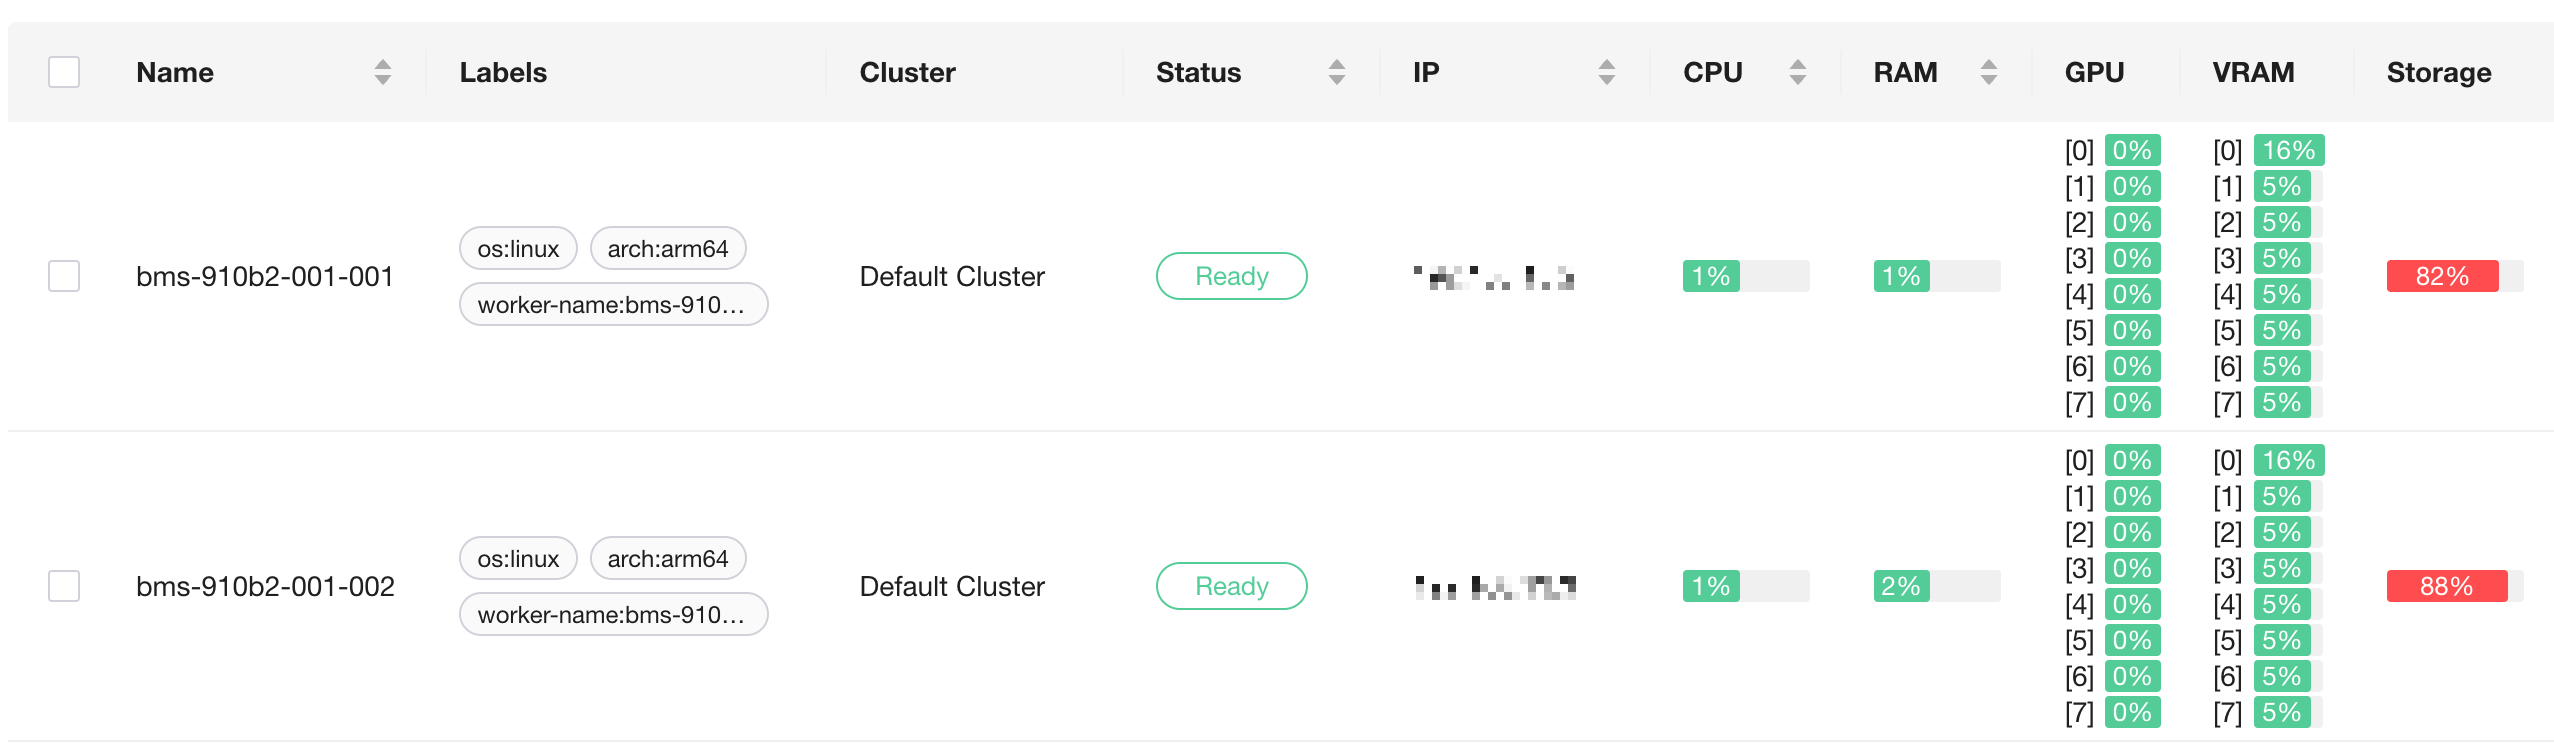
参加後、GPUStack UI の Workers ページで両ノードが Ready で、GPU が表示されていることを確認します。
手順 2:MP バックエンドでのモデルのデプロイ
Deploymentsページに移動します。Deploy Modelをクリックし、ソース(Local Pathなど)と、全ノードで共通のモデルパスを入力します。BackendがvLLMであることを確認します。- 詳細設定で
Allow Distributed Inference Across Workersを有効にします。 -
Backend Parametersに次のパラメーターを追加します。 -
互換性チェックが成功したら、
Saveをクリックしてデプロイします。
分散インスタンス全体を単一のデプロイメントとして配置する
ノードをまたぐ分散インスタンスは、単一のデプロイメントとして作成することを推奨します。上記のように 1 つだけ作成すると、GPUStack は次を行います。
- 両ワーカーの GPU(この例では 16 基)を選択し、ノードごとの
--data-parallel-size-localを自動計算するため、--data-parallel-size-localの手動設定は不要です。 - 複数ノードのトポロジーパラメーター
--nnodes、--node-rank、--master-addr、--master-portを注入します。 - フォロワーに
--headlessを自動付与し、API エンドポイントを開始せず分散計算だけに参加させます。フォロワーログの--headlessは正常です。
自動スケジューリングの条件を満たせない場合
gpu_memory_utilization のメモリー要件などを満たせず自動割り当てできない場合、Scheduling Mode を Manual または Specify GPU に切り替え、GPU Selector で各ワーカーの 8 GPU(合計 16)を選択します。自動配置の全条件は、組み込み推論バックエンドをご覧ください。
手動で複数のデプロイメントに分ける場合:GPUSTACK_SKIP_GPU_COUNT_CHECK で GPU 数チェックを省略する
外部の負荷分散を自身で管理する場合など、ノードごとにデプロイメントを作り、GPU を手動選択して --data-parallel-size-local 1 を指定することがあります。各デプロイメントの GPU は 8 基でも tensor-parallel-size × data-parallel-size = 16 のため、GPUStack は world size との不一致を the selected gpu count (8) does not match the world size (16) として報告します。
意図した配置であれば、各デプロイメントの Environment Variables で GPUSTACK_SKIP_GPU_COUNT_CHECK=1 を設定し、検証を省略して手動 GPU 数を維持します。GPU を手動選択した場合のみ(Scheduling Mode が Manual または Specify GPU)有効で、自動スケジューリングには影響しません。
手順 3:デプロイの監視
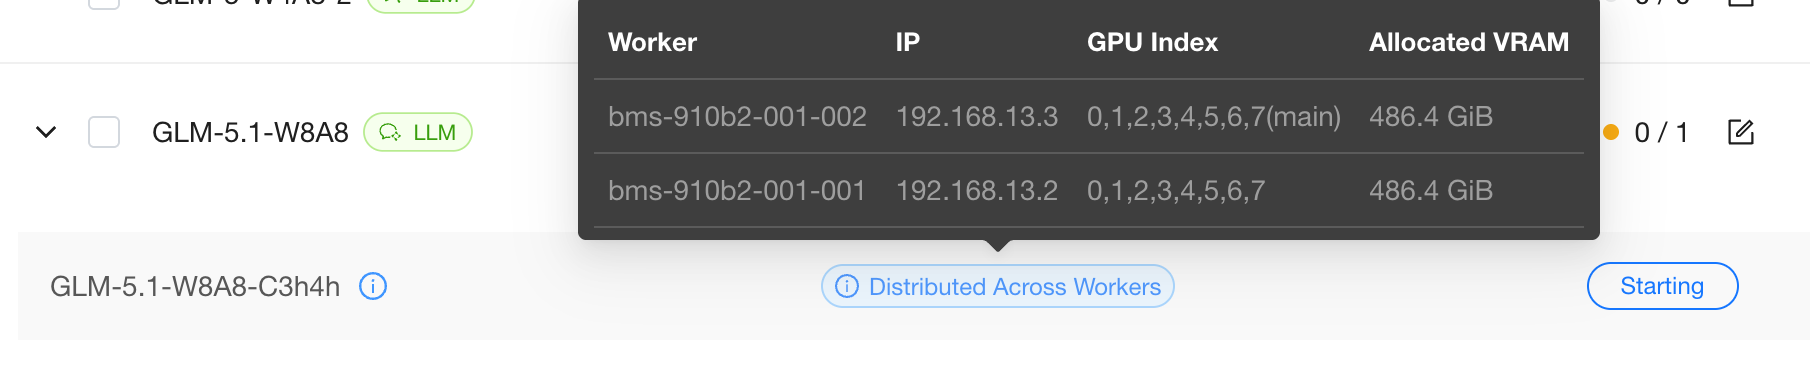
Deployments ページで状態を監視します。Distributed Across Workers にポインターを合わせると、各ワーカーの GPU 使用状況が表示されます。View Logs でリアルタイムログを確認します。
- リーダーはモデルを読み込み、OpenAI 互換エンドポイントを公開します。
- フォロワーのログの
--headlessは、分散計算にのみ参加し API ポートを使わないことを示します。これは正常です。
モデルの読込には数分かかる場合があります。
手順 4:プレイグラウンドでの確認
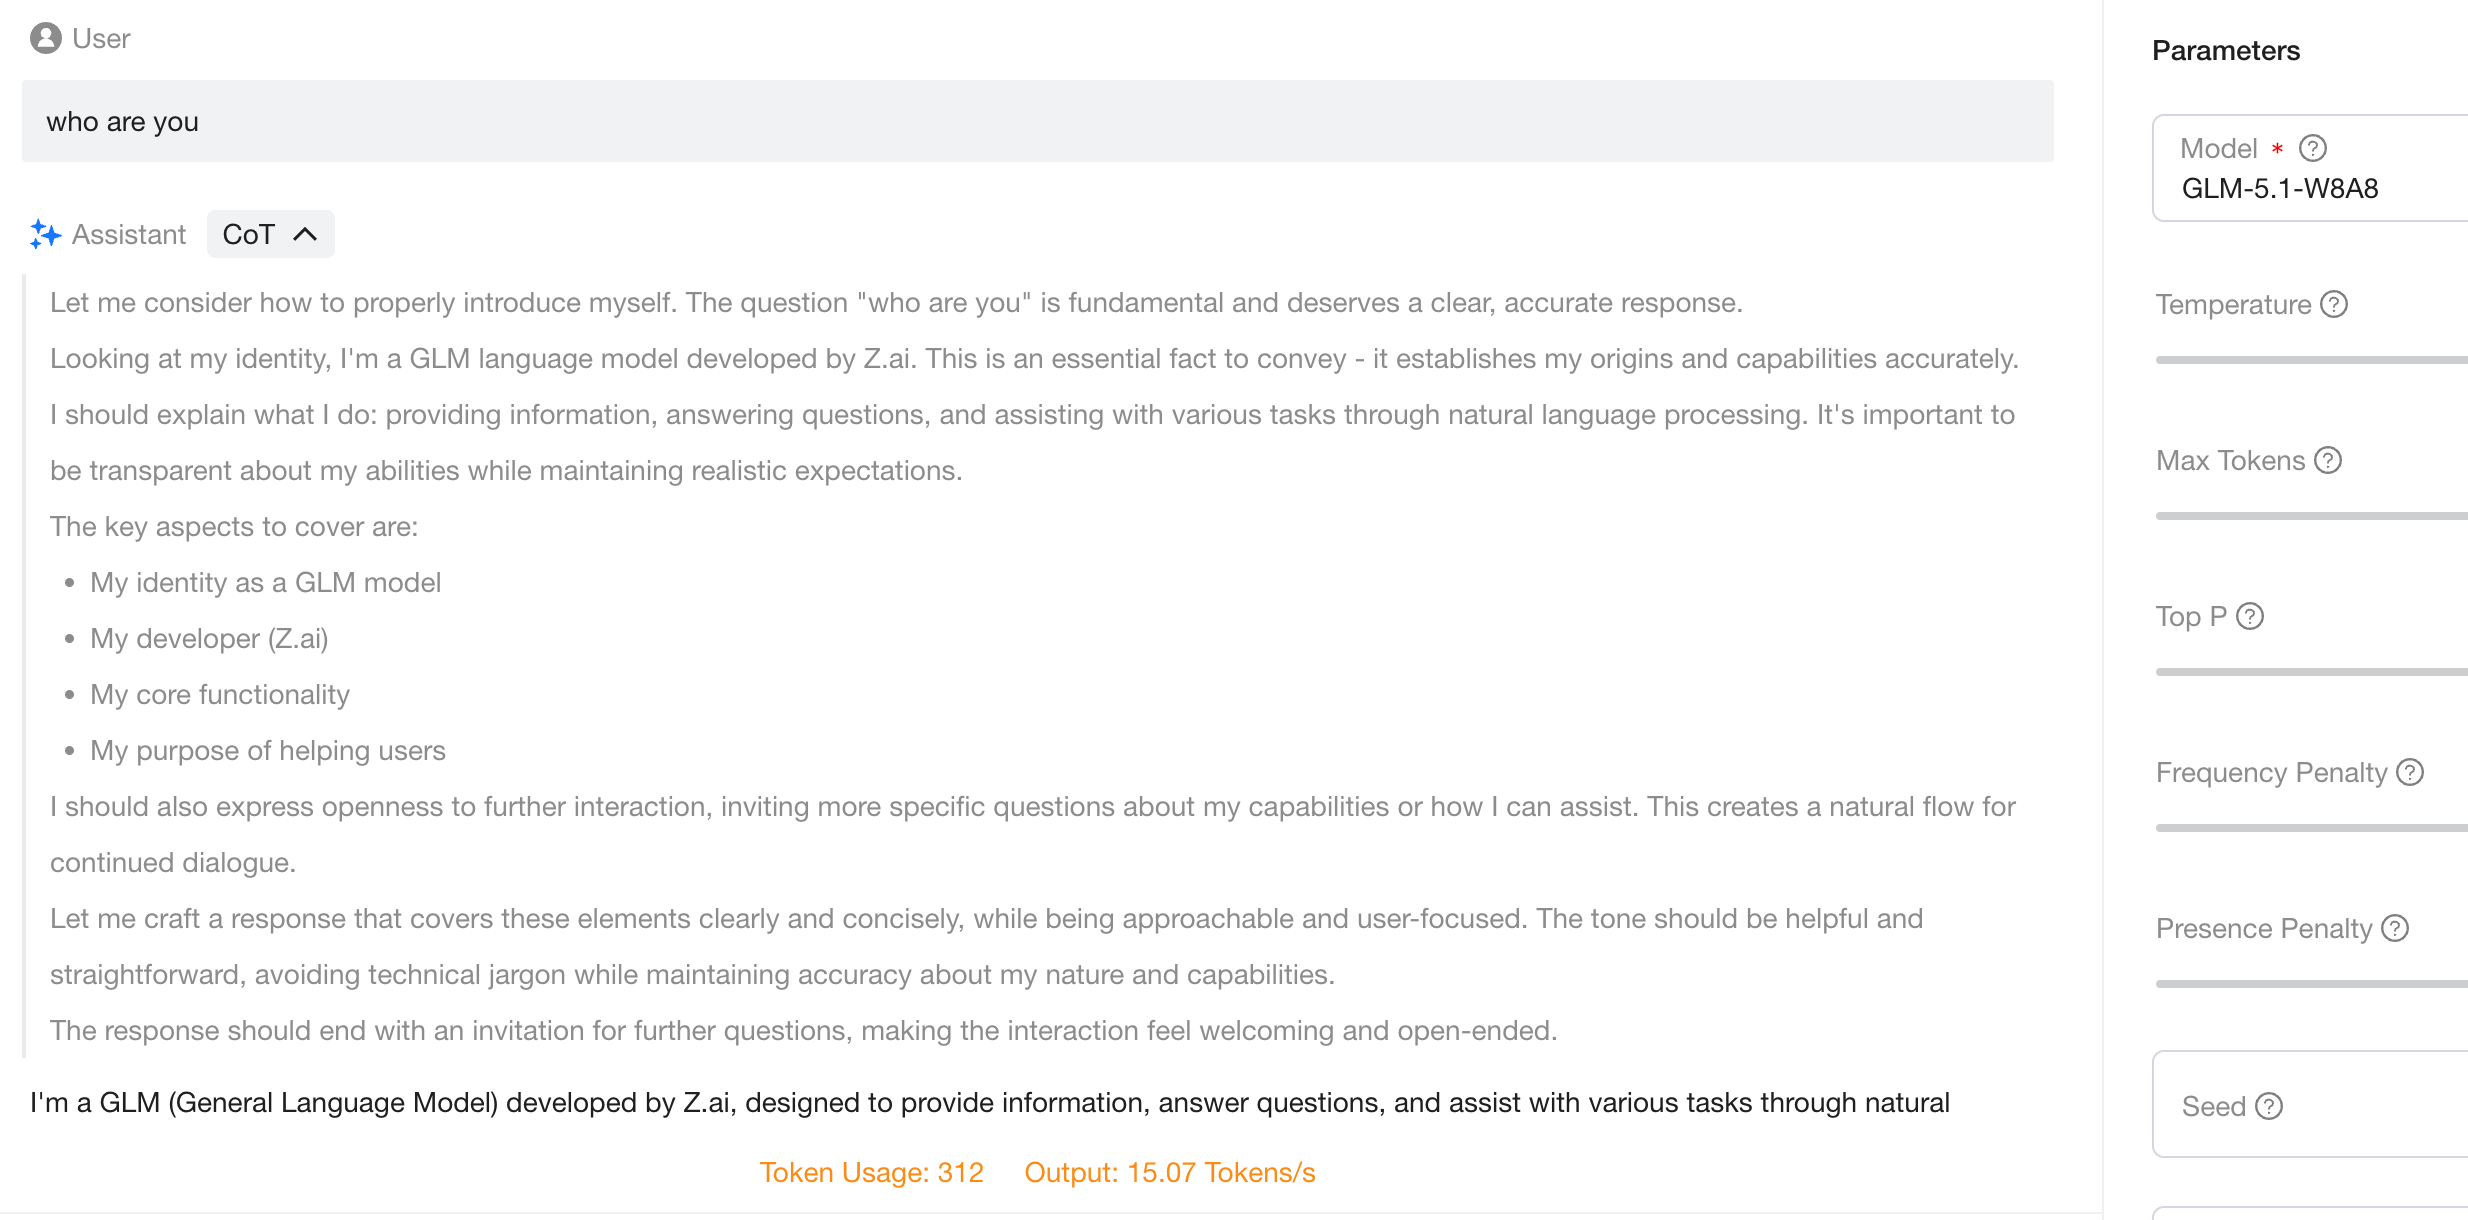
実行中になったら、GPUStack Playground で直接確認します。すべての外部要求はリーダーに入り、そこからフォロワーへ振り分けられるため、単一ワーカーのデプロイメントと同じ方法で利用できます。
Playground>Chatに移動します。- モデルが 1 つだけならデフォルトで選択されます。複数ある場合は、右上のドロップダウンから対象を選択します。
- プロンプトを入力してモデルと対話します。
以上で、GPUStack クラスター上で vLLM の MP バックエンドを使用した複数ノードの分散推論のデプロイと実行が完了しました。
さらに支援が必要な場合は、GPUStack コミュニティまたはサポートチームにお問い合わせください。