分散 vLLM による DeepSeek R1 671B の実行
このチュートリアルでは、GPUStack クラスターで分散 vLLM を使用し、オリジナルの DeepSeek R1 671B を構成・実行します。非常に大規模なモデルのため、通常は複数ワーカーにまたがる分散推論が必要です。
GPUStack は vLLM の分散推論を簡単に設定・オーケストレーションでき、最小限の手動設定で DeepSeek R1 のような巨大モデルを実行できます。
前提条件
開始前に、次の条件を満たしていることを確認します。
- 必要な GPU を搭載した Linux ノードを十分な台数用意します。例:
| GPU | ノード数 |
|---|---|
| H100/H800:8 | 2 |
| A100/A800-80GB:8 | 4 |
| A100/A800:8 | 8 |
- 性能を最大限に引き出すため、NVLink や InfiniBand などの高速相互接続を推奨します。
- モデルファイルを各ノードの同じパスにダウンロードします。GPUStack は実行時にも取得できますが、ネットワーク速度によって時間がかかるため、事前取得を推奨します。
注記
- この例では、各ノードに A800-80GB GPU を 8 基搭載し、200G InfiniBand で接続した 4 ノードを使用します。
- A100/A800 GPU は、DeepSeek R1 が元々使用する FP8 精度に対応しないため、Unsloth の BF16 バージョンを使います。
手順 1:GPUStack サーバーのインストール
インストールに従い、次のコマンドで GPUStack サーバーを起動します。
注記
/path/to/your/modelを実際のパスに置き換えます。
GPUStack サーバーが起動したら、次のコマンドで初期管理者パスワードを取得します。
手順 2:GPUStack UI へのアクセス
admin ユーザーと取得したパスワードで GPUStack UI にログインします。
手順 3:GPUStack ワーカーのインストール
GPUStack UI の Workers ページで Add Worker をクリックし、追加用のコマンドを取得します。
各ワーカーノードで追加コマンドを実行し、GPUStack ワーカーを起動します。
注記
- パス、IP アドレス・ホスト名、クラスタートークンのプレースホルダーを環境に合わせて置き換えます。
/path/to/your/modelを、DeepSeek R1 のモデルファイルがある実際のパスに置き換えます。
すべてのワーカーを追加したら、GPUStack UI に戻ります。
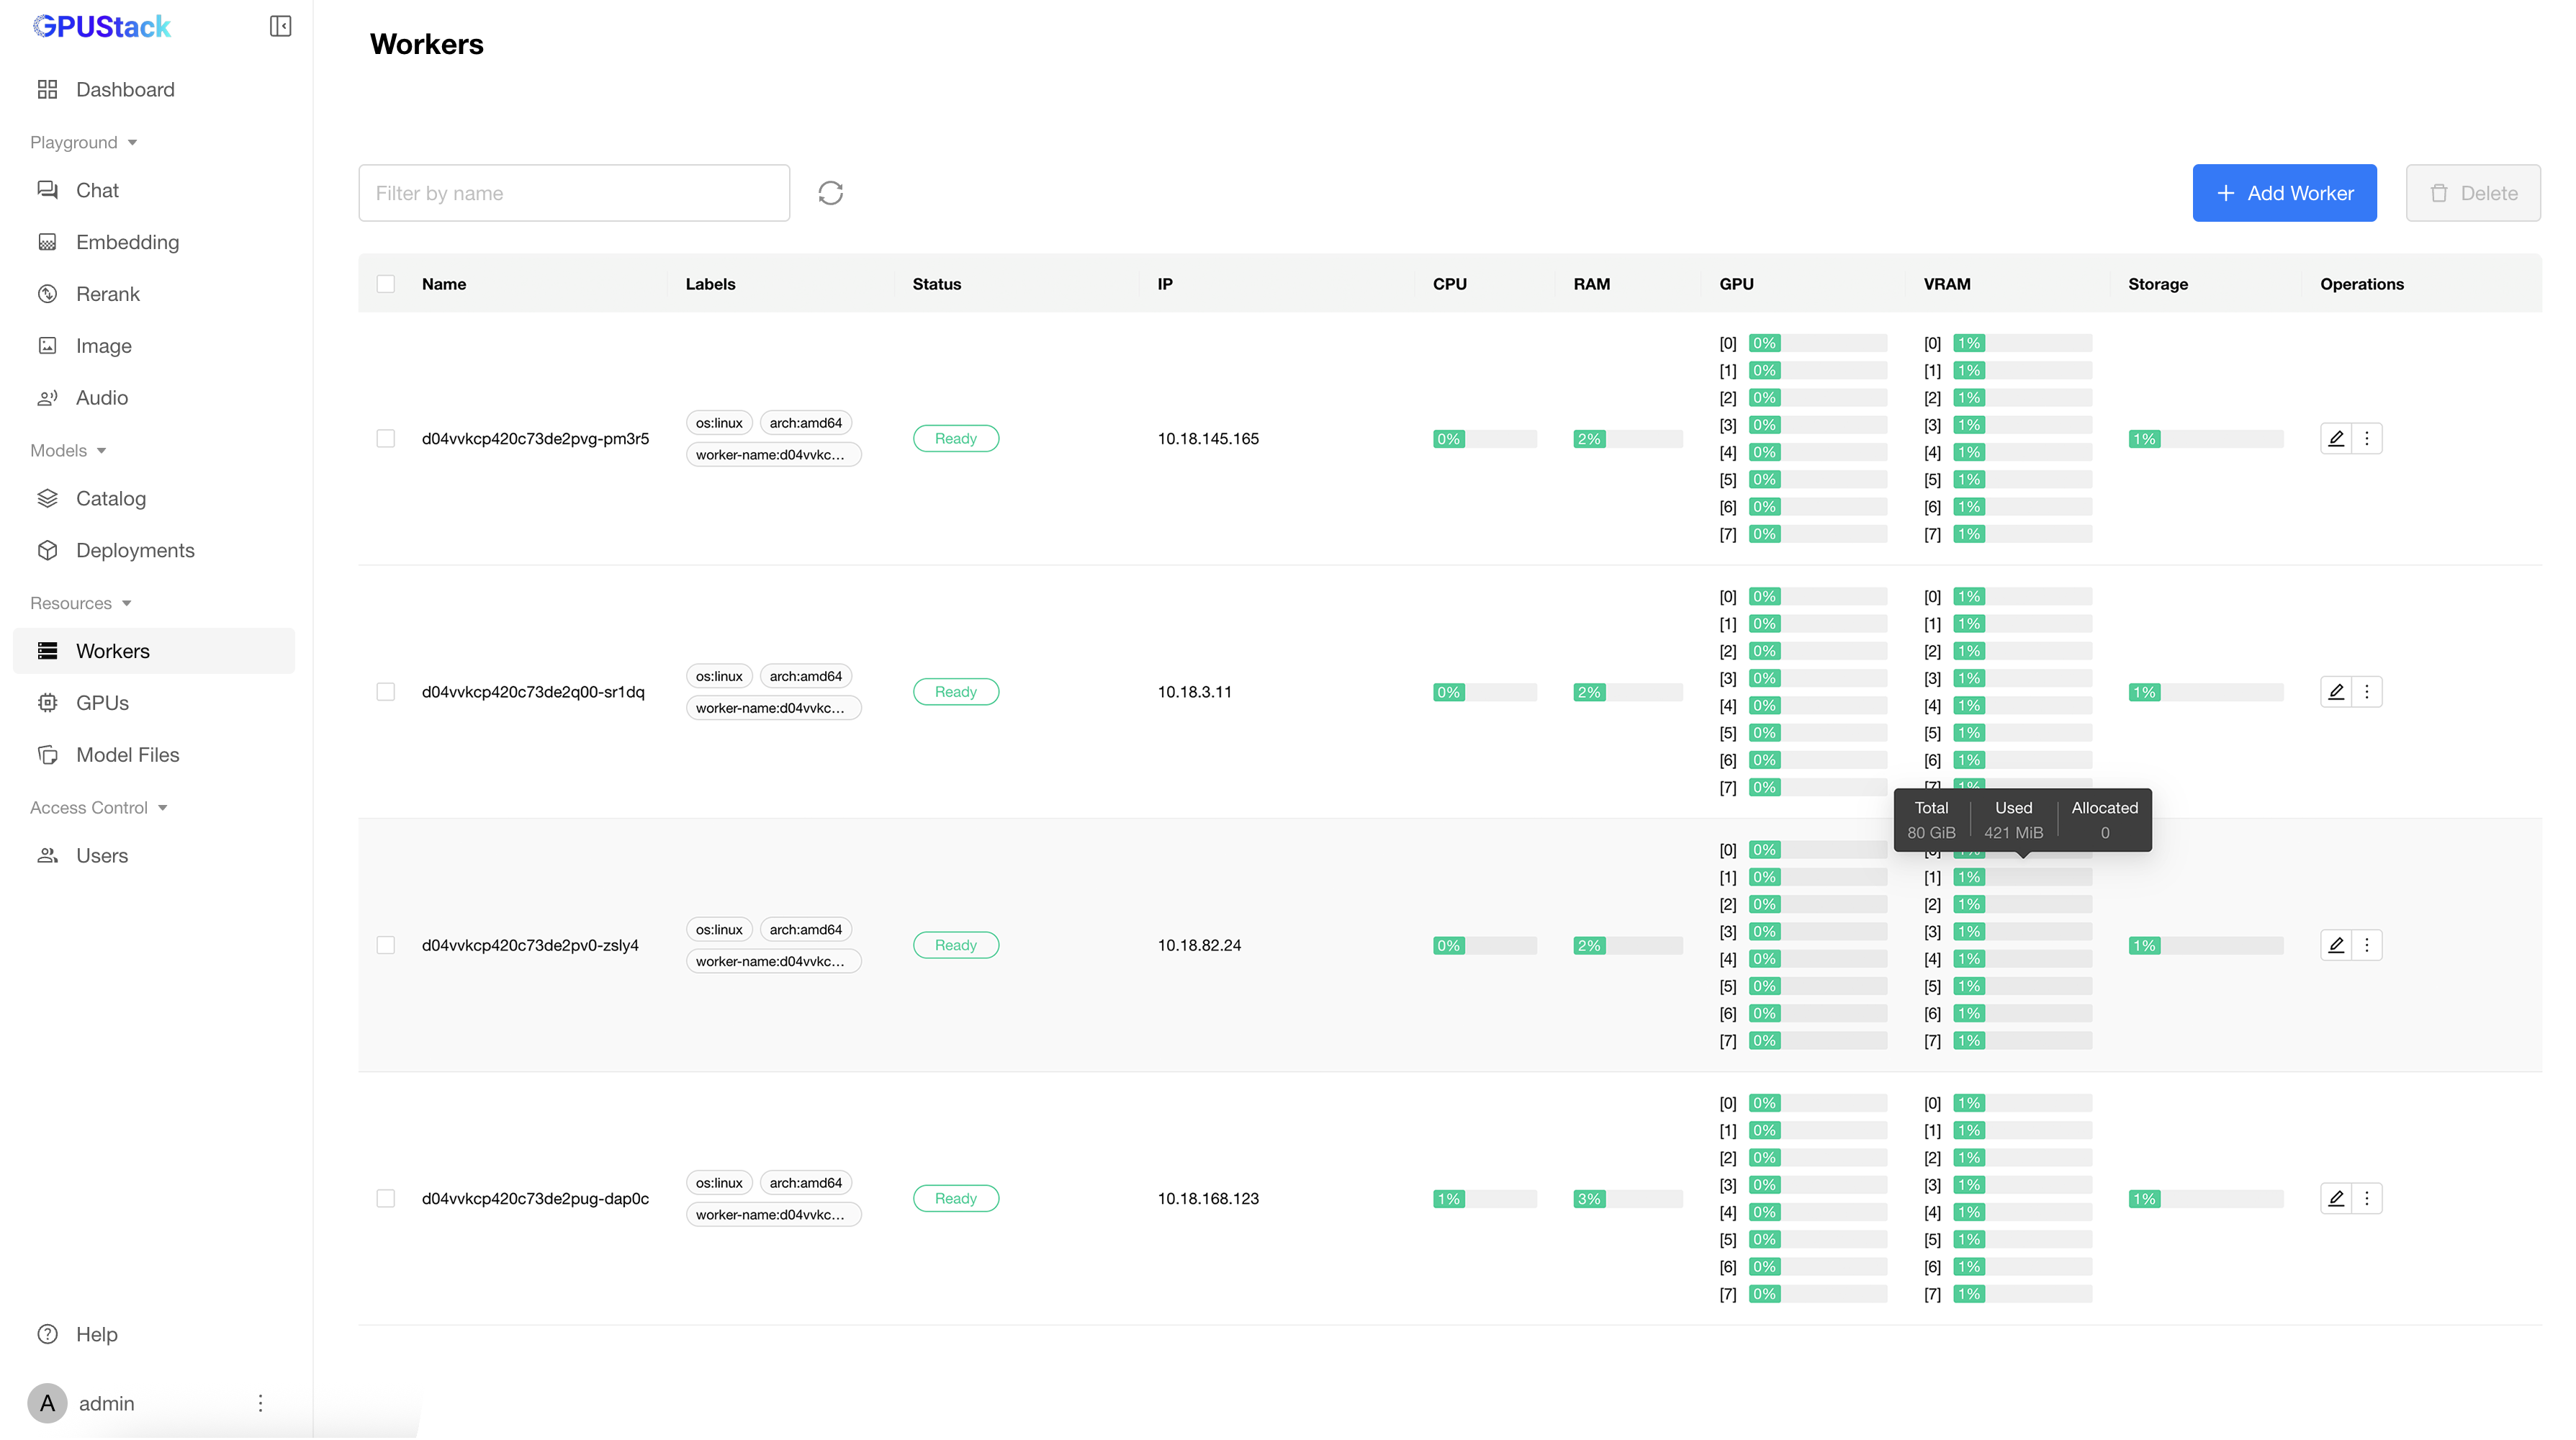
Workers ページで、すべてのワーカーが Ready で、GPU が一覧に表示されていることを確認します。
手順 4:DeepSeek R1 モデルのデプロイ
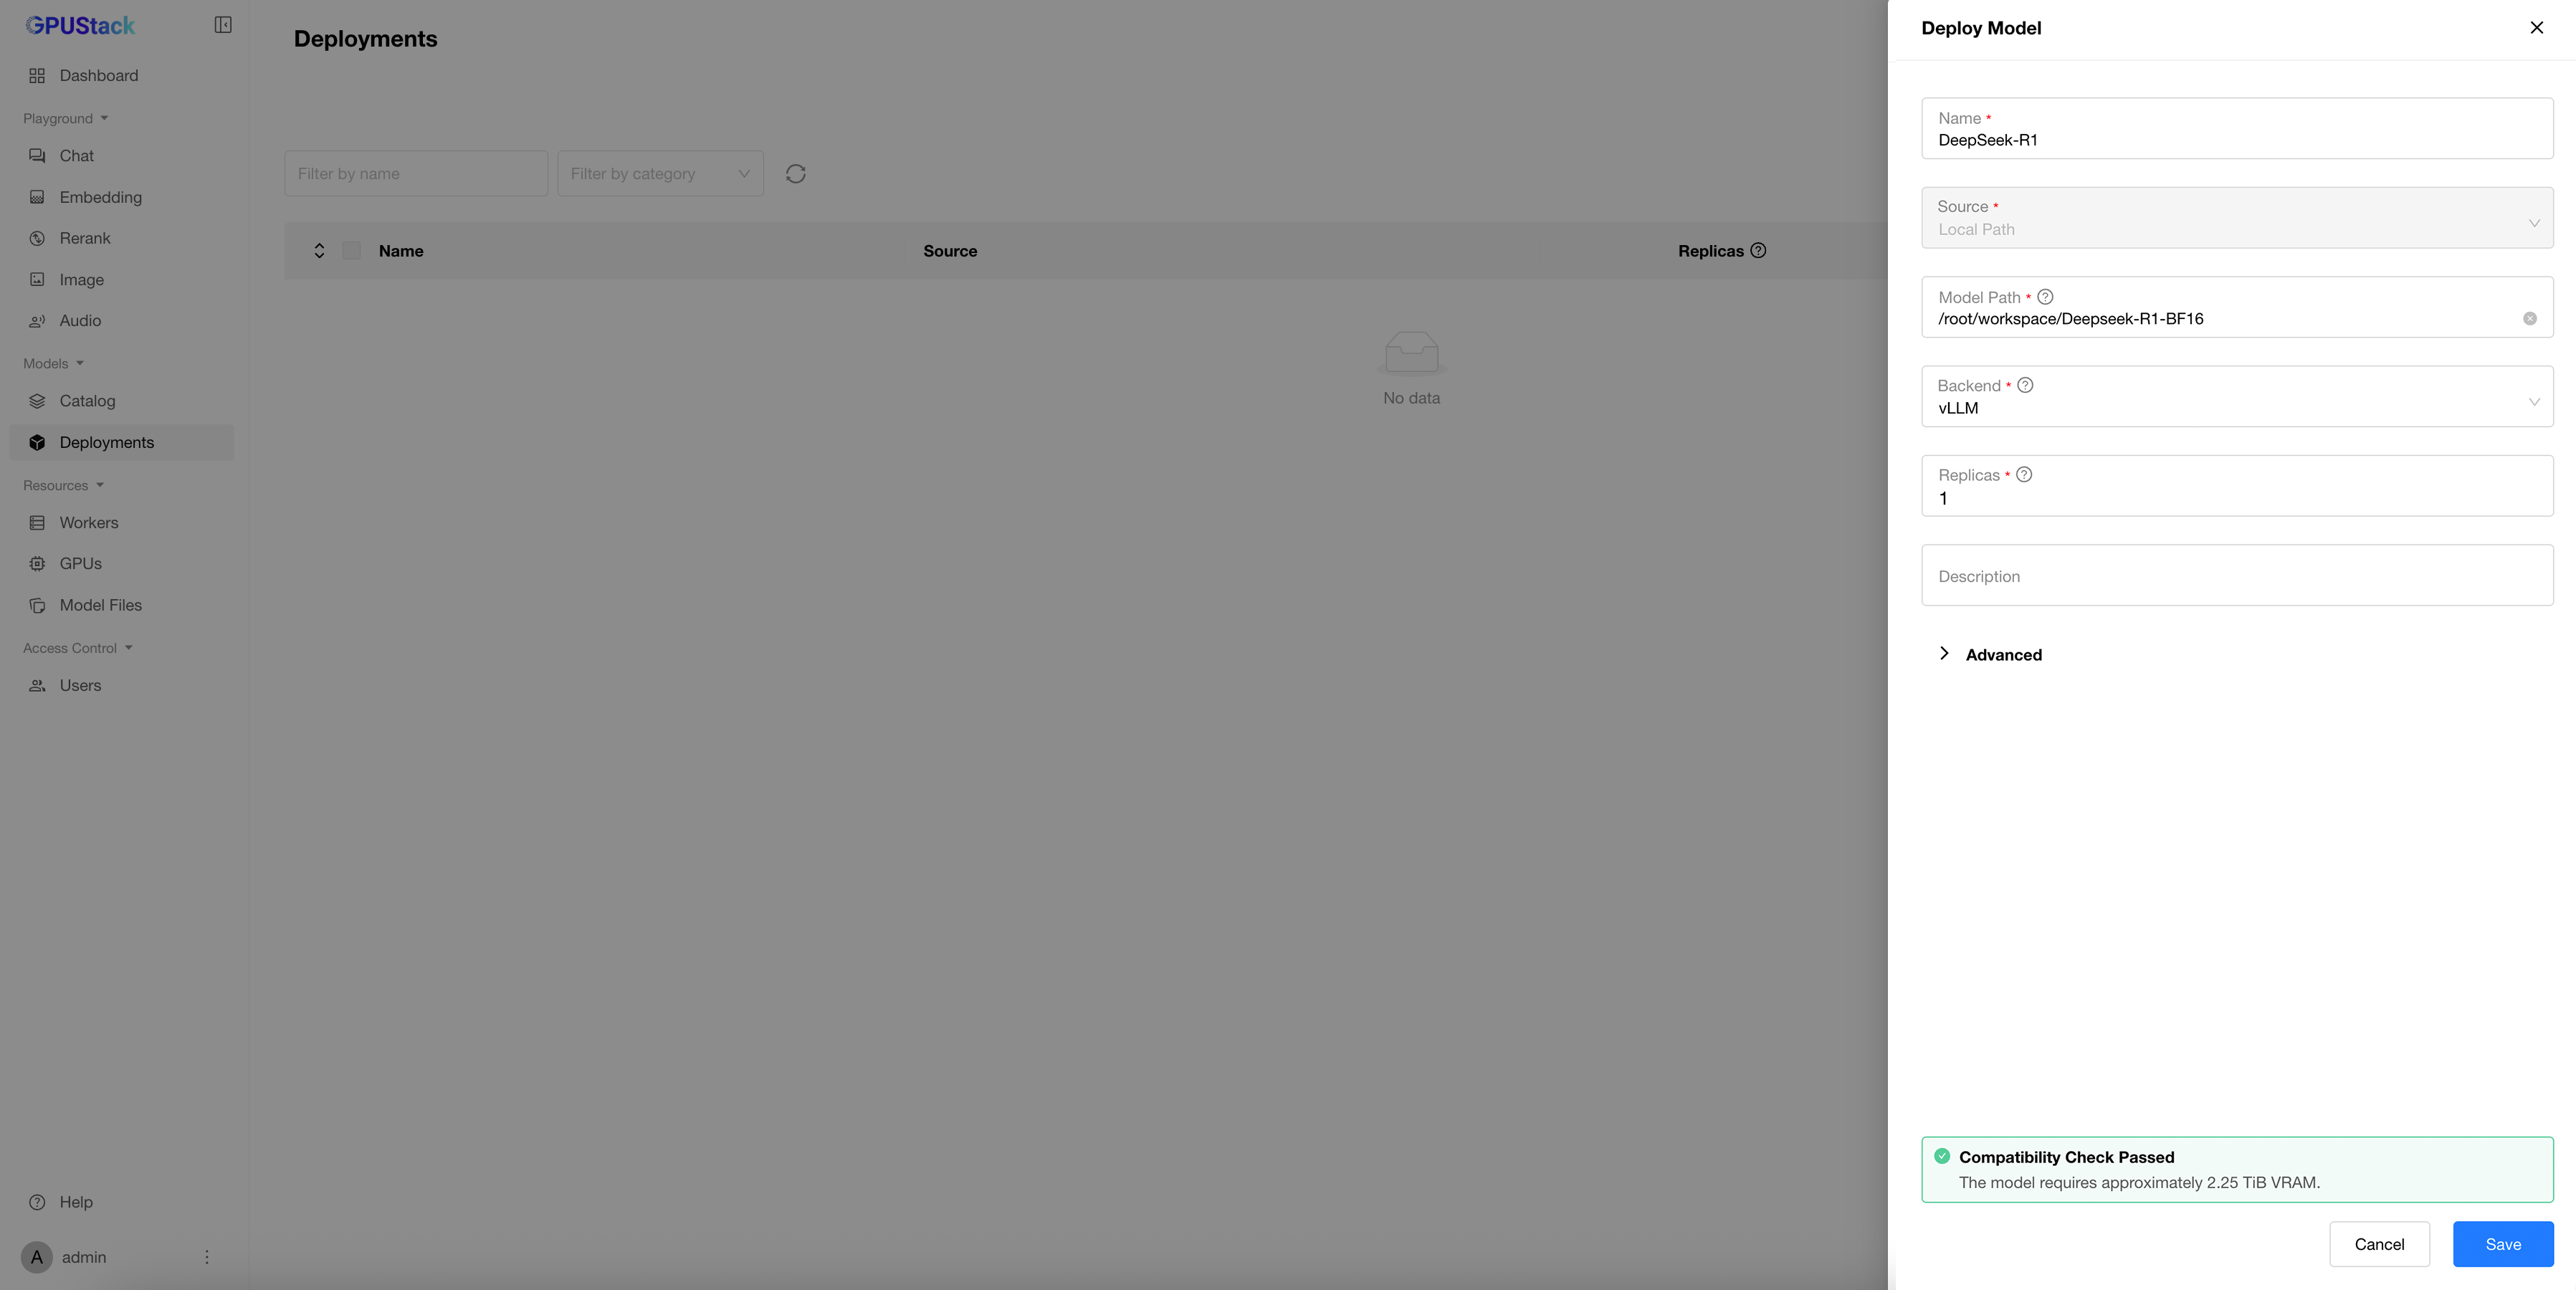
Deploymentsページに移動します。Deploy Modelをクリックします。- ソースに
Local Pathを選択します。 Nameに名前(例:DeepSeek-R1)を入力します。Model Pathに、各ワーカーノードで DeepSeek R1 のファイルを格納するディレクトリを指定します。BackendがvLLMであることを確認します。- 互換性チェックが成功したら、
Saveをクリックしてデプロイします。
手順 5:デプロイの監視
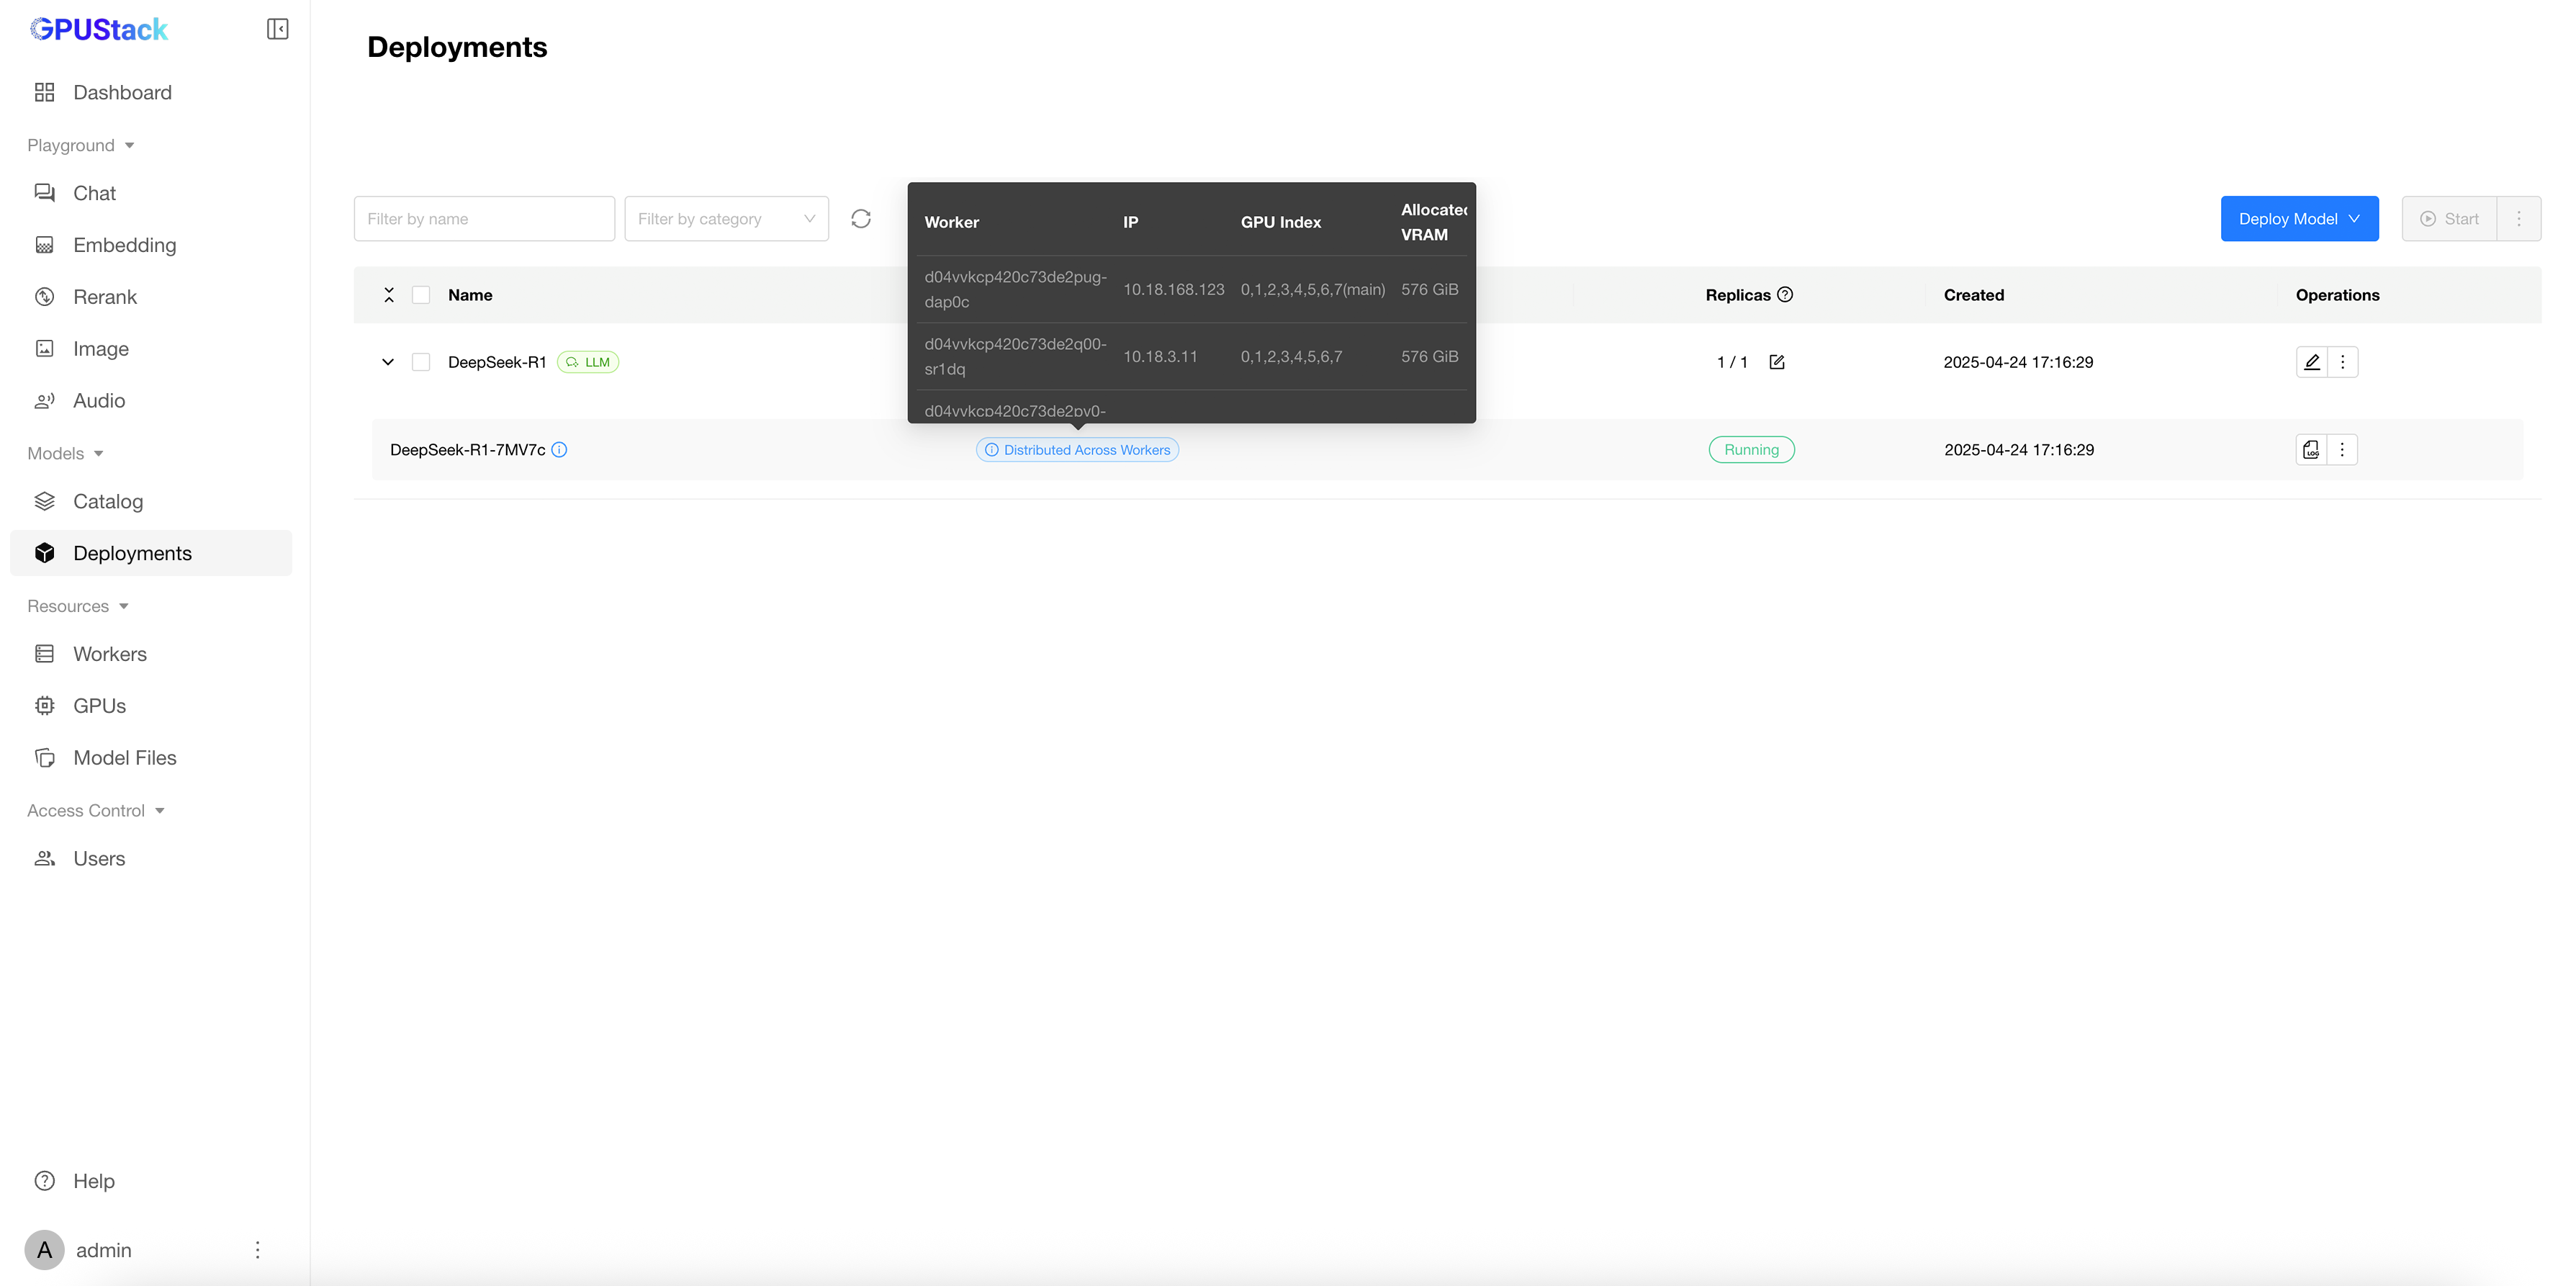
Deployments ページで状態を監視できます。distributed across workers にポインターを合わせると、GPU とワーカーの使用状況を確認できます。View Logs をクリックすると、モデル読込の進行状況がリアルタイムに表示されます。読込には数分かかる場合があります。
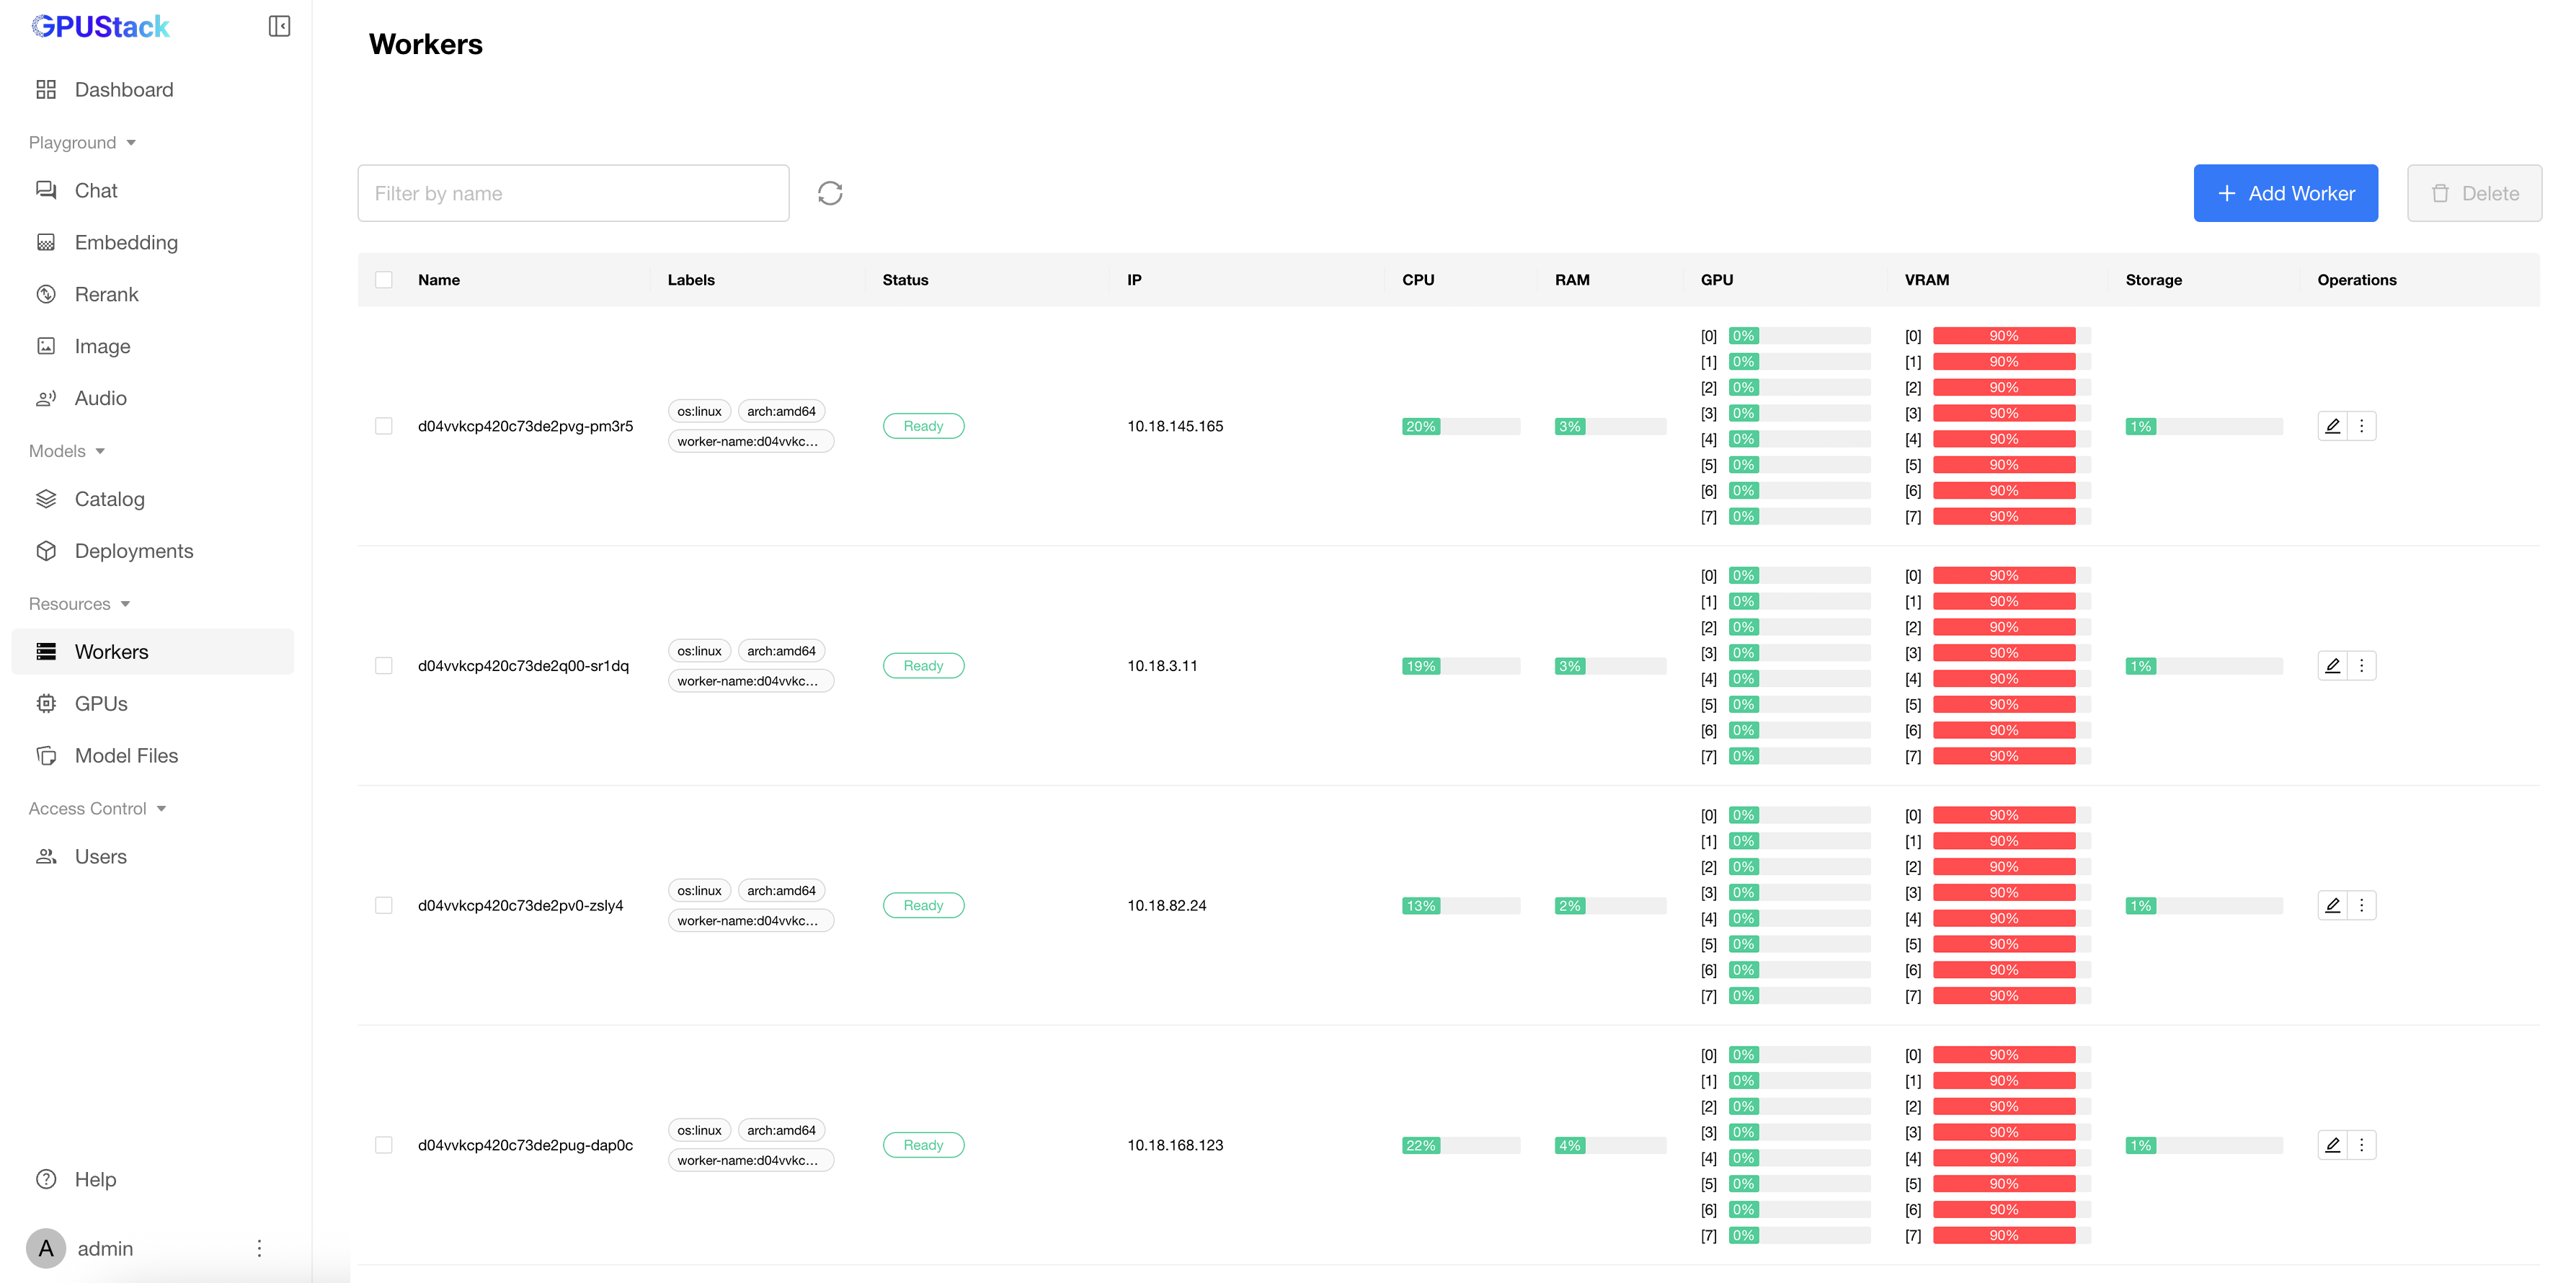
モデル起動後、Workers ページで GPU 使用率を確認します。vLLM はデフォルトで GPU メモリーの 90% を使用し、モデル設定で調整できます。
手順 6:プレイグラウンドでの推論
モデルがデプロイされ実行中になったら、GPUStack Playground でテストできます。
Playground->Chatに移動します。- モデルが 1 つだけならデフォルトで選択されます。複数ある場合はドロップダウンから
DeepSeek-R1を選択します。 - プロンプトを入力してモデルと対話します。
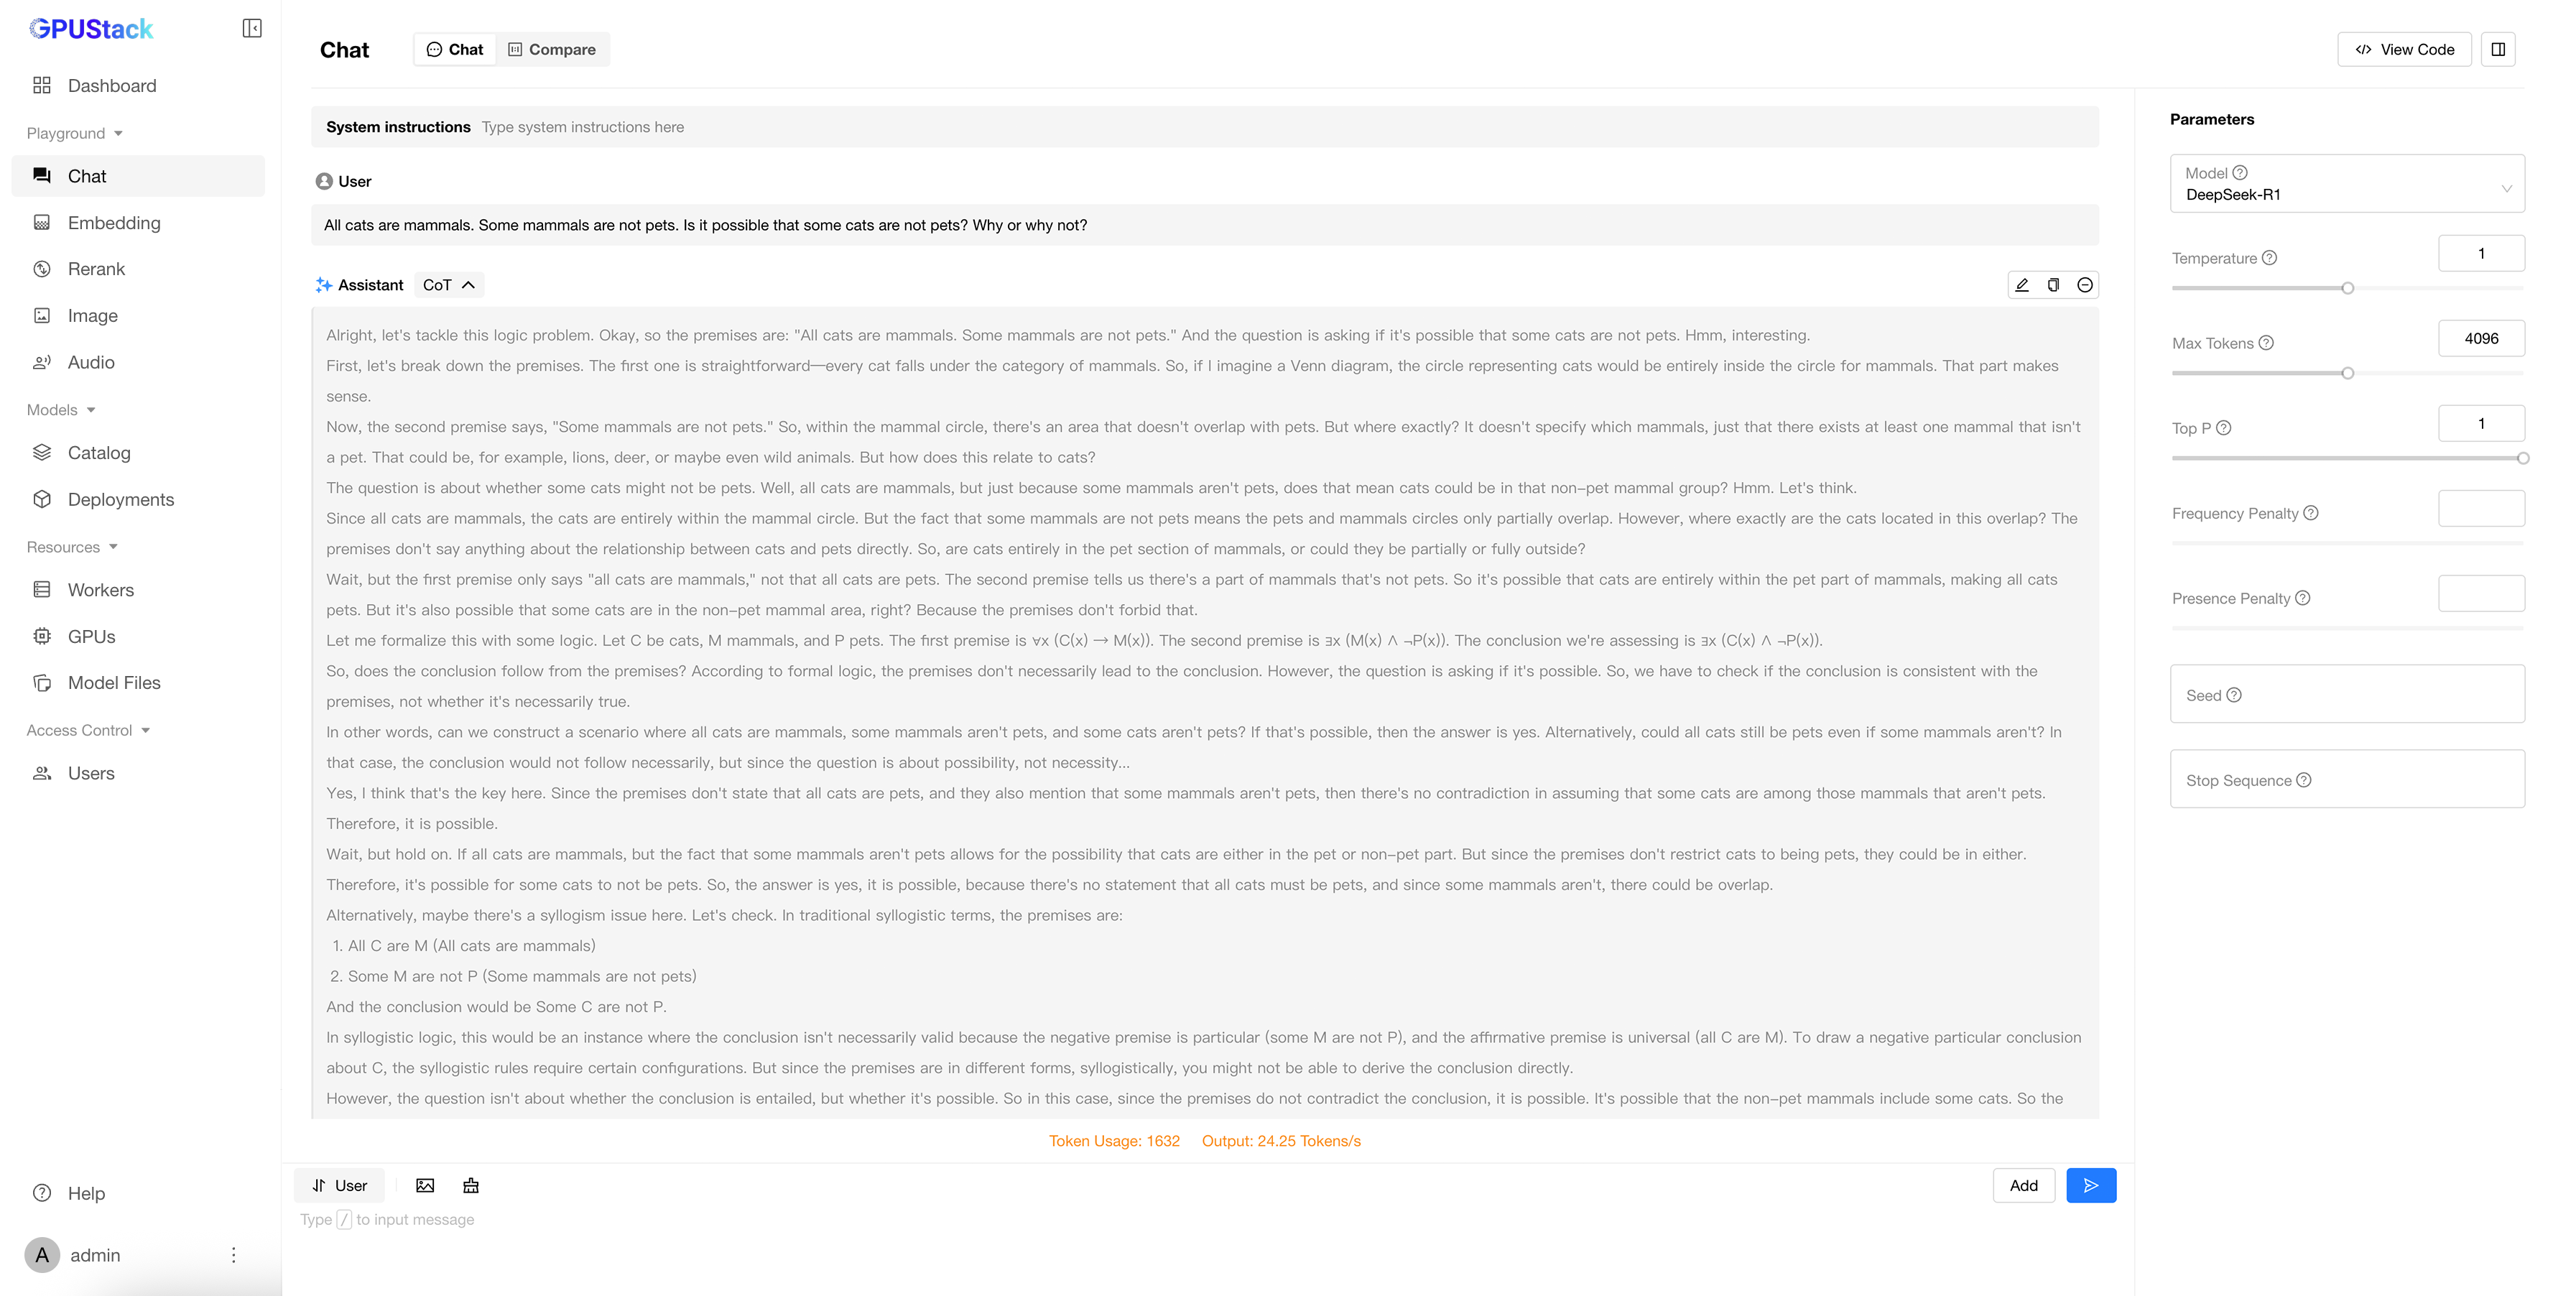
Compare タブでは同時推論のシナリオもテストできます。
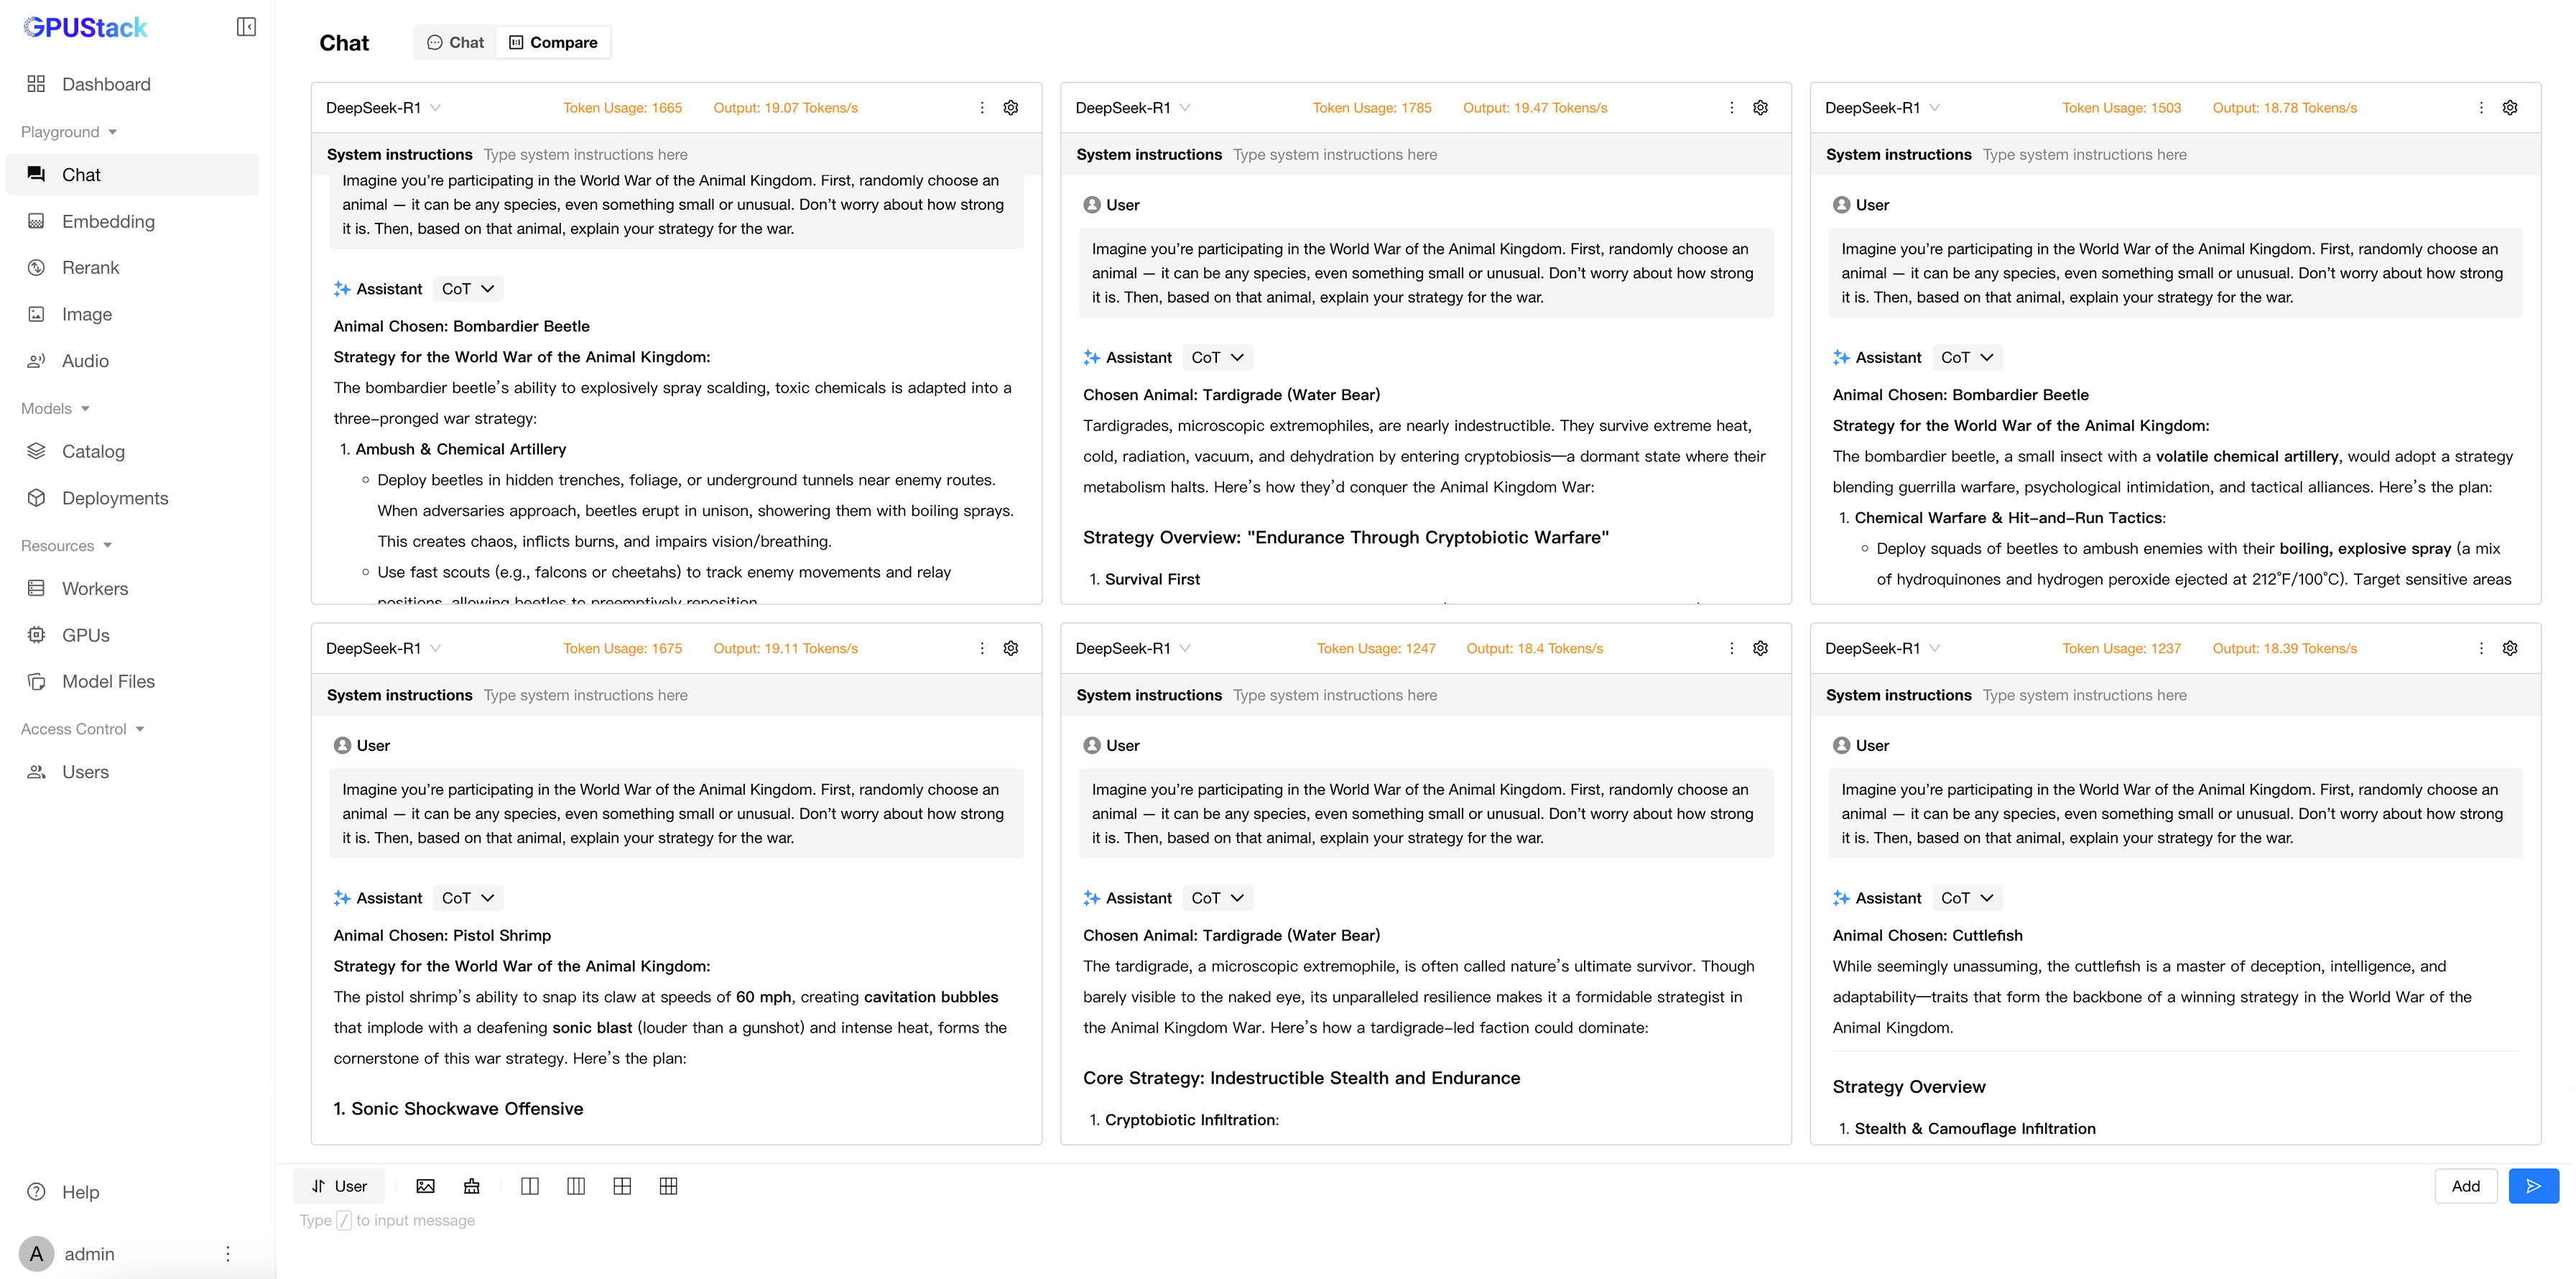
以上で、GPUStack クラスター上の分散 vLLM による DeepSeek R1 671B のデプロイと実行が完了しました。実際のアプリケーションでモデルの性能や機能を試してください。
さらに支援が必要な場合は、GPUStack コミュニティまたはサポートチームにお問い合わせください。