CPU での推論実行
GPUStack は CPU 推論に対応しており、GPU リソースが少ない場合や、モデルが割り当て可能な GPU メモリーより大きい場合にも柔軟に対応できます。次のモードを利用できます。
- CPU+GPU のハイブリッド推論:VRAM が不足する場合、大規模モデルの一部を CPU にオフロードし、部分的に GPU で高速化します。
- CPU のみの推論:GPU リソースがない場合、すべて CPU で実行します。
注記
カスタムバックエンドでのみ利用できます。
CPU オフロードを有効にすると、GPU リソースが不足する場合に GPUStack が CPU メモリーを割り当てます。バックエンドで CPU+GPU のハイブリッド推論または CPU 推論を正しく設定する必要があります。
CPU 推論は、CPU ワーカー上でのみ使用することを強く推奨します。
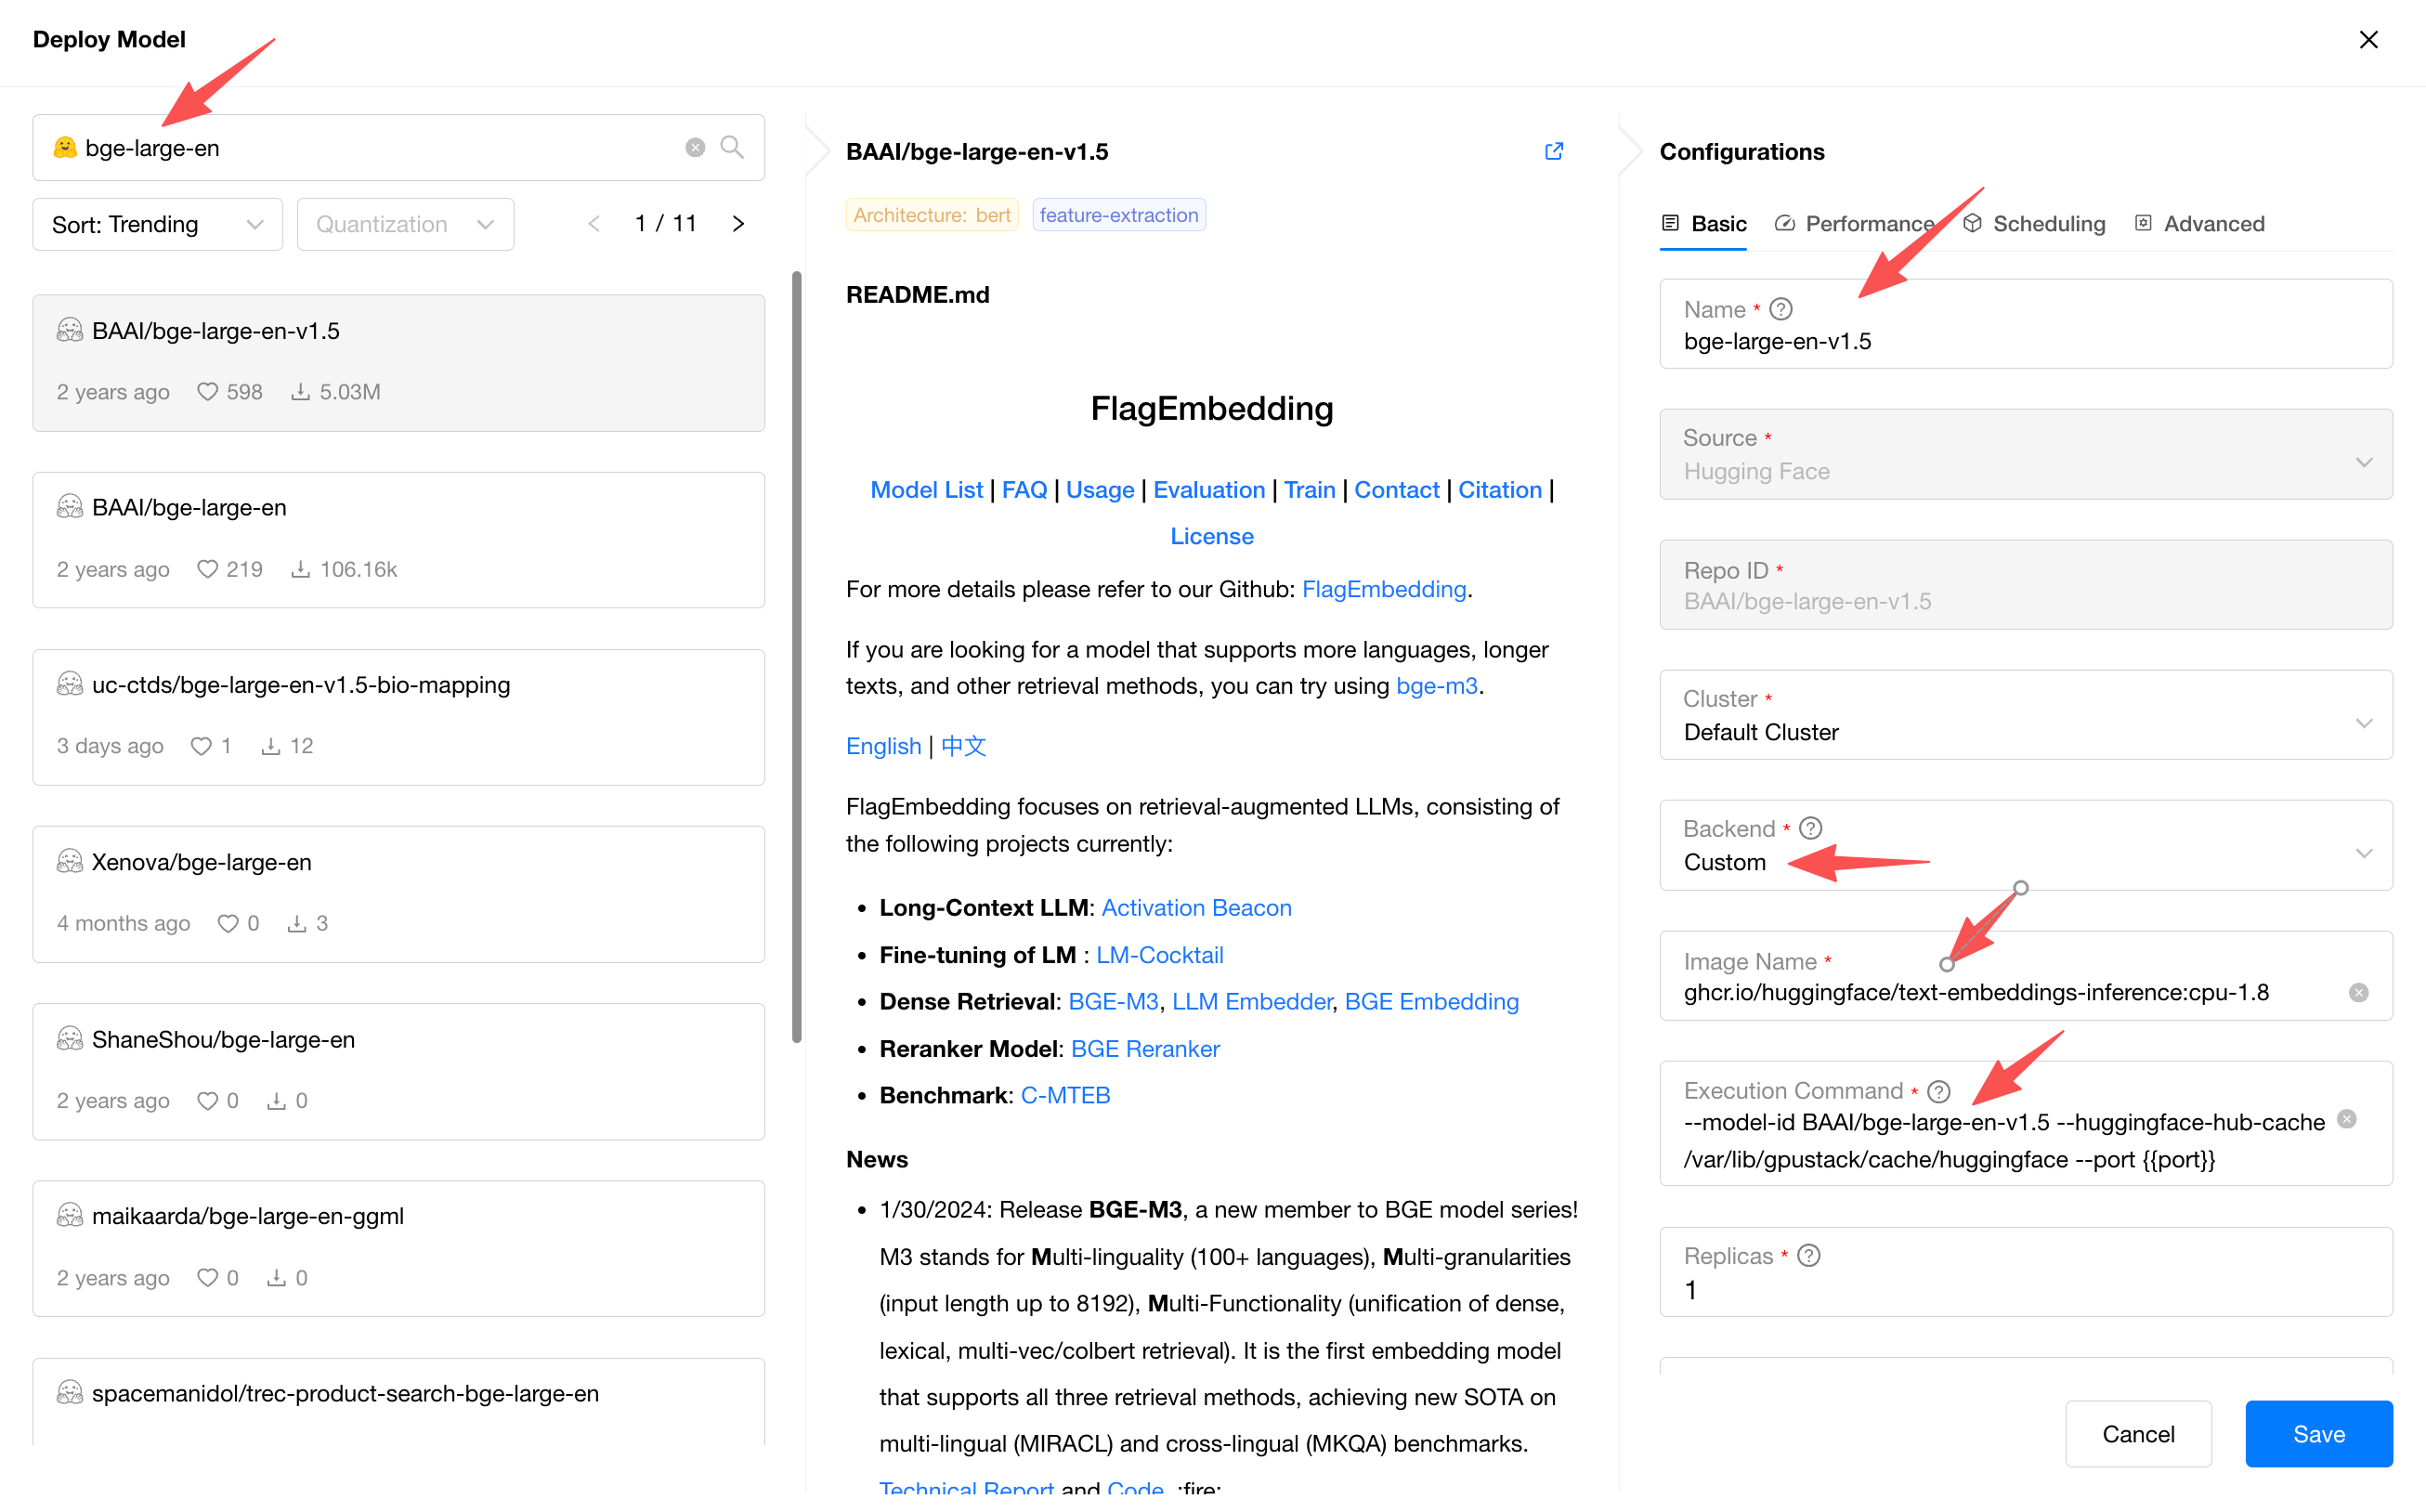
たとえば Text Embeddings Inference で CPU 推論モデルをデプロイするには、次のように設定します。
ソース:HuggingFace
リポジトリ ID:BAAI/bge-large-en-v1.5
バックエンド:Custom
イメージ名:ghcr.io/huggingface/text-embeddings-inference:cpu-1.8
実行コマンド:--model-id BAAI/bge-large-en-v1.5 --huggingface-hub-cache /var/lib/gpustack/cache/huggingface --port {{port}}
注記
TEI (Text Embeddings Inference) は HuggingFace からのモデルデプロイにのみ対応します。
ghcr.io/huggingface/text-embeddings-inference:cpu-1.8 は TEI の CPU 推論イメージです。TEI の対応ハードウェアを参照してください。
--huggingface-hub-cache /var/lib/gpustack/cache/huggingface は、TEI の HuggingFace Hub キャッシュを、GPUStack が取得した HuggingFace モデルの保存先に設定します。デフォルトは /var/lib/gpustack/cache/huggingface です。TEI CLI 引数を参照してください。
{{port}} は、GPUStack が自動割り当てするポートのプレースホルダーです。
Advanced Settings で Allow CPU Offloading にチェックを入れます。
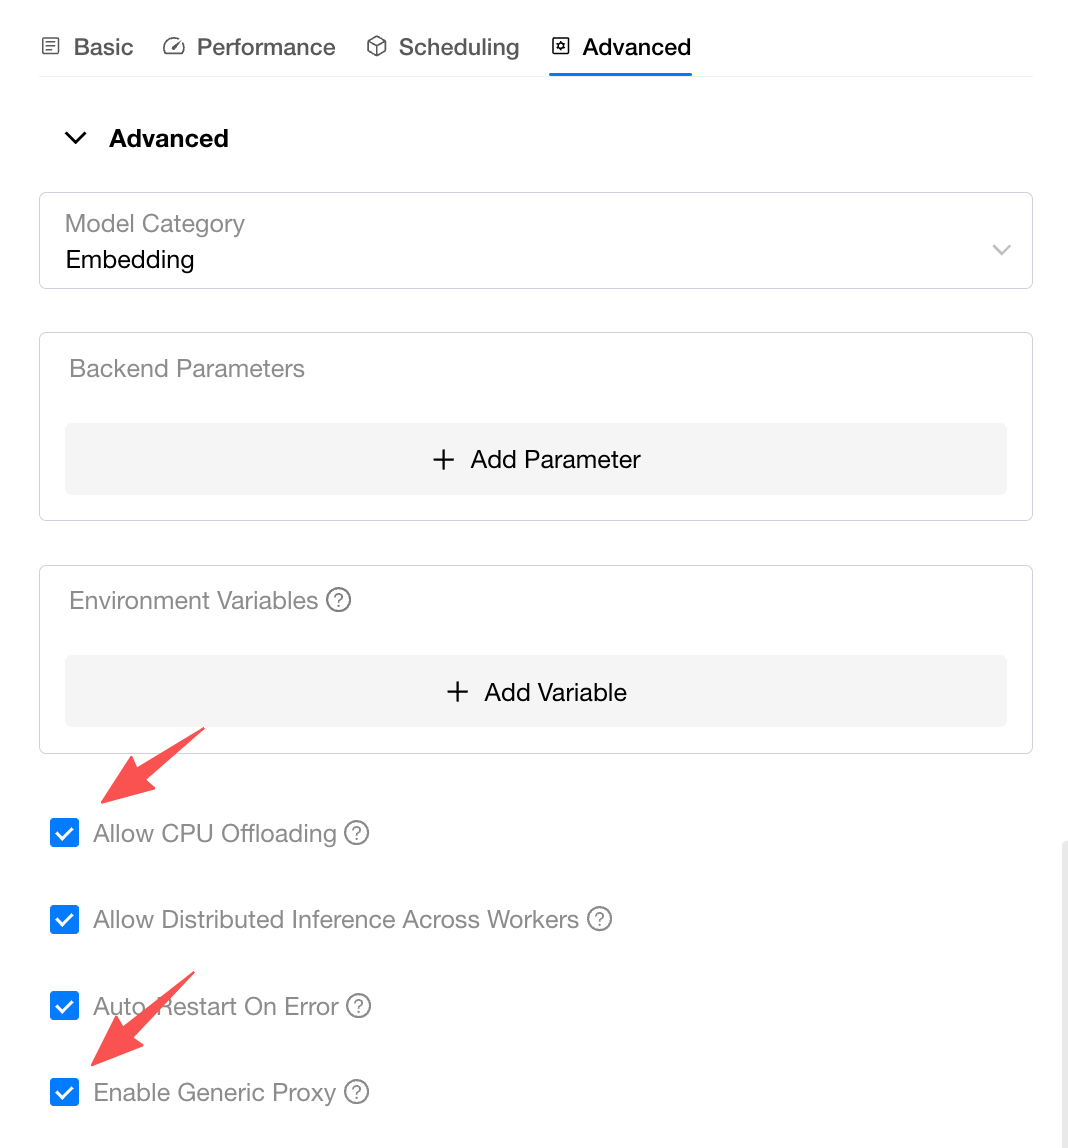
OpenAI 互換以外の API にアクセスする場合は、Enable Generic Proxy も有効にできます。
詳細は、汎用プロキシの有効化をご覧ください。