Qwen3.5-9B のレイテンシー最適化
結論
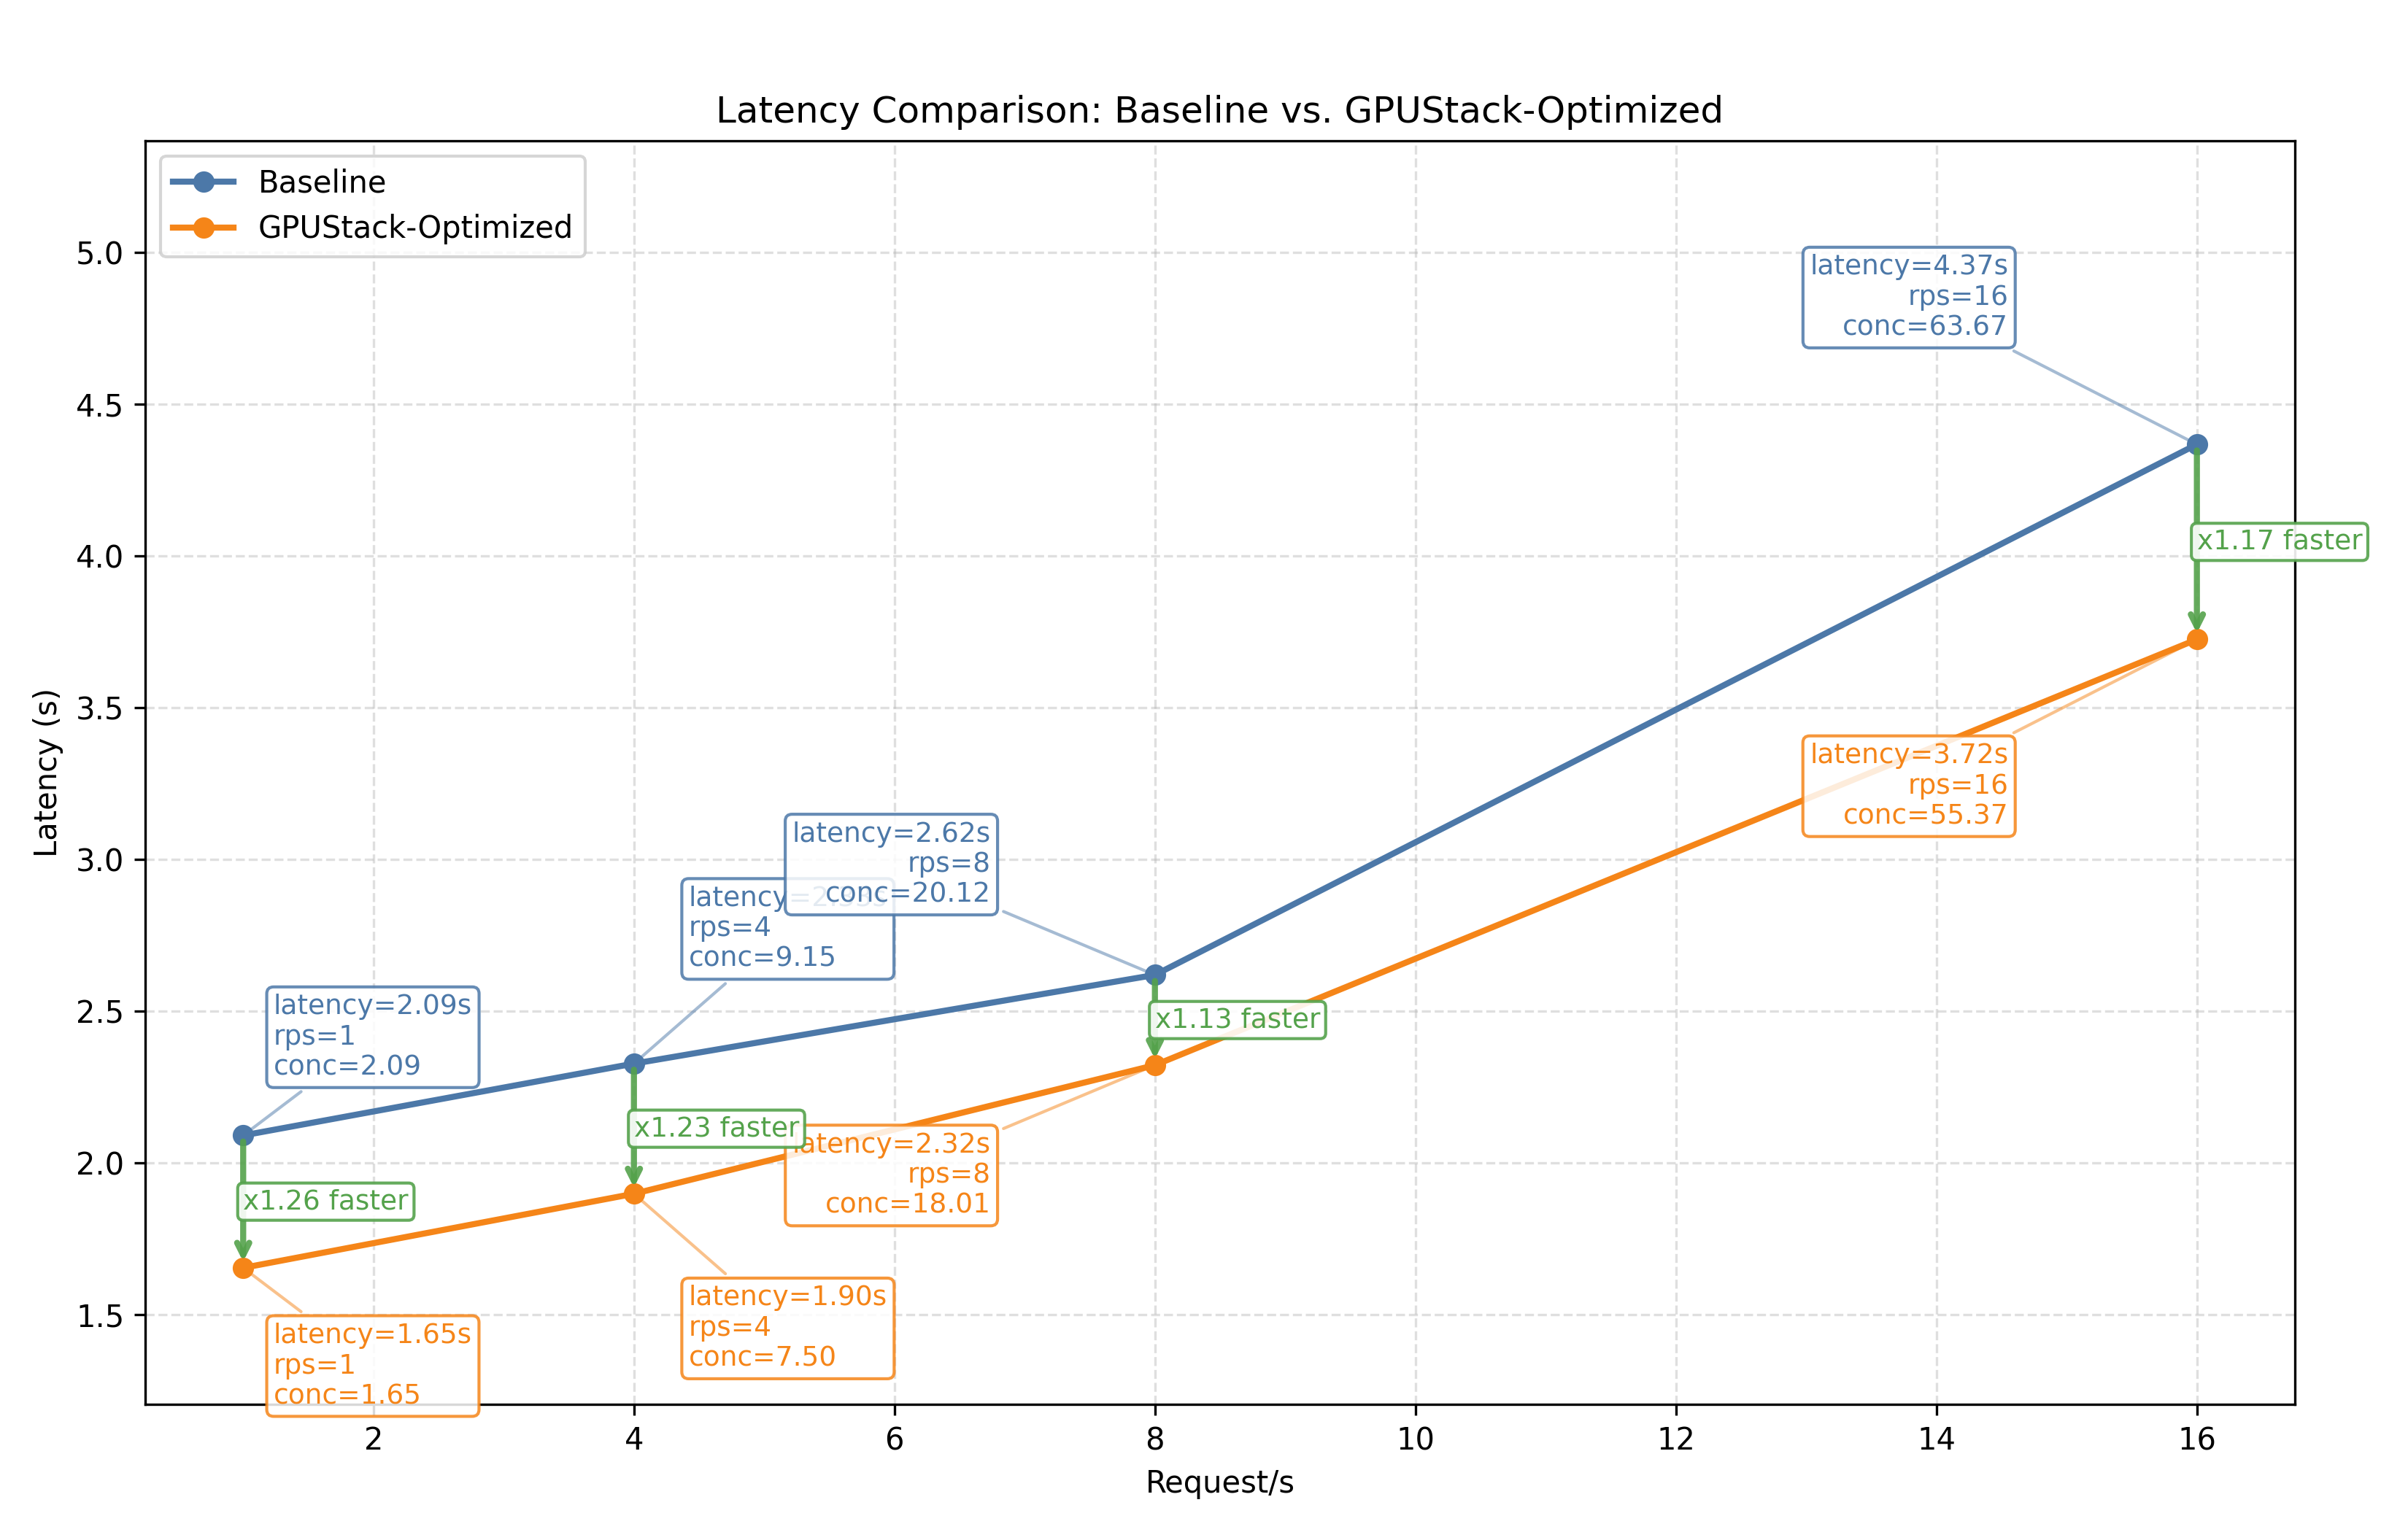
NVIDIA H100 80GB HBM3 上で Qwen/Qwen3.5-9B のレイテンシーを最適化するための推奨設定:
推論サービスのコマンド
| vllm serve Qwen/Qwen3.5-9B \
--reasoning-parser=qwen3 \
--max-model-len=32768 \
--speculative-config={"method":"mtp","num_speculative_tokens":1} \
--language-model-only \
--performance-mode=interactivity
|
最適化前後のベンチマーク結果の比較:
| ベンチマークケース | 基準設定(最適化なしの vLLM) | 最適化後 |
| Rate 1 | 平均レイテンシー: 2.09s/req | 平均レイテンシー: 1.65s/req (1.26x 高速) |
| Rate 4 | 平均レイテンシー: 2.33s/req | 平均レイテンシー: 1.90s/req (1.23x 高速) |
| Rate 8 | 平均レイテンシー: 2.62s/req | 平均レイテンシー: 2.32s/req (1.13x 高速) |
| Rate 16 | 平均レイテンシー: 4.37s/req | 平均レイテンシー: 3.72s/req (1.17x 高速) |
注記
- 本ベンチマークは、考えられるすべての最適化の組み合わせを網羅していません。たとえば、デフォルト設定で最も性能が高い推論エンジンを選び、それを追加調整の出発点としています。このような候補の絞り込みで得られるのは局所最適解であり、大域最適解とは限りません。
- 最大バッチサイズ、スケジューリング設定、拡張 KV キャッシュ、CUDA graph など、利用シナリオに応じた最適化もあります。本書の結論は、用途に合わせてさらに最適化するための出発点として利用できます。
- 本テストは特定のハードウェアとソフトウェアの構成で実施しています。推論エンジンの進化により、結論が変わる可能性があります。
- 量子化は精度に影響する場合がありますが、多くのモデルでは FP8 量子化による精度低下は 1% 未満です。詳細は評価結果を参照してください。そのため、低レイテンシーでのモデル提供には FP8 量子化を強く推奨します。
- 投機的デコーディングは、低並列度のリクエストのレイテンシーを大きく短縮できます。ただし、ベンチマークデータセットの分布やドラフトモデルの選択によって効果が異なります。たとえば、ここで選んだドラフトモデルは英語データで学習されているため、他の言語では十分な性能が得られない場合があります。
記載漏れや最新の変更を反映すべき点があれば、お知らせください。
実験環境
モデル
Qwen/Qwen3.5-9B
ハードウェア
NVIDIA H100 80GB HBM3
エンジンのバージョン
- vLLM v0.17.1
- SGLang v0.5.9
ベンチマーク手法
本プロジェクトでは、推論ワークロードに GPUStack のワンクリックベンチマーク機能を使用します。本書のベンチマークテストも、この手順で実行しました。
GPUStack のベンチマークは guidellm を基盤とし、ラッパープロジェクト benchmark-runner を介して実装されています。
以下に示すベンチマーク構成について、GPUStack がモデルのデプロイ、ベンチマークジョブの送信、結果の収集を処理します。
ベンチマークプロファイル
ShareGPT 8RPS
| dataset_name: ShareGPT
request_rate: 8
total_requests: 1000
|
ShareGPT 1RPS
| dataset_name: ShareGPT
request_rate: 1
total_requests: 1000
|
ShareGPT 4RPS
| dataset_name: ShareGPT
request_rate: 4
total_requests: 1000
|
ShareGPT 16RPS
| dataset_name: ShareGPT
request_rate: 16
total_requests: 1000
|
オープンソースツールによる代替手順
GPUStack を使用しない場合は、GPUStack のベンチマーク手順を直接 guidellm benchmark コマンドで置き換えることができます。
dataset_name: ShareGPT を指定したプロファイルの場合:
| guidellm benchmark \
--target ${target} \
--profile constant \
--rate ${request_rate} \
--max-requests ${total_requests} \
--processor ${model_path} \
--data ./ShareGPT_V3_unfiltered_cleaned_split.json
|
実験結果
推論エンジンの選択
vLLM
- プロファイル:
ShareGPT 8RPS - バックエンドパラメーター:
| --reasoning-parser=qwen3
--max-model-len=32768
|
ベンチマーク結果
| ============ Serving Benchmark Result ============
Successful requests: 1000
Maximum request concurrency: 31
Benchmark duration (s): 130.18
Total input tokens: 342058
Total generated tokens: 281412
Request throughput (req/s): 7.68
Output token throughput (tok/s): 2197.17
Peak output token throughput (tok/s): 2885041.51
Peak concurrent requests: 31.00
Total Token throughput (tok/s): 4867.84
----------------------Latency---------------------
Mean Latency(s): 2.62
Median Latency(s): 2.29
P95 Latency(s): 6.81
P99 Latency(s): 7.75
---------------Time to First Token----------------
Mean TTFT (ms): 41.12
Median TTFT (ms): 33.92
P95 TTFT (ms): 72.24
P99 TTFT (ms): 141.44
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms): 1.34
Median TPOT (ms): 0.11
P95 TPOT (ms): 9.18
P99 TPOT (ms): 10.07
---------------Inter-token Latency----------------
Mean ITL (ms): 1.19
Median ITL (ms): 0.00
P95 ITL (ms): 9.08
P99 ITL (ms): 10.04
==================================================
|
SGLang
- プロファイル:
ShareGPT 8RPS - バックエンドパラメーター:
| --reasoning-parser=qwen3
--context-length=32768
|
ベンチマーク結果
| ============ Serving Benchmark Result ============
Successful requests: 1000
Maximum request concurrency: 96
Benchmark duration (s): 131.60
Total input tokens: 342058
Total generated tokens: 281412
Request throughput (req/s): 7.60
Output token throughput (tok/s): 2145.85
Peak output token throughput (tok/s): 33380.30
Peak concurrent requests: 96.00
Total Token throughput (tok/s): 4754.13
----------------------Latency---------------------
Mean Latency(s): 8.13
Median Latency(s): 6.94
P95 Latency(s): 20.20
P99 Latency(s): 26.21
---------------Time to First Token----------------
Mean TTFT (ms): 98.72
Median TTFT (ms): 51.48
P95 TTFT (ms): 212.72
P99 TTFT (ms): 460.47
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms): 28.88
Median TPOT (ms): 28.26
P95 TPOT (ms): 43.34
P99 TPOT (ms): 51.52
---------------Inter-token Latency----------------
Mean ITL (ms): 28.63
Median ITL (ms): 27.88
P95 ITL (ms): 43.23
P99 ITL (ms): 50.55
==================================================
|
- 要約:
vLLM 平均レイテンシー = 2.62s, SGLang 平均レイテンシー = 8.13s. vLLM は 5.51 s 高速 (3.10x 高速). TTFT = 41.12 ms 対 98.72 ms, 短縮量 57.60 ms (2.40x 高速); TPOT = 1.34 ms 対 28.88 ms, 短縮量 27.54 ms (21.62x 高速).
プレフィックスキャッシュ
- プロファイル:
ShareGPT 8RPS - バックエンドパラメーター:
| --reasoning-parser=qwen3
--max-model-len=32768
--enable-prefix-caching
|
ベンチマーク結果
| ============ Serving Benchmark Result ============
Successful requests: 1000
Maximum request concurrency: 32
Benchmark duration (s): 130.23
Total input tokens: 342058
Total generated tokens: 281412
Request throughput (req/s): 7.68
Output token throughput (tok/s): 2212.47
Peak output token throughput (tok/s): 1443445.16
Peak concurrent requests: 32.00
Total Token throughput (tok/s): 4901.75
----------------------Latency---------------------
Mean Latency(s): 2.69
Median Latency(s): 2.36
P95 Latency(s): 6.95
P99 Latency(s): 7.94
---------------Time to First Token----------------
Mean TTFT (ms): 46.19
Median TTFT (ms): 34.75
P95 TTFT (ms): 90.30
P99 TTFT (ms): 233.30
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms): 1.38
Median TPOT (ms): 0.12
P95 TPOT (ms): 9.49
P99 TPOT (ms): 10.50
---------------Inter-token Latency----------------
Mean ITL (ms): 1.22
Median ITL (ms): 0.00
P95 ITL (ms): 9.35
P99 ITL (ms): 10.40
==================================================
|
最大バッチトークン数
16k
- プロファイル:
ShareGPT 8RPS - バックエンドパラメーター:
| --reasoning-parser=qwen3
--max-model-len=32768
--max-num-batched-tokens=16384
|
ベンチマーク結果
| ============ Serving Benchmark Result ============
Successful requests: 1000
Maximum request concurrency: 31
Benchmark duration (s): 130.20
Total input tokens: 342058
Total generated tokens: 281412
Request throughput (req/s): 7.68
Output token throughput (tok/s): 2220.17
Peak output token throughput (tok/s): 2763536.75
Peak concurrent requests: 31.00
Total Token throughput (tok/s): 4918.81
----------------------Latency---------------------
Mean Latency(s): 2.64
Median Latency(s): 2.30
P95 Latency(s): 6.87
P99 Latency(s): 7.79
---------------Time to First Token----------------
Mean TTFT (ms): 42.05
Median TTFT (ms): 34.13
P95 TTFT (ms): 76.02
P99 TTFT (ms): 190.03
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms): 1.26
Median TPOT (ms): 0.11
P95 TPOT (ms): 9.19
P99 TPOT (ms): 10.11
---------------Inter-token Latency----------------
Mean ITL (ms): 1.11
Median ITL (ms): 0.00
P95 ITL (ms): 9.13
P99 ITL (ms): 10.04
==================================================
|
32k
- プロファイル:
ShareGPT 8RPS - バックエンドパラメーター:
| --reasoning-parser=qwen3
--max-model-len=32768
--max-num-batched-tokens=32768
|
ベンチマーク結果
| ============ Serving Benchmark Result ============
Successful requests: 1000
Maximum request concurrency: 31
Benchmark duration (s): 130.20
Total input tokens: 342058
Total generated tokens: 281412
Request throughput (req/s): 7.68
Output token throughput (tok/s): 2196.67
Peak output token throughput (tok/s): 1167858.46
Peak concurrent requests: 31.00
Total Token throughput (tok/s): 4866.73
----------------------Latency---------------------
Mean Latency(s): 2.64
Median Latency(s): 2.31
P95 Latency(s): 6.88
P99 Latency(s): 7.81
---------------Time to First Token----------------
Mean TTFT (ms): 41.88
Median TTFT (ms): 34.03
P95 TTFT (ms): 76.91
P99 TTFT (ms): 164.85
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms): 1.38
Median TPOT (ms): 0.11
P95 TPOT (ms): 9.34
P99 TPOT (ms): 10.14
---------------Inter-token Latency----------------
Mean ITL (ms): 1.23
Median ITL (ms): 0.00
P95 ITL (ms): 9.20
P99 ITL (ms): 10.09
==================================================
|
- 要約:
16k 平均レイテンシー = 2.64s, 32k 平均レイテンシー = 2.64s. 16k は 0.00 s 高速 (1.00x 高速). TTFT = 42.05 ms 対 41.88 ms, 増加量 0.17 ms (1.00x 低速); TPOT = 1.26 ms 対 1.38 ms, 短縮量 0.12 ms (1.10x 高速).
最大シーケンス数
Seqs 128
- プロファイル:
ShareGPT 8RPS - バックエンドパラメーター:
| --reasoning-parser=qwen3
--max-model-len=32768
--max-num-seqs=128
|
ベンチマーク結果
| ============ Serving Benchmark Result ============
Successful requests: 1000
Maximum request concurrency: 31
Benchmark duration (s): 130.18
Total input tokens: 342058
Total generated tokens: 281412
Request throughput (req/s): 7.68
Output token throughput (tok/s): 2213.28
Peak output token throughput (tok/s): 3033763.06
Peak concurrent requests: 31.00
Total Token throughput (tok/s): 4903.53
----------------------Latency---------------------
Mean Latency(s): 2.66
Median Latency(s): 2.32
P95 Latency(s): 6.91
P99 Latency(s): 7.82
---------------Time to First Token----------------
Mean TTFT (ms): 44.11
Median TTFT (ms): 35.02
P95 TTFT (ms): 75.65
P99 TTFT (ms): 197.93
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms): 1.33
Median TPOT (ms): 0.11
P95 TPOT (ms): 9.53
P99 TPOT (ms): 10.28
---------------Inter-token Latency----------------
Mean ITL (ms): 1.17
Median ITL (ms): 0.00
P95 ITL (ms): 9.48
P99 ITL (ms): 10.23
==================================================
|
Seqs 256
- プロファイル:
ShareGPT 8RPS - バックエンドパラメーター:
| --reasoning-parser=qwen3
--max-model-len=32768
--max-num-seqs=256
|
ベンチマーク結果
| ============ Serving Benchmark Result ============
Successful requests: 1000
Maximum request concurrency: 31
Benchmark duration (s): 130.18
Total input tokens: 342058
Total generated tokens: 281412
Request throughput (req/s): 7.68
Output token throughput (tok/s): 2196.96
Peak output token throughput (tok/s): 1994998.46
Peak concurrent requests: 31.00
Total Token throughput (tok/s): 4867.37
----------------------Latency---------------------
Mean Latency(s): 2.64
Median Latency(s): 2.30
P95 Latency(s): 6.82
P99 Latency(s): 7.79
---------------Time to First Token----------------
Mean TTFT (ms): 42.97
Median TTFT (ms): 34.30
P95 TTFT (ms): 77.05
P99 TTFT (ms): 187.56
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms): 1.32
Median TPOT (ms): 0.11
P95 TPOT (ms): 9.23
P99 TPOT (ms): 10.28
---------------Inter-token Latency----------------
Mean ITL (ms): 1.17
Median ITL (ms): 0.00
P95 ITL (ms): 9.16
P99 ITL (ms): 10.16
==================================================
|
- 要約:
Seqs 256 平均レイテンシー = 2.64s, Seqs 128 平均レイテンシー = 2.66s. Seqs 256 は 0.02 s 高速 (1.01x 高速). TTFT = 42.97 ms 対 44.11 ms, 短縮量 1.13 ms (1.03x 高速); TPOT = 1.32 ms 対 1.33 ms, 短縮量 0.01 ms (1.01x 高速).
投機的デコーディング
- プロファイル:
ShareGPT 8RPS - バックエンドパラメーター:
| --reasoning-parser=qwen3
--speculative-config={"method":"mtp","num_speculative_tokens":1}
--max-model-len=32768
|
ベンチマーク結果
| ============ Serving Benchmark Result ============
Successful requests: 1000
Maximum request concurrency: 28
Benchmark duration (s): 129.03
Total input tokens: 342058
Total generated tokens: 281412
Request throughput (req/s): 7.75
Output token throughput (tok/s): 2224.24
Peak output token throughput (tok/s): 9620127.05
Peak concurrent requests: 28.00
Total Token throughput (tok/s): 4927.83
----------------------Latency---------------------
Mean Latency(s): 2.39
Median Latency(s): 2.08
P95 Latency(s): 6.12
P99 Latency(s): 7.17
---------------Time to First Token----------------
Mean TTFT (ms): 81.50
Median TTFT (ms): 55.93
P95 TTFT (ms): 96.41
P99 TTFT (ms): 788.19
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms): 1.29
Median TPOT (ms): 0.18
P95 TPOT (ms): 8.45
P99 TPOT (ms): 9.48
---------------Inter-token Latency----------------
Mean ITL (ms): 1.01
Median ITL (ms): 0.00
P95 ITL (ms): 8.31
P99 ITL (ms): 9.42
==================================================
|
- プロファイル:
ShareGPT 8RPS - バックエンドパラメーター:
| --reasoning-parser=qwen3
--performance-mode=interactivity
--max-model-len=32768
--speculative-config={"method":"mtp","num_speculative_tokens":1}
|
ベンチマーク結果
| ============ Serving Benchmark Result ============
Successful requests: 1000
Maximum request concurrency: 28
Benchmark duration (s): 129.07
Total input tokens: 342058
Total generated tokens: 281412
Request throughput (req/s): 7.75
Output token throughput (tok/s): 2214.80
Peak output token throughput (tok/s): 1904162.55
Peak concurrent requests: 28.00
Total Token throughput (tok/s): 4906.90
----------------------Latency---------------------
Mean Latency(s): 2.38
Median Latency(s): 2.09
P95 Latency(s): 6.09
P99 Latency(s): 7.20
---------------Time to First Token----------------
Mean TTFT (ms): 82.37
Median TTFT (ms): 55.71
P95 TTFT (ms): 96.16
P99 TTFT (ms): 960.28
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms): 1.42
Median TPOT (ms): 0.18
P95 TPOT (ms): 8.54
P99 TPOT (ms): 9.65
---------------Inter-token Latency----------------
Mean ITL (ms): 1.13
Median ITL (ms): 0.00
P95 ITL (ms): 8.39
P99 ITL (ms): 9.08
==================================================
|
- プロファイル:
ShareGPT 8RPS - バックエンドパラメーター:
| --reasoning-parser=qwen3
--max-model-len=32768
--speculative-config={"method":"mtp","num_speculative_tokens":1}
--language-model-only
--performance-mode=interactivity
|
ベンチマーク結果
| ============ Serving Benchmark Result ============
Successful requests: 1000
Maximum request concurrency: 27
Benchmark duration (s): 128.98
Total input tokens: 342058
Total generated tokens: 281412
Request throughput (req/s): 7.75
Output token throughput (tok/s): 2214.46
Peak output token throughput (tok/s): 4861500.66
Peak concurrent requests: 27.00
Total Token throughput (tok/s): 4906.15
----------------------Latency---------------------
Mean Latency(s): 2.32
Median Latency(s): 2.02
P95 Latency(s): 5.99
P99 Latency(s): 6.89
---------------Time to First Token----------------
Mean TTFT (ms): 80.63
Median TTFT (ms): 54.04
P95 TTFT (ms): 96.82
P99 TTFT (ms): 933.41
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms): 1.31
Median TPOT (ms): 0.17
P95 TPOT (ms): 8.19
P99 TPOT (ms): 9.47
---------------Inter-token Latency----------------
Mean ITL (ms): 1.02
Median ITL (ms): 0.00
P95 ITL (ms): 8.03
P99 ITL (ms): 8.91
==================================================
|
最適化項目の一覧
| ベンチマークケース | グループ | 最適化後 | 基準設定 | 比較 |
| ShareGPT 8RPS (r=8) | 推論エンジンの選択 | 2.62s | 2.62s | (1.00x 高速) |
| ShareGPT 8RPS (r=8) | プレフィックスキャッシュ | 2.69s | 2.62s | (1.03x 低速) |
| ShareGPT 8RPS (r=8) | 最大バッチトークン数 | 2.64s | 2.62s | (1.01x 低速) |
| ShareGPT 8RPS (r=8) | 最大シーケンス数 | 2.64s | 2.62s | (1.01x 低速) |
| ShareGPT 8RPS (r=8) | 投機的デコーディング | 2.39s | 2.62s | (1.09x 高速) |
| ShareGPT 8RPS (r=8) | 投機的デコーディング && パフォーマンスモード | 2.38s | 2.62s | (1.10x 高速) |
| ShareGPT 8RPS (r=8) | 投機的デコーディング && パフォーマンスモード && 言語モデル | 2.32s | 2.62s | (1.13x 高速) |
その他のベンチマークケース
レート 1
- 基準設定のバックエンドパラメーター:
| --reasoning-parser=qwen3
--max-model-len=32768
|
基準設定のベンチマーク結果
| ============ Serving Benchmark Result ============
Successful requests: 1000
Maximum request concurrency: 6
Benchmark duration (s): 1001.23
Total input tokens: 342058
Total generated tokens: 281412
Request throughput (req/s): 1.00
Output token throughput (tok/s): 281.69
Peak output token throughput (tok/s): 211793.17
Peak concurrent requests: 6.00
Total Token throughput (tok/s): 624.09
----------------------Latency---------------------
Mean Latency(s): 2.09
Median Latency(s): 1.85
P95 Latency(s): 5.42
P99 Latency(s): 6.27
---------------Time to First Token----------------
Mean TTFT (ms): 37.03
Median TTFT (ms): 31.51
P95 TTFT (ms): 63.17
P99 TTFT (ms): 95.35
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms): 0.94
Median TPOT (ms): 0.10
P95 TPOT (ms): 7.38
P99 TPOT (ms): 7.51
---------------Inter-token Latency----------------
Mean ITL (ms): 0.81
Median ITL (ms): 0.00
P95 ITL (ms): 7.34
P99 ITL (ms): 7.47
==================================================
|
- 最適化後のバックエンドパラメーター:
| --reasoning-parser=qwen3
--max-model-len=32768
--speculative-config={"method":"mtp","num_speculative_tokens":1}
--language-model-only
--performance-mode=interactivity
|
最適化後のベンチマーク結果
| ============ Serving Benchmark Result ============
Successful requests: 1000
Maximum request concurrency: 5
Benchmark duration (s): 1000.35
Total input tokens: 342058
Total generated tokens: 281412
Request throughput (req/s): 1.00
Output token throughput (tok/s): 281.69
Peak output token throughput (tok/s): 271386.26
Peak concurrent requests: 5.00
Total Token throughput (tok/s): 624.08
----------------------Latency---------------------
Mean Latency(s): 1.65
Median Latency(s): 1.45
P95 Latency(s): 4.28
P99 Latency(s): 4.98
---------------Time to First Token----------------
Mean TTFT (ms): 54.58
Median TTFT (ms): 50.45
P95 TTFT (ms): 75.37
P99 TTFT (ms): 123.14
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms): 0.91
Median TPOT (ms): 0.15
P95 TPOT (ms): 5.90
P99 TPOT (ms): 6.22
---------------Inter-token Latency----------------
Mean ITL (ms): 0.72
Median ITL (ms): 0.00
P95 ITL (ms): 5.75
P99 ITL (ms): 6.14
==================================================
|
レート 4
- 基準設定のバックエンドパラメーター:
| --reasoning-parser=qwen3
--max-model-len=32768
|
基準設定のベンチマーク結果
| ============ Serving Benchmark Result ============
Successful requests: 1000
Maximum request concurrency: 15
Benchmark duration (s): 254.36
Total input tokens: 342058
Total generated tokens: 281412
Request throughput (req/s): 3.93
Output token throughput (tok/s): 1126.78
Peak output token throughput (tok/s): 800262.91
Peak concurrent requests: 15.00
Total Token throughput (tok/s): 2496.39
----------------------Latency---------------------
Mean Latency(s): 2.33
Median Latency(s): 2.06
P95 Latency(s): 5.96
P99 Latency(s): 6.94
---------------Time to First Token----------------
Mean TTFT (ms): 38.09
Median TTFT (ms): 31.67
P95 TTFT (ms): 67.05
P99 TTFT (ms): 109.44
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms): 1.15
Median TPOT (ms): 0.10
P95 TPOT (ms): 8.25
P99 TPOT (ms): 8.73
---------------Inter-token Latency----------------
Mean ITL (ms): 1.02
Median ITL (ms): 0.00
P95 ITL (ms): 8.19
P99 ITL (ms): 8.67
==================================================
|
- 最適化後のバックエンドパラメーター:
| --reasoning-parser=qwen3
--max-model-len=32768
--speculative-config={"method":"mtp","num_speculative_tokens":1}
--language-model-only
--performance-mode=interactivity
|
最適化後のベンチマーク結果
| ============ Serving Benchmark Result ============
Successful requests: 1000
Maximum request concurrency: 13
Benchmark duration (s): 253.27
Total input tokens: 342058
Total generated tokens: 281412
Request throughput (req/s): 3.95
Output token throughput (tok/s): 1126.67
Peak output token throughput (tok/s): 996666.30
Peak concurrent requests: 13.00
Total Token throughput (tok/s): 2496.15
----------------------Latency---------------------
Mean Latency(s): 1.90
Median Latency(s): 1.66
P95 Latency(s): 4.91
P99 Latency(s): 5.82
---------------Time to First Token----------------
Mean TTFT (ms): 57.94
Median TTFT (ms): 52.57
P95 TTFT (ms): 77.15
P99 TTFT (ms): 112.48
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms): 0.97
Median TPOT (ms): 0.16
P95 TPOT (ms): 6.79
P99 TPOT (ms): 7.25
---------------Inter-token Latency----------------
Mean ITL (ms): 0.76
Median ITL (ms): 0.00
P95 ITL (ms): 6.64
P99 ITL (ms): 7.11
==================================================
|
レート 8
- 基準設定のバックエンドパラメーター:
| --reasoning-parser=qwen3
--max-model-len=32768
|
基準設定のベンチマーク結果
| ============ Serving Benchmark Result ============
Successful requests: 1000
Maximum request concurrency: 31
Benchmark duration (s): 130.18
Total input tokens: 342058
Total generated tokens: 281412
Request throughput (req/s): 7.68
Output token throughput (tok/s): 2197.17
Peak output token throughput (tok/s): 2885041.51
Peak concurrent requests: 31.00
Total Token throughput (tok/s): 4867.84
----------------------Latency---------------------
Mean Latency(s): 2.62
Median Latency(s): 2.29
P95 Latency(s): 6.81
P99 Latency(s): 7.75
---------------Time to First Token----------------
Mean TTFT (ms): 41.12
Median TTFT (ms): 33.92
P95 TTFT (ms): 72.24
P99 TTFT (ms): 141.44
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms): 1.34
Median TPOT (ms): 0.11
P95 TPOT (ms): 9.18
P99 TPOT (ms): 10.07
---------------Inter-token Latency----------------
Mean ITL (ms): 1.19
Median ITL (ms): 0.00
P95 ITL (ms): 9.08
P99 ITL (ms): 10.04
==================================================
|
- 最適化後のバックエンドパラメーター:
| --reasoning-parser=qwen3
--max-model-len=32768
--speculative-config={"method":"mtp","num_speculative_tokens":1}
--language-model-only
--performance-mode=interactivity
|
最適化後のベンチマーク結果
| ============ Serving Benchmark Result ============
Successful requests: 1000
Maximum request concurrency: 27
Benchmark duration (s): 128.98
Total input tokens: 342058
Total generated tokens: 281412
Request throughput (req/s): 7.75
Output token throughput (tok/s): 2214.46
Peak output token throughput (tok/s): 4861500.66
Peak concurrent requests: 27.00
Total Token throughput (tok/s): 4906.15
----------------------Latency---------------------
Mean Latency(s): 2.32
Median Latency(s): 2.02
P95 Latency(s): 5.99
P99 Latency(s): 6.89
---------------Time to First Token----------------
Mean TTFT (ms): 80.63
Median TTFT (ms): 54.04
P95 TTFT (ms): 96.82
P99 TTFT (ms): 933.41
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms): 1.31
Median TPOT (ms): 0.17
P95 TPOT (ms): 8.19
P99 TPOT (ms): 9.47
---------------Inter-token Latency----------------
Mean ITL (ms): 1.02
Median ITL (ms): 0.00
P95 ITL (ms): 8.03
P99 ITL (ms): 8.91
==================================================
|
レート 16
- 基準設定のバックエンドパラメーター:
| --reasoning-parser=qwen3
--max-model-len=32768
|
基準設定のベンチマーク結果
| ============ Serving Benchmark Result ============
Successful requests: 1000
Maximum request concurrency: 97
Benchmark duration (s): 68.59
Total input tokens: 342058
Total generated tokens: 281412
Request throughput (req/s): 14.58
Output token throughput (tok/s): 4119.85
Peak output token throughput (tok/s): 4297231.71
Peak concurrent requests: 97.00
Total Token throughput (tok/s): 9127.56
----------------------Latency---------------------
Mean Latency(s): 4.37
Median Latency(s): 3.74
P95 Latency(s): 10.93
P99 Latency(s): 14.05
---------------Time to First Token----------------
Mean TTFT (ms): 63.36
Median TTFT (ms): 52.12
P95 TTFT (ms): 111.22
P99 TTFT (ms): 283.00
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms): 2.07
Median TPOT (ms): 0.17
P95 TPOT (ms): 16.46
P99 TPOT (ms): 18.09
---------------Inter-token Latency----------------
Mean ITL (ms): 1.85
Median ITL (ms): 0.00
P95 ITL (ms): 16.34
P99 ITL (ms): 17.94
==================================================
|
- 最適化後のバックエンドパラメーター:
| --reasoning-parser=qwen3
--max-model-len=32768
--speculative-config={"method":"mtp","num_speculative_tokens":1}
--language-model-only
--performance-mode=interactivity
|
最適化後のベンチマーク結果
| ============ Serving Benchmark Result ============
Successful requests: 1000
Maximum request concurrency: 77
Benchmark duration (s): 67.27
Total input tokens: 342058
Total generated tokens: 281412
Request throughput (req/s): 14.86
Output token throughput (tok/s): 4191.07
Peak output token throughput (tok/s): 3207595.57
Peak concurrent requests: 77.00
Total Token throughput (tok/s): 9285.35
----------------------Latency---------------------
Mean Latency(s): 3.72
Median Latency(s): 3.31
P95 Latency(s): 9.44
P99 Latency(s): 11.45
---------------Time to First Token----------------
Mean TTFT (ms): 81.88
Median TTFT (ms): 66.01
P95 TTFT (ms): 149.68
P99 TTFT (ms): 375.11
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms): 1.92
Median TPOT (ms): 0.22
P95 TPOT (ms): 13.69
P99 TPOT (ms): 15.01
---------------Inter-token Latency----------------
Mean ITL (ms): 1.63
Median ITL (ms): 0.00
P95 ITL (ms): 13.50
P99 ITL (ms): 14.78
==================================================
|