GPU 服务实例类型
GPU 服务实例类型描述用于创建 GPU 服务实例的计算规格,可以是纯 CPU,也可以配备加速器。
GPUStack Operator 支持多个厂商的加速器,包括 AMD、昇腾、寒武纪、海光、天数智芯、沐曦、摩尔线程、NVIDIA 和平头哥。各厂商的加速器均可按独占(整块设备)、共享或逻辑切分(通过软件拆分,具有独立的 VRAM 和计算资源配额)方式分配。NVIDIA、平头哥和海光还支持物理分区(MIG),由硬件对设备进行分割。各厂商的详细支持情况参见 Operator 的加速器支持矩阵。
浏览实例类型
打开 GPU Service > Instance Types。页面列出你有权查看的所有 GPU 服务集群的实例类型,每一行都会标明所属集群:
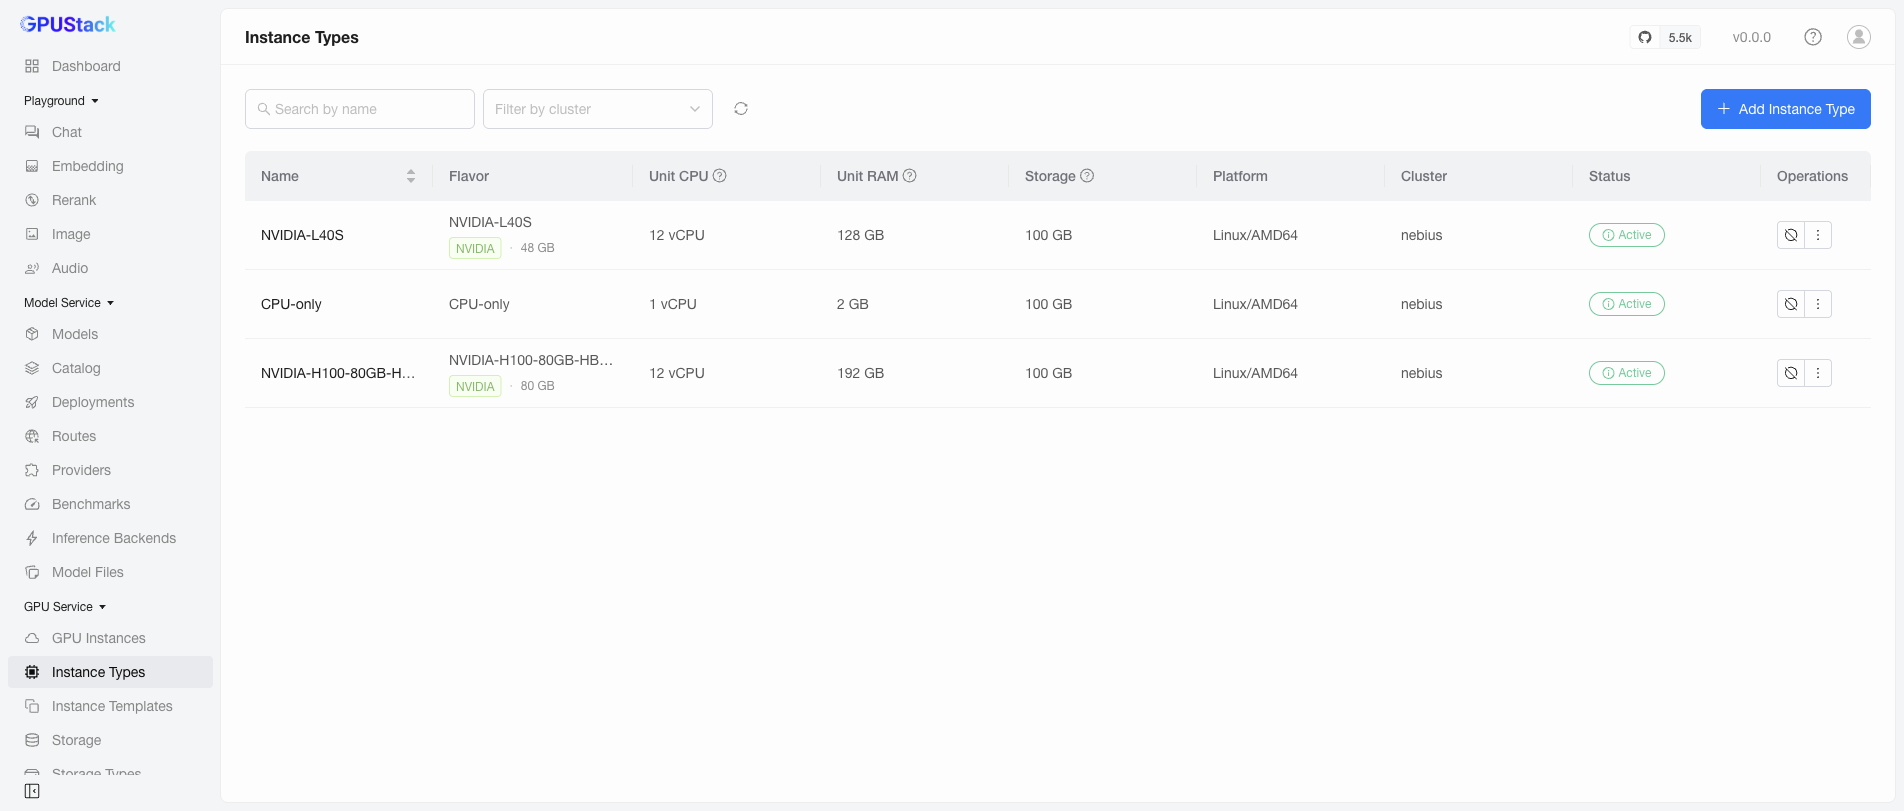
- Name / Flavor:类型名称(或其显示名称)及所属设备规格,例如
NVIDIA-H100-80GB-HBM3或CPU-only。 - Unit CPU / Unit RAM / Storage:该类型每单位分配的主机资源。对于加速器规格,一单位指一块完整设备;创建逻辑切片和物理分区时,会以此为基础计算资源。
- Platform:操作系统和 CPU 架构,用于选择兼容镜像。
- Cluster:该类型所属的集群。
- Status:
Active类型可在 Add GPU Instance 表单中选择;Inactive类型不可选择。
使用工具栏中的 Filter by cluster 选择器可将列表限制为单个集群;使用搜索框可按显示名称或名称匹配类型,即 Name 列可能显示的任意一个值。筛选、排序和分页都在 GPUStack Server 端执行;对 Name 列排序时,按实际显示的标签排序。停用、启用、删除等行操作始终作用于该行 Cluster 列所指明的集群。
此列表是控制平面中的记录,并非每次都从各集群实时读取;集群不可达时,行中显示的是最后一次观测到的状态。以下实时容量视图仍是判断当前剩余容量的依据。
也可以使用 kubectl 读取各类型的实时容量。四种加速器视图分别是独占 EX、共享 SH、逻辑切片 SL 和物理分区 PT;加速器视图及 CPU 列都以 onceMaxRequest/remaining 格式显示:
在上述新添加集群的输出中,H100 类型提供一块可独占使用的完整设备(EX 1/1)、十个共享槽位(SH 10/10)、完整逻辑切片配额(SL 100/100),以及七个 MIG 分区槽位(PT 1/7,来自第二个启用 MIG 的 H100 节点)。L40S 类型以同样方式提供其单块设备,但不支持分区(PT 0/0,L40S 没有 MIG);通用纯 CPU 类型则完全不包含加速器容量。
派生实例类型
当 GPU 服务集群上的 Derive Instance Types from Nodes 为 Enabled(默认值)时,Operator 会发现各节点的设备并自动创建匹配的实例类型:每种加速器型号对应一个类型,另加一个纯 CPU 类型。上面的列表就是这样的派生集合。
派生类型的每单位 CPU/RAM 来自 Operator 维护的各产品预设,详见实例类型单位资源参考。存储容量始终为 100 GiB,派生纯 CPU 类型始终为 1 CPU / 2 GiB RAM。
派生类型由 Operator 管理:
- 不能通过 UI 删除,其
Delete操作会被禁用:
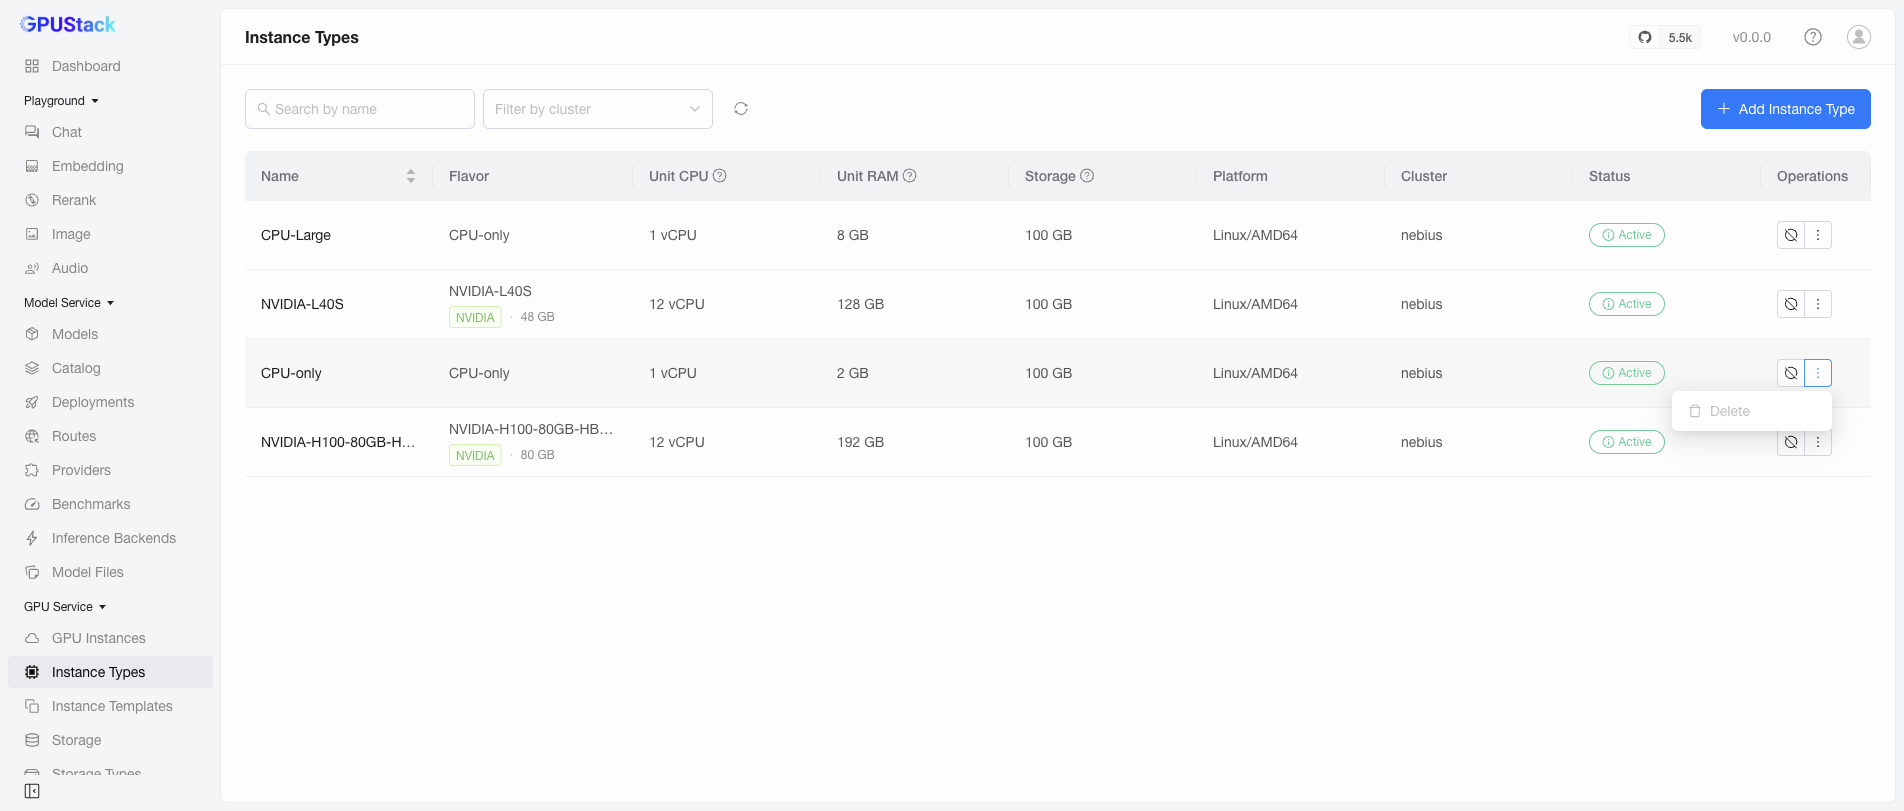
- 使用
kubectl删除同样无法持久生效:Operator 会在下一次协调同步时重新创建它。(实际上,按这种方式重新创建派生类型,是 Operator 升级后调整其资源大小的受支持方式,因为单位资源只在创建时写入。)
要永久移除派生类型,请先在集群上将 Derive Instance Types from Nodes 设置为 Disabled(参见集群的高级选项);Operator 随后会停止创建类型,已有派生类型便可删除。
添加实例类型
派生类型不满足需求时,可以添加自定义实例类型,例如资源更大的纯 CPU 规格。单击 Add Instance Type 并填写表单:
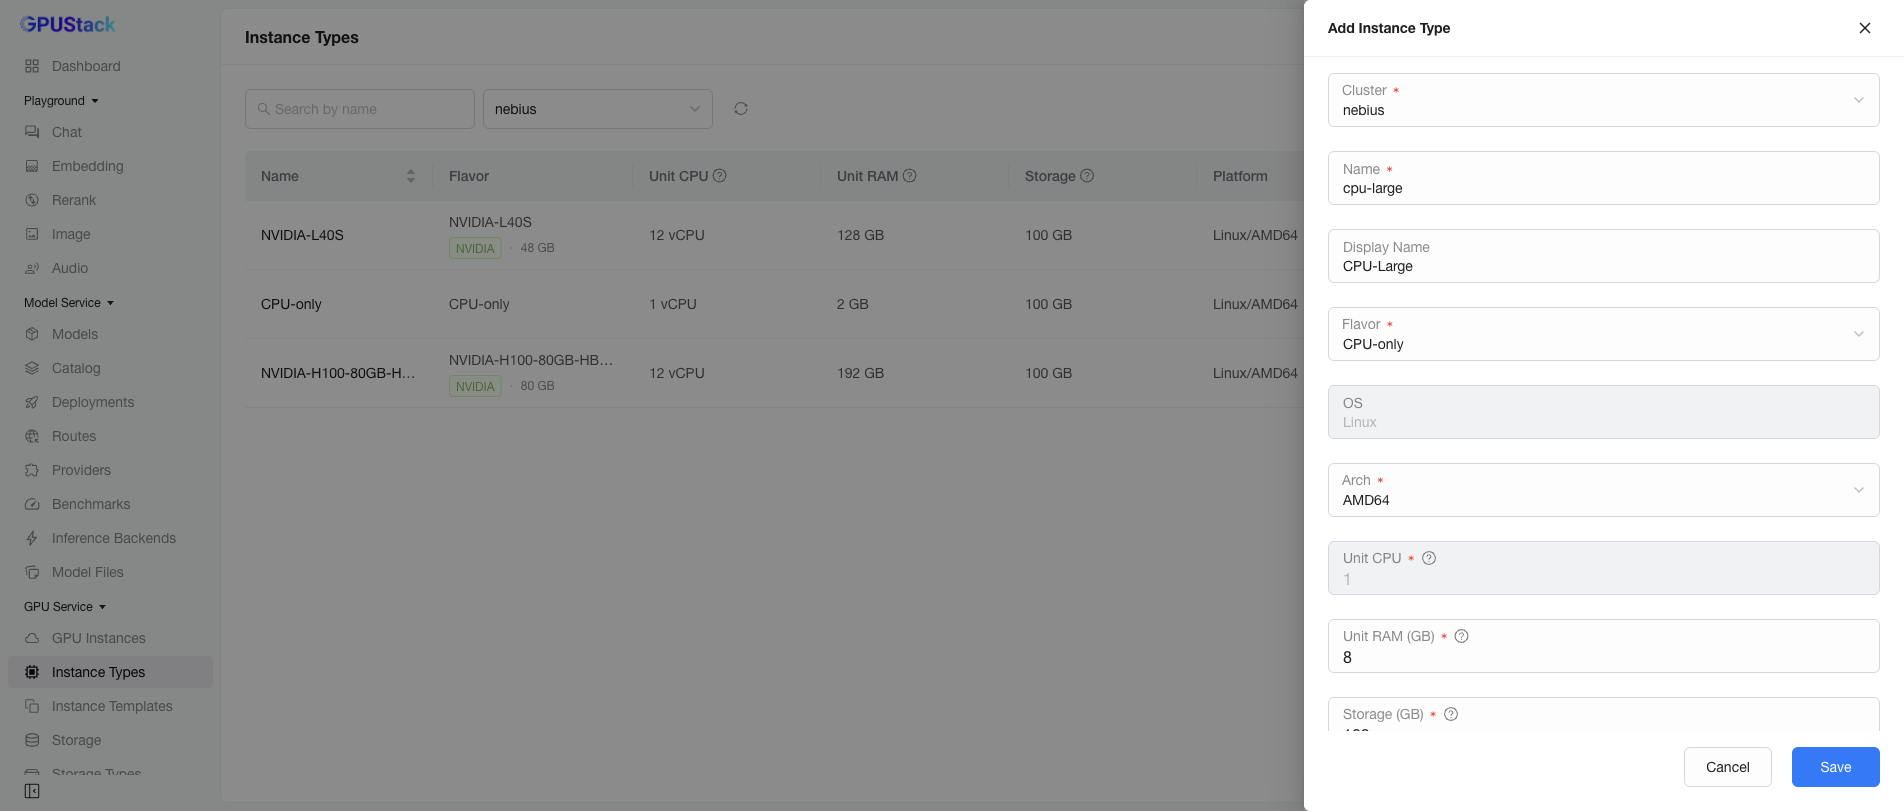
- Cluster:创建该类型的集群。
- Name:类型名称。由于会成为底层资源名称的一部分,必须为小写且符合 Kubernetes 命名规则。它在集群内必须唯一;重复使用已有类型(包括派生类型)的名称会被拒绝,不会覆盖已有类型。
- Display Name:可选的易读名称,显示在 UI 中。
- Flavor:
CPU-only,或所选集群包含的加速器规格。可选项随 Cluster 字段变化。 - OS / Arch:该类型面向的平台。
- Unit CPU / Unit RAM / Storage:每单位分配的主机资源。
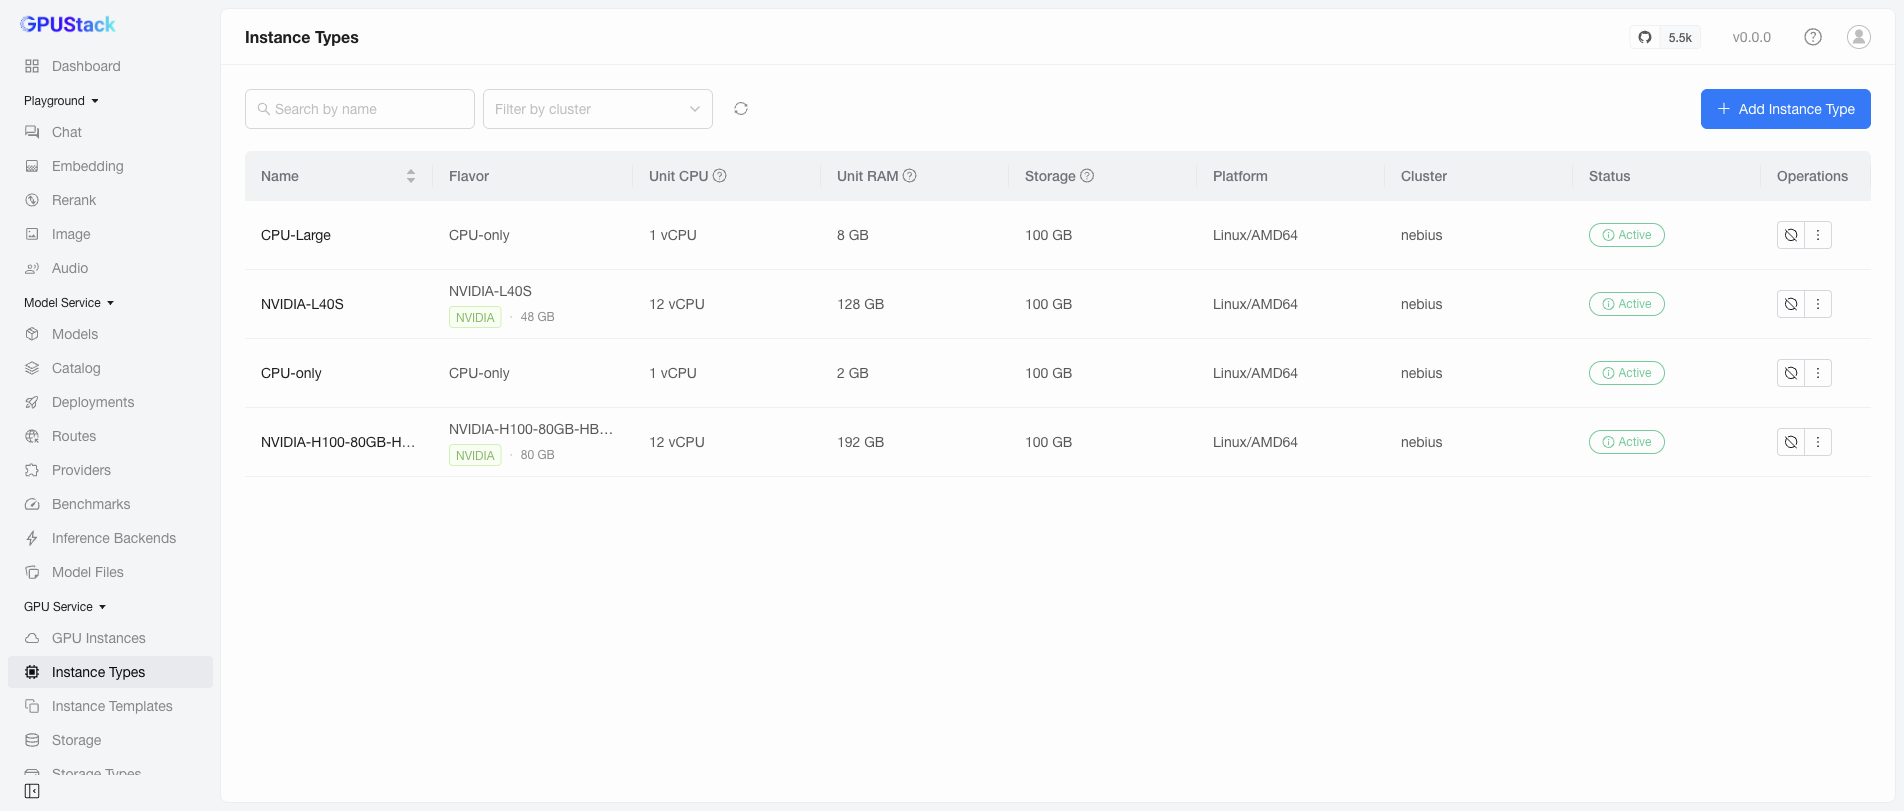
单击 Save。新类型会显示在列表和 Add GPU Instance 表单中:
说明
Operator 不会修改自定义实例类型。派生流程只创建类型,从不修改它并非刚刚创建的类型。
停用和启用实例类型
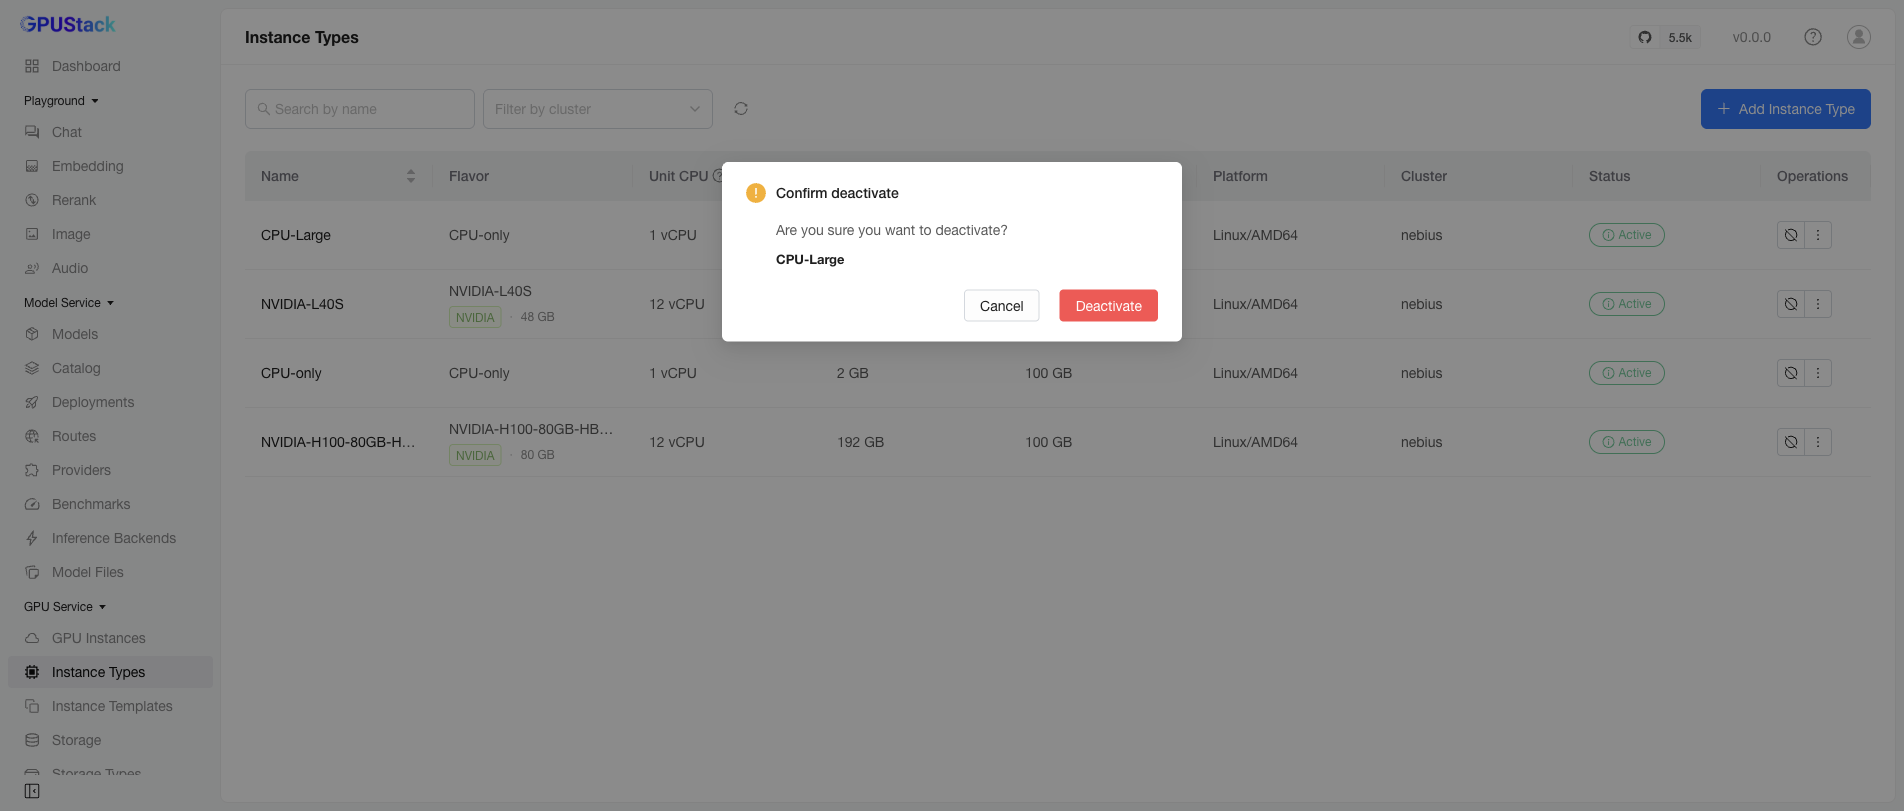
停用类型可以阻止从该类型创建新实例,而无需删除类型。在类型所在行单击停用操作并确认:
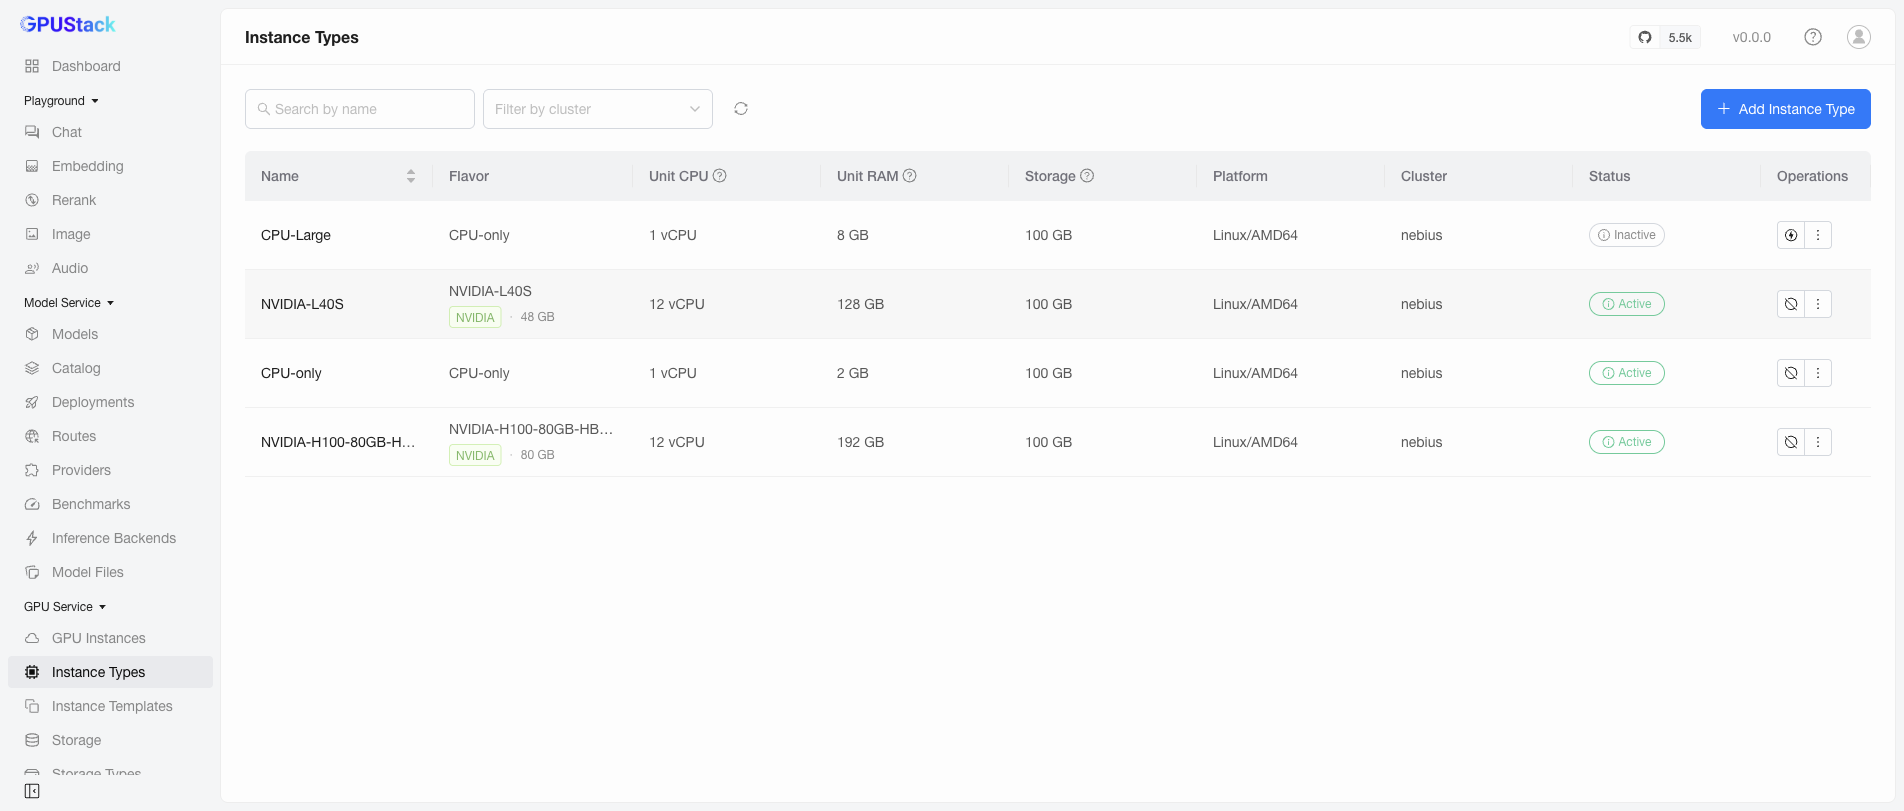
该类型会变为 Inactive,无法再在 Add GPU Instance 表单中选择:
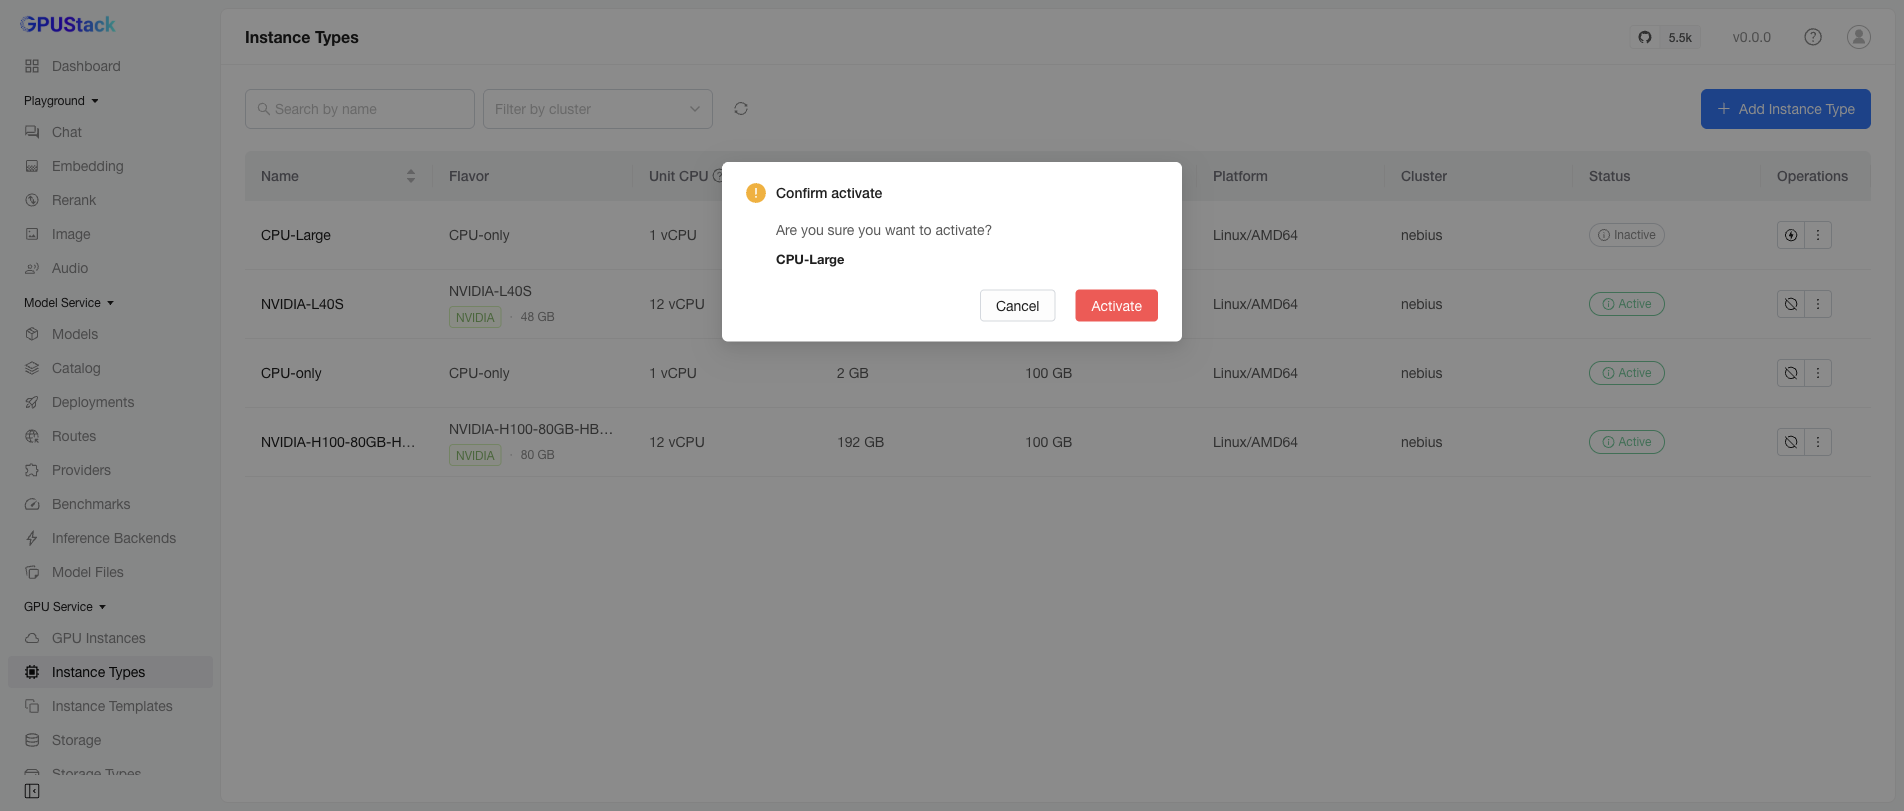
再次单击同一操作并确认,可重新启用:
删除实例类型
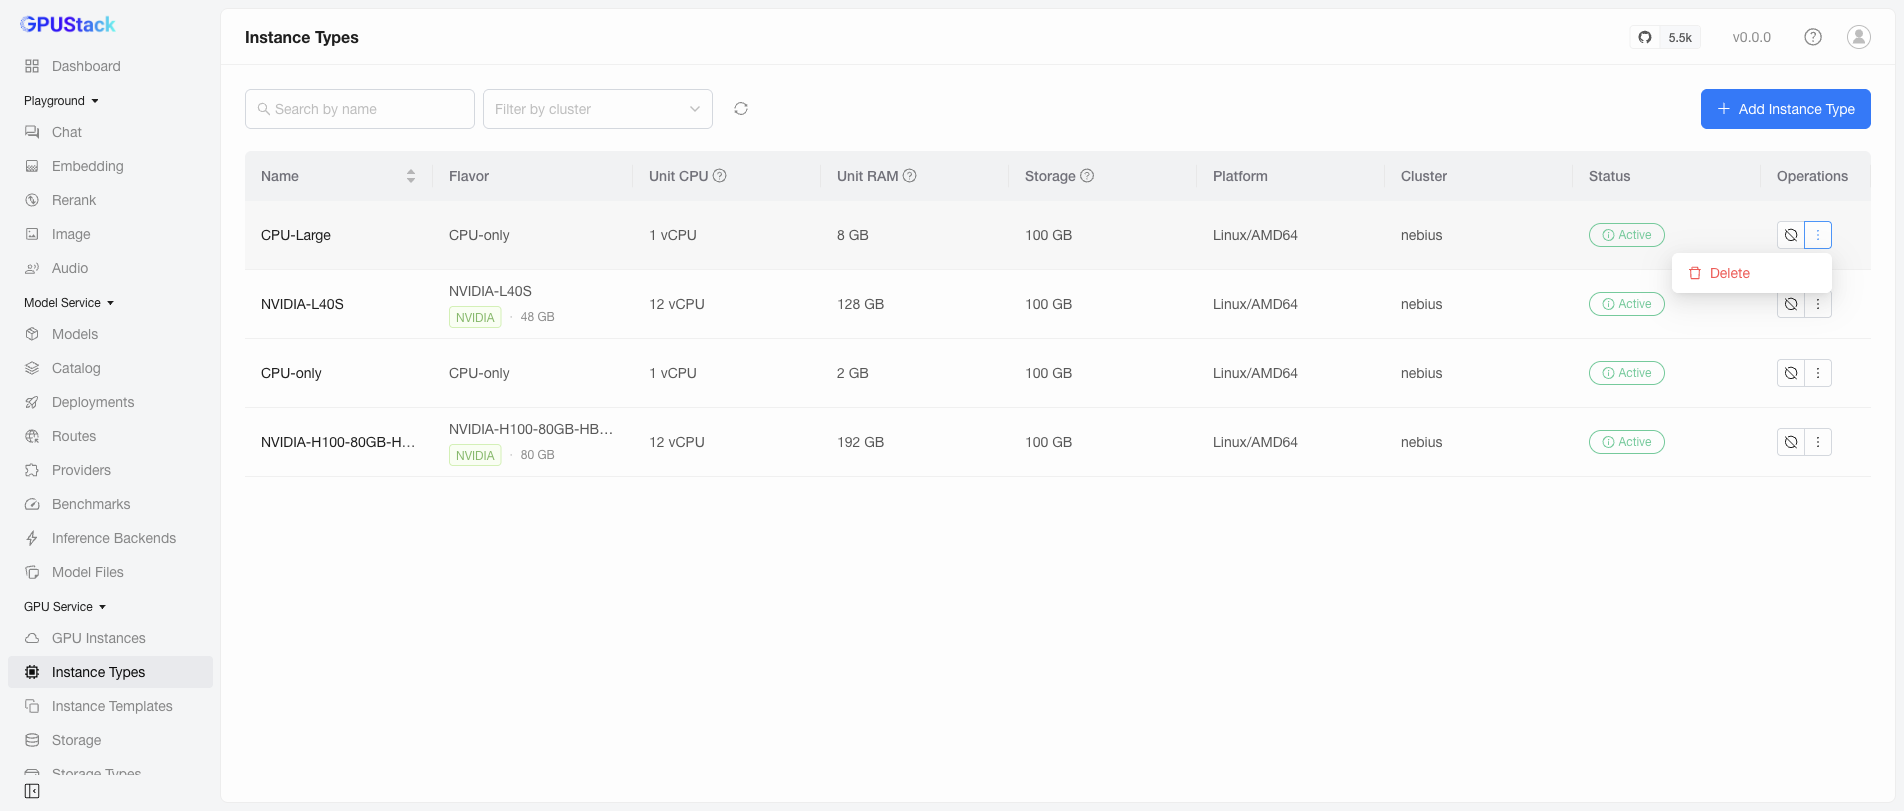
打开类型所在行的操作菜单,单击 Delete:
确认删除:
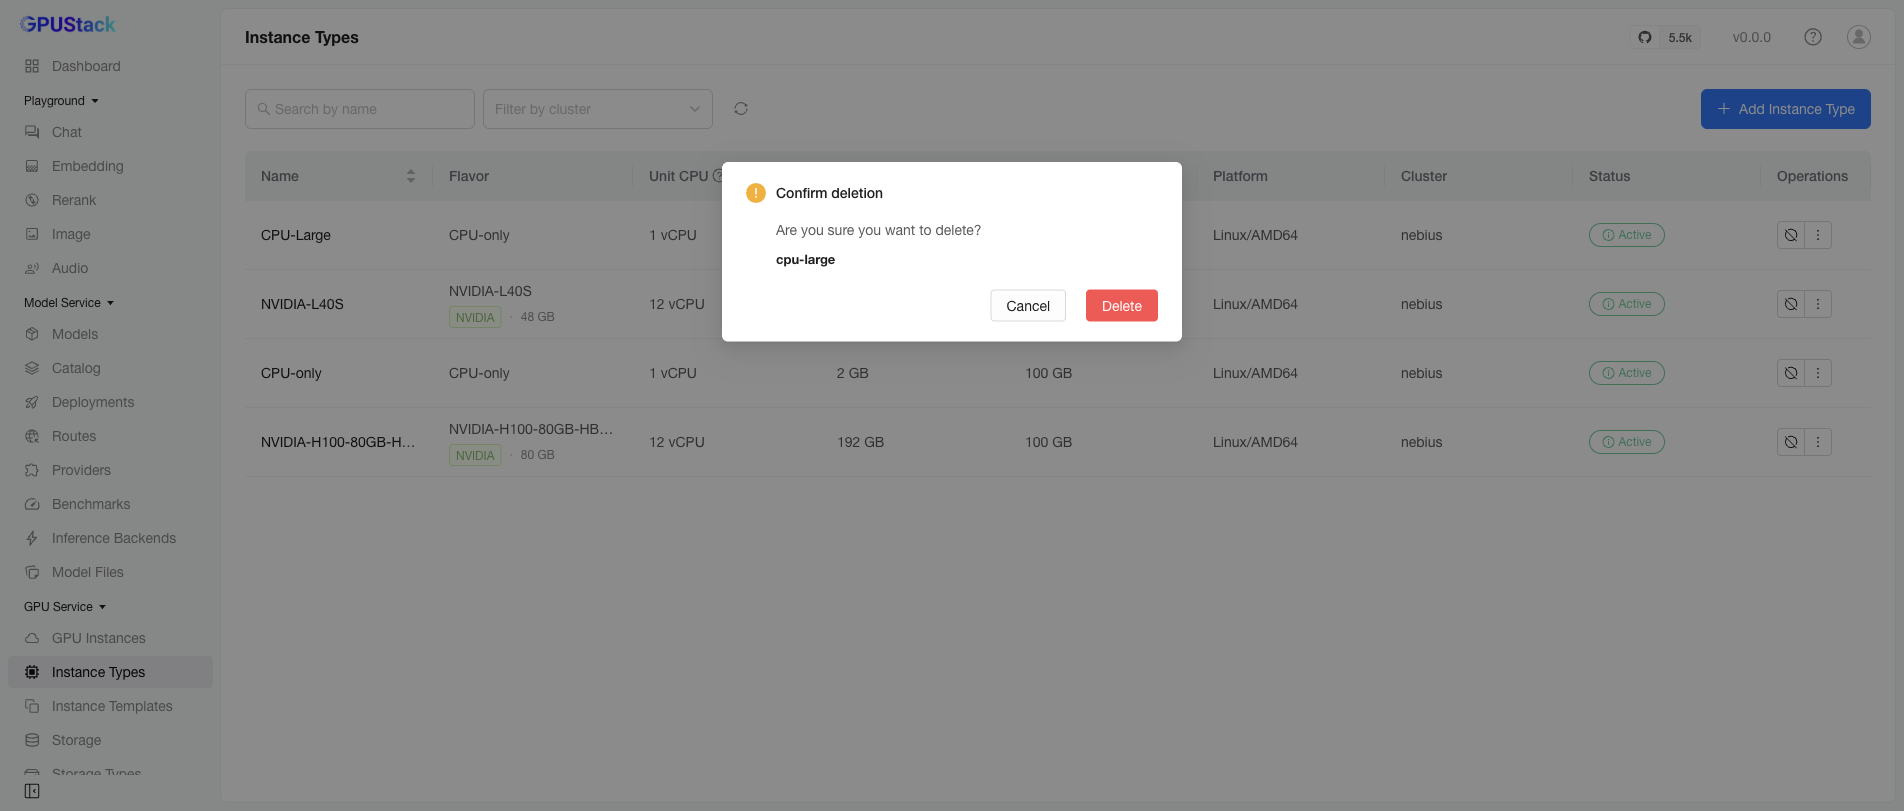
自定义类型会被永久移除。启用派生功能时无法删除派生类型,参见派生实例类型。
物理分区(MIG)
采用物理分区(MIG)的设备不会获得独立的实例类型:其分区会作为设备实例类型的分区容量(PT 视图)显示;在添加实例时选择分区规格。
Operator 支持 NVIDIA、平头哥和海光加速器上的 MIG。MIG 模式本身是由管理员按节点管理的属性,Operator 只观测它,绝不会启用、禁用或重新配置。要在节点上提供分区,请使用厂商工具在节点上启用 MIG,然后重启该节点上的 Operator 设备管理器。例如,在 NVIDIA 节点上:
各厂商的完整流程、前提条件和限制参见 Operator 的 MIG 运维手册,其中包括 MIG 实例无法跨节点重启保留的限制:
- NVIDIA MIG 操作
- 平头哥 MIG 操作
- 海光 MIG 操作——海光的模式作用于整个节点,启用分区的节点只提供分区。