使用自定义推理后端
本指南介绍如何在 GPUStack 中添加自定义推理后端,包括使用经过验证的社区配置和从头创建配置。
参数说明见用户指南。
后端类型
GPUStack 支持三类推理后端:
- 内置:由 GPUStack 维护的预配置后端,例如 vLLM、MindIE、VoxBox、SGLang,会自动针对不同硬件优化。
- 社区:经过预先验证的自定义后端配置,本质上是标记为“community”的 CustomBackends,用于简化手动配置。
- 自定义:使用自定义 Docker 镜像和命令自行配置的后端。
使用社区后端
社区后端是添加常用推理引擎的快捷方式。
步骤:
- 打开 Inference Backend 页面,点击“Add Backend”。
- 选择“Community”。
- 浏览“Community Backend Marketplace”,启用所需后端。
创建自定义后端
基本步骤
- 准备所需推理后端的 Docker 镜像。
- 理解镜像的 ENTRYPOINT 或 CMD,以确定启动命令。
- 在 Inference Backend 页面添加配置。
- 部署模型并选择新添加的后端。
示例:TensorRT-LLM
下面以 TensorRT-LLM 为例,说明如何添加和使用推理后端。
以下示例用于演示功能,并非经过性能优化的配置。如需优化性能,请参考各后端官方文档进行调优。
- 从 TensorRT-LLM 文档链接的发布页面查找所需镜像。
- TensorRT-LLM 镜像必须通过
trtllm-serve启动推理服务,否则会启动交互式 shell。run_command支持{{model_path}}和{{port}}等占位符,也可使用{{model_name}}、{{worker_ip}}、{{gpu_count}}、{{gpu_ids}}。部署调度到 Worker 时,这些占位符会替换为实际值。{{gpu_count}}和{{gpu_ids}}表示调度目标 Worker 上分配的 GPU;自定义后端在单个 Worker 上运行。 - 在 Inference Backend 页面添加配置,支持导入 YAML。例如:
- 在 Deployments 页面选择刚添加的后端并部署模型。
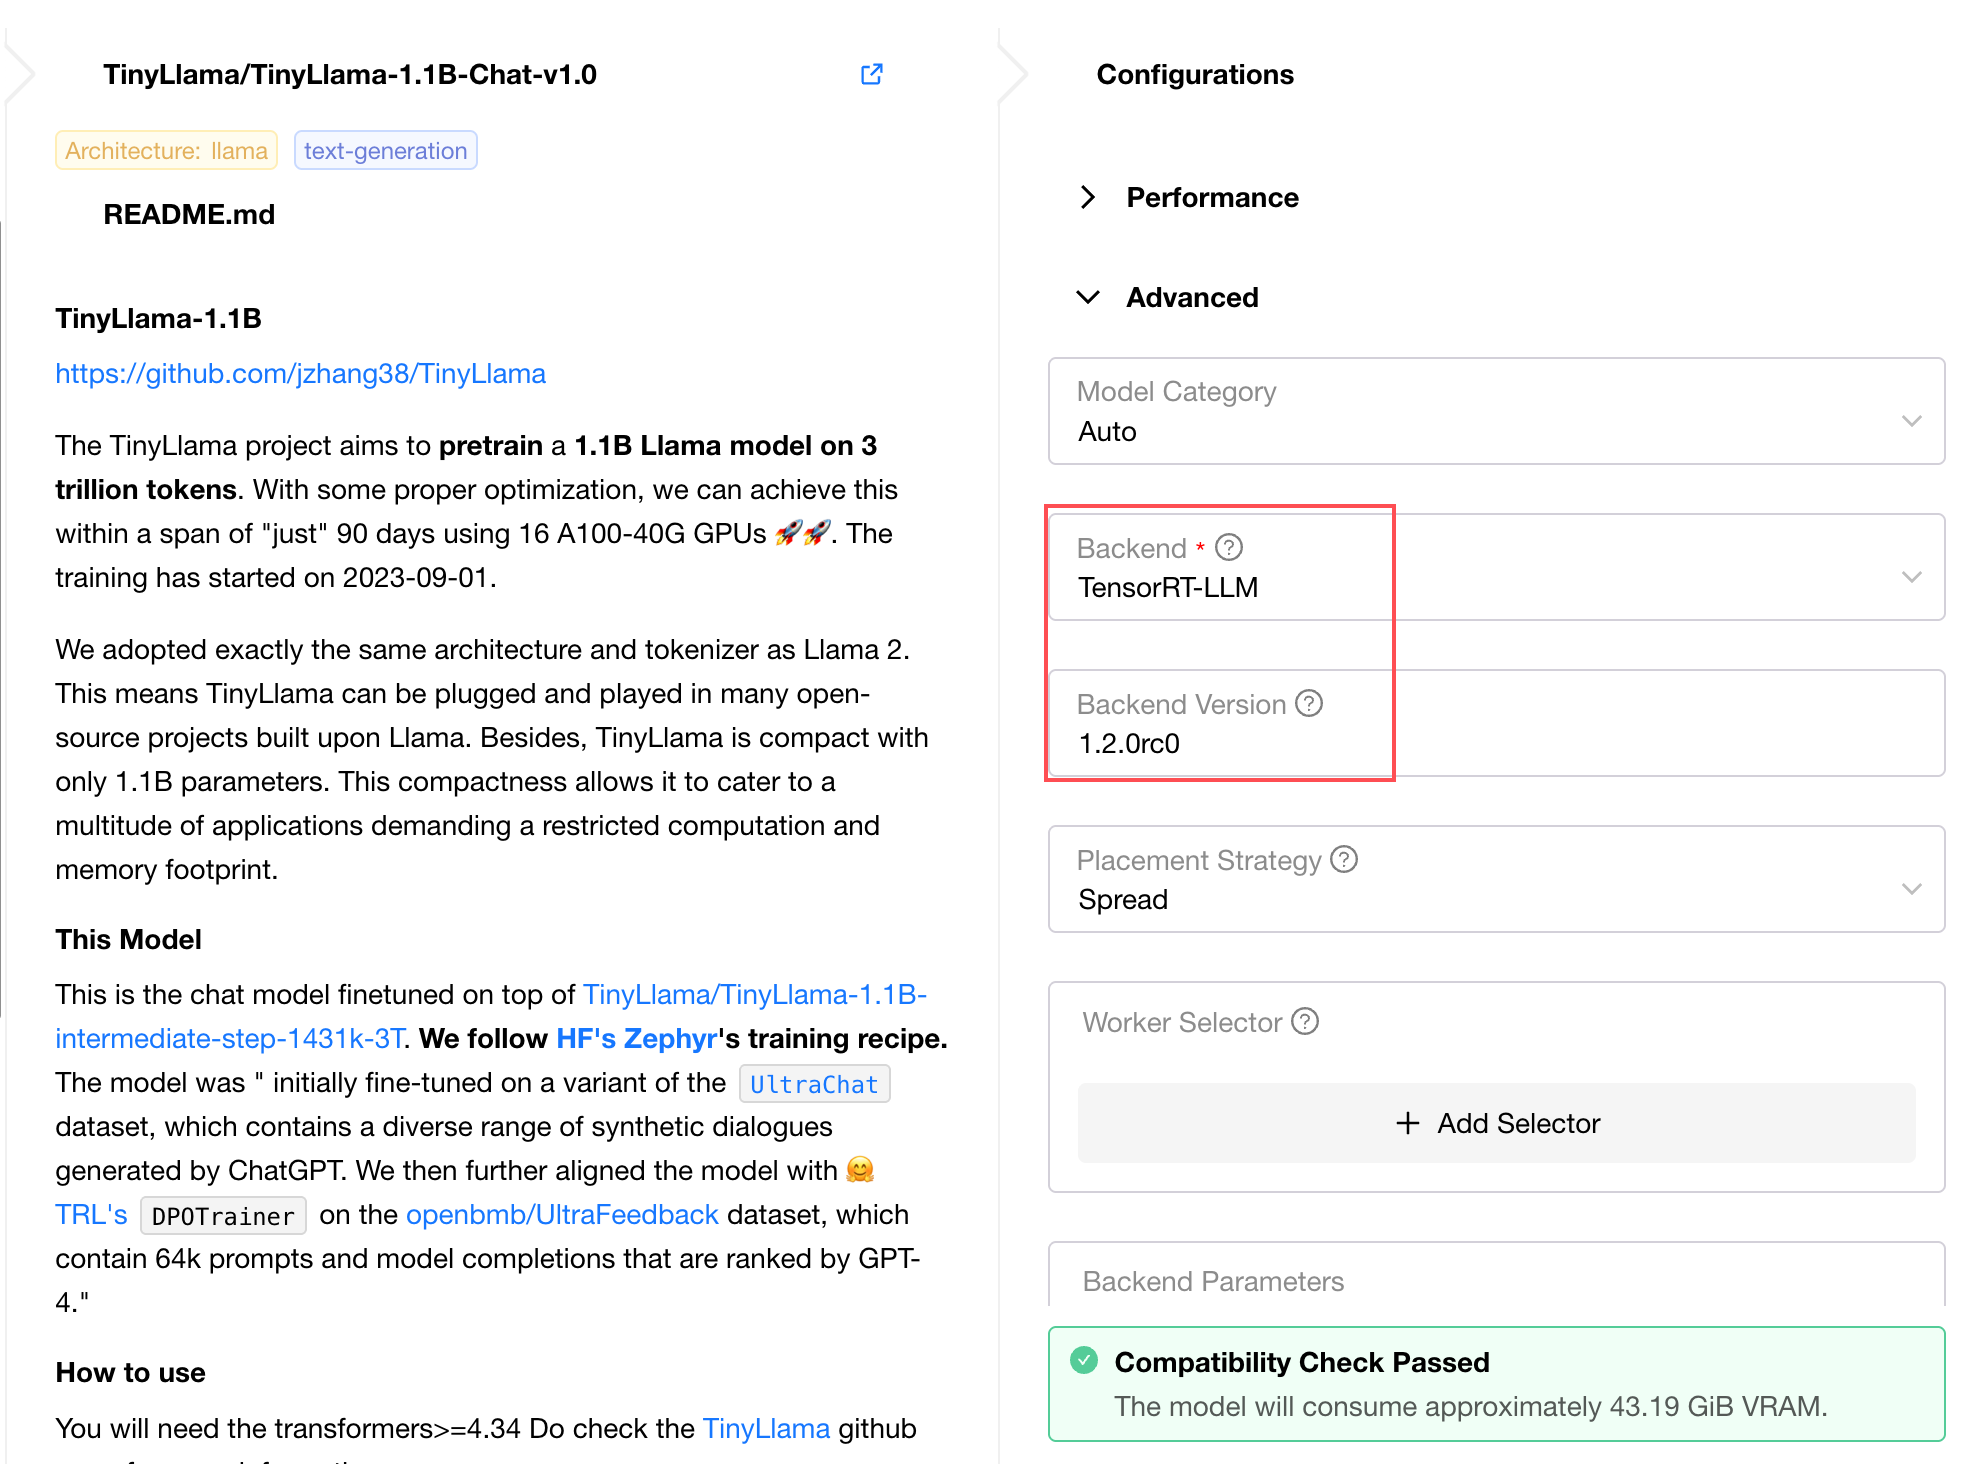
结果
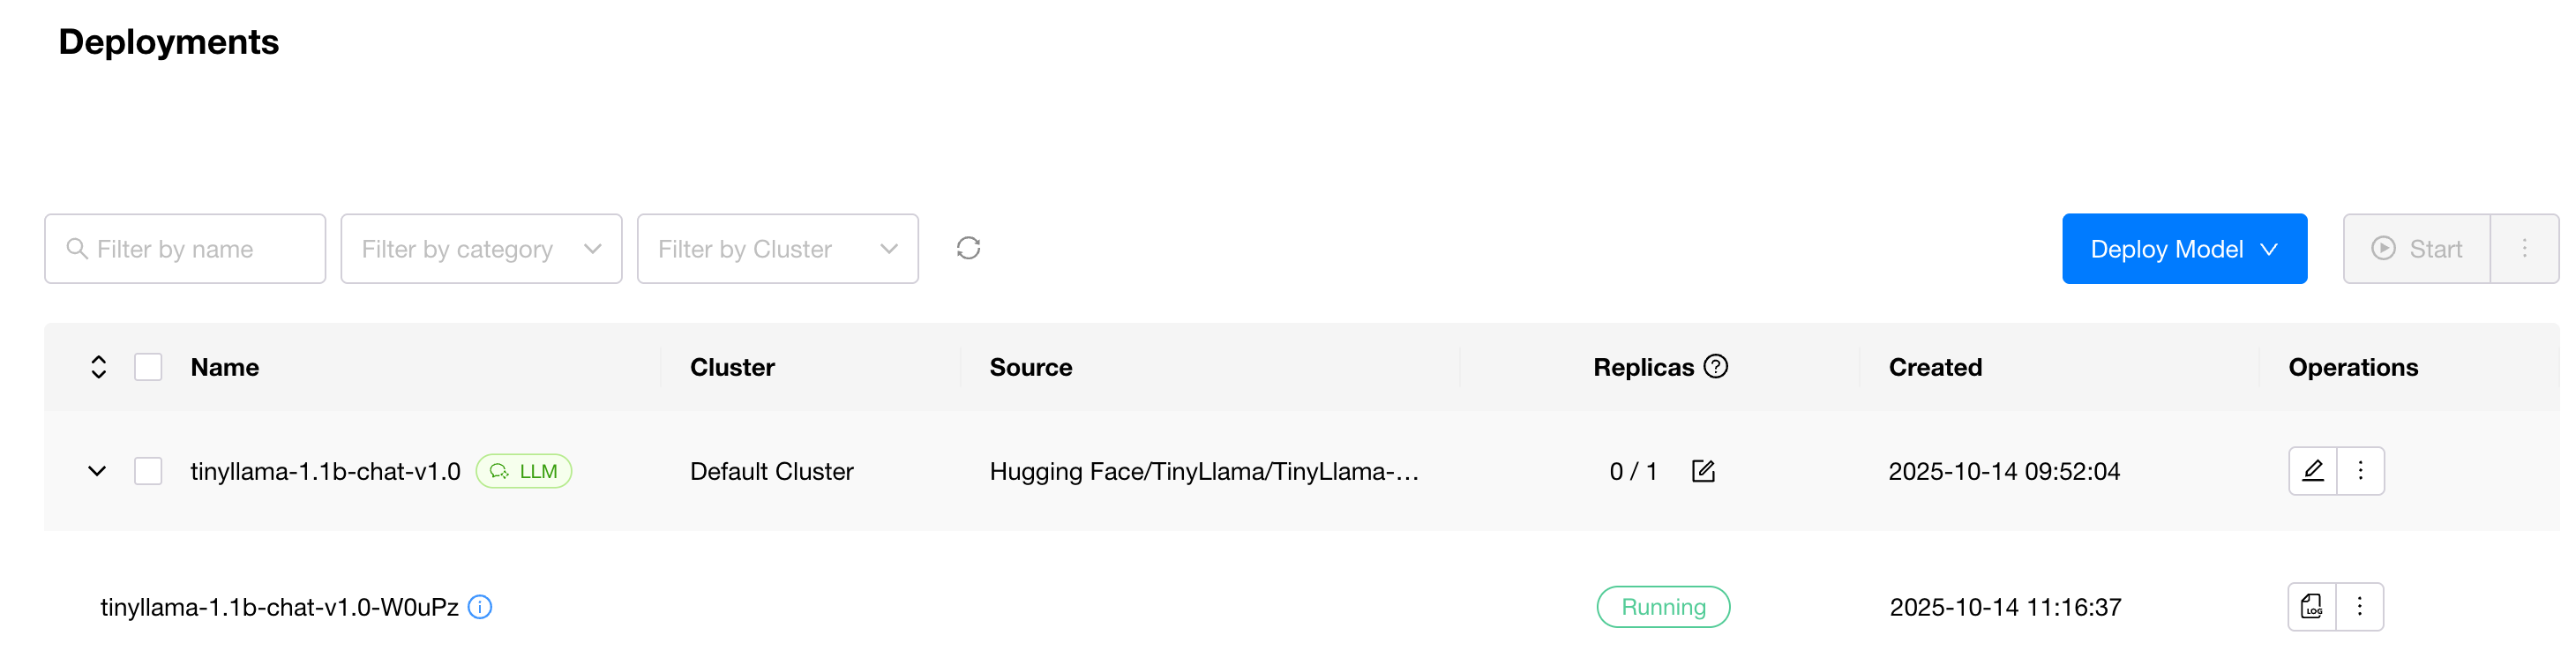
推理后端服务启动后,可以看到 model_instance 状态变为 RUNNING。
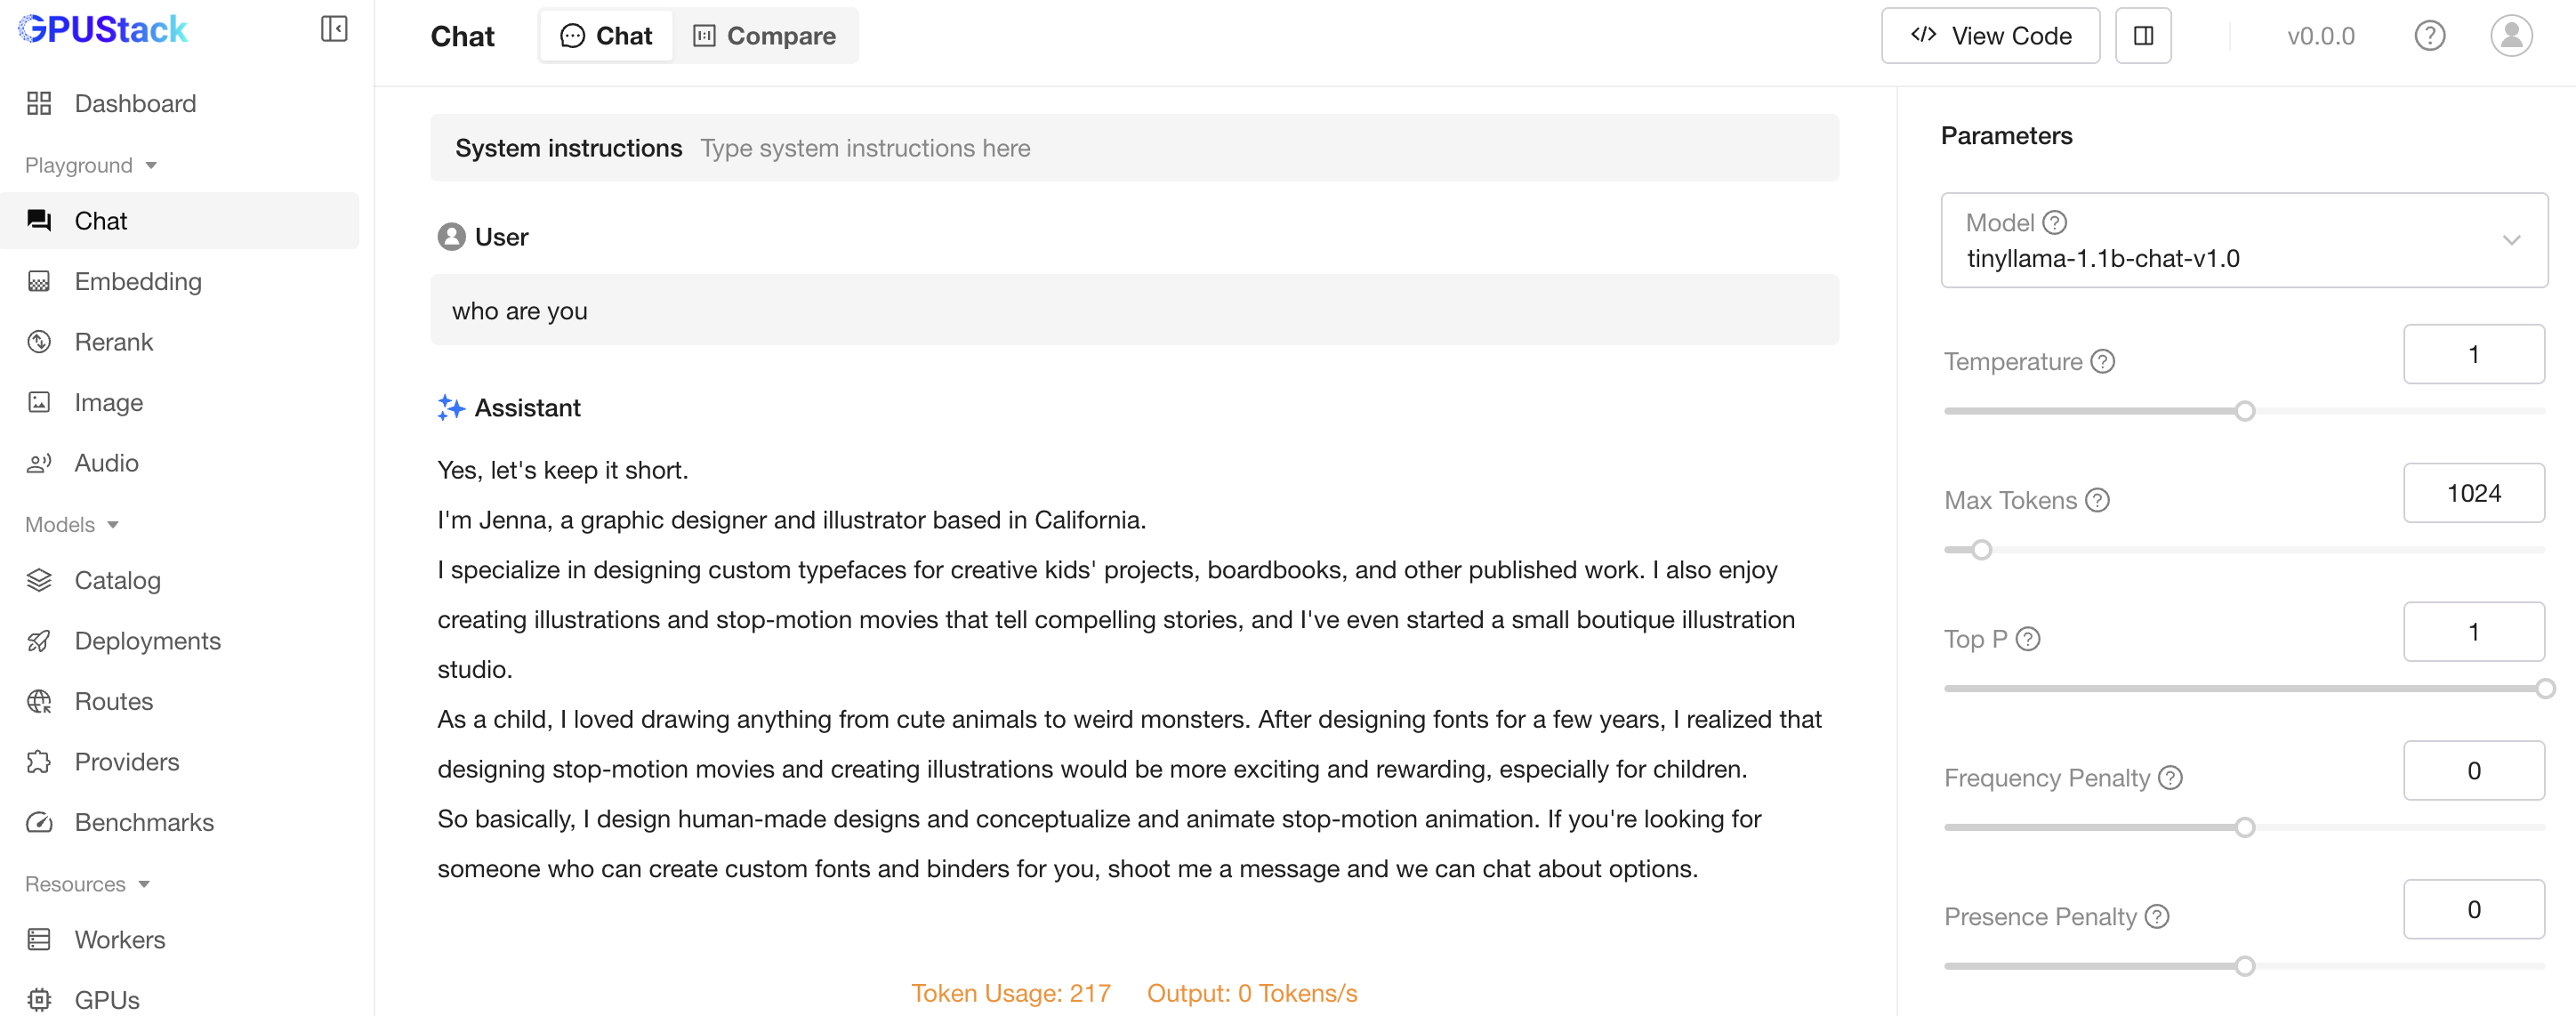
可以在 Playground 中与模型对话。
高级配置
使用环境变量
环境变量可以灵活配置参数,避免在命令中硬编码值:
此示例中:
- 在后端层级定义了
CACHE_DIR和LOG_LEVEL。 - 版本
v1将LOG_LEVEL覆盖为debug。 - 命令通过
{{VAR_NAME}}语法引用这两个变量。
自定义 Entrypoint
镜像需要自定义初始化时,可以覆盖容器默认 Entrypoint。后端和版本层级都可以配置 Entrypoint: