在 CPU 上运行推理
GPUStack 支持 CPU 推理,在 GPU 资源不足或模型大小超过可分配 GPU 显存时提供更灵活的选择。支持以下模式:
- CPU+GPU 混合推理:显存不足时,将大型模型的一部分卸载到 CPU,实现部分 GPU 加速。
- 纯 CPU 推理:没有可用 GPU 资源时,完全使用 CPU 运行。
说明
仅适用于自定义后端。
启用 CPU 卸载后,GPU 资源不足时 GPUStack 会分配 CPU 内存。必须正确配置推理后端,以使用 CPU+GPU 混合推理或纯 CPU 推理。
强烈建议仅在 CPU Worker 上使用 CPU 推理。
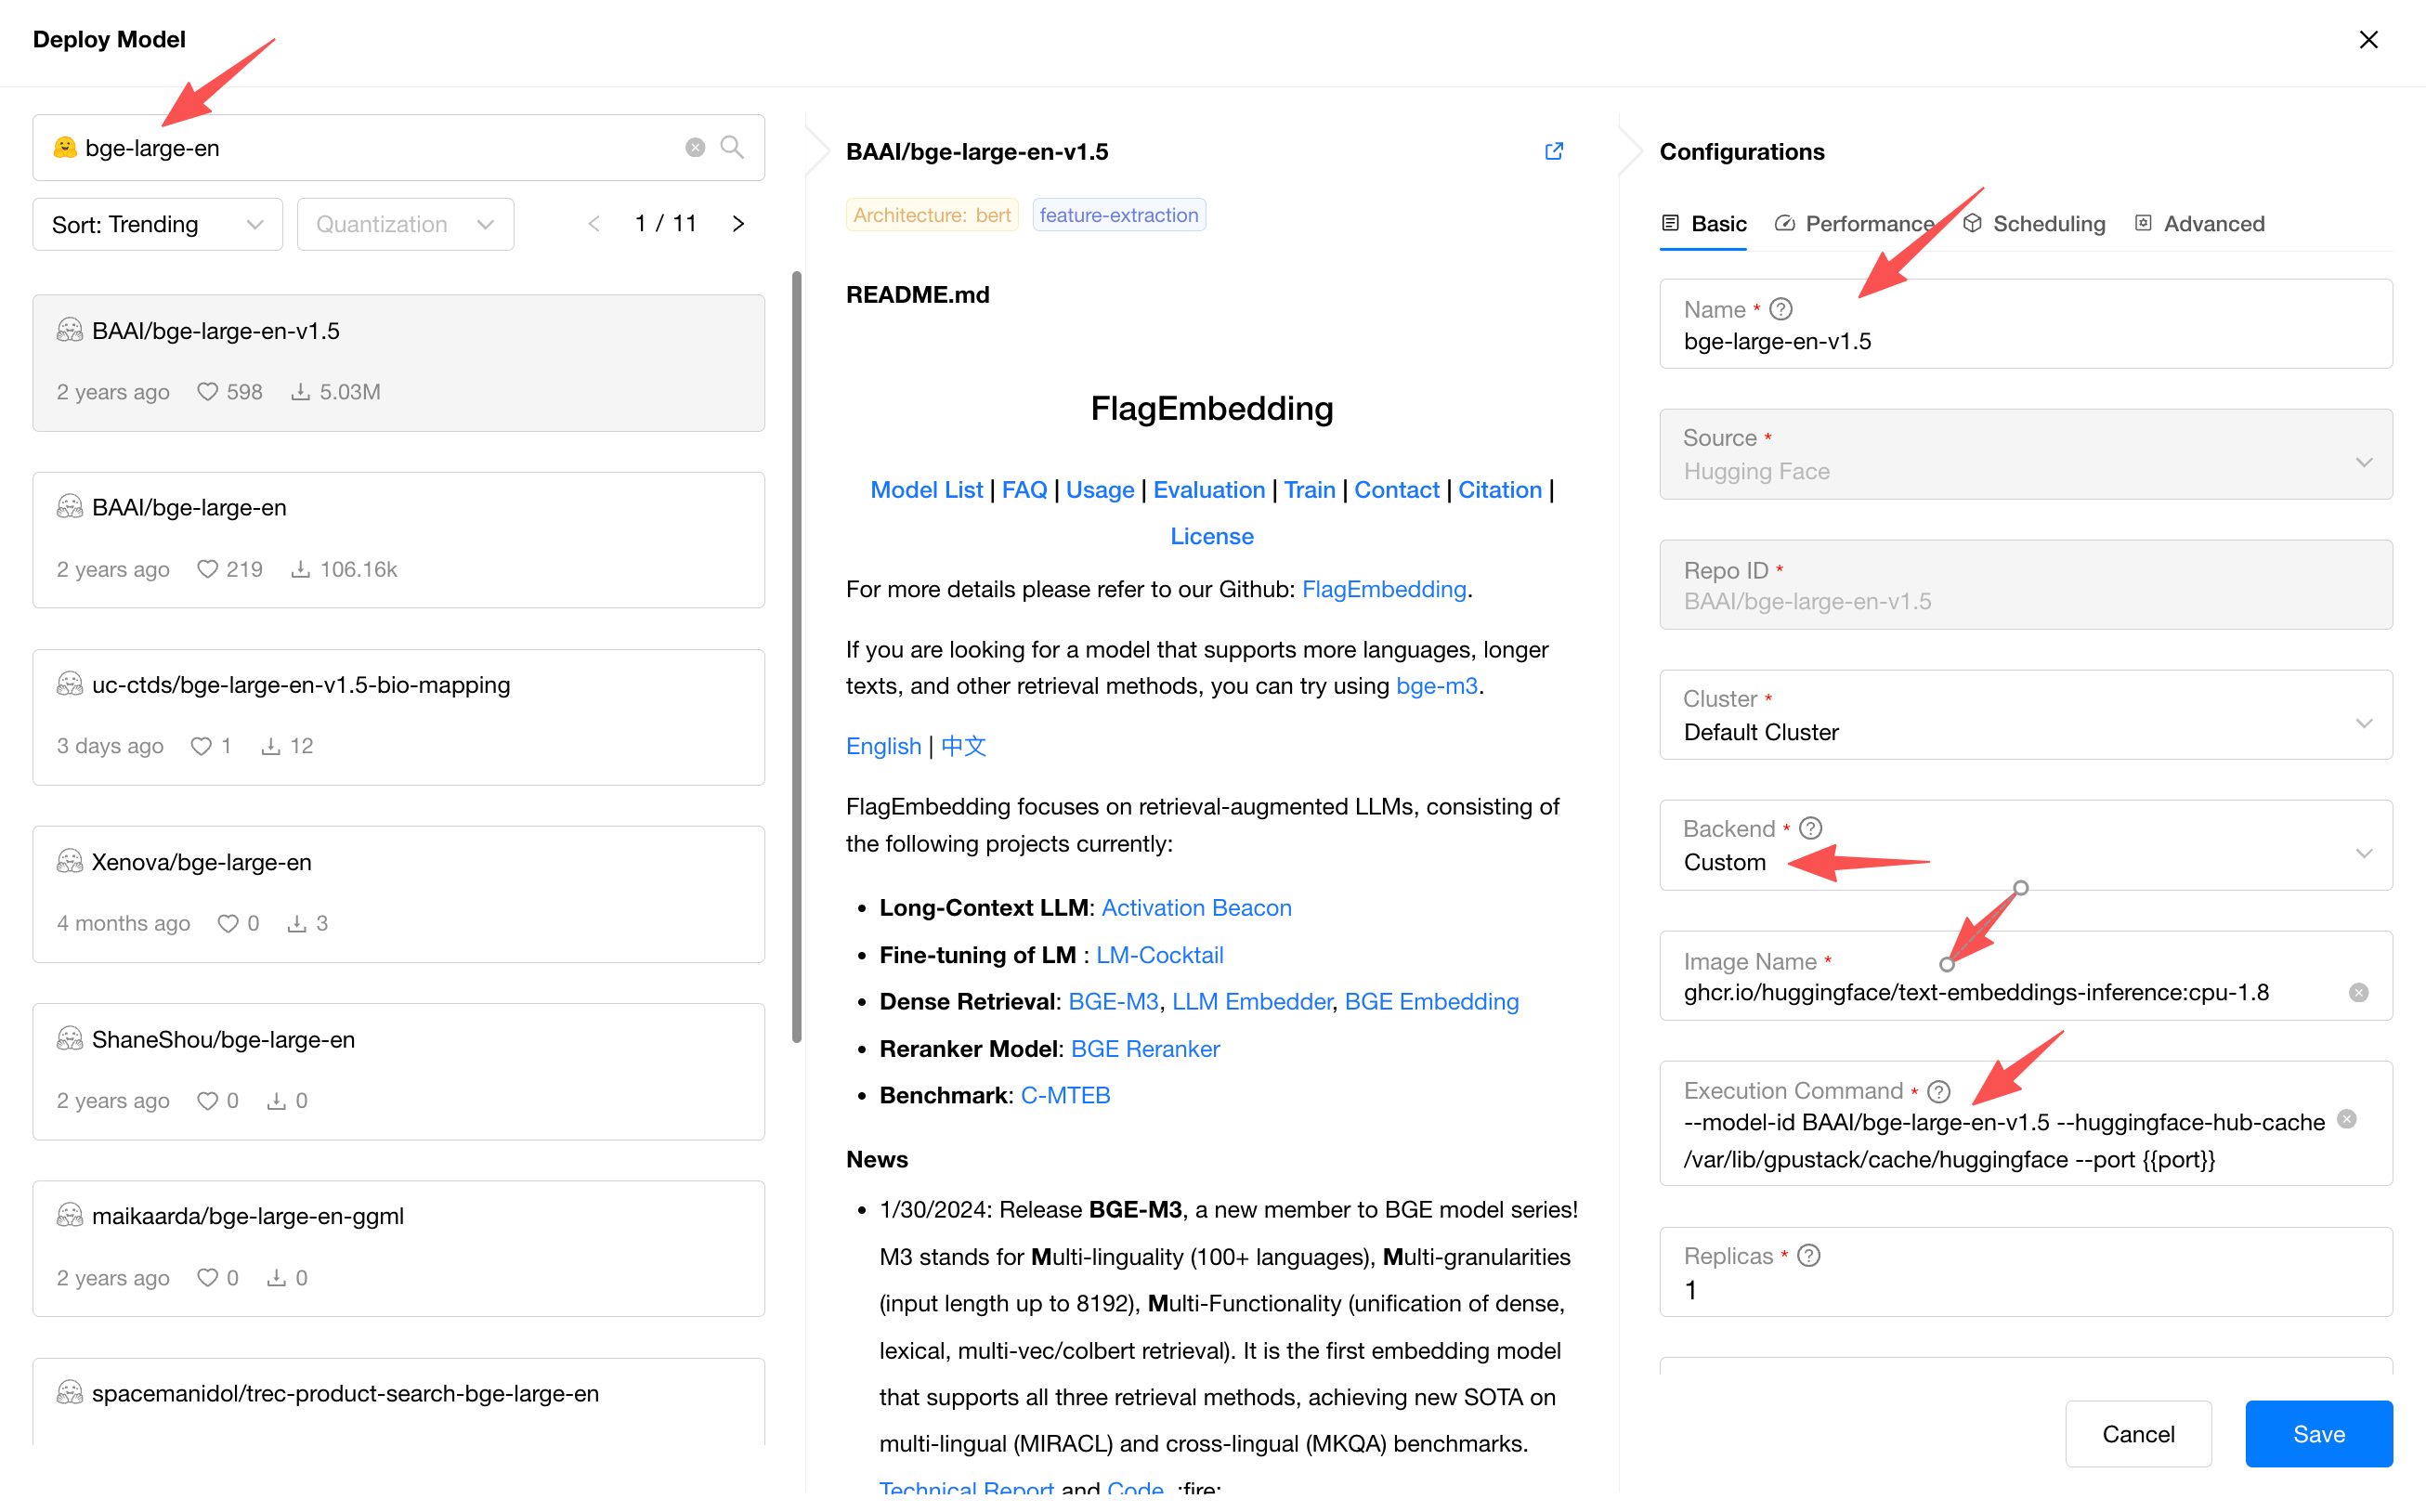
例如,使用 Text Embeddings Inference部署 CPU 推理模型,可采用以下配置:
Source:HuggingFace
Repo ID:BAAI/bge-large-en-v1.5
Backend:Custom
Image Name:ghcr.io/huggingface/text-embeddings-inference:cpu-1.8
Execution Command:--model-id BAAI/bge-large-en-v1.5 --huggingface-hub-cache /var/lib/gpustack/cache/huggingface --port {{port}}
说明
TEI (Text Embeddings Inference) 仅支持部署来自 HuggingFace 的模型。
ghcr.io/huggingface/text-embeddings-inference:cpu-1.8 是 TEI 的 CPU 推理镜像,参见 TEI 支持的硬件。
--huggingface-hub-cache /var/lib/gpustack/cache/huggingface 将 TEI 的 HuggingFace Hub 缓存目录设为 GPUStack 存储已下载 HuggingFace 模型的路径。默认路径为 /var/lib/gpustack/cache/huggingface,参见 TEI CLI 参数。
{{port}} 是占位符,代表 GPUStack 自动分配的端口。
在 Advanced Settings 中勾选 Allow CPU Offloading:
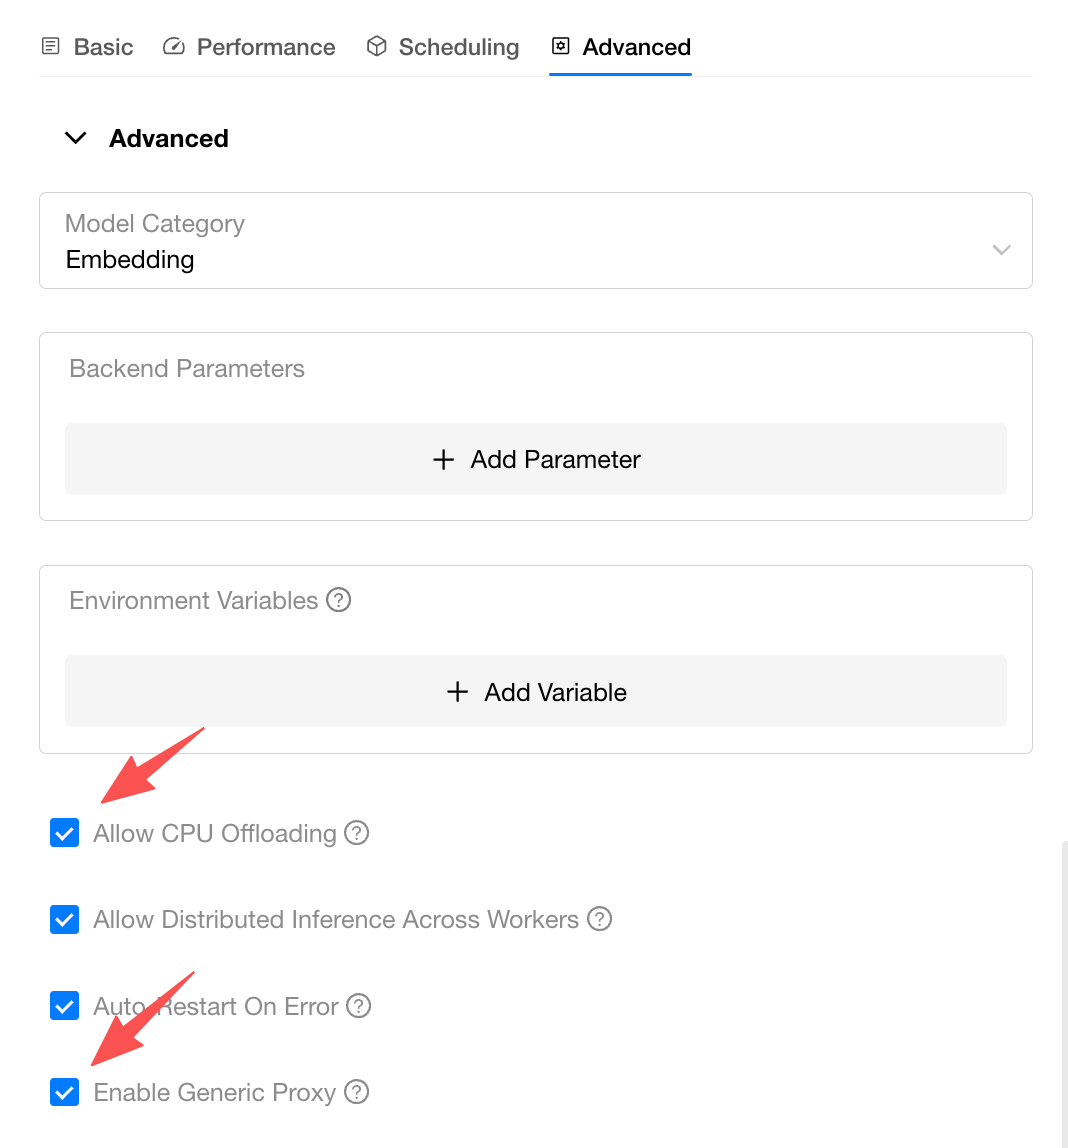
如果需要访问非 OpenAI 兼容 API,也可以勾选 Enable Generic Proxy。
更多说明见启用 Generic Proxy。