NVIDIA H100 GPUs 上的 Qwen3-235B-A22B 吞吐量优化 结论
Qwen3-235B-A22B-Instruct-2507 在 H100 GPUs 上的吞吐量优化推荐配置:
推理服务命令 serve Qwen/Qwen3-235B-A22B-Instruct-2507-FP8 -tp 4 --max-num-batched-tokens 16384
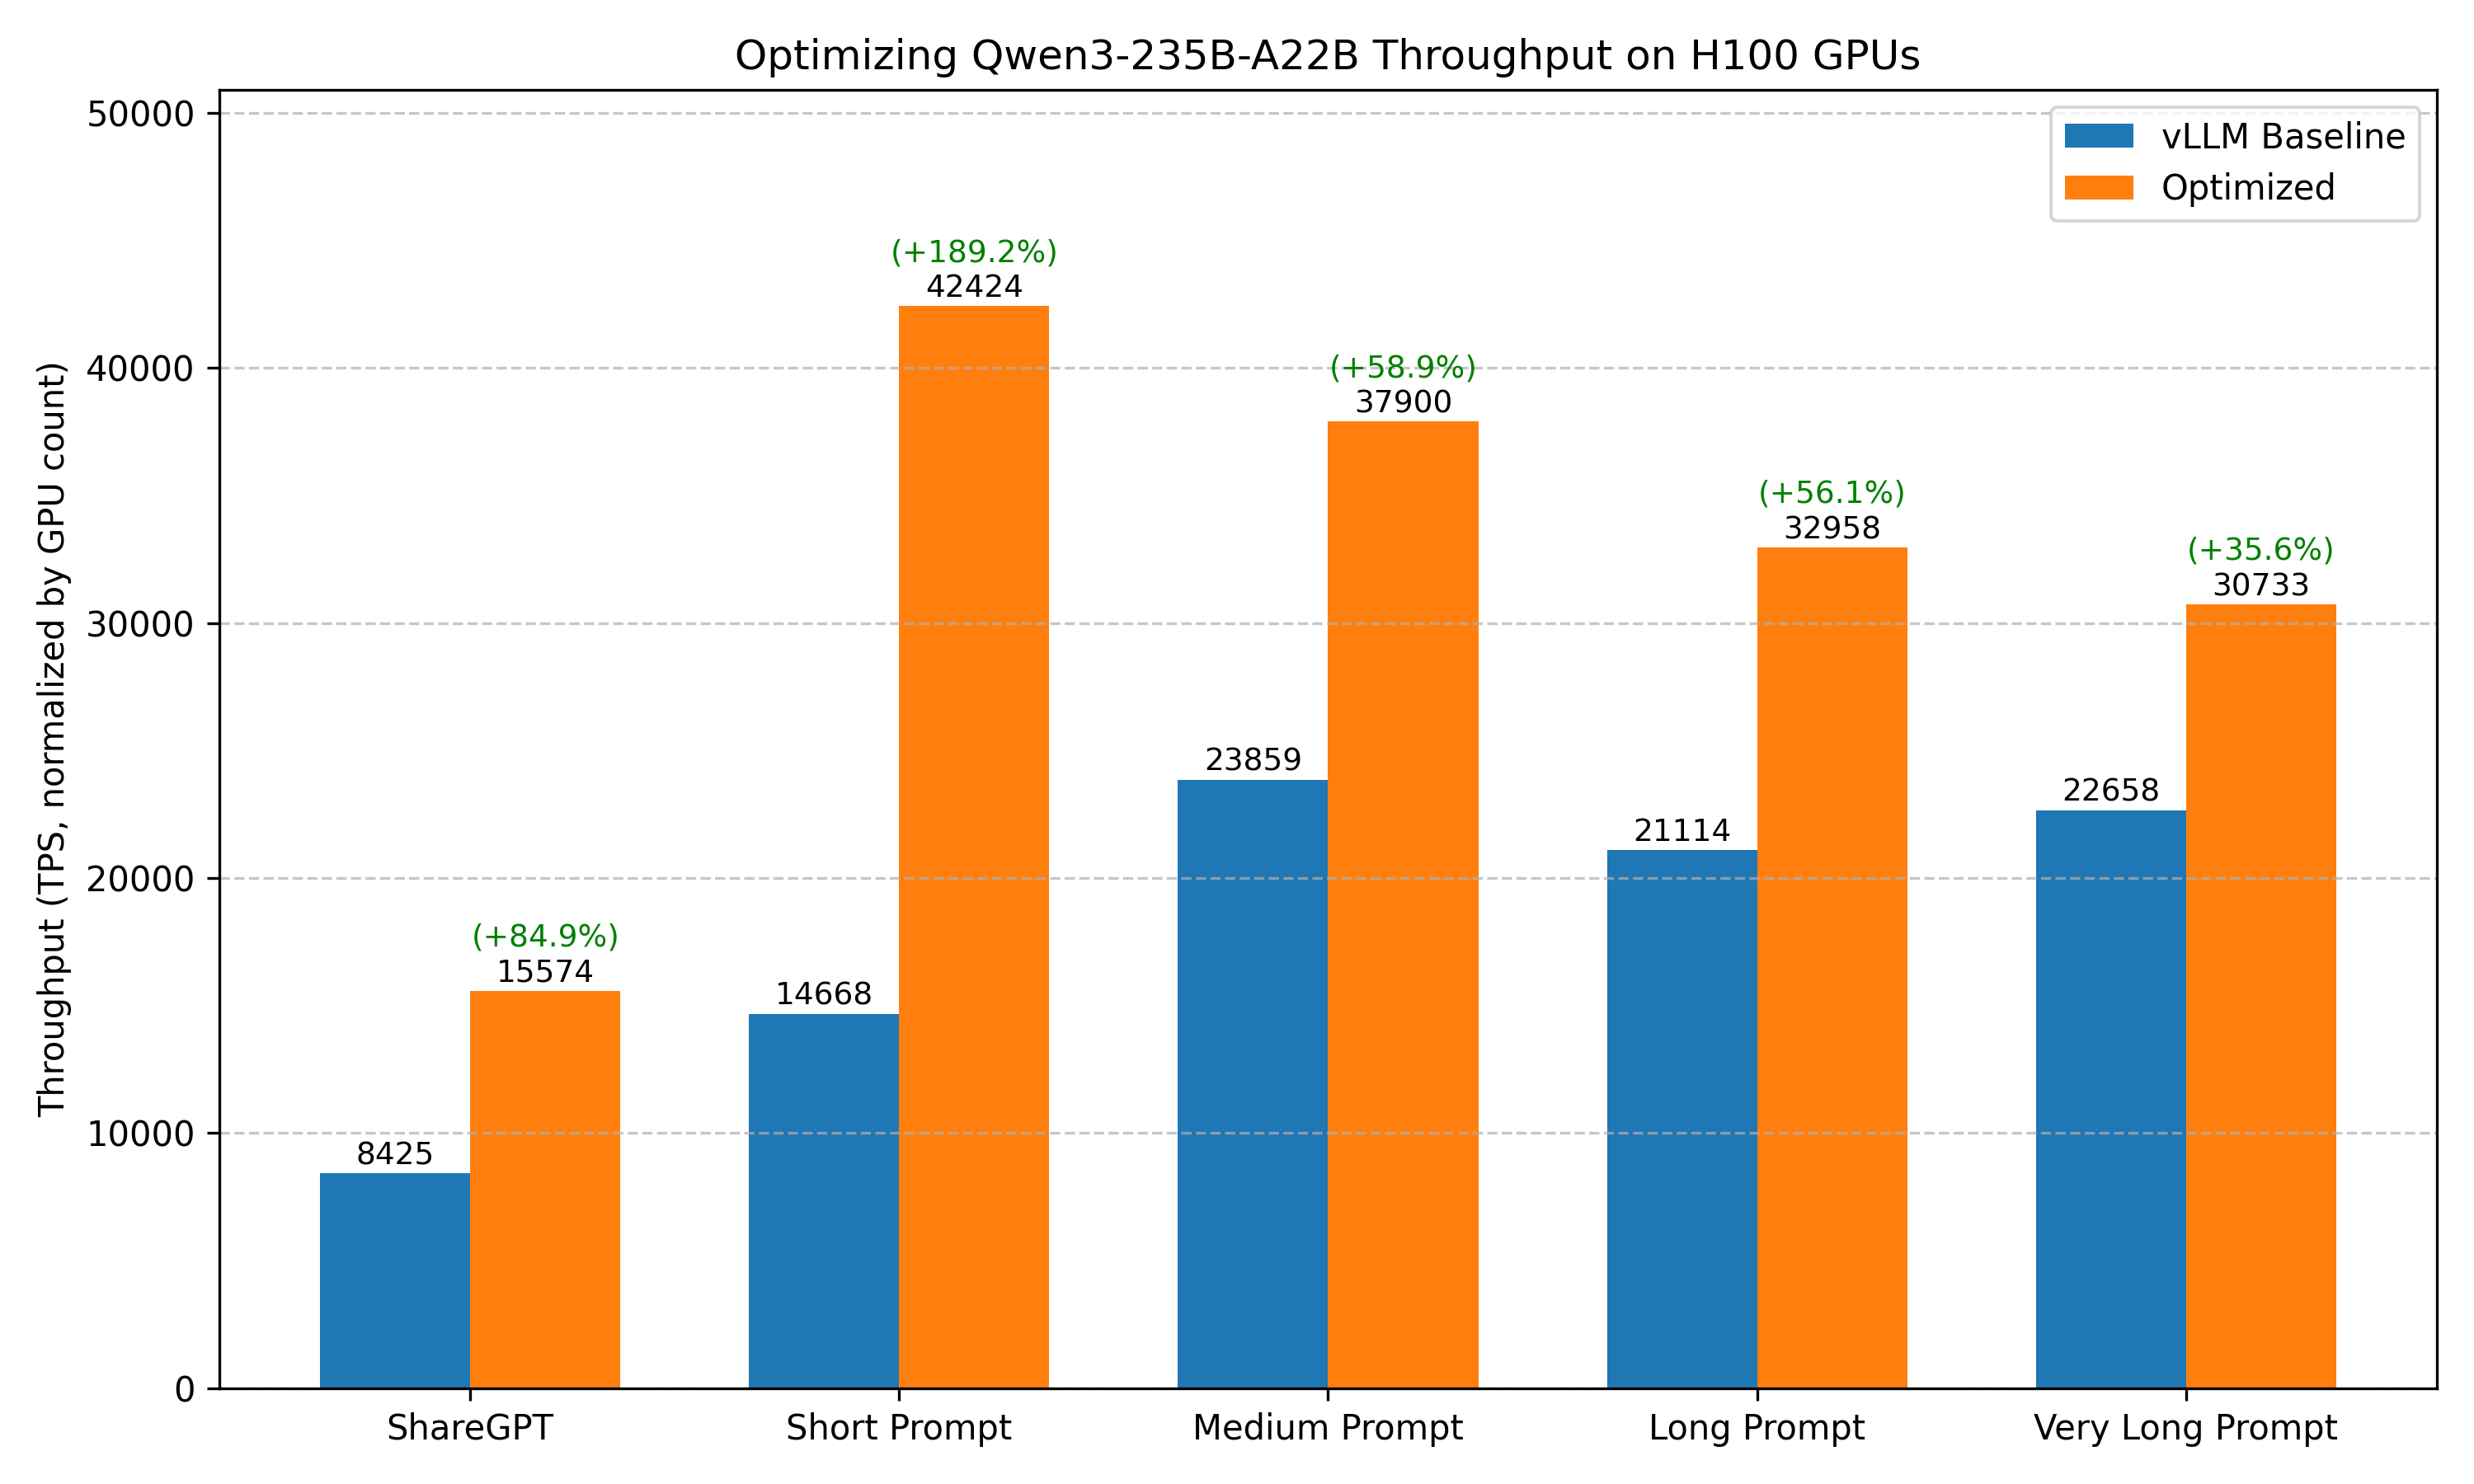
优化前后的基准测试结果对比:
基准测试用例 基准配置(未做任何优化的 vLLM) 优化后 ShareGPT Total TPS: 8424.86 Total TPS: 7787.17x2 (+84.9%) 短提示词 Total TPS: 14668.27 Total TPS: 21211.83x2 (+189.2%) 中等长度提示词 Total TPS: 23858.69 Total TPS: 18950.04x2 (+58.9%) 长提示词 Total TPS: 21113.53 Total TPS: 16478.79x2 (+56.1%) 超长提示词 Total TPS: 22657.51 Total TPS: 15366.32x2 (+35.6%)
说明
基准测试未覆盖所有可能的优化组合。例如,我们会选择默认配置下表现最好的推理引擎作为后续调优的起点。这种剪枝方式得到的是局部最优解,未必是全局最优解。 其他优化方法取决于具体使用场景,包括最大批大小、调度配置、扩展 KV cache、CUDA graph、Torch Compile 等。本文结论可作为进一步针对性优化的起点。 测试基于特定的硬件和软件环境。推理引擎的改进可能带来新的结论。 量化可能影响准确率,但对于大多数模型,FP8 量化的准确率下降可控制在 1% 以内。详情参见评估结果 。因此,强烈建议在高吞吐量推理服务场景中使用 FP8 量化。 如有遗漏或需要根据最新变化更新的内容,请告诉我们 。
优化目标 在高并发请求场景下实现高吞吐量。
实验环境 模型 Qwen3-235B-A22B-Instruct-2507
硬件 单节点配备 8 × NVIDIA H100 SXM GPU。
引擎版本 vLLM: v0.11.0 SGLang: v0.5.5.post1 基准测试数据集 ShareGPT 不同序列长度的随机数据集: 超长提示词:32000 输入 tokens,100 输出 tokens 长提示词:4000 输入 tokens,200 输出 tokens 中等长度提示词:2000 输入 tokens,100 输出 tokens 短提示词:128 输入 tokens,4 输出 tokens 基准测试脚本 使用 vLLM bench CLI 工具对模型性能进行基准测试。运行基准测试的命令如下:
# Prepare the ShareGPT dataset
https://huggingface.co/datasets/anon8231489123/ShareGPT_Vicuna_unfiltered/resolve/main/ShareGPT_V3_unfiltered_cleaned_split.json
# Benchmark on ShareGPT dataset
bench serve --model Qwen/Qwen3-235B-A22B-Instruct-2507 --backend openai-chat --endpoint /v1/chat/completions --dataset-name sharegpt --dataset-path ShareGPT_V3_unfiltered_cleaned_split.json --num-prompts 1000
# Benchmark on random dataset (fixed seed for reproducibility)
bench serve --model Qwen/Qwen3-235B-A22B-Instruct-2507 --backend openai-chat --endpoint /v1/chat/completions --dataset-name random --random-input-len 4000 --random-output-len 200 --num-prompts 500 --seed 42
实验结果 1. 选择推理引擎 vLLM
推理服务脚本 serve Qwen/Qwen3-235B-A22B-Instruct-2507 -tp 8
基准测试结果
SGLang
推理服务脚本 -m sglang.launch_server --model-path Qwen/Qwen3-235B-A22B-Instruct-2507 --tp-size 8
基准测试结果
结果:vLLM (8424.86 tok/s) > SGLang (7671.31 tok/s)
2. vLLM 中的 量化 推理服务脚本 # TP8 only is not compatible with the model weight. Use EP as well.
serve Qwen/Qwen3-235B-A22B-Instruct-2507-FP8 -tp 8 --enable-expert-parallel
基准测试结果
3. vLLM 中的 并行策略 TP4
推理服务脚本 serve Qwen/Qwen3-235B-A22B-Instruct-2507-FP8 -tp 4
基准测试结果
TP4+EP
推理服务脚本 serve Qwen/Qwen3-235B-A22B-Instruct-2507-FP8 -tp 4 --enable-expert-parallel
基准测试结果
4. vLLM 中的 注意力后端 默认使用 FlashAttention。
FlashInfer
推理服务脚本 VLLM_ATTENTION_BACKEND = FLASHINFER vllm serve Qwen/Qwen3-235B-A22B-Instruct-2507-FP8 -tp 4
基准测试结果 XFormers
推理服务脚本 VLLM_ATTENTION_BACKEND = XFORMERS vllm serve Qwen/Qwen3-235B-A22B-Instruct-2507-FP8 -tp 4
基准测试结果 5. vLLM 中的 最大批处理 Token 数 推理服务脚本 serve Qwen/Qwen3-235B-A22B-Instruct-2507-FP8 -tp 4 --max-num-batched-tokens 16384
基准测试结果
优化选项汇总 优化选项 吞吐量提升 引擎选择 - 量化 - 并行策略 +78.7% 注意力后端 - 最大批处理 Token 数 +3.4%
其他基准测试用例 我们进一步对优化后的配置进行了基准测试,评估其在不同工作负载下的泛化表现。
基准配置的推理服务脚本 serve Qwen/Qwen3-235B-A22B-Instruct-2507 -tp 8
基准配置的测试结果 # random 32K input
============ Serving Benchmark Result ============
requests: 100
duration ( s) : 141 .60
input tokens: 3200000
generated tokens: 8191
throughput ( req/s) : 0 .71
token throughput ( tok/s) : 57 .85
output token throughput ( tok/s) : 346 .00
concurrent requests: 100 .00
Token throughput ( tok/s) : 22657 .51
to First Token----------------
TTFT ( ms) : 70409 .55
TTFT ( ms) : 70737 .29
TTFT ( ms) : 138084 .17
per Output Token ( excl. 1st token) ------
TPOT ( ms) : 132 .10
TPOT ( ms) : 134 .49
TPOT ( ms) : 182 .76
Latency----------------
ITL ( ms) : 129 .44
ITL ( ms) : 23 .29
ITL ( ms) : 376 .34
==================================================
# random 4K input
============ Serving Benchmark Result ============
requests: 500
duration ( s) : 98 .99
input tokens: 1997942
generated tokens: 92185
throughput ( req/s) : 5 .05
token throughput ( tok/s) : 931 .21
output token throughput ( tok/s) : 2450 .00
concurrent requests: 500 .00
Token throughput ( tok/s) : 21113 .53
to First Token----------------
TTFT ( ms) : 47811 .58
TTFT ( ms) : 48562 .54
TTFT ( ms) : 93161 .32
per Output Token ( excl. 1st token) ------
TPOT ( ms) : 68 .94
TPOT ( ms) : 72 .58
TPOT ( ms) : 92 .94
Latency----------------
ITL ( ms) : 68 .75
ITL ( ms) : 30 .18
ITL ( ms) : 245 .68
==================================================
# random 2K input
============ Serving Benchmark Result ============
requests: 500
duration ( s) : 43 .91
input tokens: 998175
generated tokens: 49500
throughput ( req/s) : 11 .39
token throughput ( tok/s) : 1127 .26
output token throughput ( tok/s) : 4021 .00
concurrent requests: 500 .00
Token throughput ( tok/s) : 23858 .69
to First Token----------------
TTFT ( ms) : 21313 .79
TTFT ( ms) : 20242 .32
TTFT ( ms) : 40939 .00
per Output Token ( excl. 1st token) ------
TPOT ( ms) : 101 .08
TPOT ( ms) : 108 .64
TPOT ( ms) : 125 .24
Latency----------------
ITL ( ms) : 100 .16
ITL ( ms) : 35 .94
ITL ( ms) : 244 .64
==================================================
# random 128 input
============ Serving Benchmark Result ============
requests: 984
duration ( s) : 8 .83
input tokens: 125650
generated tokens: 3936
throughput ( req/s) : 111 .38
token throughput ( tok/s) : 445 .53
output token throughput ( tok/s) : 1489 .00
concurrent requests: 984 .00
Token throughput ( tok/s) : 14668 .27
to First Token----------------
TTFT ( ms) : 7042 .17
TTFT ( ms) : 6882 .45
TTFT ( ms) : 8721 .24
per Output Token ( excl. 1st token) ------
TPOT ( ms) : 212 .98
TPOT ( ms) : 238 .84
TPOT ( ms) : 242 .28
Latency----------------
ITL ( ms) : 159 .73
ITL ( ms) : 235 .21
ITL ( ms) : 250 .35
==================================================
优化后的推理服务脚本 serve Qwen/Qwen3-235B-A22B-Instruct-2507-FP8 -tp 4 --max-num-batched-tokens 16384
优化后的测试结果 # random 32K input
============ Serving Benchmark Result ============
requests: 100
duration ( s) : 208 .79
input tokens: 3200000
generated tokens: 8281
throughput ( req/s) : 0 .48
token throughput ( tok/s) : 39 .66
output token throughput ( tok/s) : 277 .00
concurrent requests: 100 .00
Token throughput ( tok/s) : 15366 .32
to First Token----------------
TTFT ( ms) : 103754 .50
TTFT ( ms) : 103784 .48
TTFT ( ms) : 205204 .25
per Output Token ( excl. 1st token) ------
TPOT ( ms) : 194 .60
TPOT ( ms) : 194 .50
TPOT ( ms) : 277 .94
Latency----------------
ITL ( ms) : 193 .15
ITL ( ms) : 27 .60
ITL ( ms) : 1117 .34
==================================================
# random 4K input
============ Serving Benchmark Result ============
requests: 500
duration ( s) : 126 .76
input tokens: 1997942
generated tokens: 90966
throughput ( req/s) : 3 .94
token throughput ( tok/s) : 717 .60
output token throughput ( tok/s) : 2139 .00
concurrent requests: 500 .00
Token throughput ( tok/s) : 16478 .79
to First Token----------------
TTFT ( ms) : 60513 .14
TTFT ( ms) : 61048 .35
TTFT ( ms) : 120001 .31
per Output Token ( excl. 1st token) ------
TPOT ( ms) : 89 .52
TPOT ( ms) : 94 .78
TPOT ( ms) : 121 .95
Latency----------------
ITL ( ms) : 89 .17
ITL ( ms) : 34 .82
ITL ( ms) : 642 .94
==================================================
# random 2K input
============ Serving Benchmark Result ============
requests: 500
duration ( s) : 55 .28
input tokens: 998175
generated tokens: 49471
throughput ( req/s) : 9 .04
token throughput ( tok/s) : 894 .84
output token throughput ( tok/s) : 3723 .00
concurrent requests: 500 .00
Token throughput ( tok/s) : 18950 .04
to First Token----------------
TTFT ( ms) : 26860 .95
TTFT ( ms) : 26155 .54
TTFT ( ms) : 51773 .01
per Output Token ( excl. 1st token) ------
TPOT ( ms) : 125 .93
TPOT ( ms) : 140 .65
TPOT ( ms) : 152 .49
Latency----------------
ITL ( ms) : 124 .89
ITL ( ms) : 39 .21
ITL ( ms) : 632 .84
==================================================
# random 128 input
============ Serving Benchmark Result ============
requests: 984
duration ( s) : 6 .11
input tokens: 125650
generated tokens: 3936
throughput ( req/s) : 161 .07
token throughput ( tok/s) : 644 .28
output token throughput ( tok/s) : 3676 .00
concurrent requests: 984 .00
Token throughput ( tok/s) : 21211 .83
to First Token----------------
TTFT ( ms) : 5621 .51
TTFT ( ms) : 5525 .90
TTFT ( ms) : 5803 .57
per Output Token ( excl. 1st token) ------
TPOT ( ms) : 125 .18
TPOT ( ms) : 152 .34
TPOT ( ms) : 182 .84
Latency----------------
ITL ( ms) : 93 .89
ITL ( ms) : 110 .55
ITL ( ms) : 243 .41
==================================================