LoRA Adaptörlü Modeller Sunma
LoRA (Düşük Sıralı Uyarlama), tüm ağırlıkları yeniden eğitmek yerine küçük bağdaştırıcı dosyaları yükleyerek temel modeli belirli bir alana uyarlayan, parametre açısından verimli bir ince ayar yöntemidir.
GPUStack, birden fazla LoRA bağdaştırıcısını konuşlandırılmış bir temel LLM'ye bağlamanıza olanak tanır ve bağdaştırıcı başına otomatik olarak bir Model Rotası oluşturur; arayanlar, OpenAI uyumlu model alanını ilgili rota adına ayarlayarak, her ince ayar için ayrı bir GPU ayırmadan, istek başına adaptörleri değiştirir.
Bu eğitimde, birden fazla LoRA bağdaştırıcısının vLLM, SGLang veya Ascend MindIE arka ucundaki tek bir temel modele nasıl ekleneceği ve OpenAI uyumlu API aracılığıyla belirli bir bağdaştırıcının nasıl çağrılacağı gösterilir.
Not
LoRA şu anda yalnızca vLLM, SGLang ve Ascend MindIE arka uçlarında desteklenmektedir. lora_list yapılandırması diğer arka uçlarda göz ardı edilir.
Önkoşullar
Devam etmeden önce aşağıdakilerden emin olun:
- GPUStack kurulu ve çalışıyor.
- GPU'lu bir Linux çalışan düğümü mevcuttur. Burada kullanılan temel model
Qwen3-8B'dir, dolayısıyla GPU'nun 8B modeline hizmet vermek için yeterli belleğe ihtiyacı vardır (örneğin, 24 GB veya daha fazlası). İki bağdaştırıcı aynı örneği paylaşır ve yalnızca küçük miktarda ekstra bellek ekler. - Model ve adaptör dosyalarını indirmek için Hugging Face'e erişim.
Bu eğitimde iki LoRA adaptörleri tek bir temel modele monte edilir, böylece arayanların istek başına ince ayarlar arasında nasıl geçiş yaptığını görebilirsiniz. Aşağıdaki yapılandırmayı kullanır:
| Ürün | Bu eğitimde kullanılan değer |
|---|---|
| Model kaynağı | Hugging Face |
| Arka uç | vLLM |
| Temel model | Qwen/Qwen3-8B |
| LoRA adaptörü 1 | AMaslovskyi/qwen-devops-foundation-lora (adı devops) |
| LoRA adaptörü 2 | XinyuanWang/qwen3-8b-medical-lora (adı medical) |
Her iki adaptör de Qwen/Qwen3-8B'ı temel model olarak bildirir. Bu kesin bir gerekliliktir: Bir dağıtıma takılan her bağdaştırıcının aynı temel modeli paylaşması gerekir.
İpucu
Eğitimi bu değerlerle tamamladıktan sonra kaynak olarak ModelScope veya Local Path'i, arka uç olarak SGLang veya Ascend MindIE'i ve kendi temel modelinizi ve adaptörlerinizi değiştirebilirsiniz. Arka uç başına farklılıklar için Arka Uç Uyumluluğu ve Sınırları konusuna bakın.
1. Adım: Temel Modeli LoRA Adaptörleriyle Dağıtın
Deploymentssayfasına gidin veDeploy Model'e tıklayın, ardından kaynak olarakHugging Face'yi seçin.- Arama kutusuna
Qwen/Qwen3-8Byazın ve sonuçlardan seçin. - Arka ucu
vLLMolarak ayarlayın. -
Advancedbölümünü genişletin veLoRA Adapters'i bulun. ilk adaptörünü ekleyin:- Bağdaştırıcı açılır menüsüne
AMaslovskyi/qwen-devops-foundation-lorayazın ve seçin. LoRA namealanınadevopsgirin.
- Bağdaştırıcı açılır menüsüne
-
ikinci adaptörünü eklemek için tıklayın:
- Bağdaştırıcı açılır menüsüne
XinyuanWang/qwen3-8b-medical-lorayazın ve seçin. LoRA namealanınamedicalgirin.
- Bağdaştırıcı açılır menüsüne
-
Dağıtımı tamamlamak için
Saveöğesine tıklayın.
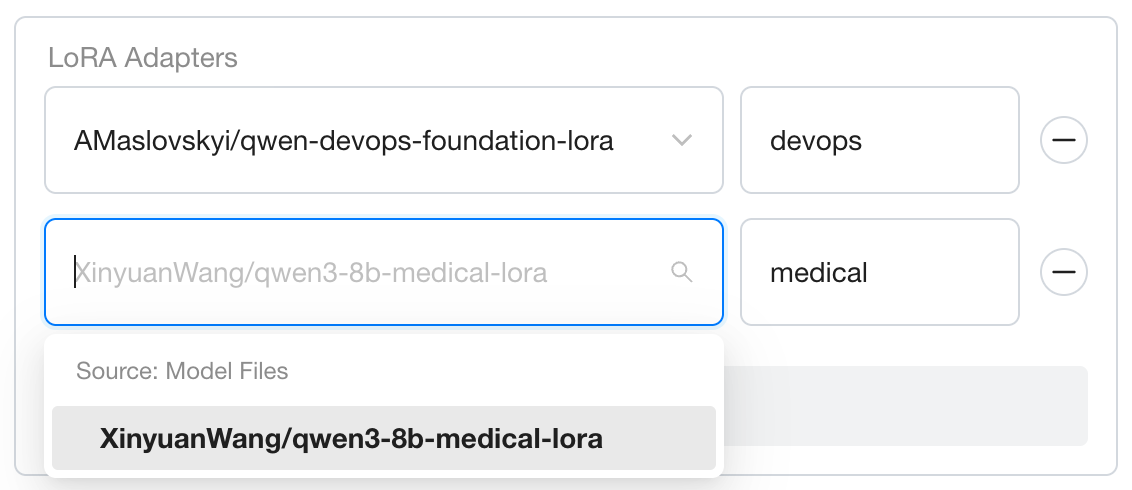
Not
Temel model öneki olmadan yalnızca çıplak adaptör adını (devops, medical) girin. GPUStack, aynı zamanda her bağdaştırıcıyı çağırmak için kullandığınız Model Rota adı olan tam tanımlayıcıyı (qwen3-8b:devops, qwen3-8b:medical) otomatik olarak türetir (bkz. Adım 2).
İpucu
Her bağdaştırıcının ayrı bir LoRA name olması gerekir — daha fazlasını monte etmek için ekleme adımını tekrarlayın. İstediğiniz adaptör açılır listede görünmüyorsa öncelikle Hugging Face veya ModelScope'ta modelin gerçekten bir LoRA adaptörü gönderdiğini doğrulayın, ardından tam depo kimliğini seçmek için arama kutusuna yapıştırın.
Adım 2: Bir LoRA Adaptörünü Çağırın
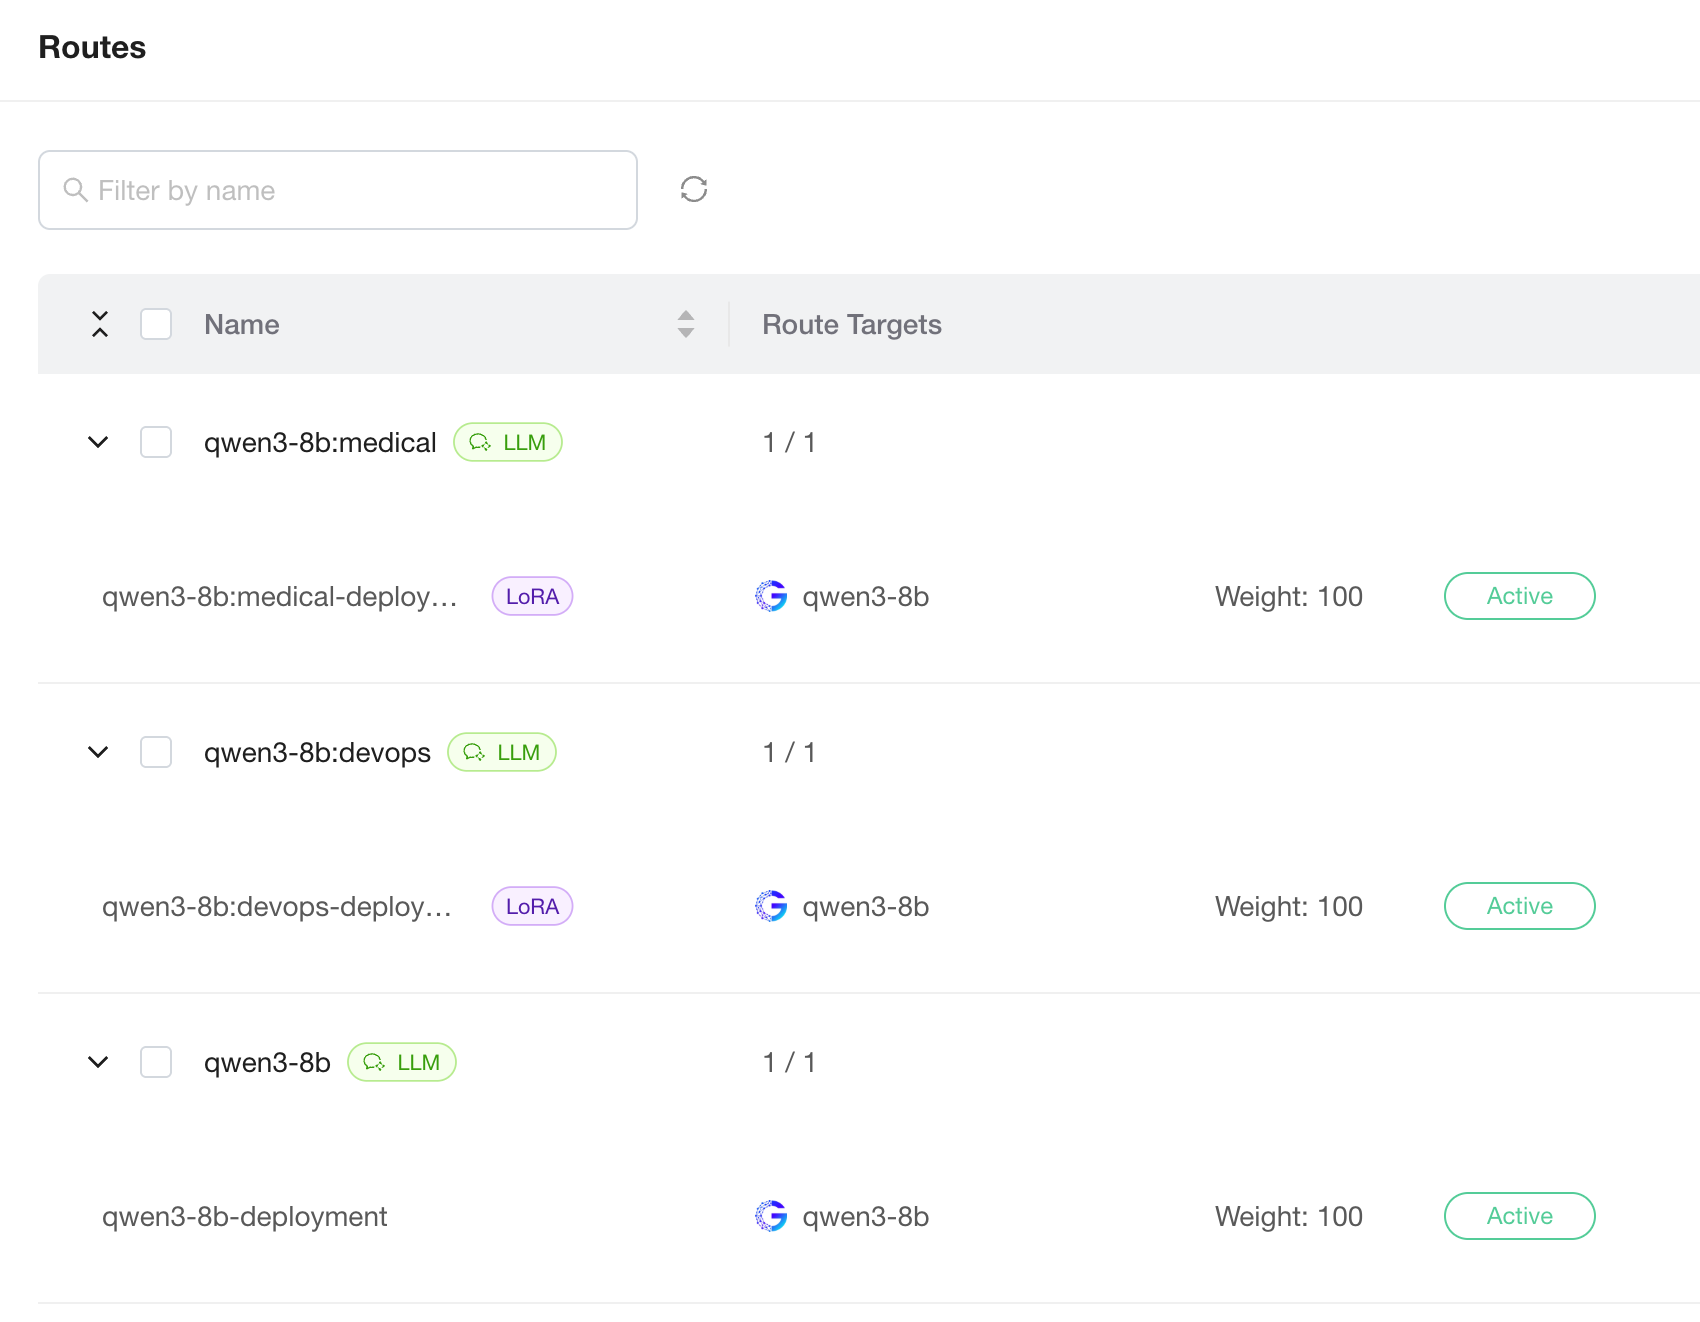
Dağıtımdan sonra GPUStack, her LoRA bağdaştırıcısı için otomatik olarak <base-model-name>:<adapter-name> adlı bir Model Rota oluşturur. Bu eğitimde üç rota elde ediliyor: qwen3-8b tabanı, artı qwen3-8b:devops ve qwen3-8b:medical. Her LoRA rotası, Model Routes sayfasında temel modelin kendi Model Rotasının yanında görünür ve kolay tanımlama için LoRA rozetiyle etiketlenir.
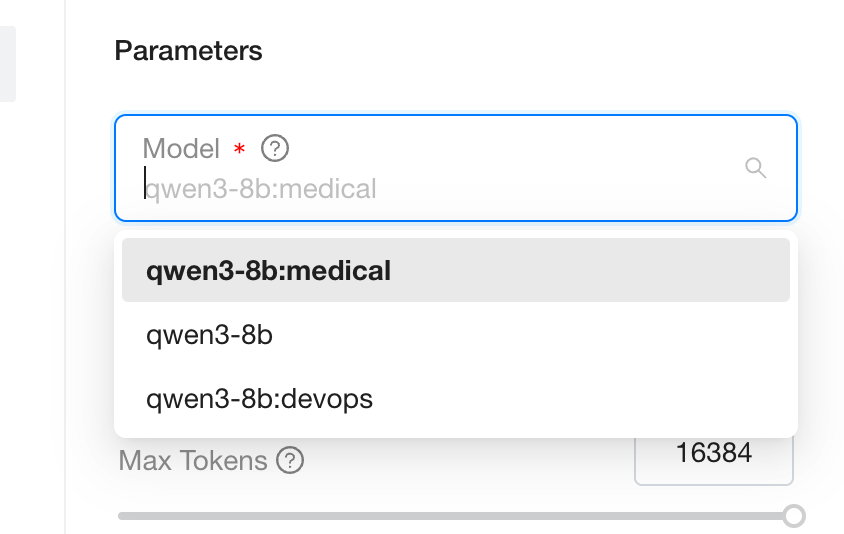
Playground'da bir model seçtiğinizde açılır listede temel model ve tüm LoRA adaptörleri listelenir; seçeneğin değiştirilmesi, isteği ilgili adaptöre yönlendirir. Aynı durum OpenAI uyumlu API için de geçerlidir; model alanını temel model adına veya herhangi bir adaptör rota adına ayarlayın. Temelde tüm adaptörler aynı GPU örneğini paylaşır, dolayısıyla bunlar arasında geçiş yapmak, modelleri değiştirmekten çok daha ucuzdur.
Örneğin, aynı istem yalnızca model alanını değiştirerek iki ince ayardan birine yönlendirilebilir. DevOps bağdaştırıcısına bir Kubernetes sorusu gönderin:
Ardından yalnızca model değerini değiştirerek klinik soruyu tıbbi adaptöre yönlendirin:
<your-gpustack-server>'i sunucu adresinizle ve <your-api-key>'i API Keys sayfasında oluşturulan API anahtarıyla değiştirin. "model": "qwen3-8b" gönderilmesi bunun yerine adaptör uygulanmayan temel modeli hedefler.
3. Adım: LoRA Adaptörlerini Yönetin
Dağıtım oluşturulduktan sonra LoRA yapılandırmasını ayarlayabilirsiniz:
- Bağdaştırıcı ekleyin: Dağıtılan modeli düzenleyin ve kaydedin. Yeni eklenen bağdaştırıcının takılıp sunulmasından önce zaten
Runningdurumunda olan örneklerin yeniden başlatılması gerekir. - Bir bağdaştırıcıyı kaldırın: Dağıtılan modelden ilgili girişi silin. GPUStack, hiçbir
Runningörneği hala bağdaştırıcıyı kullanmadığında eşleşen Model Rotasını otomatik olarak kaldırır. - Ad çakışmaları: İki farklı temel model, adları aynı Model Rotasına çözümlenen bağdaştırıcılar eklerse gönderim bir çakışma hatasıyla reddedilir. Kurtarmak için bağdaştırıcılardan birini yeniden adlandırın.
Arka Uç Uyumluluğu ve Sınırları
LoRA desteği, çıkarım arka uçlarına göre değişiklik gösterir:
| Arka uç | LoRA başlangıç argümanları / konfigürasyonu | Temel sınırlamalar |
|---|---|---|
vLLM | --enable-lora, --max-loras, --lora-modules | --max-loras lora_list uzunluğundan itibaren otomatik olarak ayarlanır. Temel model başladıktan sonra bağdaştırıcı sayısı sabitlenir; değişiklikler örneğin yeniden başlatılmasını gerektirir. |
SGLang | --enable-lora, --lora-paths name=path, --max-loras-per-batch | Bir grupta aynı anda etkinleştirilen LoRA'ların sayısı --max-loras-per-batch ile sınırlıdır. |
Ascend MindIE | maxLoras / maxLoraRank / LoraModules yapılandırma dosyasında | maxLoraRank varsayılan olarak 64'tür; Daha yüksek dereceli adaptörler başlatılamıyor. maxLoras=0 otomatik olarak takılan adaptör sayısına eşittir. |
GPUStack bu parametreleri otomatik olarak enjekte eder; genellikle bunları Backend Parameters altında tekrarlamanıza gerek yoktur. Yalnızca Advanced → Backend Parameters altına bayrak ekleyerek varsayılanları geçersiz kılın (örneğin, maxLoraRank'i yükseltmek).
Tüm ayrıntılar ve sınırlamalar için her bir arka ucun resmi belgelerine bakın:
- vLLM: LoRA Adaptörleri
- SGLang: LoRA Sunumu
- Ascend MindIE: Multi-LoRA (yalnızca Çince)