Dağıtılmış vLLM'yi Çoklu İşleme Arka Uçuyla Çalıştırma
Tek bir çalışanın bir modeli barındırmak için yeterli GPU belleği veya bilgi işlemi olmadığı durumlarda vLLM, işbirliğine dayalı çıkarım için bir model örneğini birden fazla çalışana bölebilir. GPUStack, bu düğümler arası işlemleri tek model örneği olarak düzenler ve yalnızca bir OpenAI uyumlu uç nokta ortaya çıkarır. vLLM, --distributed-executor-backend parametresi aracılığıyla iki yürütme yolu sunar: ray ve mp (MultiProcessing). Bu eğitimde, tensör paralelliği (TP) ve veri paralelliği (DP) kombinasyonuyla birden çok çalışan arasında dağıtılmış çıkarım yürütmek için MP arka ucunun nasıl kullanılacağı gösterilir.
Bu eğitimde, GPUStack'te çalışanlar arası dağıtılmış çıkarımı nasıl etkinleştireceğinizi, MP arka ucunu açıkça seçmeyi ve iki düğüm arasında tek bir model örneğini dağıtmak için tensör paralelliğini veri paralelliğiyle birleştirmeyi öğreneceksiniz.
Not
- MP arka ucu,
Backend Parameters'de açıkça--distributed-executor-backend=mpayarladığınızda veya vLLM ≥0.18.0ile özel bir imaj (-customson ekine sahip bir arka uç sürümü) kullandığınızda etkili olur.0.18.0'den itibaren vLLM artık varsayılan olarak Ray'e bağlı değildir, bu nedenle GPUStack, başlatma hatalarını önlemek için otomatik olarakmp'e geri döner. - Ray ve MP yolları, başsız takipçi ve
dp_only/mp_only/nestedtopolojileri arasındaki kavramsal farklılıklar için, Yerleşik Çıkarım Arka Uçları'dekiDistributed Inference Across Workersbölümüne bakın. - Bu özellik şu anda deneme aşamasındadır.
Önkoşullar
Başlamadan önce aşağıdakilere sahip olduğunuzdan emin olun:
- GPUStack kurulu ve çalışıyor.
- Her biri aynı sayıda ve aynı model GPU'ya sahip en az 2 Linux düğümü. Bu eğitimde örnek olarak 2 düğüm × 8 GPU (toplam 16 GPU) kullanılmaktadır; bu, NVIDIA, AMD ve Ascend gibi çeşitli satıcıların hızlandırıcılarına uygulanabilir.
- Daha iyi performans için düğümler arasında yüksek hızlı bir ara bağlantı (NVLink veya InfiniBand gibi) önerilir.
- Model dosyalarına, katılan her düğümdeaynı yoldan erişilebilir olmalıdır. Paylaşılan bir dosya sistemi kullanın veya model dosyalarını her düğümde aynı yola önceden indirin.
- Seçilen model
tensor-parallel-size=8,data-parallel-size=2düzenine uygundur (yani her veri paralel kopyası bir tam 8 GPU düğümünü kaplar).
Not
Bu eğitimde, her veri paralel kopyasının (tensor-parallel-size=8) bir 8 GPU düğümünü tamamen kapladığı varsayılmaktadır. Modelinize ve donanımınıza göre --tensor-parallel-size ve --data-parallel-size'yi ayarlayın.
Adım 1: GPUStack Çalışanlarını Ekleyin
Installation'in ardından, her düğümü aynı GPUStack kümesine eklemek için join komutunu çalıştırın.
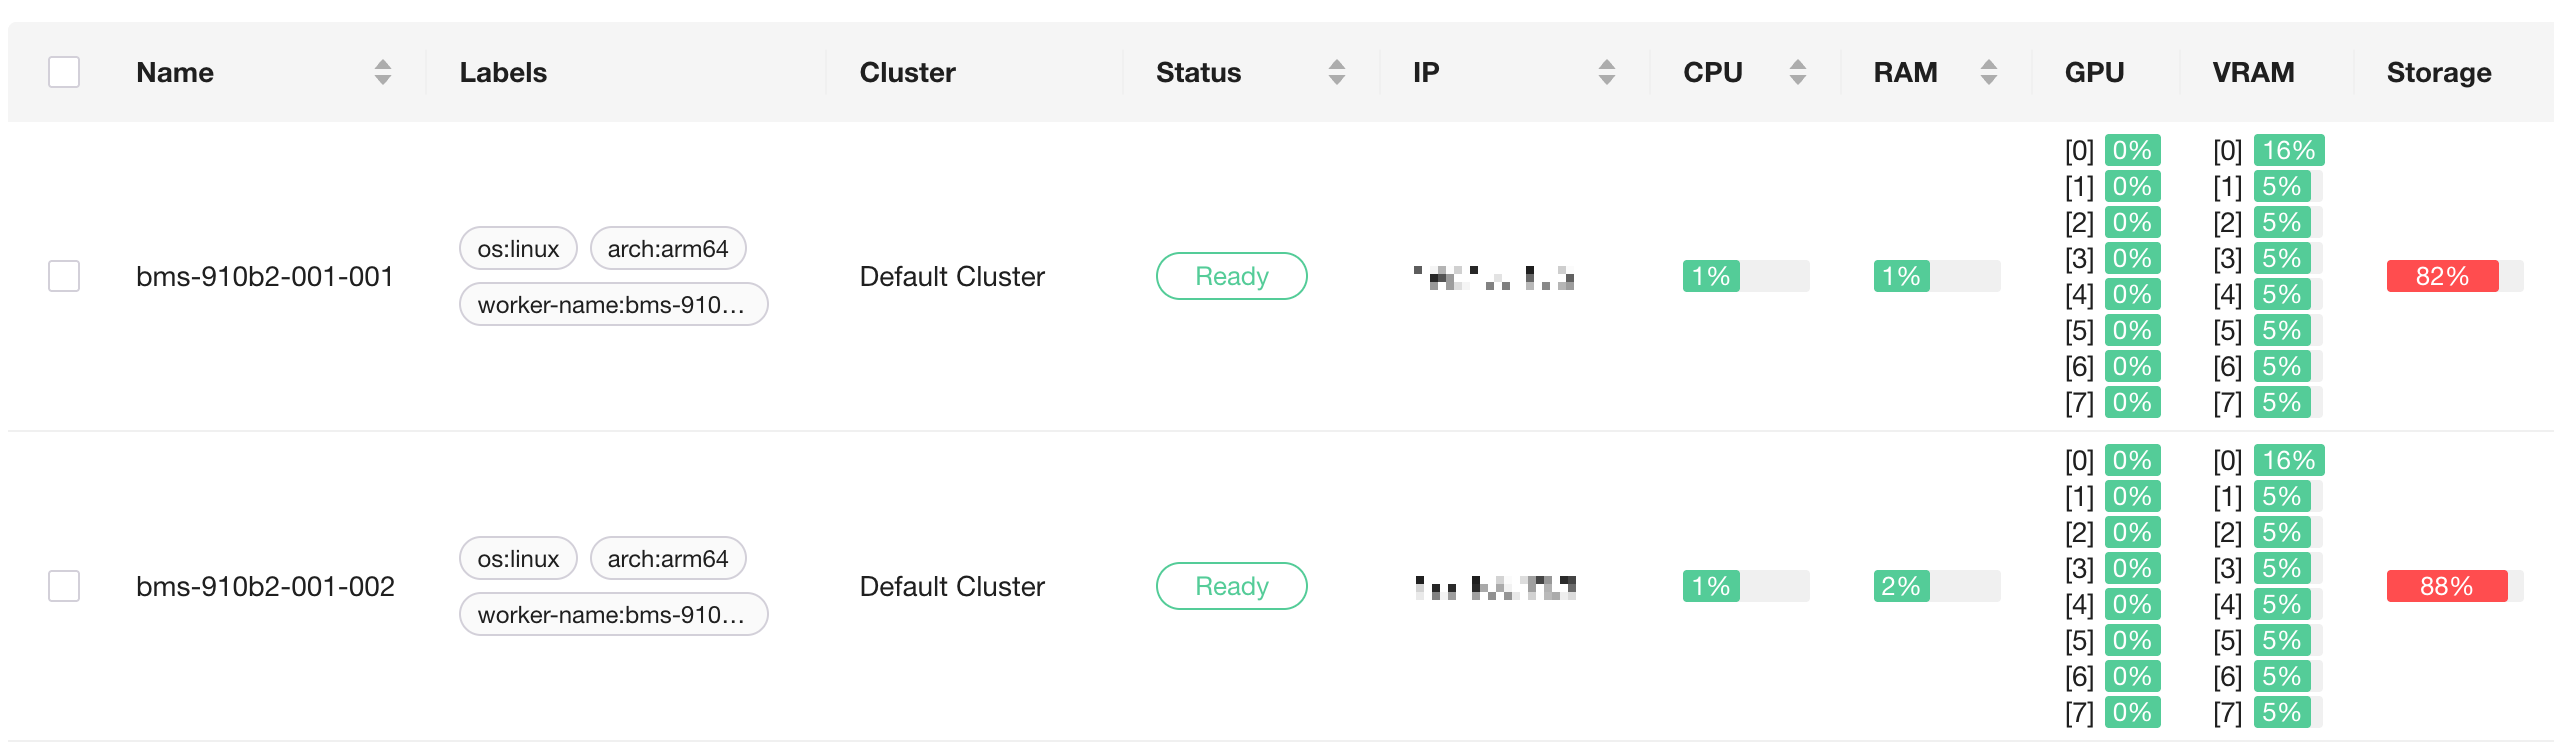
Katıldıktan sonra, GPUStack kullanıcı arayüzündeki Workers sayfasında her iki düğümün de Hazır durumda olduğunu ve GPU'larının listelendiğini doğrulayın.
Adım 2: Modeli MP Arka Uç ile Dağıtın
Deploymentssayfasına gidin.Deploy Model'e tıklayın, model kaynağını seçin (Local Pathgibi) ve tüm düğümlerde tutarlı olan model yolunu girin.Backend'invLLMolarak ayarlandığını doğrulayın.- Gelişmiş ayarlar altında, çalışanlar arası dağıtılmış çıkarımı etkinleştirmek için
Allow Distributed Inference Across Workersseçeneğini işaretleyin. -
Backend Parameters'e aşağıdaki parametreleri ekleyin: -
Uyumluluk kontrolünü geçtikten sonra dağıtmak için
Saveseçeneğine tıklayın.
Dağıtılmış örneğin tamamını tek bir dağıtım olarak dağıtın
Düğümler arası dağıtılmış bir örneği tek dağıtım olarak dağıtmanızı öneririz. Yukarıda açıklandığı gibi yalnızca bir dağıtım oluşturduğunuzda GPUStack şunları yapacaktır:
- her iki çalışandaki GPU'ları seçin (bu örnekte 16) ve düğüm başına
--data-parallel-size-localdeğerini otomatik olarak türetin, böylece manüel olarak--data-parallel-size-localayarlamanıza gerek kalmaz; - çok düğümlü topoloji parametrelerini
--nnodes,--node-rank,--master-addrve--master-portenjekte edin; - takipçi örneklerine otomatik olarak
--headlesseklenir, böylece yalnızca dağıtılmış hesaplamaya katılırlar ve bir API uç noktası başlatmazlar. Takipçi kayıtlarında--headless'in görülmesi bekleniyor.
Otomatik planlama sağlanamadığında
Otomatik planlama, bir koşulun karşılanmaması nedeniyle kaynakları tahsis edemiyorsa (örneğin, GPU belleği gpu_memory_utilization'i karşılamıyor), Scheduling Mode'yi Manual veya Specify GPU olarak değiştirin ve ardından iki çalışanın her birinde 8 GPU seçmek için GPU Selector'i kullanın (toplamda 16). Otomatik planlamanın tüm koşulları için Yerleşik Çıkarım Arka Uçları konusuna bakın.
Ayrı dağıtımlarda manuel DP
GPUStack 2.3.1 sonrasında eklenen GPUSTACK_MANUAL_DP, yeni vLLM MP sürümlerinde birden fazla dağıtımı manuel olarak bir DP grubunda birleştirme yöntemini korur. Her dağıtımın Environment Variables bölümünde şunu ayarlayın:
Örneğin, her biri 8 GPU içeren iki düğüm için iki dağıtım oluşturun. Her dağıtımda ilgili düğümün 8 GPU'sunu manuel olarak seçin ve şu Backend Parameters değerlerini ayarlayın:
<your-dp-coordinator-ip> yerine ilk düğümün IP adresini yazın. İkinci dağıtımda aynı parametreleri kullanın ve --data-parallel-rank değerini 1 olarak değiştirin. Ayrıca GPUSTACK_SKIP_GPU_COUNT_CHECK ayarlamanız gerekmez.
3. Adım: Dağıtımı İzleyin
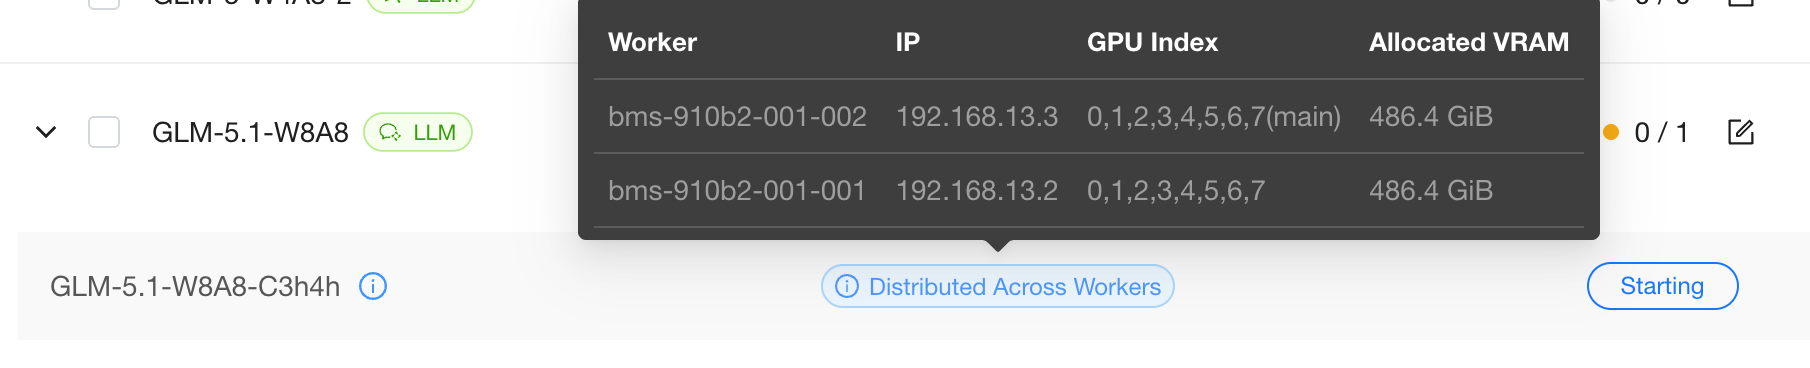
Deployments sayfasından dağıtım durumunu izleyin. Örneğin her çalışandaki GPU kullanımını imajlemek için Distributed Across Workers'in üzerine gelin. Gerçek zamanlı günlükleri görmek için View Logs'ye tıklayın:
- leader örneği modeli yükler ve OpenAI uyumlu uç noktayı ortaya çıkarır;
- follower örnek günlükleri
--headless'yi gösterir; bu, yalnızca dağıtılmış hesaplamaya katıldığı ve bir API bağlantı noktasını işgal etmediği anlamına gelir. Bu bekleniyor.
Modelin yüklenmesi birkaç dakika sürebilir.
Adım 4: Oyun Alanı aracılığıyla doğrulayın
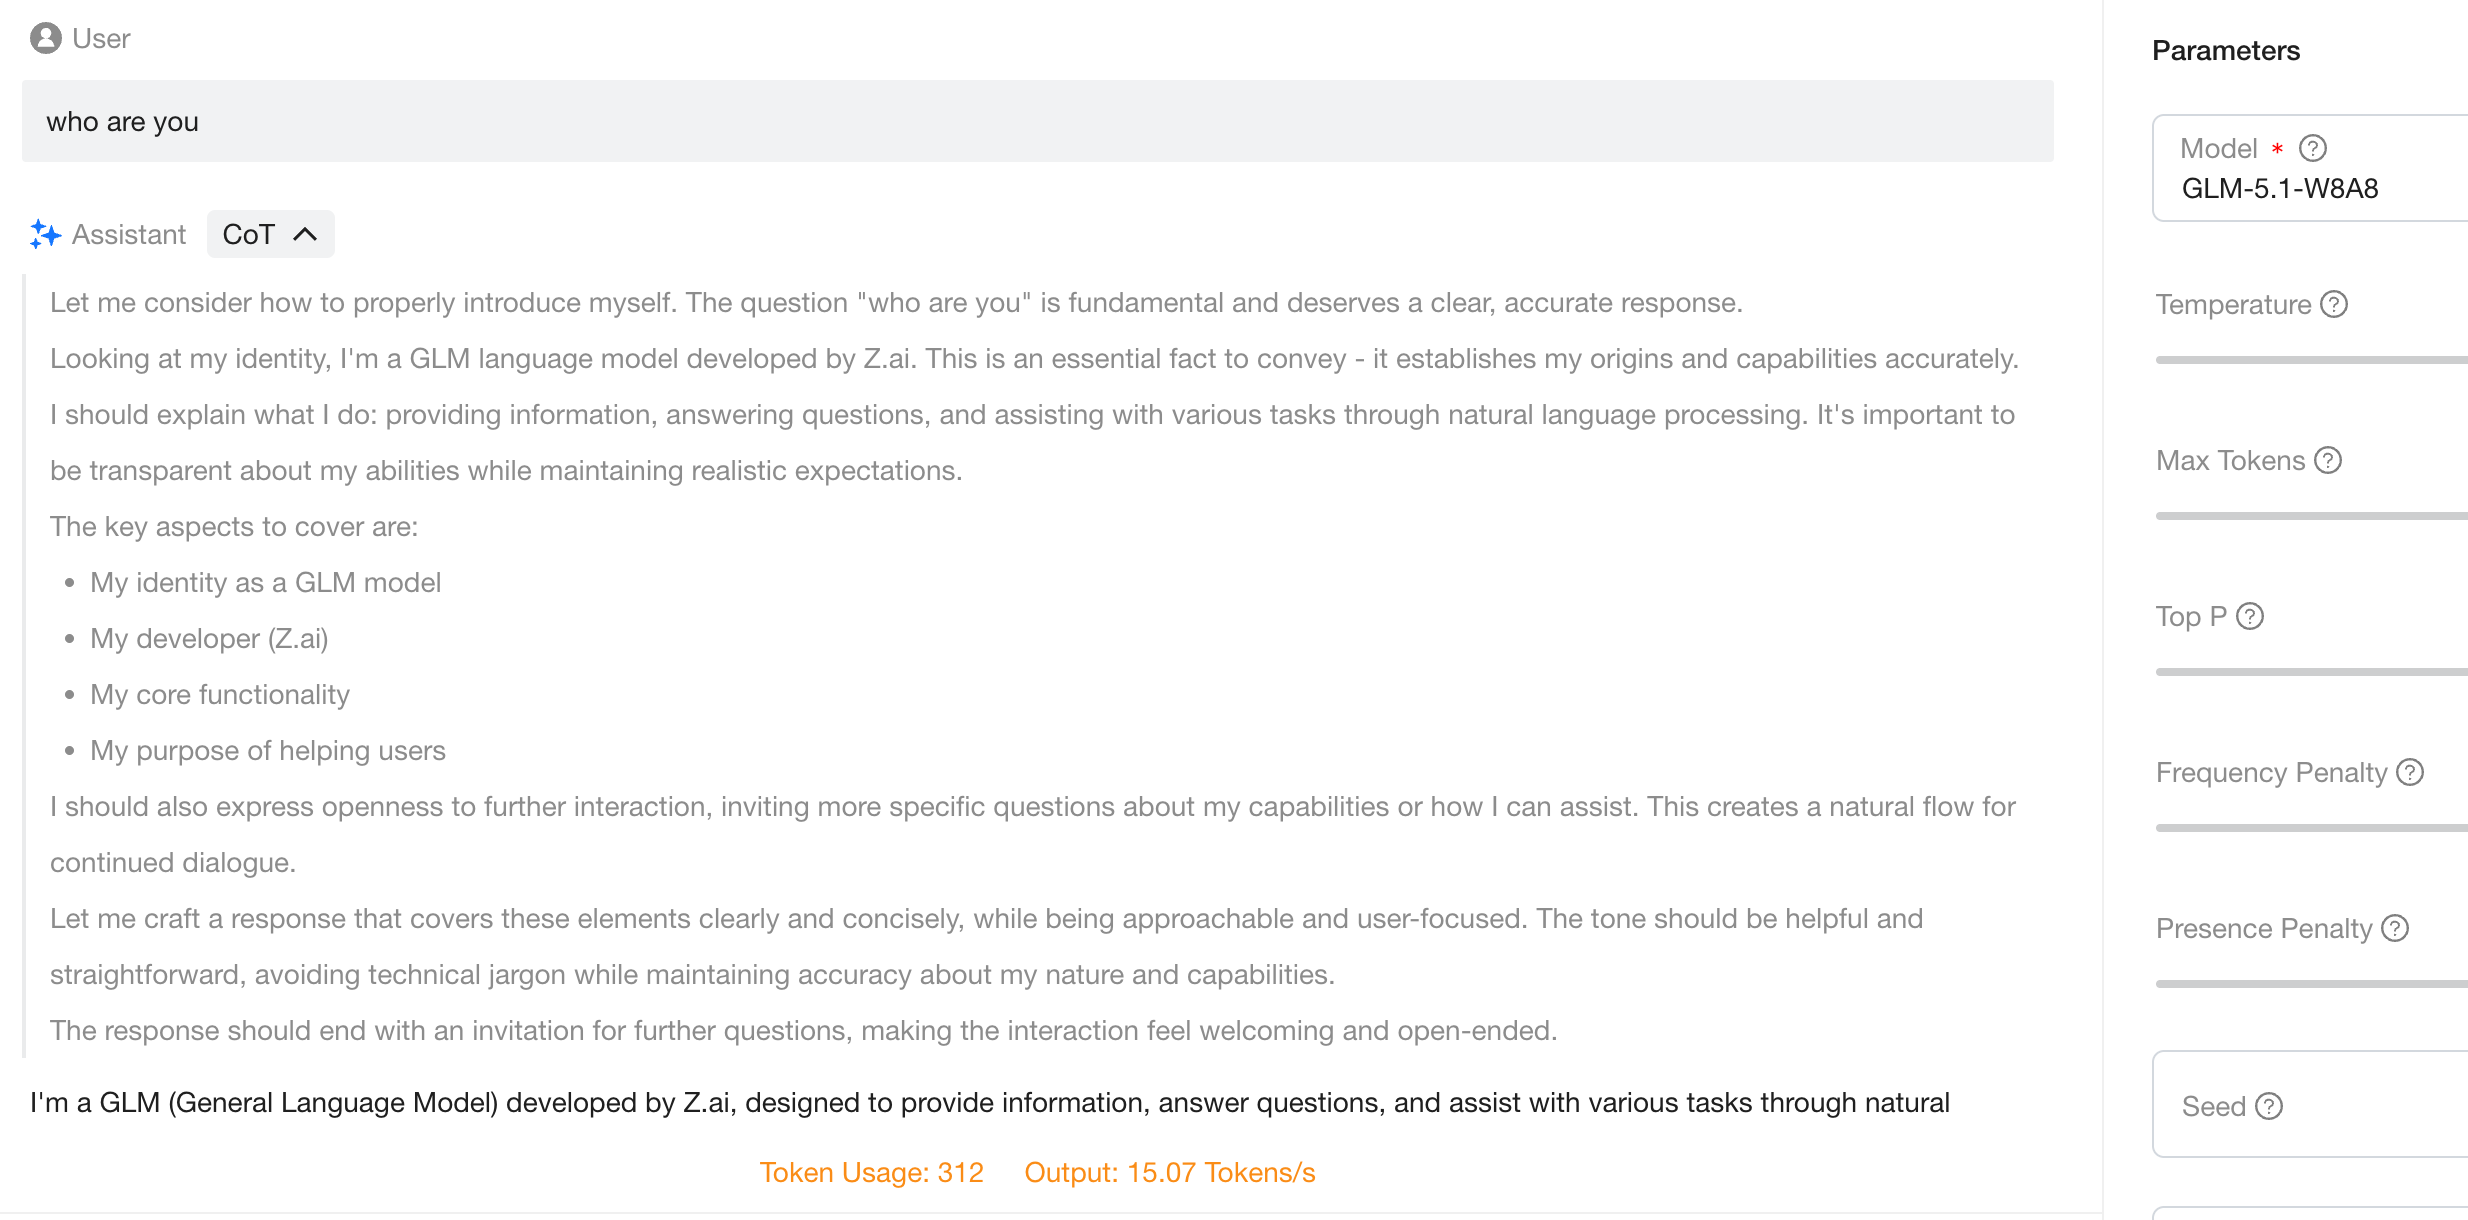
Dağıtım çalışmaya başladıktan sonra bunu doğrudan GPUStack Playground'da doğrulayın. Tüm harici istekler, bunları takipçilere gönderen lider aracılığıyla girer; böylece kullanım, tek çalışanlı dağıtımla aynıdır:
Playground>Chatseçeneğine gidin.- Yalnızca bir model konuşlandırılmışsa varsayılan olarak seçilir; aksi takdirde sağ üst köşedeki açılır menüden modelinizi seçin.
- Bir bilgi istemi girin ve modelle etkileşim kurun.
Artık vLLM'nin MP arka ucunu kullanarak bir GPUStack kümesindeki birden fazla düğümde dağıtılmış çıkarımı başarıyla dağıttınız ve çalıştırdınız.
Daha fazla yardıma ihtiyacınız olursa GPUStack topluluğu veya destek ekibiyle iletişime geçmekten çekinmeyin.