

Genel Bakış
GPUStack, AI modellerini sunmak ve GPU örnekleri sağlamak için açık kaynaklı bir GPU küme yöneticisidir. vLLM, SGLang, TensorRT-LLM veya kendi çıkarım motorlarınızı yapılandırıp düzenler ve talep üzerine SSH ile erişilebilen GPU örnekleri başlatmanıza olanak tanır.
-
Çok Kümeli GPU Yönetimi
Şirket içi sunucular, Kubernetes ve bulut sağlayıcıları genelinde GPU kümelerini yönetir. Model dağıtımları ve GPU örnekleri için yapılandırılabilir VRAM ve hesaplama kaynağı tahsisleriyle GPU dilimlemeyi destekler.
-
Takılabilir Çıkarım Motorları
vLLM, SGLang ve TensorRT-LLM gibi yüksek performanslı çıkarım motorlarını otomatik olarak yapılandırır. Gerektiğinde özel çıkarım motorları da ekleyebilirsiniz.
-
Performans İçin Optimize Edilmiş
Düşük gecikme veya yüksek verim için önceden ayarlanmış modlar sunar. Prefill/decode ayrıştırmasını, platform tarafından yönetilen paylaşımlı KV önbelleğini ve spekülatif kod çözmeyi destekler.
-
Yerleşik Performans Testleri
Auto Tune, eşzamanlılık düzeylerini veya istek hızlarını otomatik olarak değiştirerek en yüksek verimi veya hizmet düzeyi hedeflerinizi (SLO) karşılayan en yüksek eşzamanlılık düzeyini bulur.
-
GPU Örnekleri
Geliştirme, ince ayar ve etkileşimli iş yükleri için talep üzerine SSH ile erişilebilen GPU örnekleri başlatır.
-
Kurumsal Düzeyde İşlemler
Otomatik arıza kurtarma, yük dengeleme, izleme, kimlik doğrulama ve erişim kontrolü için destek sunar.
Mimari
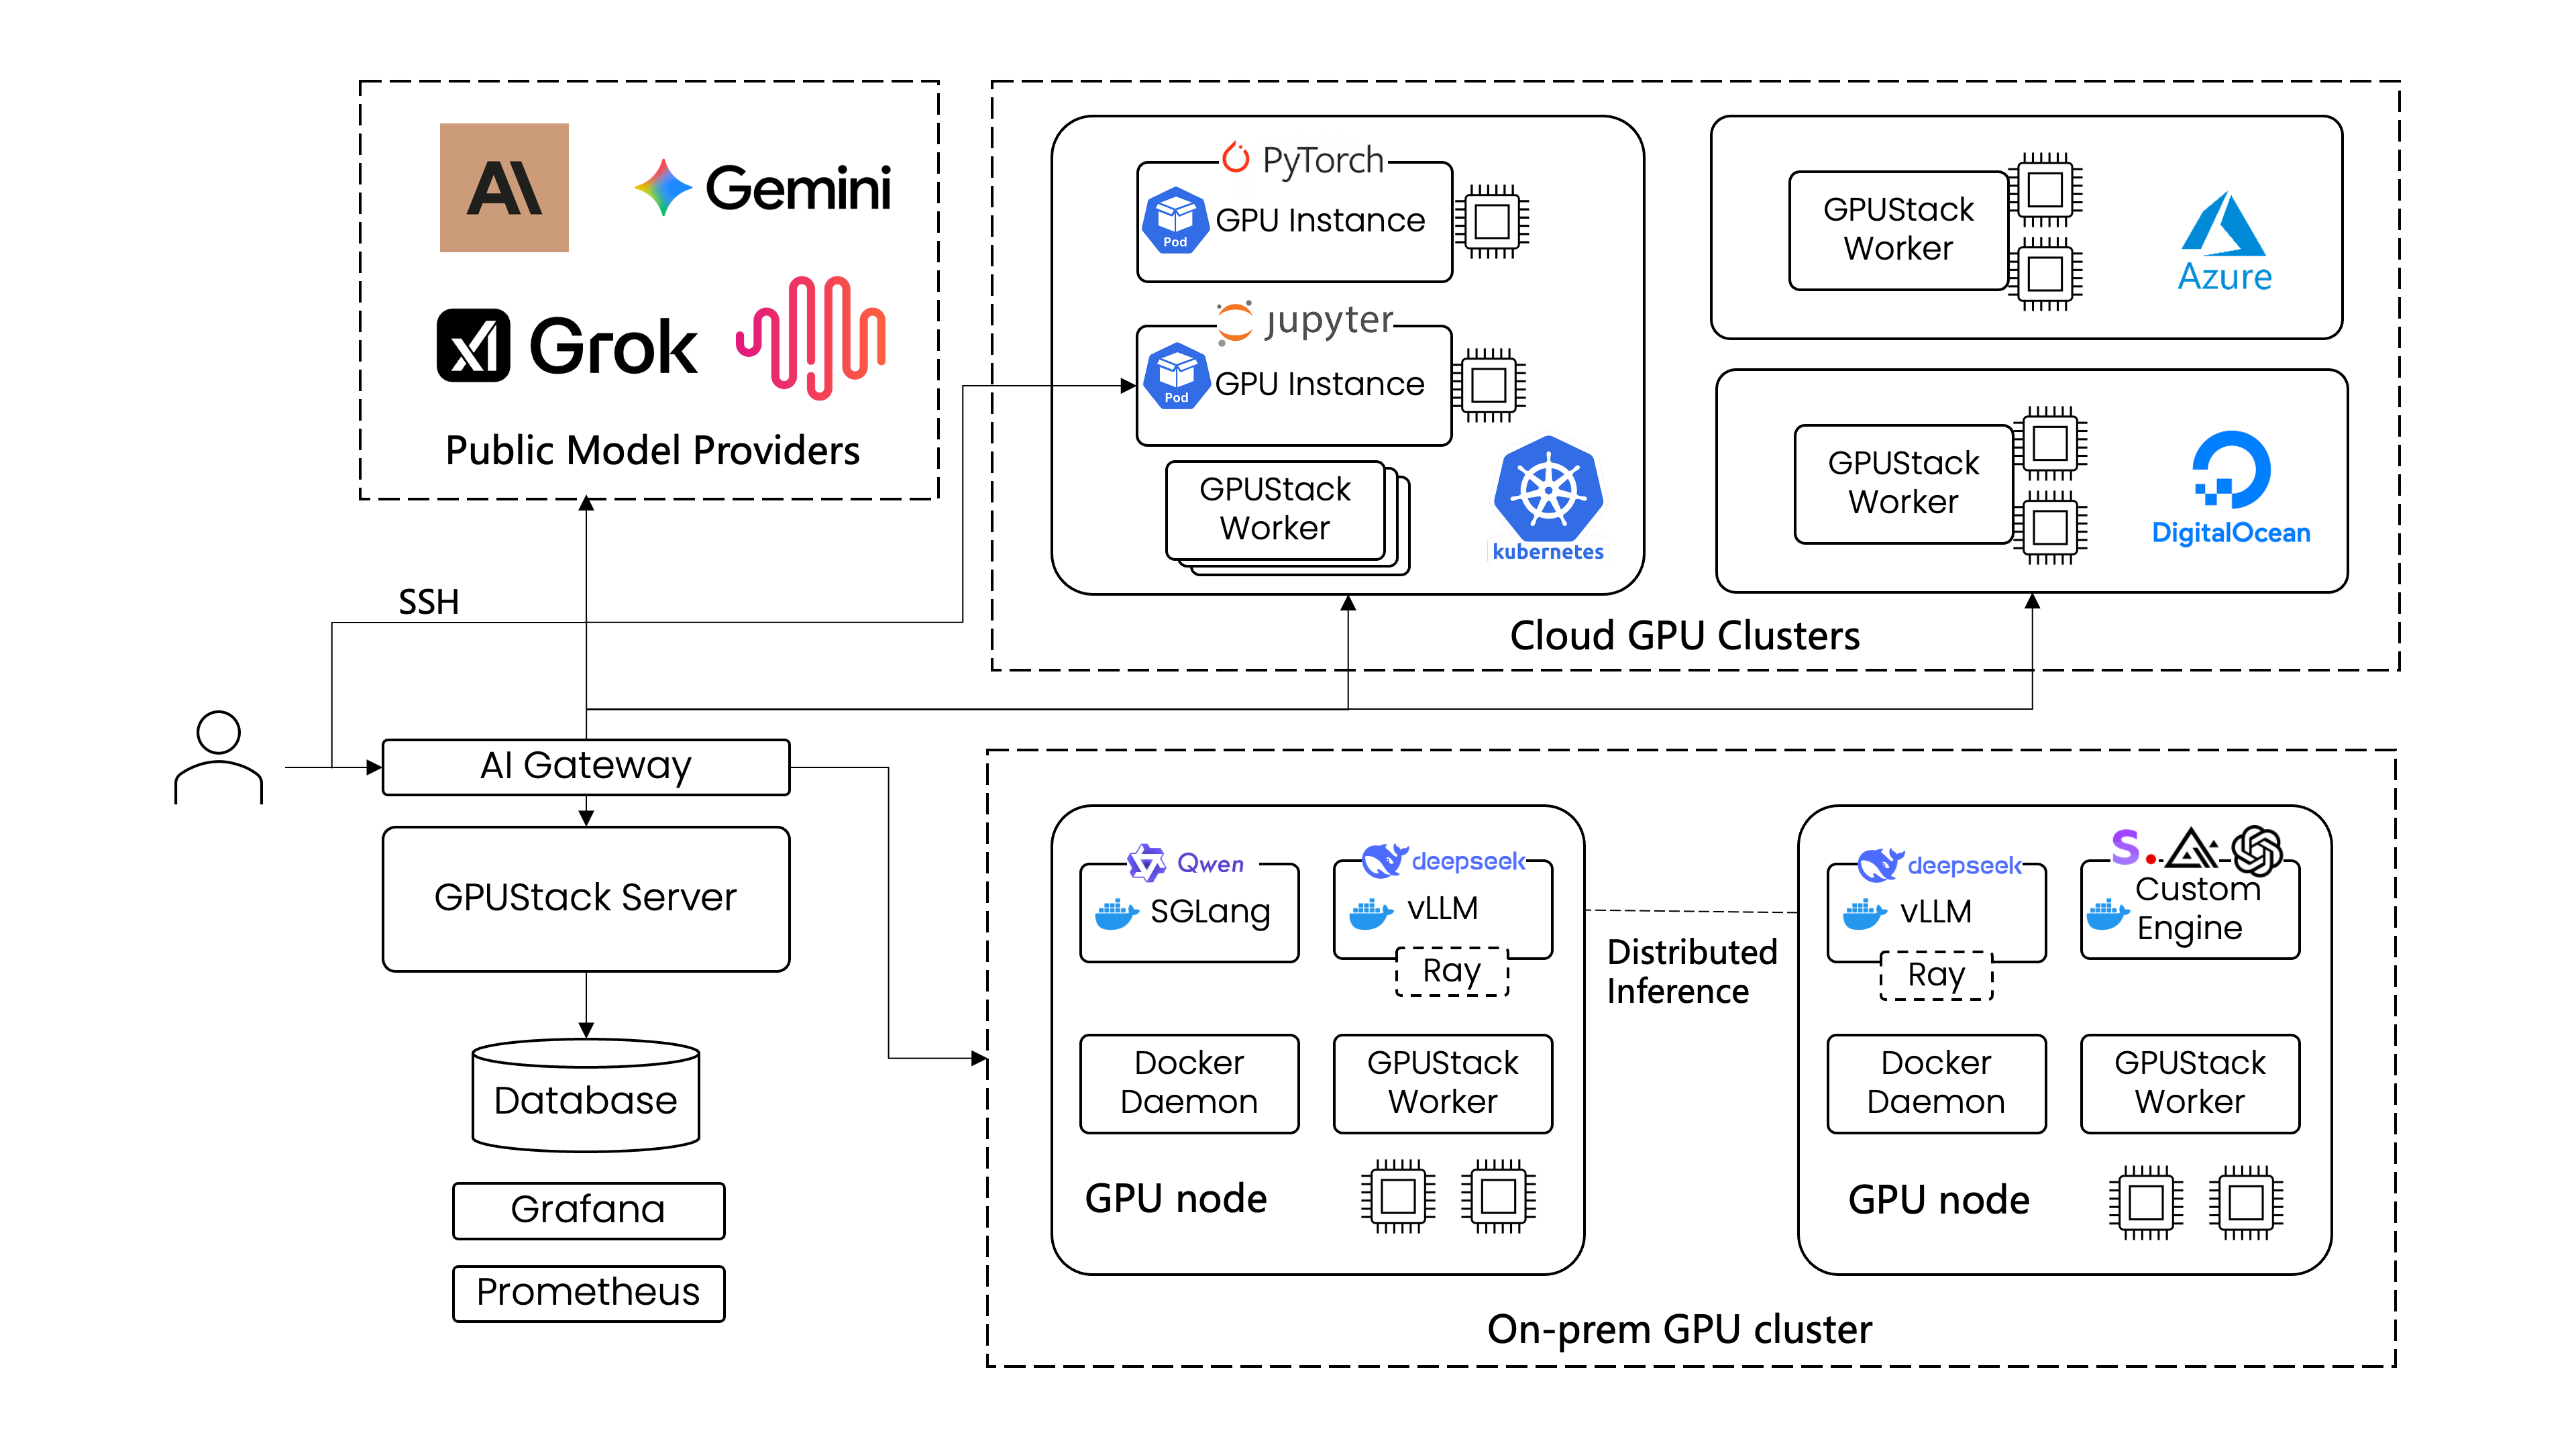
GPUStack, geliştirme ekiplerinin, BT organizasyonlarının ve hizmet sağlayıcılarının geniş ölçekte Hizmet Olarak Model sunmasına olanak tanır. LLM, ses, görüntü ve video modelleri için endüstri standardı API'leri destekler. Platform, yerleşik kullanıcı kimlik doğrulaması ve erişim kontrolünü, GPU performansının ve kullanımının gerçek zamanlı izlenmesini ve belirteç kullanımı ile API istek oranlarının ayrıntılı ölçümünü içerir.
Aşağıdaki şekil, tek bir GPUStack sunucusunun hem şirket içi hem de bulut ortamlarında birden fazla GPU kümesini nasıl yönetebileceğini göstermektedir. GPUStack zamanlayıcı, kaynak kullanımını en üst düzeye çıkarmak için GPU'ları tahsis eder ve optimum performans için uygun çıkarım motorlarını seçer. Yöneticiler ayrıca entegre Grafana ve Prometheus kontrol panelleri aracılığıyla sistem sağlığına ve ölçümlere ilişkin tam görünürlük elde eder.
Bir Bakışta Küme Görünürlüğü
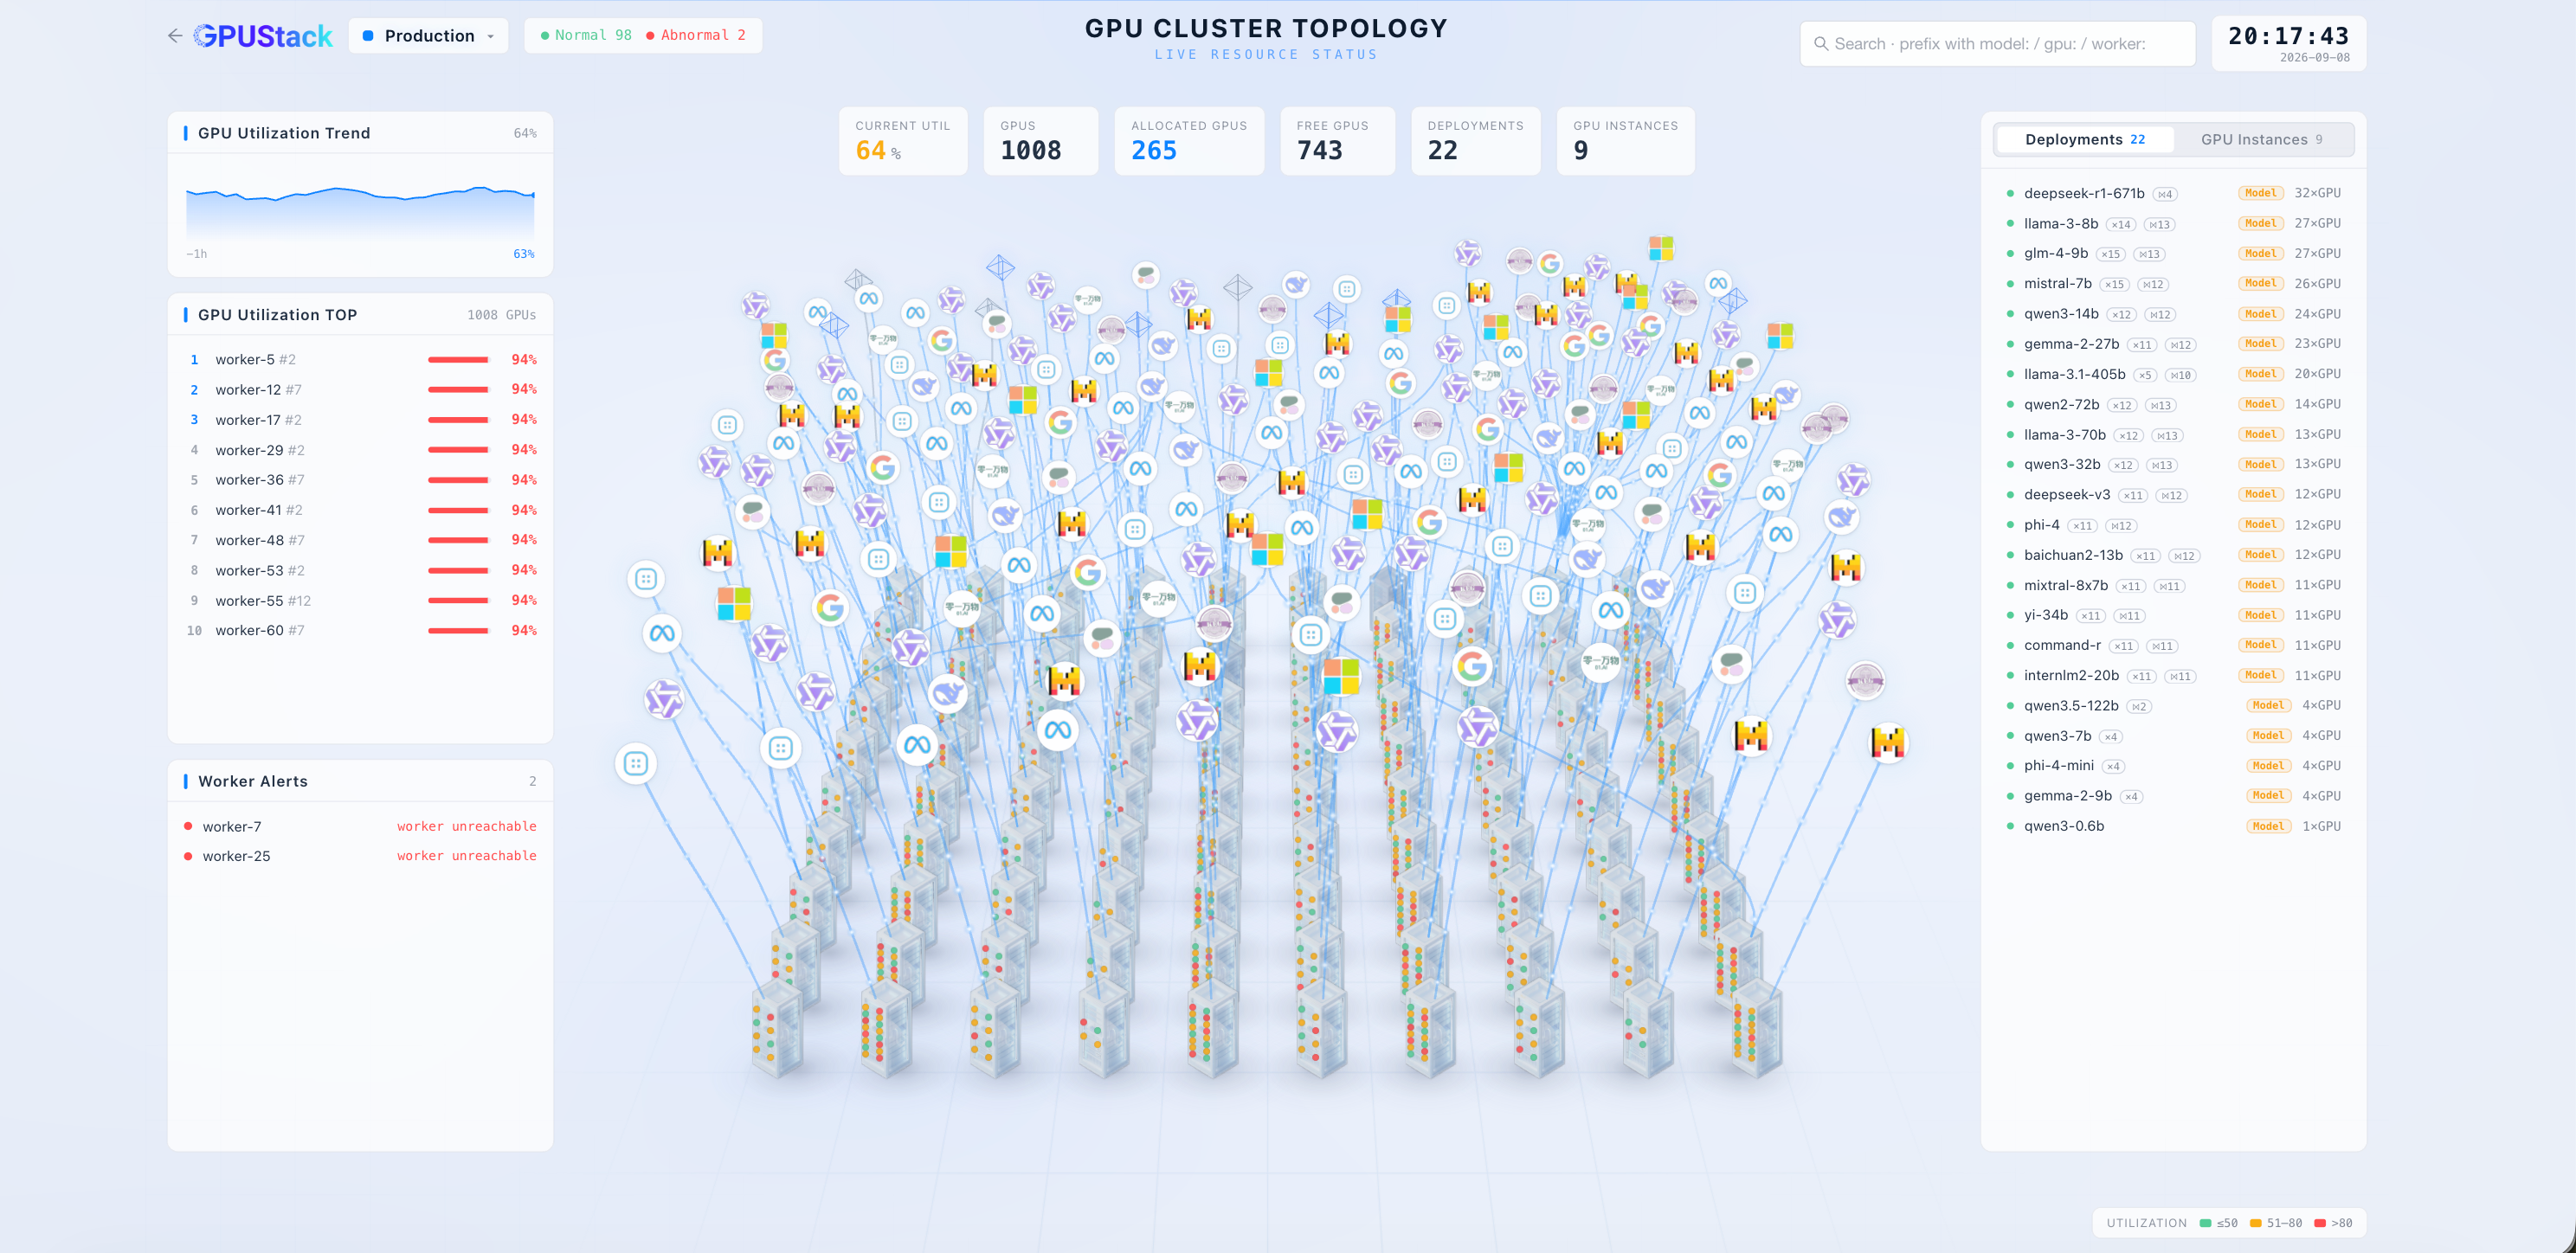
GPUStack Enterprise'deki GPU Küme Topolojisi görünümü, gerçek zamanlı kullanım, tahsis ve sağlık durumuyla birlikte tüm filonuzun (her çalışan, GPU ve model dağıtımı) tek bir yerde canlı, kuşbakışı görünümünü sağlar.
Optimize Edilmiş Çıkarım Performansı
GPUStack'in otomatik motor seçimi ve parametre optimizasyonu, kutudan çıktığı haliyle güçlü çıkarım performansı sunar. Aşağıdaki şekil, varsayılan vLLM yapılandırmalarına göre aktarım hızı iyileştirmelerini göstermektedir:
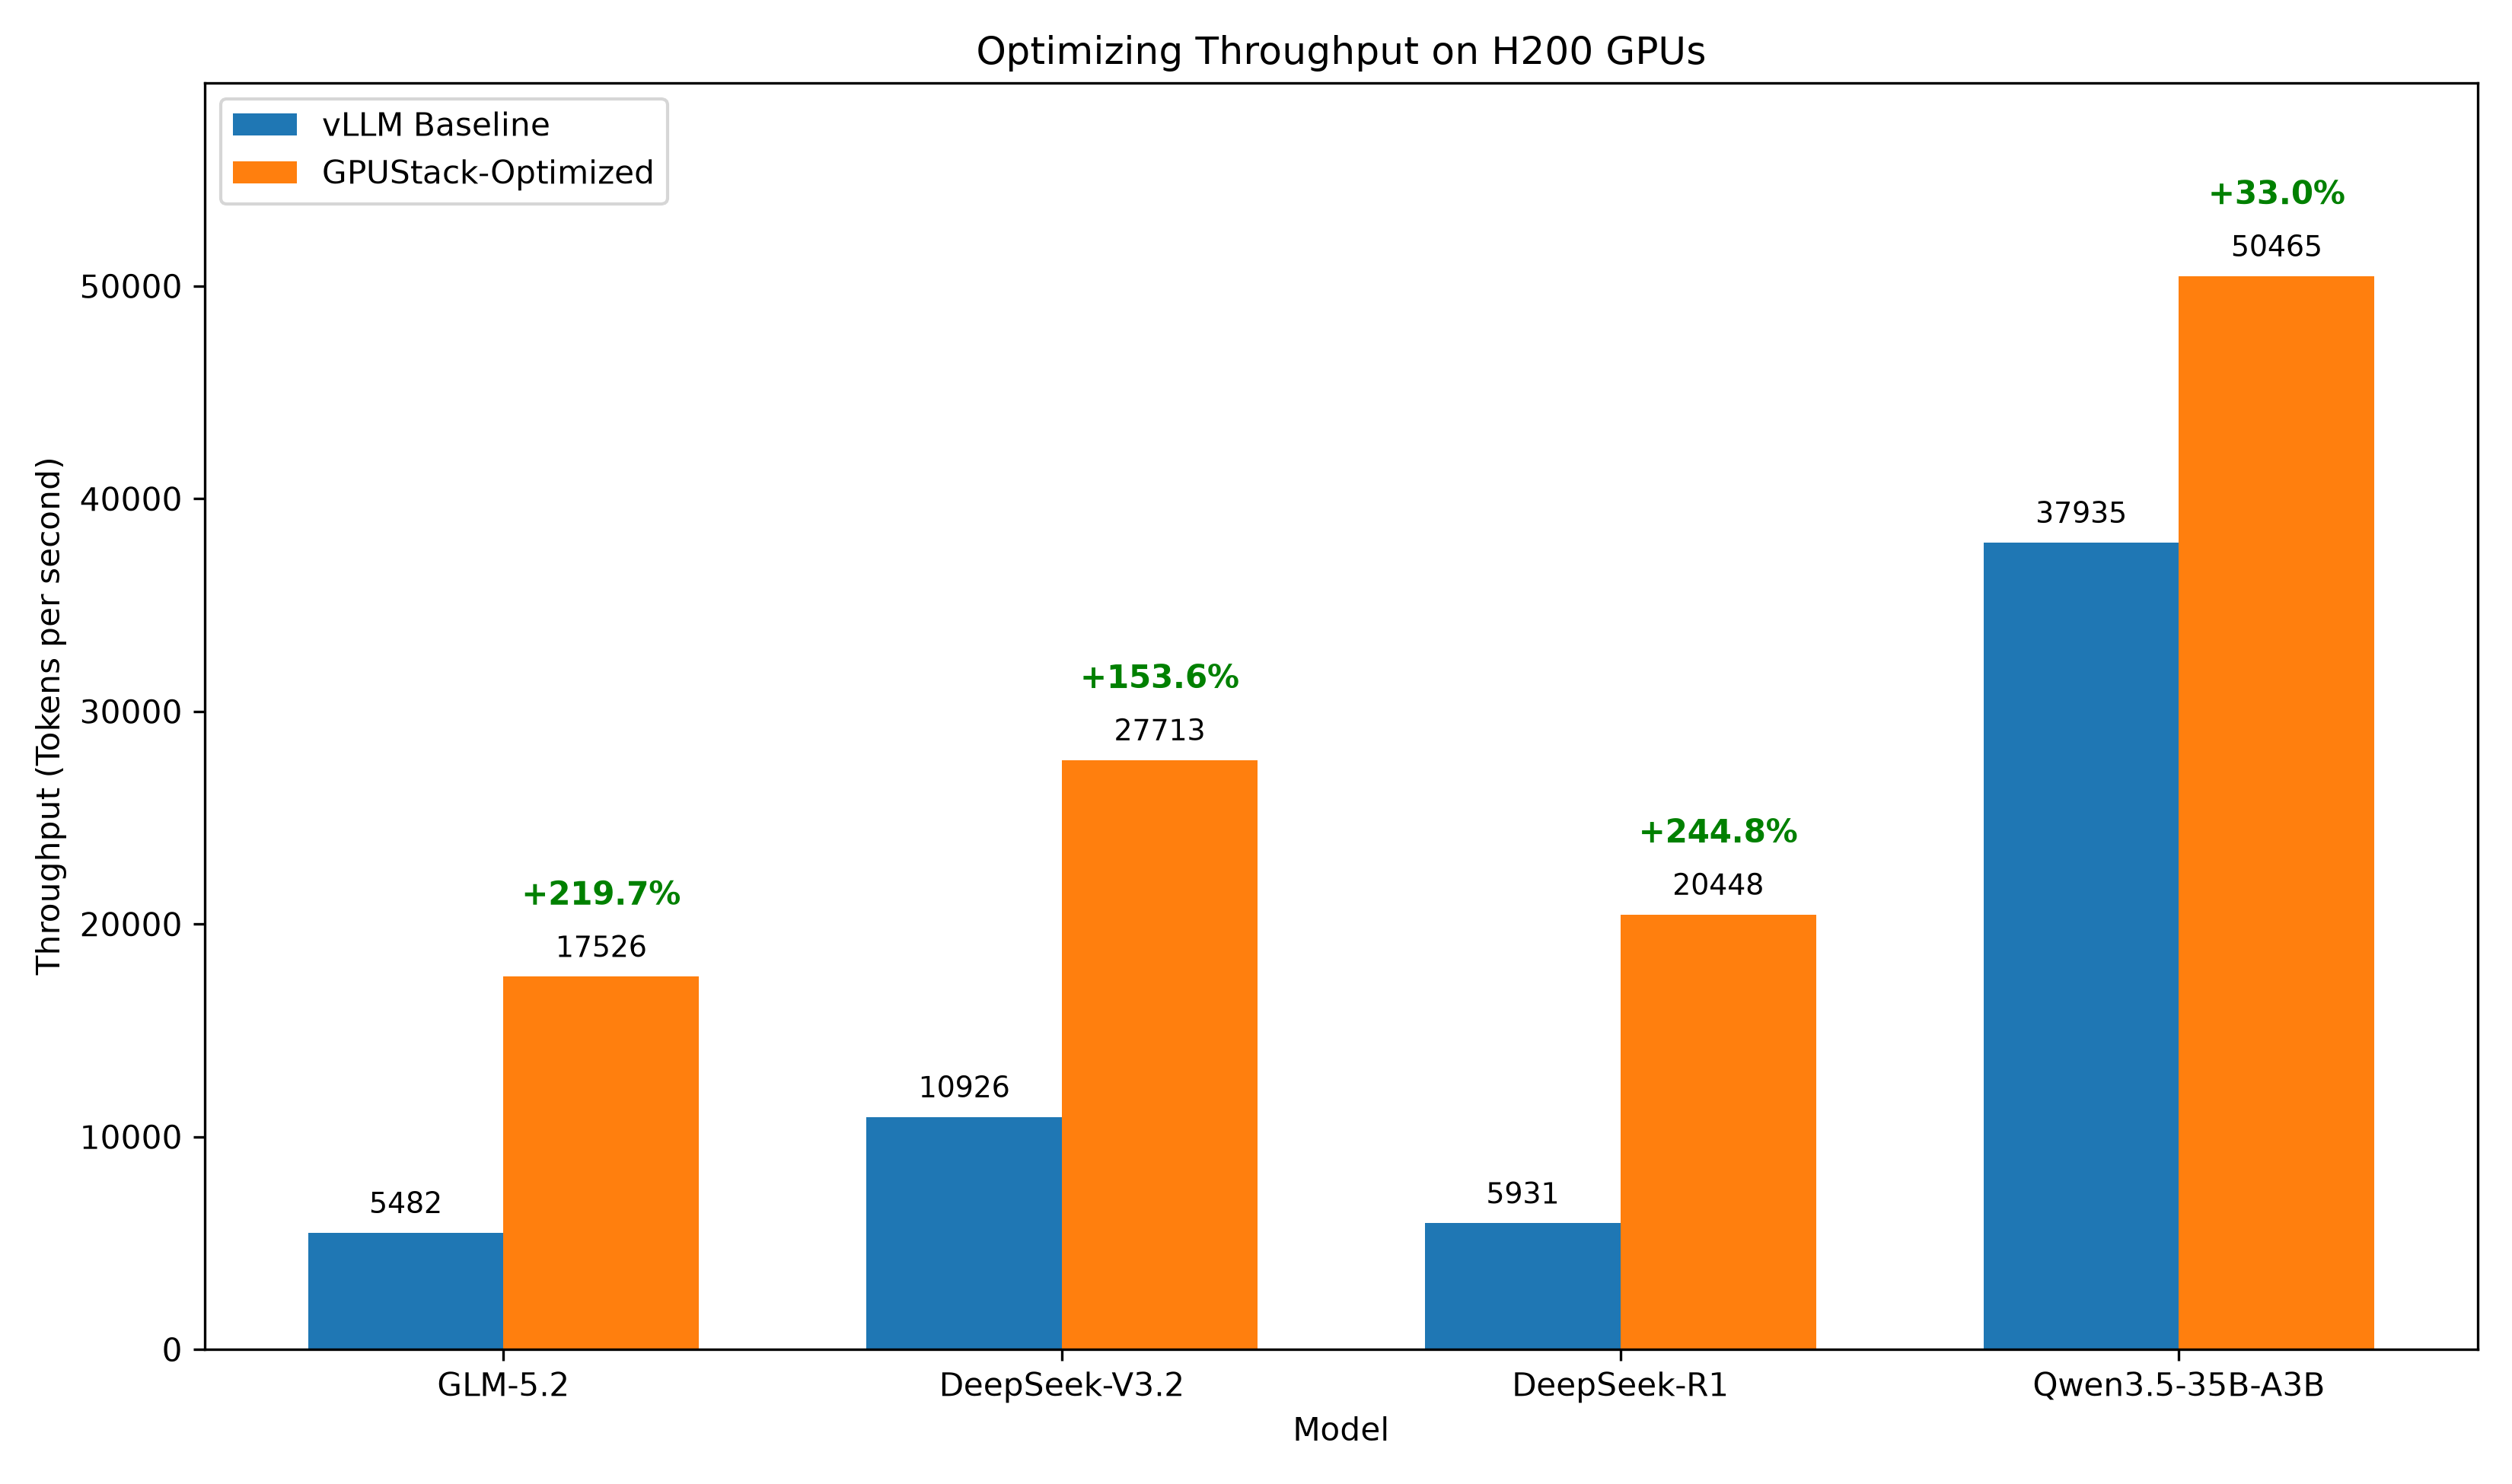
Ayrıntılı kıyaslama yöntemleri ve sonuçları için Çıkarım Performans Laboratuvarımızı ziyaret edin.
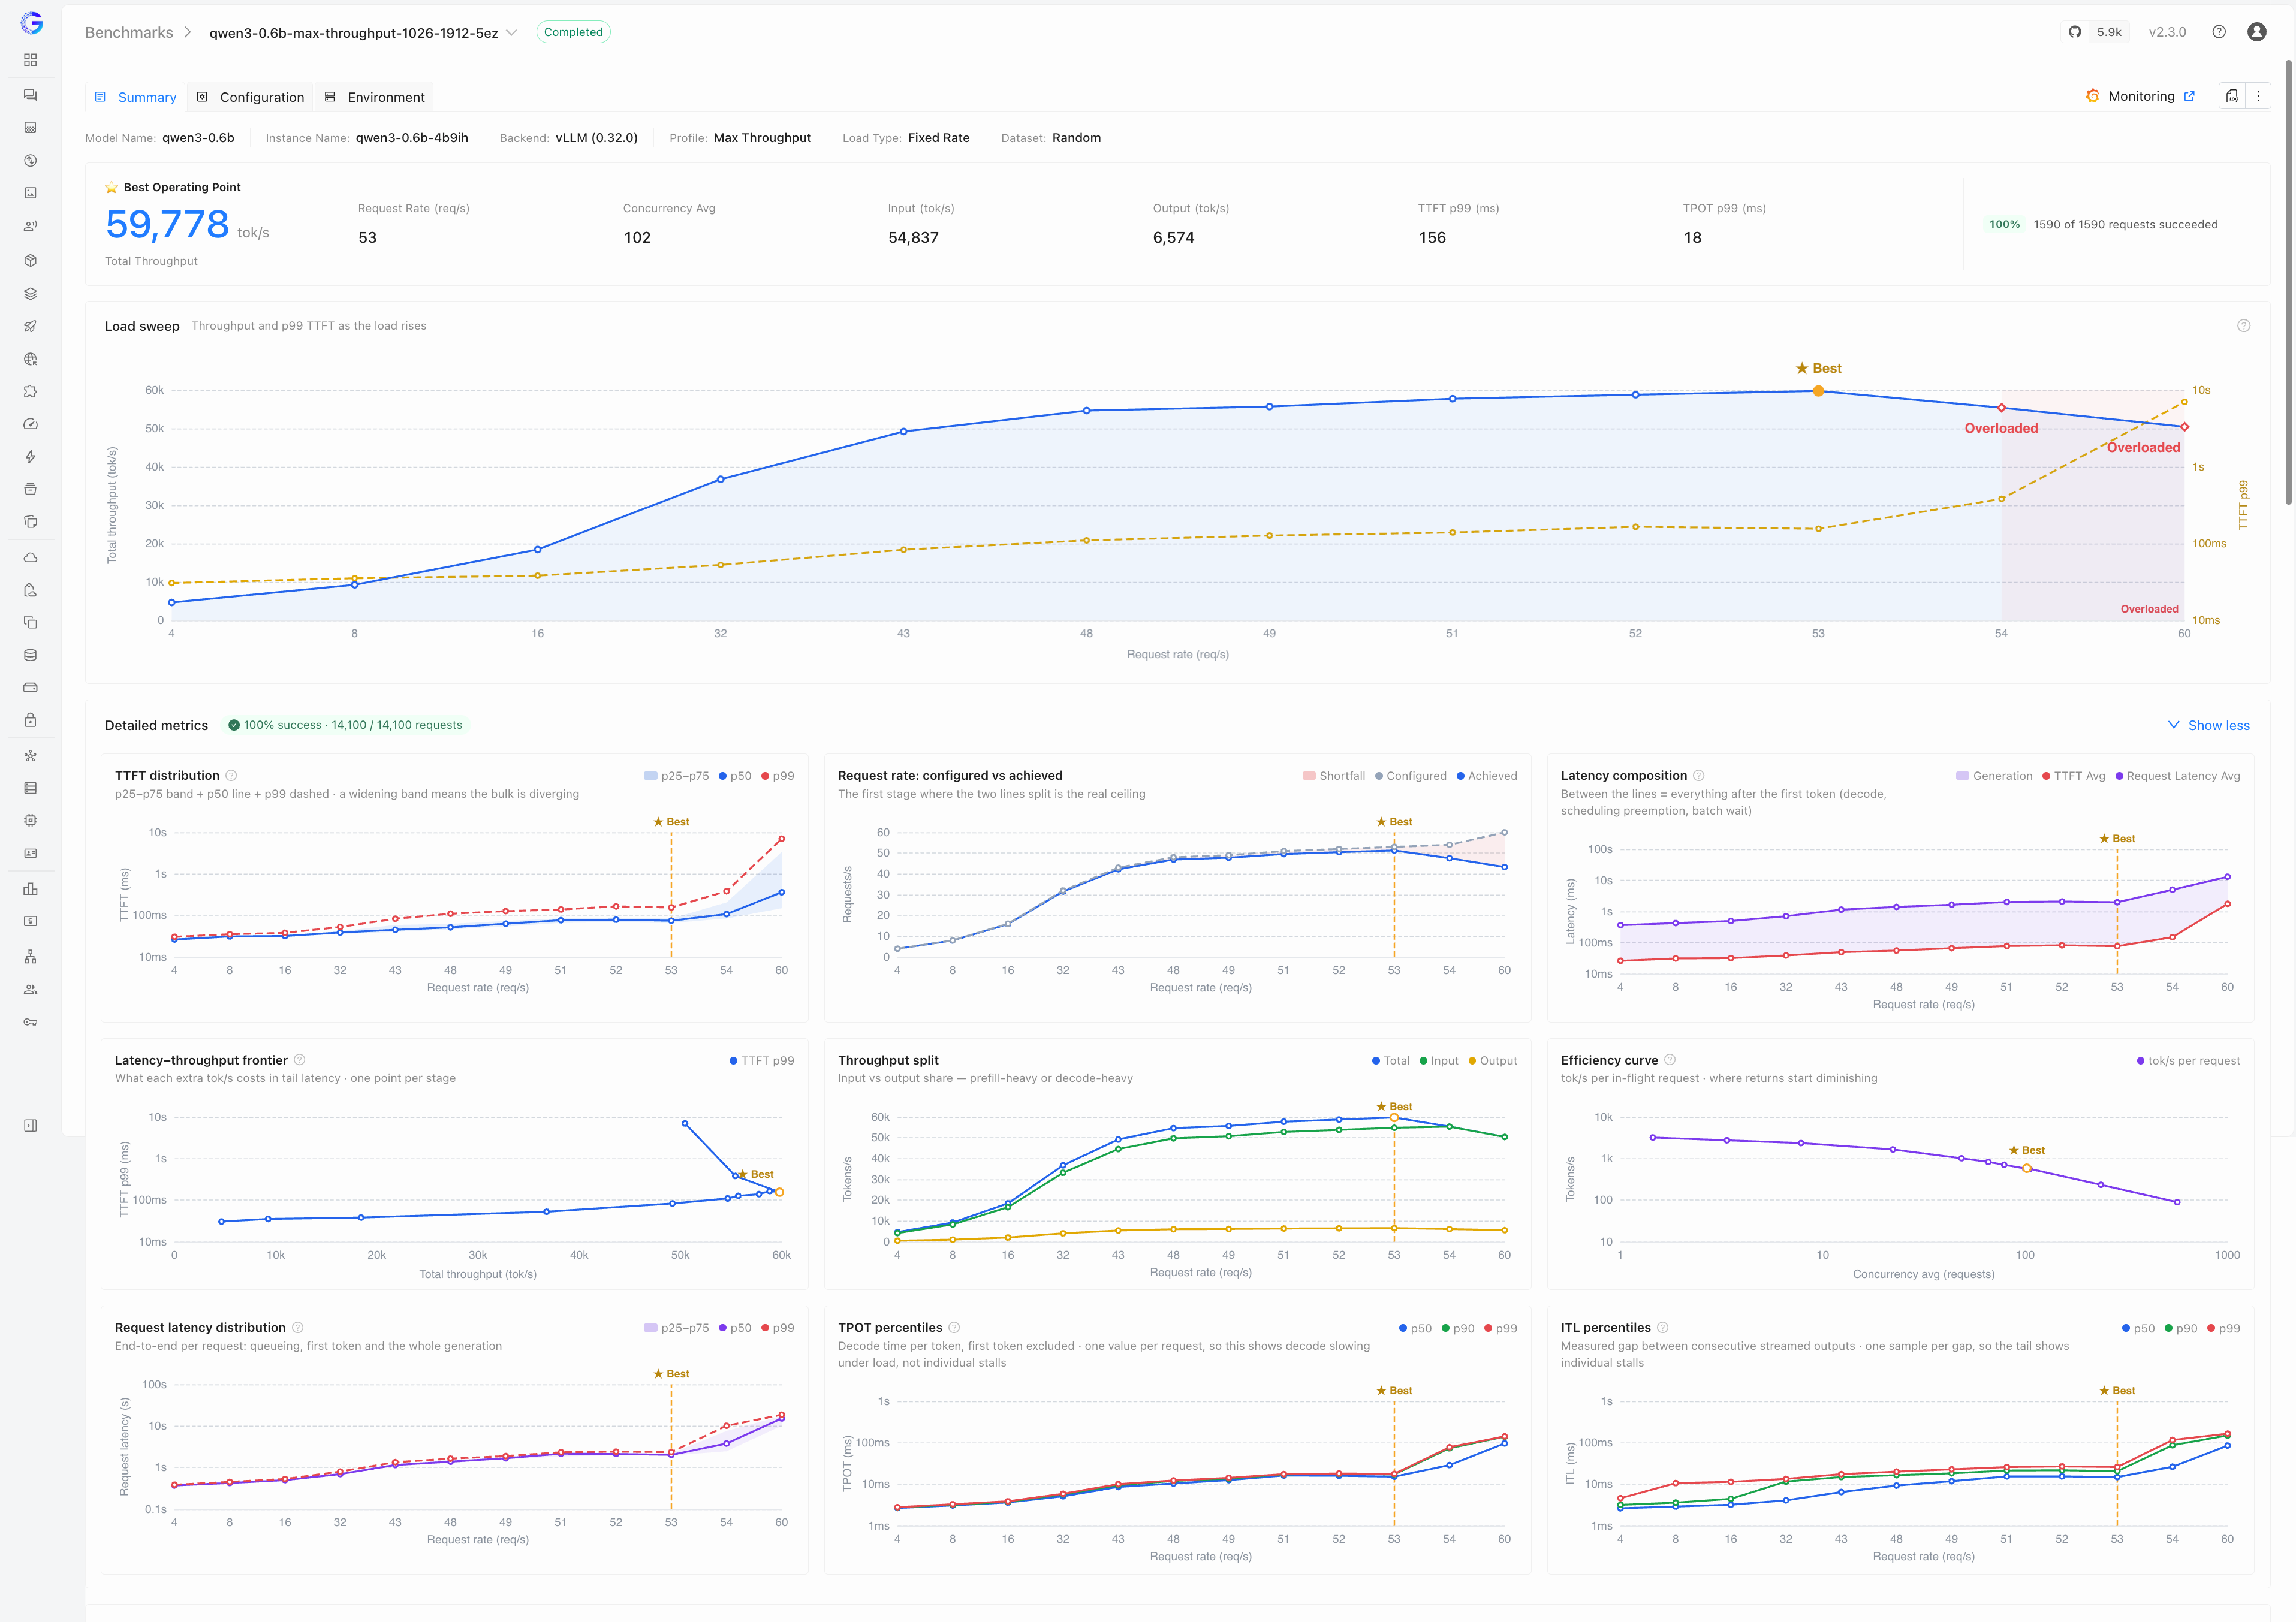
GPUStack'in yerleşik performans testleriyle dağıtımınızın ne kadar yük kaldırabileceğini keşfedin. Auto Tune, yükü uyarlanabilir biçimde ayarlayarak en yüksek verimi veya hizmet düzeyi hedeflerinizi (SLO) karşılayan en yüksek eşzamanlılık düzeyini otomatik olarak bulur. Ayrıntılı verim ve gecikme grafikleri kapasite planlamasına yol gösterir.
Desteklenen Hızlandırıcılar
GPUStack, yapay zeka çıkarımı için çok çeşitli hızlandırıcıları destekler:
Ayrıntılı gereksinimler ve kurulum talimatları için Yükleme Gereksinimleri belgelerine bakın.