Использование больших языковых моделей
Большие языковые модели (LLM) — это мощные модели ИИ, способные понимать и генерировать текст, похожий на написанный человеком. Они применяются в чат-ботах, генерации контента, дополнении кода и других задачах.
В этом руководстве вы узнаете, как развертывать LLM в GPUStack и взаимодействовать с ними.
Предварительные условия
Прежде чем начать, убедитесь, что у вас есть следующее:
- Компьютер Linux с одним или несколькими графическими процессорами и общим объемом видеопамяти не менее 30 ГБ. Мы будем использовать серверную часть vLLM, которая поддерживает только Linux.
- Доступ к Hugging Face или ModelScope для загрузки файлов модели.
- GPUStack установлен и работает. Если нет, обратитесь к Краткому руководству.
Шаг 1. Развертывание больших языковых моделей
Развертывание из каталога
Большие языковые модели в каталоге отмечены категорией LLM. Когда вы выбираете большую языковую модель из каталога, конфигурации по умолчанию должны работать, если у вас достаточно ресурсов графического процессора, а серверная часть совместима с вашей настройкой (например, для серверной части vLLM требуется рабочий процесс Linux amd64).
Здесь в качестве примера мы возьмем размещение Qwen3 0.6B.
Выполните следующие шаги, чтобы развернуть модель из каталога:
- Перейдите на страницу
Catalogв пользовательском интерфейсе GPUStack. - На странице списка моделей используйте раскрывающийся список для фильтрации с помощью
LLM. - Просмотрите описание модели, максимальную длину контекста и поддерживаемые размеры.
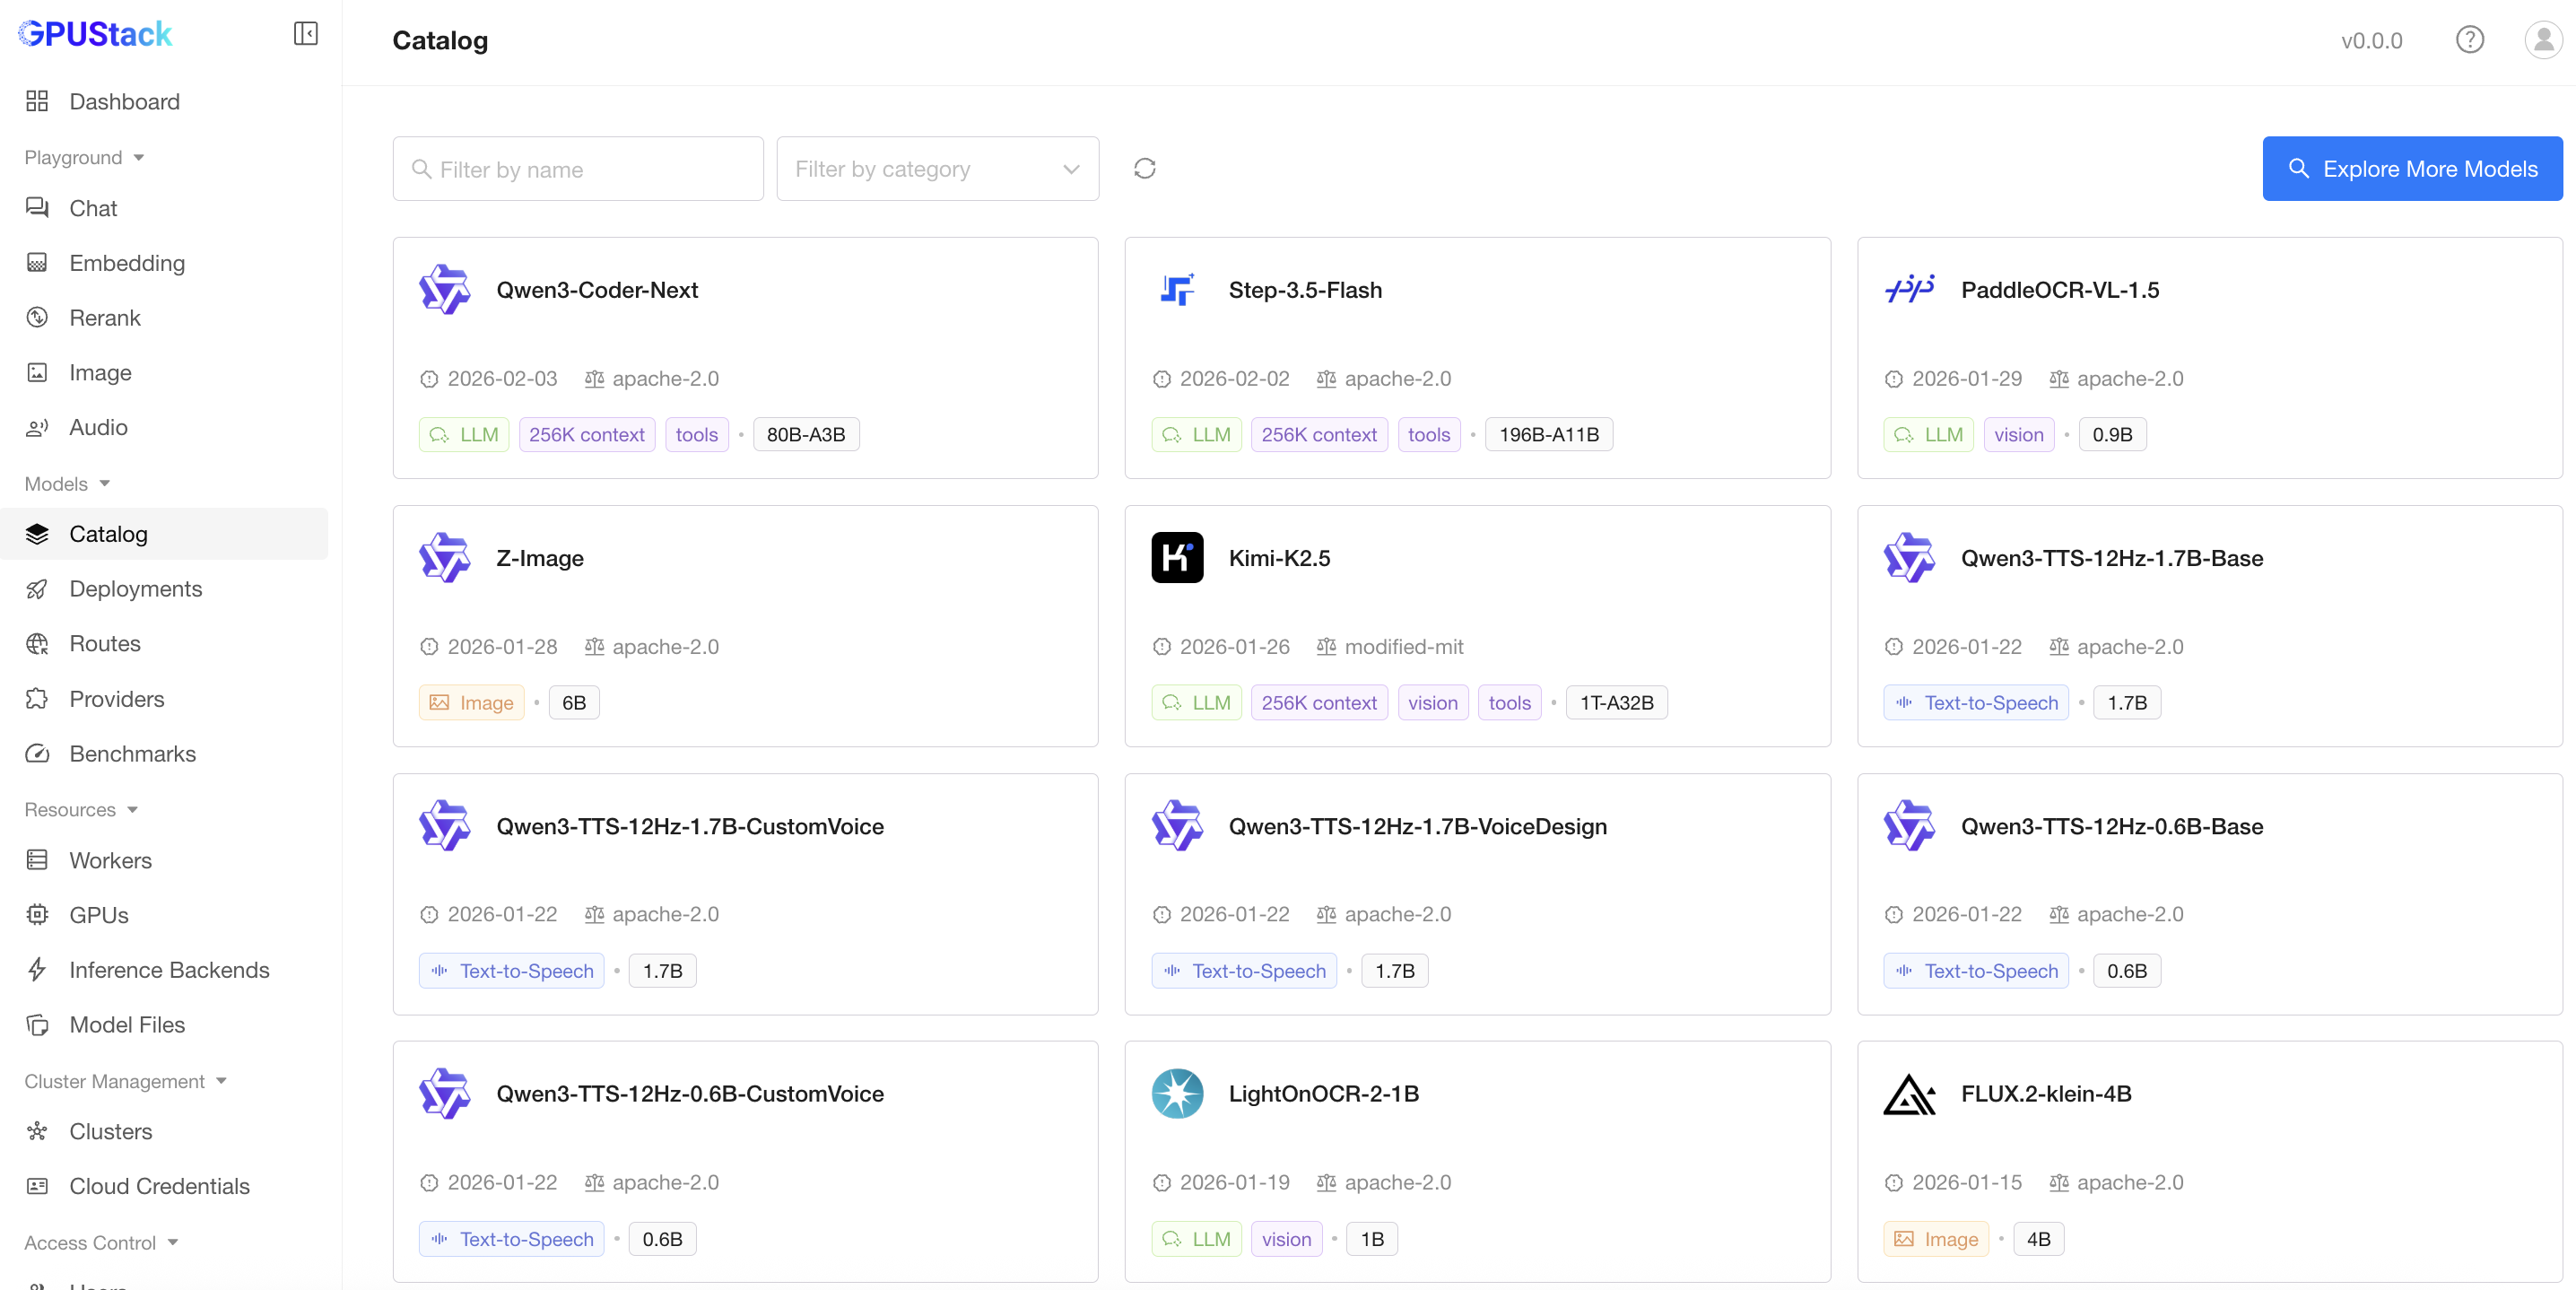
Развертывание с использованием vLLM
- Выберите
Qwen3 0.6Bиз каталога. - При необходимости измените название модели и конфигурацию.
- Нажмите кнопку
Save, чтобы развернуть модель.
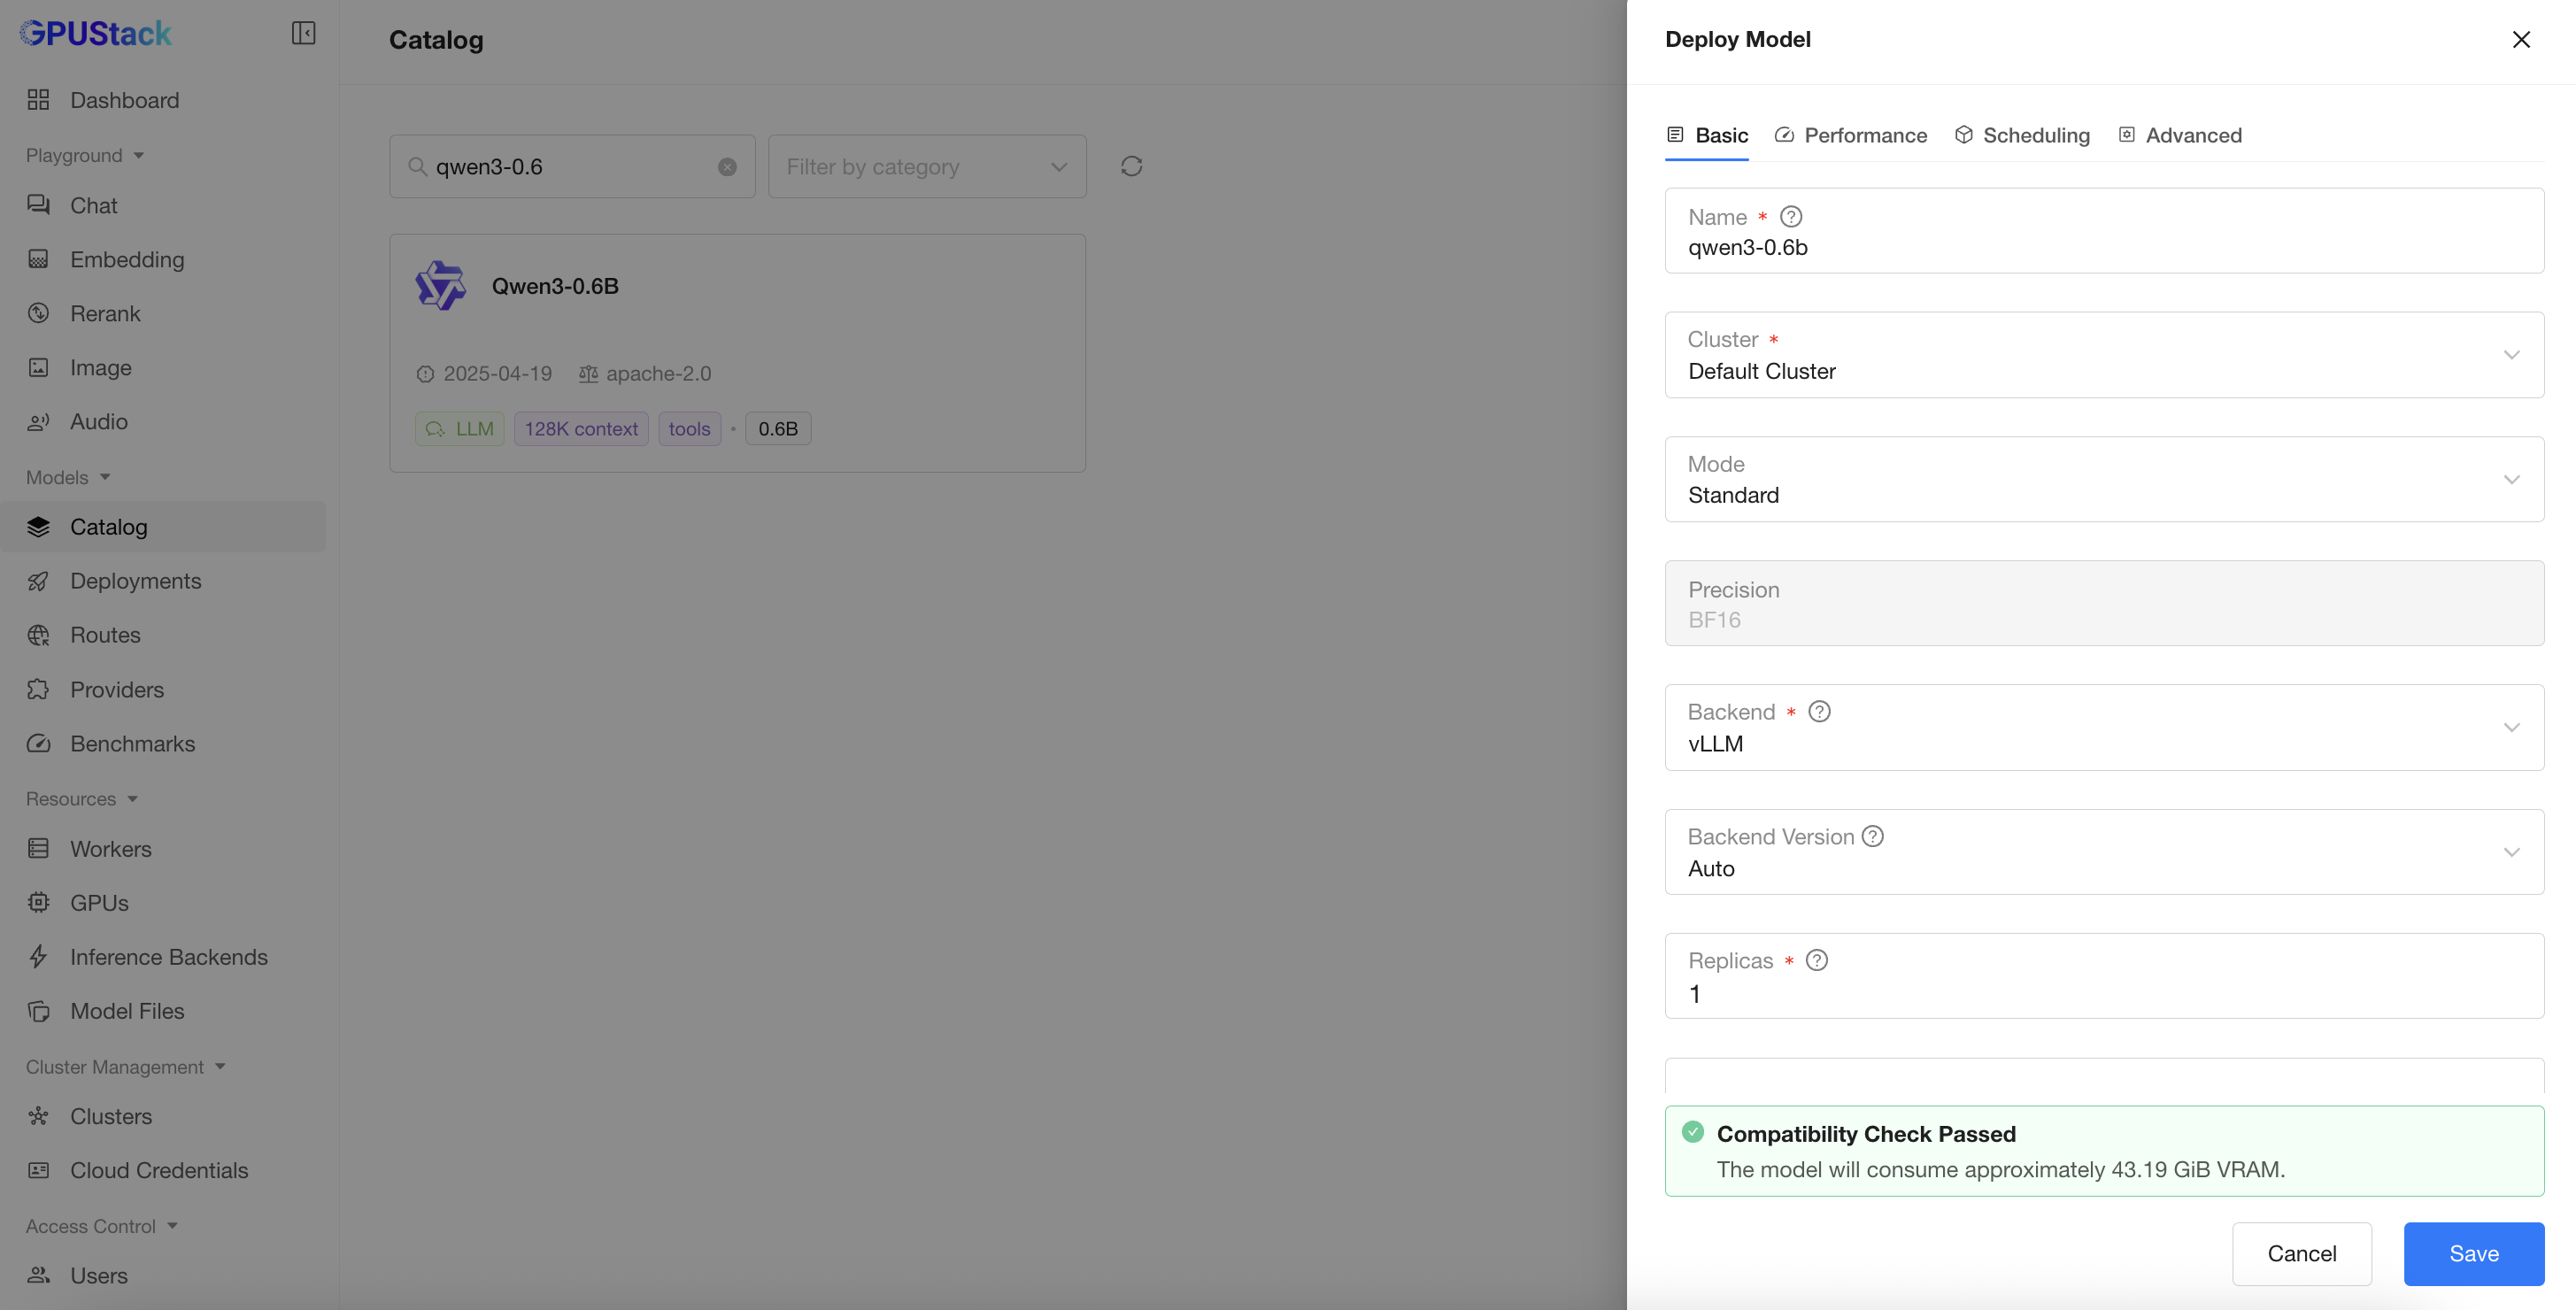
После развертывания вы можете отслеживать состояние развертывания модели на странице Deployments и ждать ее запуска.
Шаг 2. Используйте LLM для генерации текста.
- Перейдите на страницу
Playground>Chatв пользовательском интерфейсе GPUStack. - Убедитесь, что развернутая модель выбрана в раскрывающемся списке
Modelв правом верхнем углу. - Предоставьте подсказку для создания текста.
- Отрегулируйте
Parametersсправа в соответствии с вашими потребностями. - Нажмите кнопку
Submit, чтобы сгенерировать текст.
Сгенерированная цепочка мыслей и результат будут отображаться в пользовательском интерфейсе.
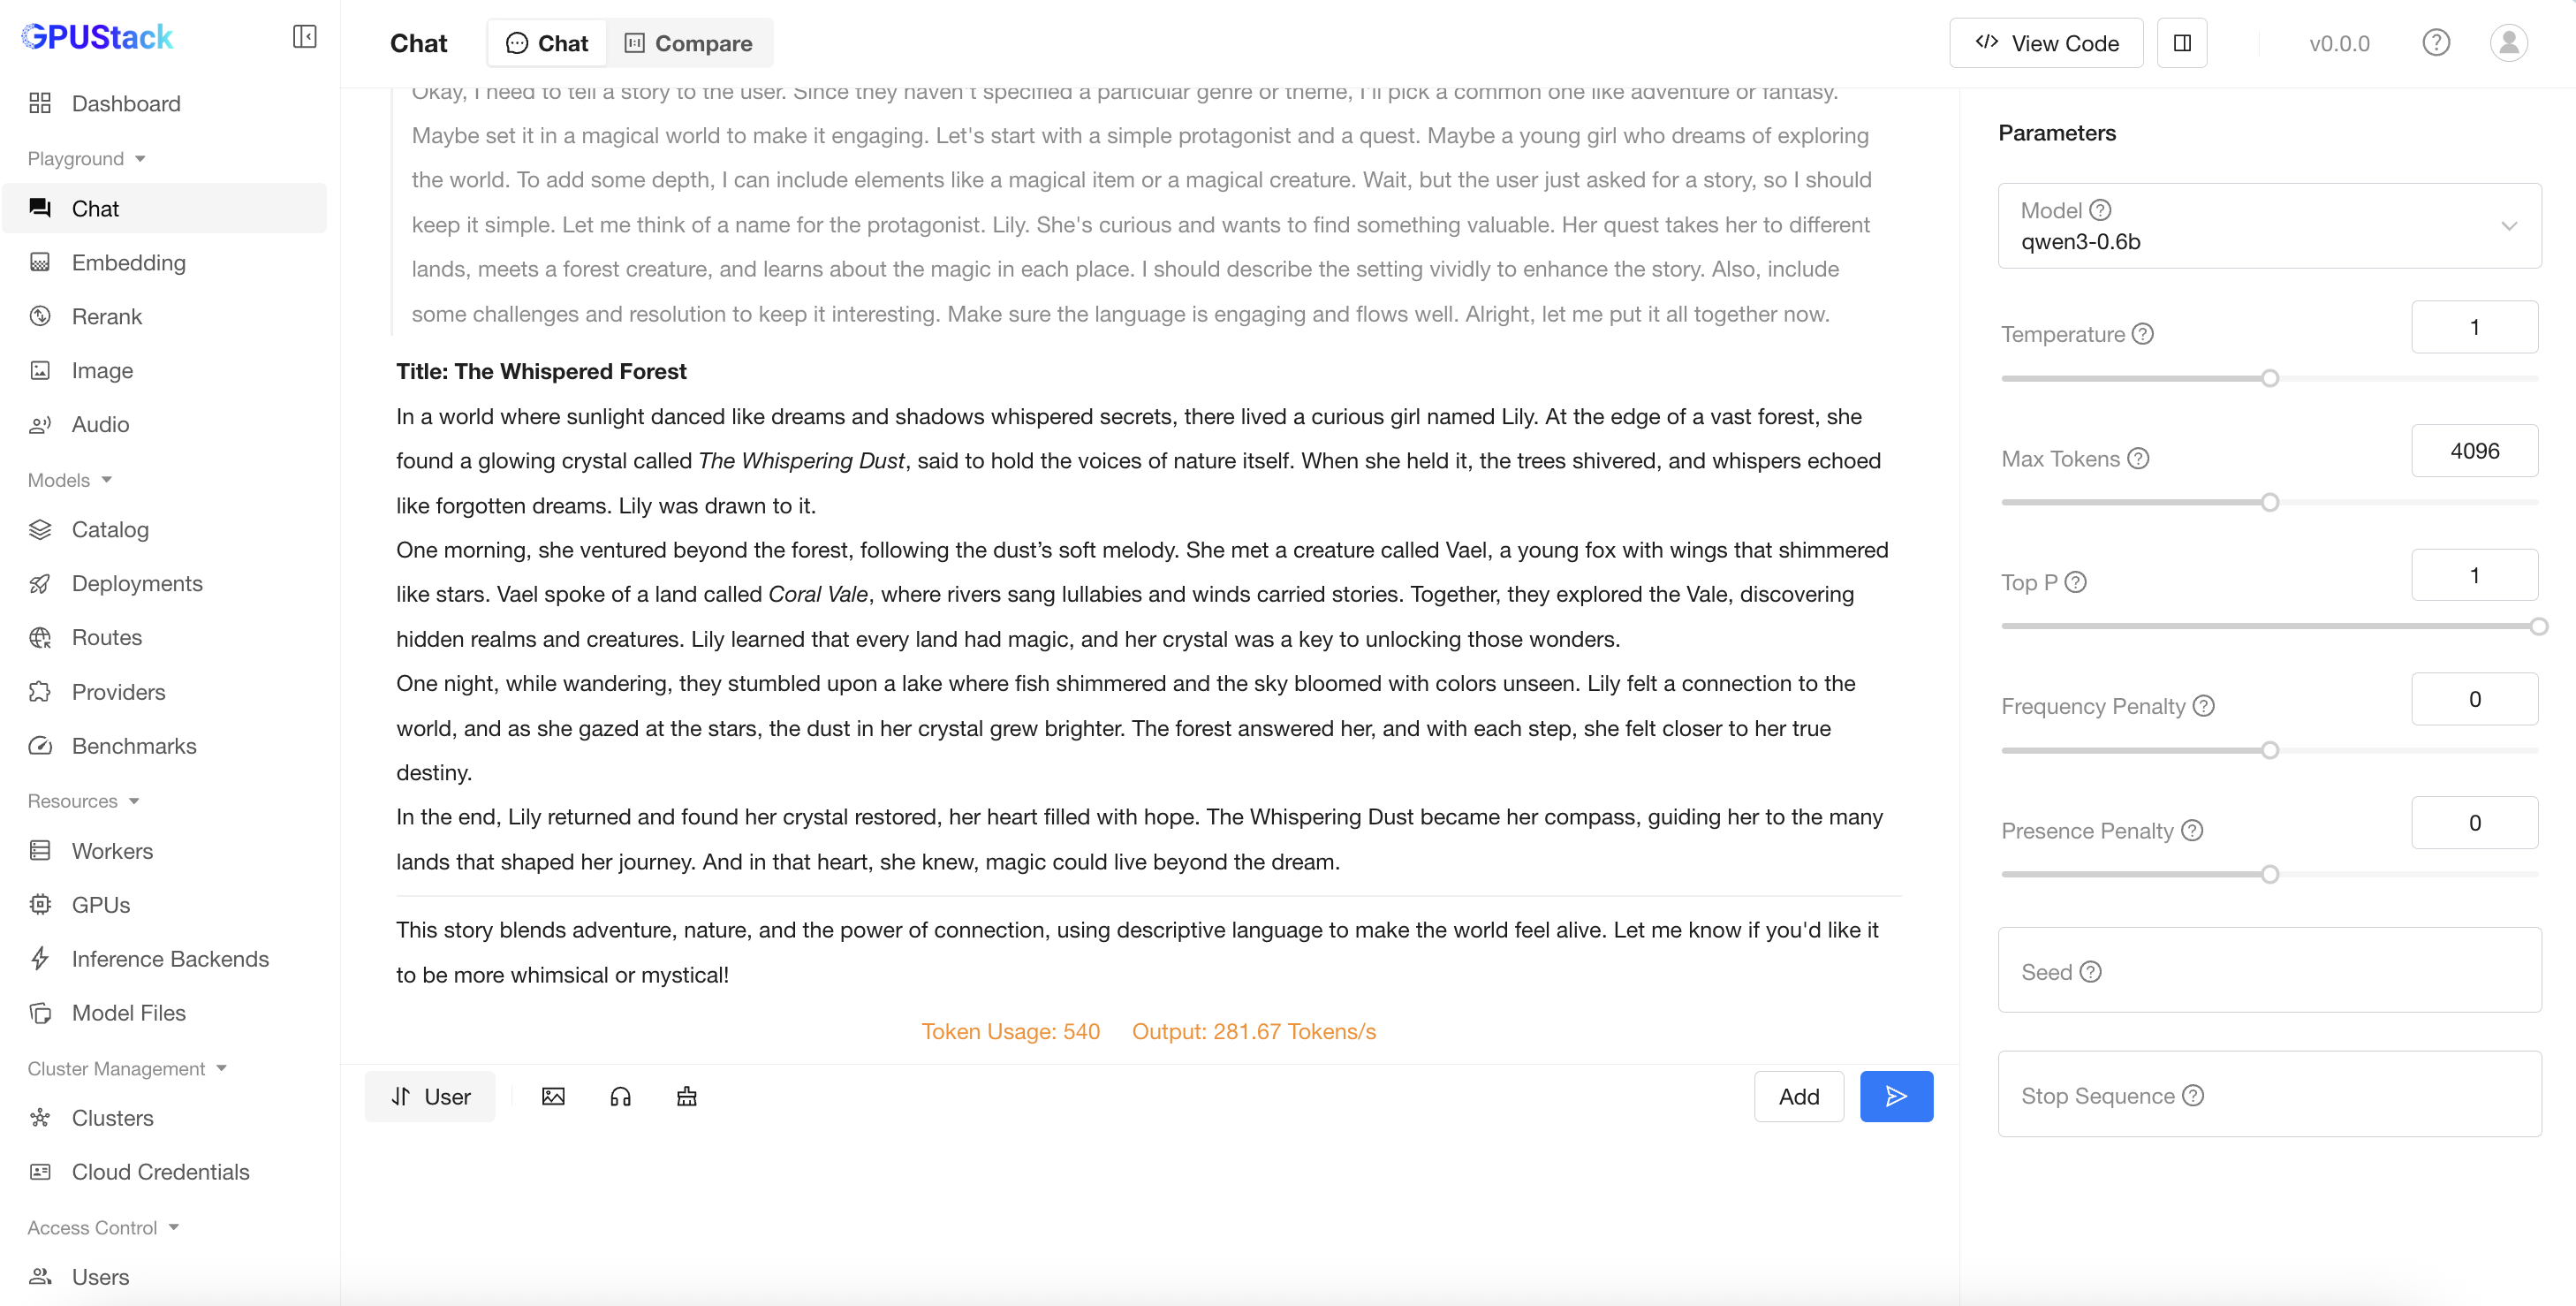
Выполнив эти шаги, вы сможете использовать LLM для генерации текста с помощью искусственного интеллекта и задач на естественном языке в GPUStack. Поэкспериментируйте с различными подсказками и настройками, чтобы изучить все возможности LLM!