Обслуживание моделей с адаптерами LoRA
LoRA (адаптация низкого ранга) — это эффективный по параметрам метод точной настройки, который адаптирует базовую модель к конкретной области путем загрузки небольших файлов адаптеров вместо повторного обучения полных весов.
GPUStack позволяет монтировать несколько адаптеров LoRA на развернутый базовый LLM и автоматически создает один модельный маршрут для каждого адаптера; вызывающие абоненты переключают адаптеры по запросу, устанавливая в поле model, совместимом с OpenAI, соответствующее имя маршрута, не выделяя отдельный графический процессор для каждой тонкой настройки.
В этом руководстве показано, как подключить несколько адаптеров LoRA к одной базовой модели на серверной части vLLM, SGLang или Ascend MindIE, а также как вызвать определенный адаптер через OpenAI-совместимый API.
Примечание
LoRA в настоящее время поддерживается только на бэкэндах vLLM, SGLang и Ascend MindIE. Конфигурация lora_list игнорируется на других серверах.
Предварительные условия
Прежде чем продолжить, убедитесь в следующем:
- GPUStack установлен и работает.
- Доступен рабочий узел Linux с графическим процессором. Используемая здесь базовая модель —
Qwen3-8B, поэтому графическому процессору требуется достаточно памяти для обслуживания модели 8B (например, 24 ГБ или более). Два адаптера используют один и тот же экземпляр и добавляют лишь небольшой объем дополнительной памяти. - Доступ к Hugging Face для загрузки файлов модели и адаптера.
В этом руководстве монтируются два адаптера LoRA на одной базовой модели, чтобы вы могли видеть, как вызывающие абоненты переключаются между тонкими настройками по запросу. Он использует следующую конфигурацию:
| Предмет | Значение, используемое в этом уроке. |
|---|---|
| Источник модели | Hugging Face |
| Бэкэнд | vLLM |
| Базовая модель | Qwen/Qwen3-8B |
| Адаптер LoRA 1 | AMaslovskyi/qwen-devops-foundation-lora (название devops) |
| Адаптер LoRA 2 | XinyuanWang/qwen3-8b-medical-lora (название medical) |
Оба адаптера указывают Qwen/Qwen3-8B как свою базовую модель. Это жесткое требование: каждый адаптер, установленный в одном развертывании, должен иметь одну и ту же базовую модель.
Совет
После завершения руководства с этими значениями вы можете поменять местами ModelScope или Local Path в качестве источника, SGLang или Ascend MindIE в качестве серверной части, а также свою собственную базовую модель и адаптеры. См. раздел Совместимость и ограничения серверной части, чтобы узнать о различиях в зависимости от серверной части.
Шаг 1. Развертывание базовой модели с помощью адаптеров LoRA.
- Перейдите на страницу
Deploymentsи нажмитеDeploy Model, затем выберитеHugging Faceв качестве источника. - В поле поиска введите
Qwen/Qwen3-8Bи выберите его из результатов. - Установите для серверной части значение
vLLM. -
Разверните раздел
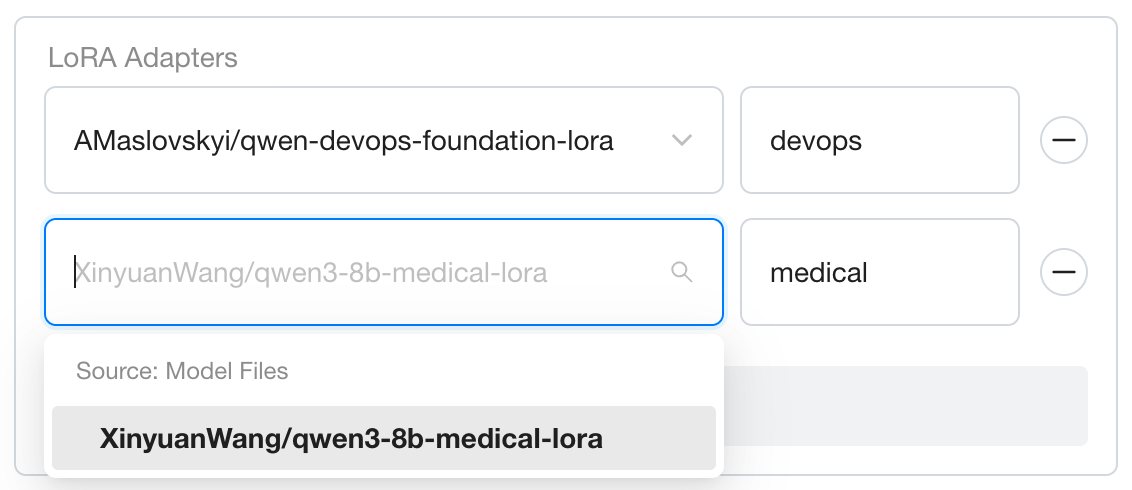
Advancedи найдитеLoRA Adapters. Добавьте адаптер первый:- В раскрывающемся списке адаптера введите
AMaslovskyi/qwen-devops-foundation-loraи выберите его. - В поле
LoRA nameвведитеdevops.
- В раскрывающемся списке адаптера введите
-
Нажмите, чтобы добавить адаптер второй:
- В раскрывающемся списке адаптера введите
XinyuanWang/qwen3-8b-medical-loraи выберите его. - В поле
LoRA nameвведитеmedical.
- В раскрывающемся списке адаптера введите
-
Нажмите
Save, чтобы завершить развертывание.
Примечание
Введите только имя адаптера (devops, medical) без префикса базовой модели. GPUStack автоматически получает полный идентификатор (qwen3-8b:devops, qwen3-8b:medical), который также является именем маршрута модели, которое вы используете для вызова каждого адаптера (см. Шаг 2).
Совет
Каждому адаптеру нужен отдельный LoRA name — чтобы установить больше, просто повторите шаг добавления. Если нужный вам адаптер не отображается в раскрывающемся списке, сначала подтвердите на Hugging Face или ModelScope, что модель действительно поставляется с адаптером LoRA, а затем вставьте полный идентификатор репозитория в поле поиска, чтобы выбрать его.
Шаг 2. Вызов адаптера LoRA
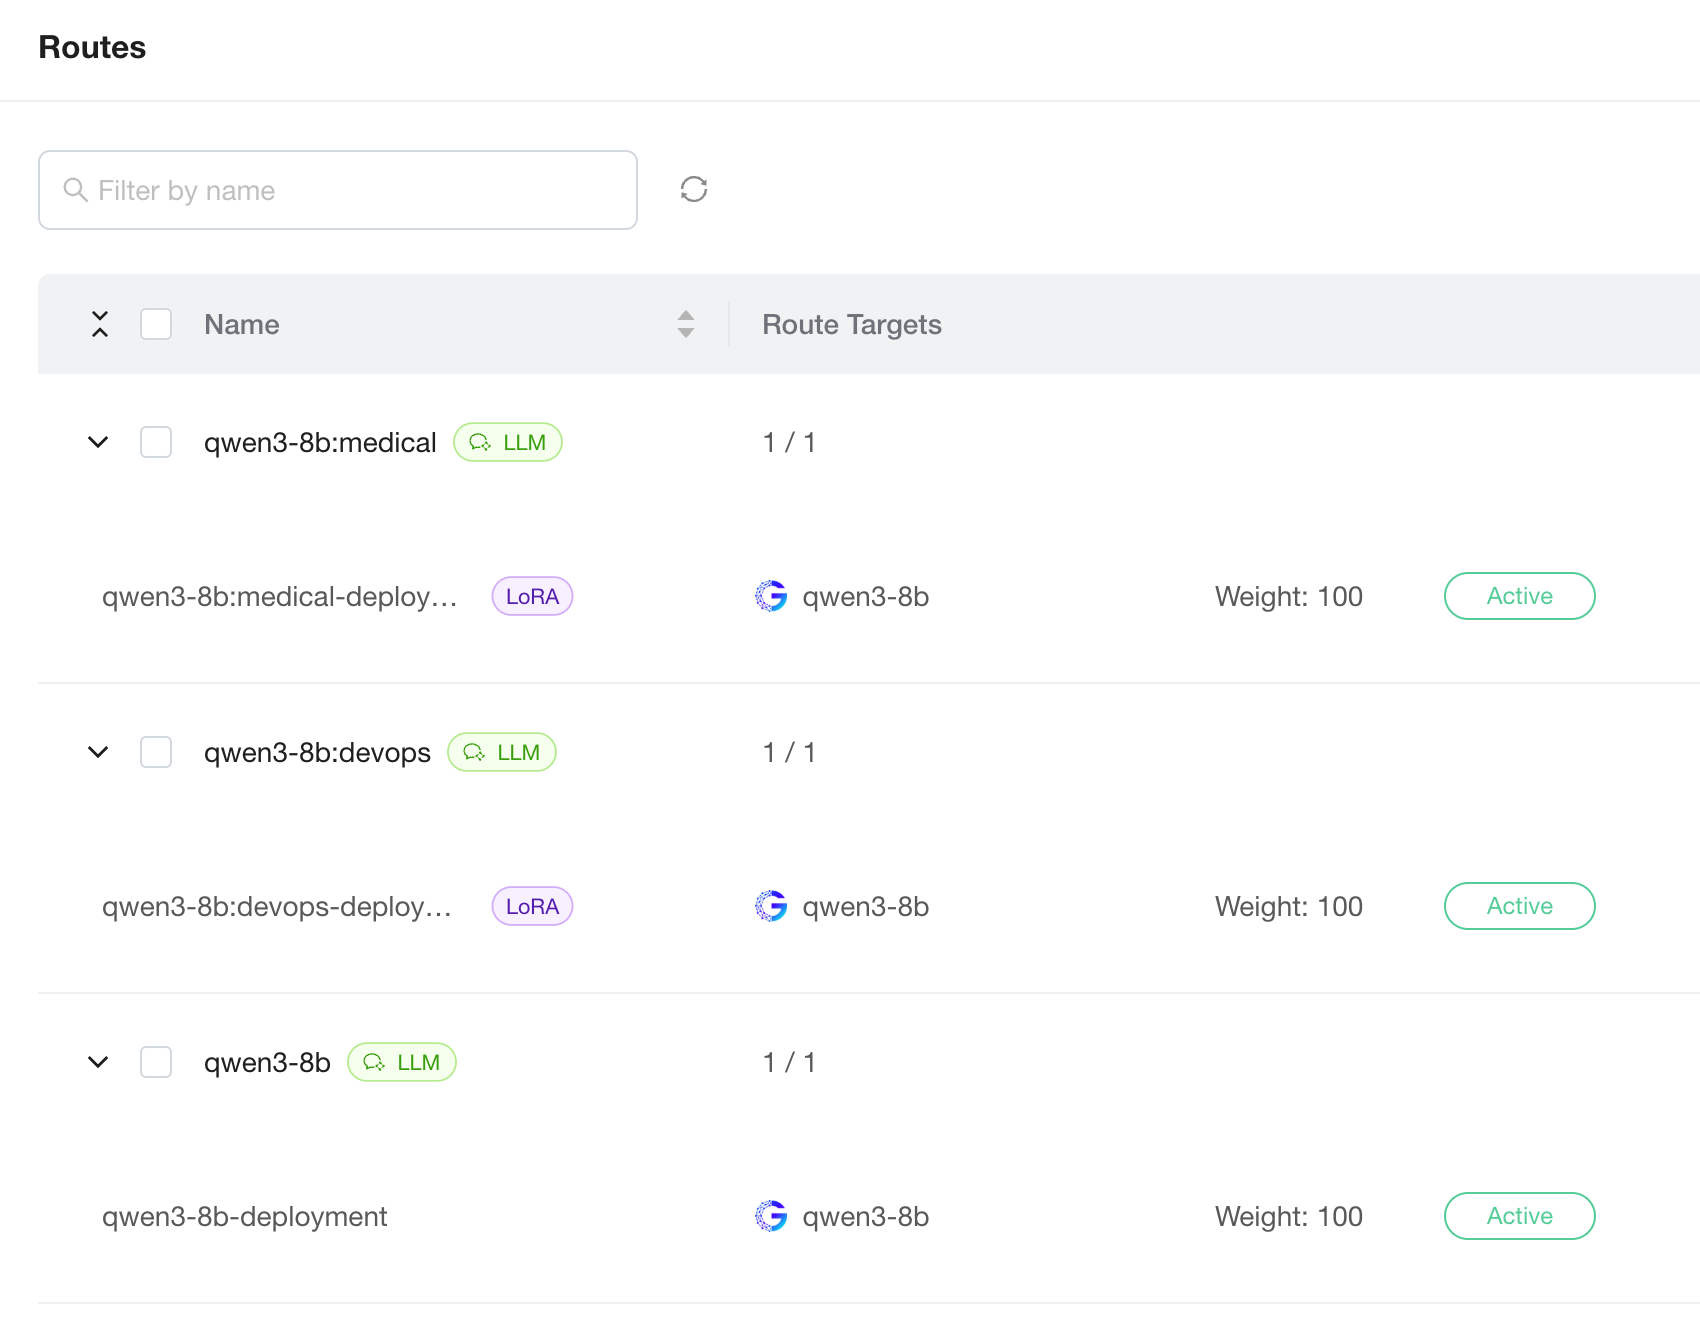
После развертывания GPUStack автоматически создает модельный маршрут для каждого адаптера LoRA с именем <base-model-name>:<adapter-name>. В этом уроке получается три маршрута — базовый qwen3-8b, плюс qwen3-8b:devops и qwen3-8b:medical. Каждый маршрут LoRA отображается рядом с собственным модельным маршрутом базовой модели на странице Model Routes и помечен значком LoRA для облегчения идентификации.
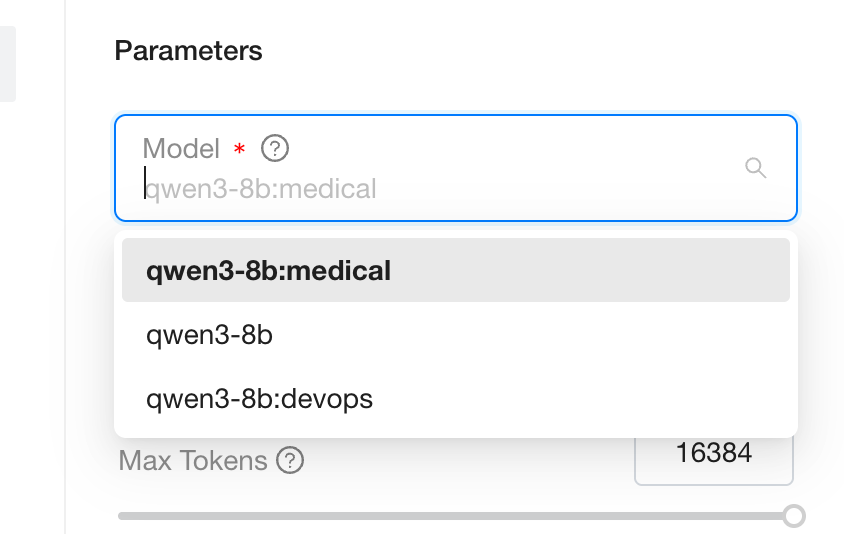
Когда вы выбираете модель в Playground, в раскрывающемся списке отображаются базовая модель и все адаптеры LoRA; переключение этой опции направляет запрос на соответствующий адаптер. То же самое относится и к API-интерфейсу, совместимому с OpenAI: установите в поле model имя базовой модели или имя маршрута любого адаптера. Под капотом все адаптеры используют один и тот же экземпляр графического процессора, поэтому переключение между ними обходится гораздо дешевле, чем замена моделей.
Например, одно и то же приглашение можно перенаправить на любую точную настройку, просто изменив поле model. Отправьте адаптеру DevOps вопрос о Kubernetes:
Затем направьте клинический вопрос на медицинский адаптер, изменив только значение model:
Замените <your-gpustack-server> адресом вашего сервера и <your-api-key> ключом API, созданным на странице API Keys. Вместо этого отправка "model": "qwen3-8b" нацелена на базовую модель без примененного адаптера.
Шаг 3. Управление адаптерами LoRA
Вы можете настроить конфигурацию LoRA после создания развертывания:
- Добавить адаптер: отредактируйте развернутую модель и сохраните ее. Экземпляры, уже находящиеся в состоянии
Running, необходимо перезапустить, прежде чем новый добавленный адаптер будет смонтирован и обслужен. - Удалить адаптер: удалить соответствующую запись из развернутой модели. GPUStack автоматически удаляет соответствующий маршрут модели, если ни один экземпляр
Runningвсе еще не использует адаптер. - Конфликты имен: если в две разные базовые модели добавляются адаптеры, имена которых соответствуют одному и тому же маршруту модели, отправка отклоняется с ошибкой конфликта. Переименуйте один из адаптеров для восстановления.
Серверная совместимость и ограничения
Поддержка LoRA различается в зависимости от серверной части вывода:
| Бэкэнд | Аргументы/конфигурация запуска LoRA | Ключевые ограничения |
|---|---|---|
vLLM | --enable-lora, --max-loras, --lora-modules | --max-loras устанавливается автоматически, начиная с длины lora_list. Количество адаптеров фиксируется после запуска базовой модели; изменения требуют перезапуска экземпляра. |
SGLang | --enable-lora, --lora-paths name=path, --max-loras-per-batch | Количество LoRA, активируемых одновременно в одной партии, ограничено --max-loras-per-batch. |
Ascend MindIE | maxLoras / maxLoraRank / LoraModules в файле конфигурации | maxLoraRank по умолчанию — 64; адаптеры более высокого ранга не запускаются. maxLoras=0 автоматически соответствует количеству установленного адаптера. |
GPUStack автоматически вводит эти параметры; обычно вам не нужно повторять их под Backend Parameters. Отменяйте значения по умолчанию (например, повышение maxLoraRank), добавляя флаг под Advanced → Backend Parameters.
Полную информацию и ограничения см. в официальной документации каждого бэкэнда:
- vLLM: Адаптеры LoRA
- SGLang: Сервировка LoRA
- Ascend MindIE: Multi-LoRA (только на китайском языке)