Запуск DeepSeek R1 671B с распределенной vLLM
В этом руководстве описан процесс настройки и запуска исходной версии DeepSeek R1 671B с использованием Distributed vLLM в кластере GPUStack. Из-за чрезвычайно большого размера модели обычно требуется распределенный вывод по нескольким исполнителям.
GPUStack обеспечивает простую настройку и оркестрацию распределенного вывода с использованием vLLM, что позволяет запускать масштабные модели, такие как DeepSeek R1, с минимальной ручной настройкой.
Предварительные условия
Прежде чем начать, убедитесь, что выполнены следующие требования:
- У вас есть доступ к достаточному количеству узлов Linux, каждый из которых оснащен необходимыми графическими процессорами. Например:
| ГП | Количество узлов |
|---|---|
| H100/H800:8 | 2 |
| A100/A800-80GB:8 | 4 |
| A100/A800:8 | 8 |
- Для оптимальной производительности рекомендуется использовать высокоскоростные соединения, такие как NVLink или InfiniBand.
- Файлы модели следует загружать по одному и тому же пути на каждом узле. Хотя GPUStack поддерживает загрузку модели «на лету», рекомендуется выполнить предварительную загрузку, поскольку это может занять много времени в зависимости от скорости сети.
Примечание
- В этом руководстве мы предполагаем настройку из 4 узлов, каждый из которых оснащен 8 графическими процессорами A800-80GB и подключен к 200G InfiniBand.
- Графические процессоры A100/A800 не поддерживают точность FP8, первоначально используемую DeepSeek R1. Следовательно, мы используем версию BF16 из Unsloth.
Шаг 1. Установите сервер GPUStack.
Согласно Установка, вы можете использовать следующую команду для запуска сервера GPUStack:
Примечание
- Замените
/path/to/your/modelфактическим путем.
После запуска сервера GPUStack выполните следующие команды, чтобы получить первоначальный пароль администратора:
Шаг 2. Доступ к пользовательскому интерфейсу GPUStack.
Войдите в пользовательский интерфейс GPUStack, используя пользователя admin и полученный пароль.
Шаг 3. Установите работники GPUStack.
Перейдите на страницу Workers в пользовательском интерфейсе GPUStack, нажмите кнопку Add Worker, чтобы получить команду для добавления рабочих процессов.
А затем на каждом рабочем узле запустите команду добавления рабочего, чтобы запустить рабочий GPUStack:
Примечание
- Замените соответственно пути-заполнители, IP-адрес/имя хоста и токен кластера.
- Замените
/path/to/your/modelфактическим путем в вашей системе, где хранятся файлы модели DeepSeek R1.
После добавления всех рабочих процессов вернитесь в пользовательский интерфейс GPUStack.
Перейдите на страницу Workers и убедитесь, что все рабочие процессы находятся в состоянии готовности и их графические процессоры указаны в списке.
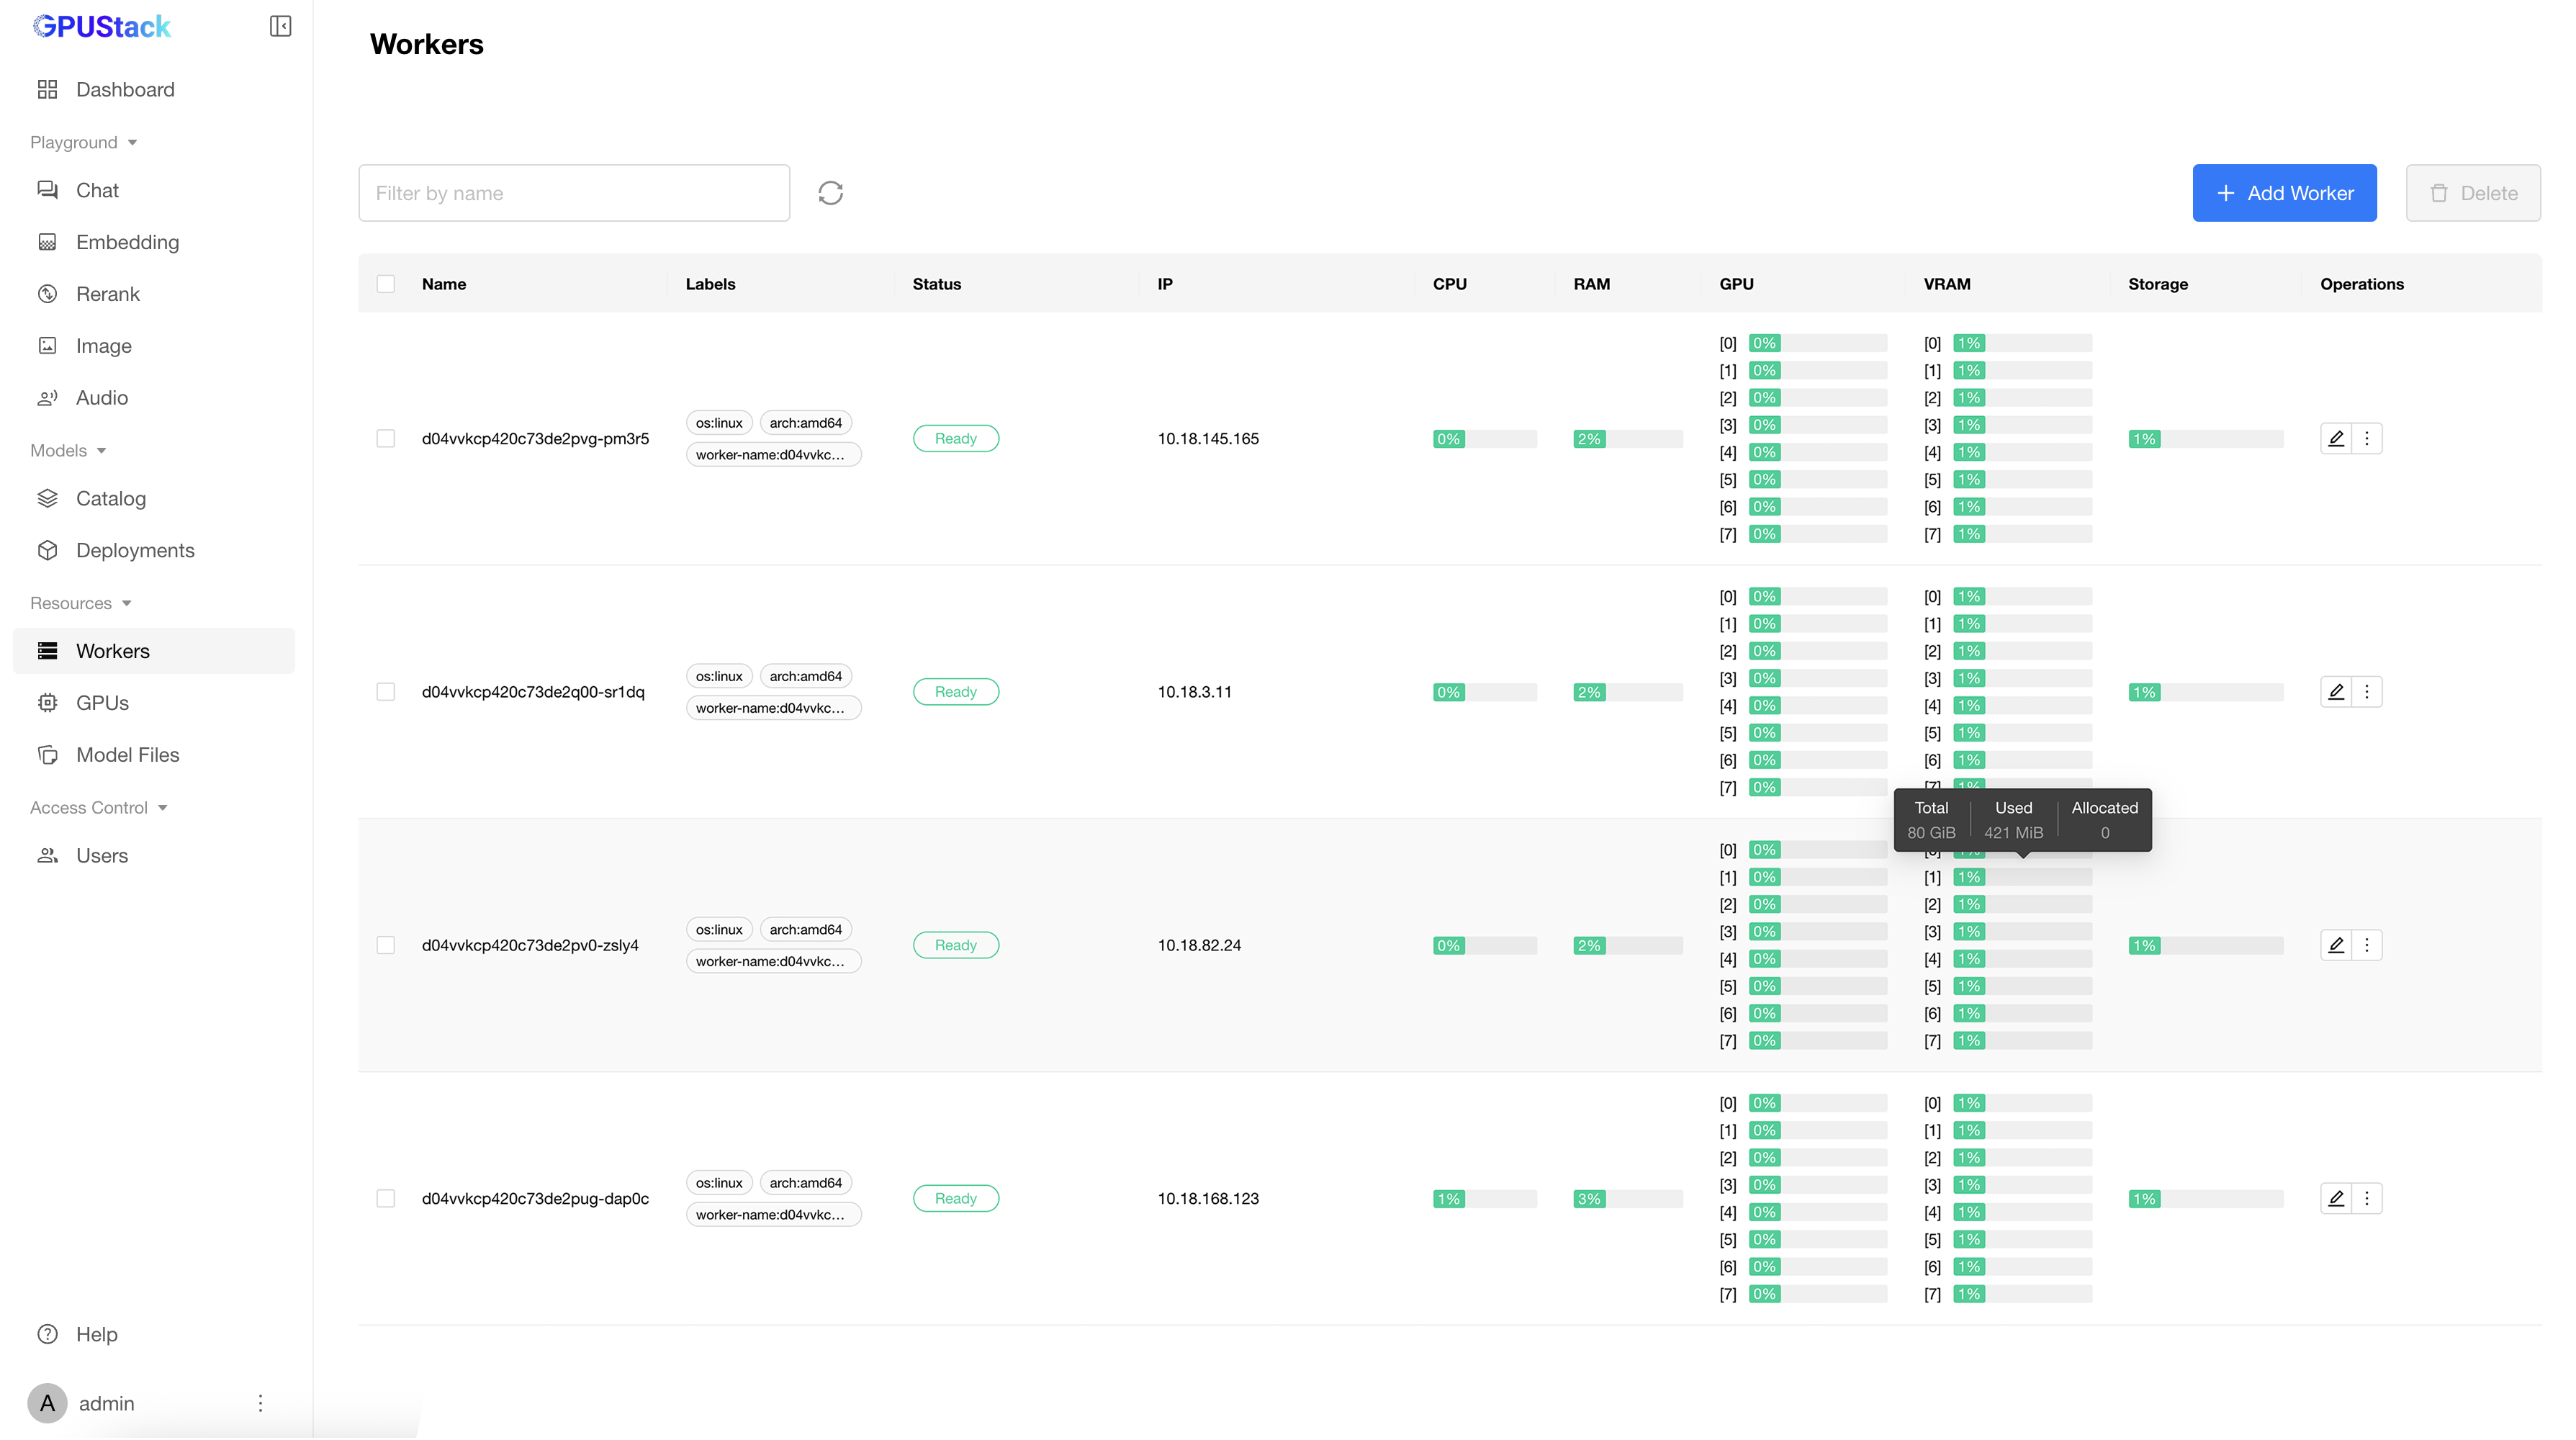
Шаг 4. Развертывание модели DeepSeek R1.
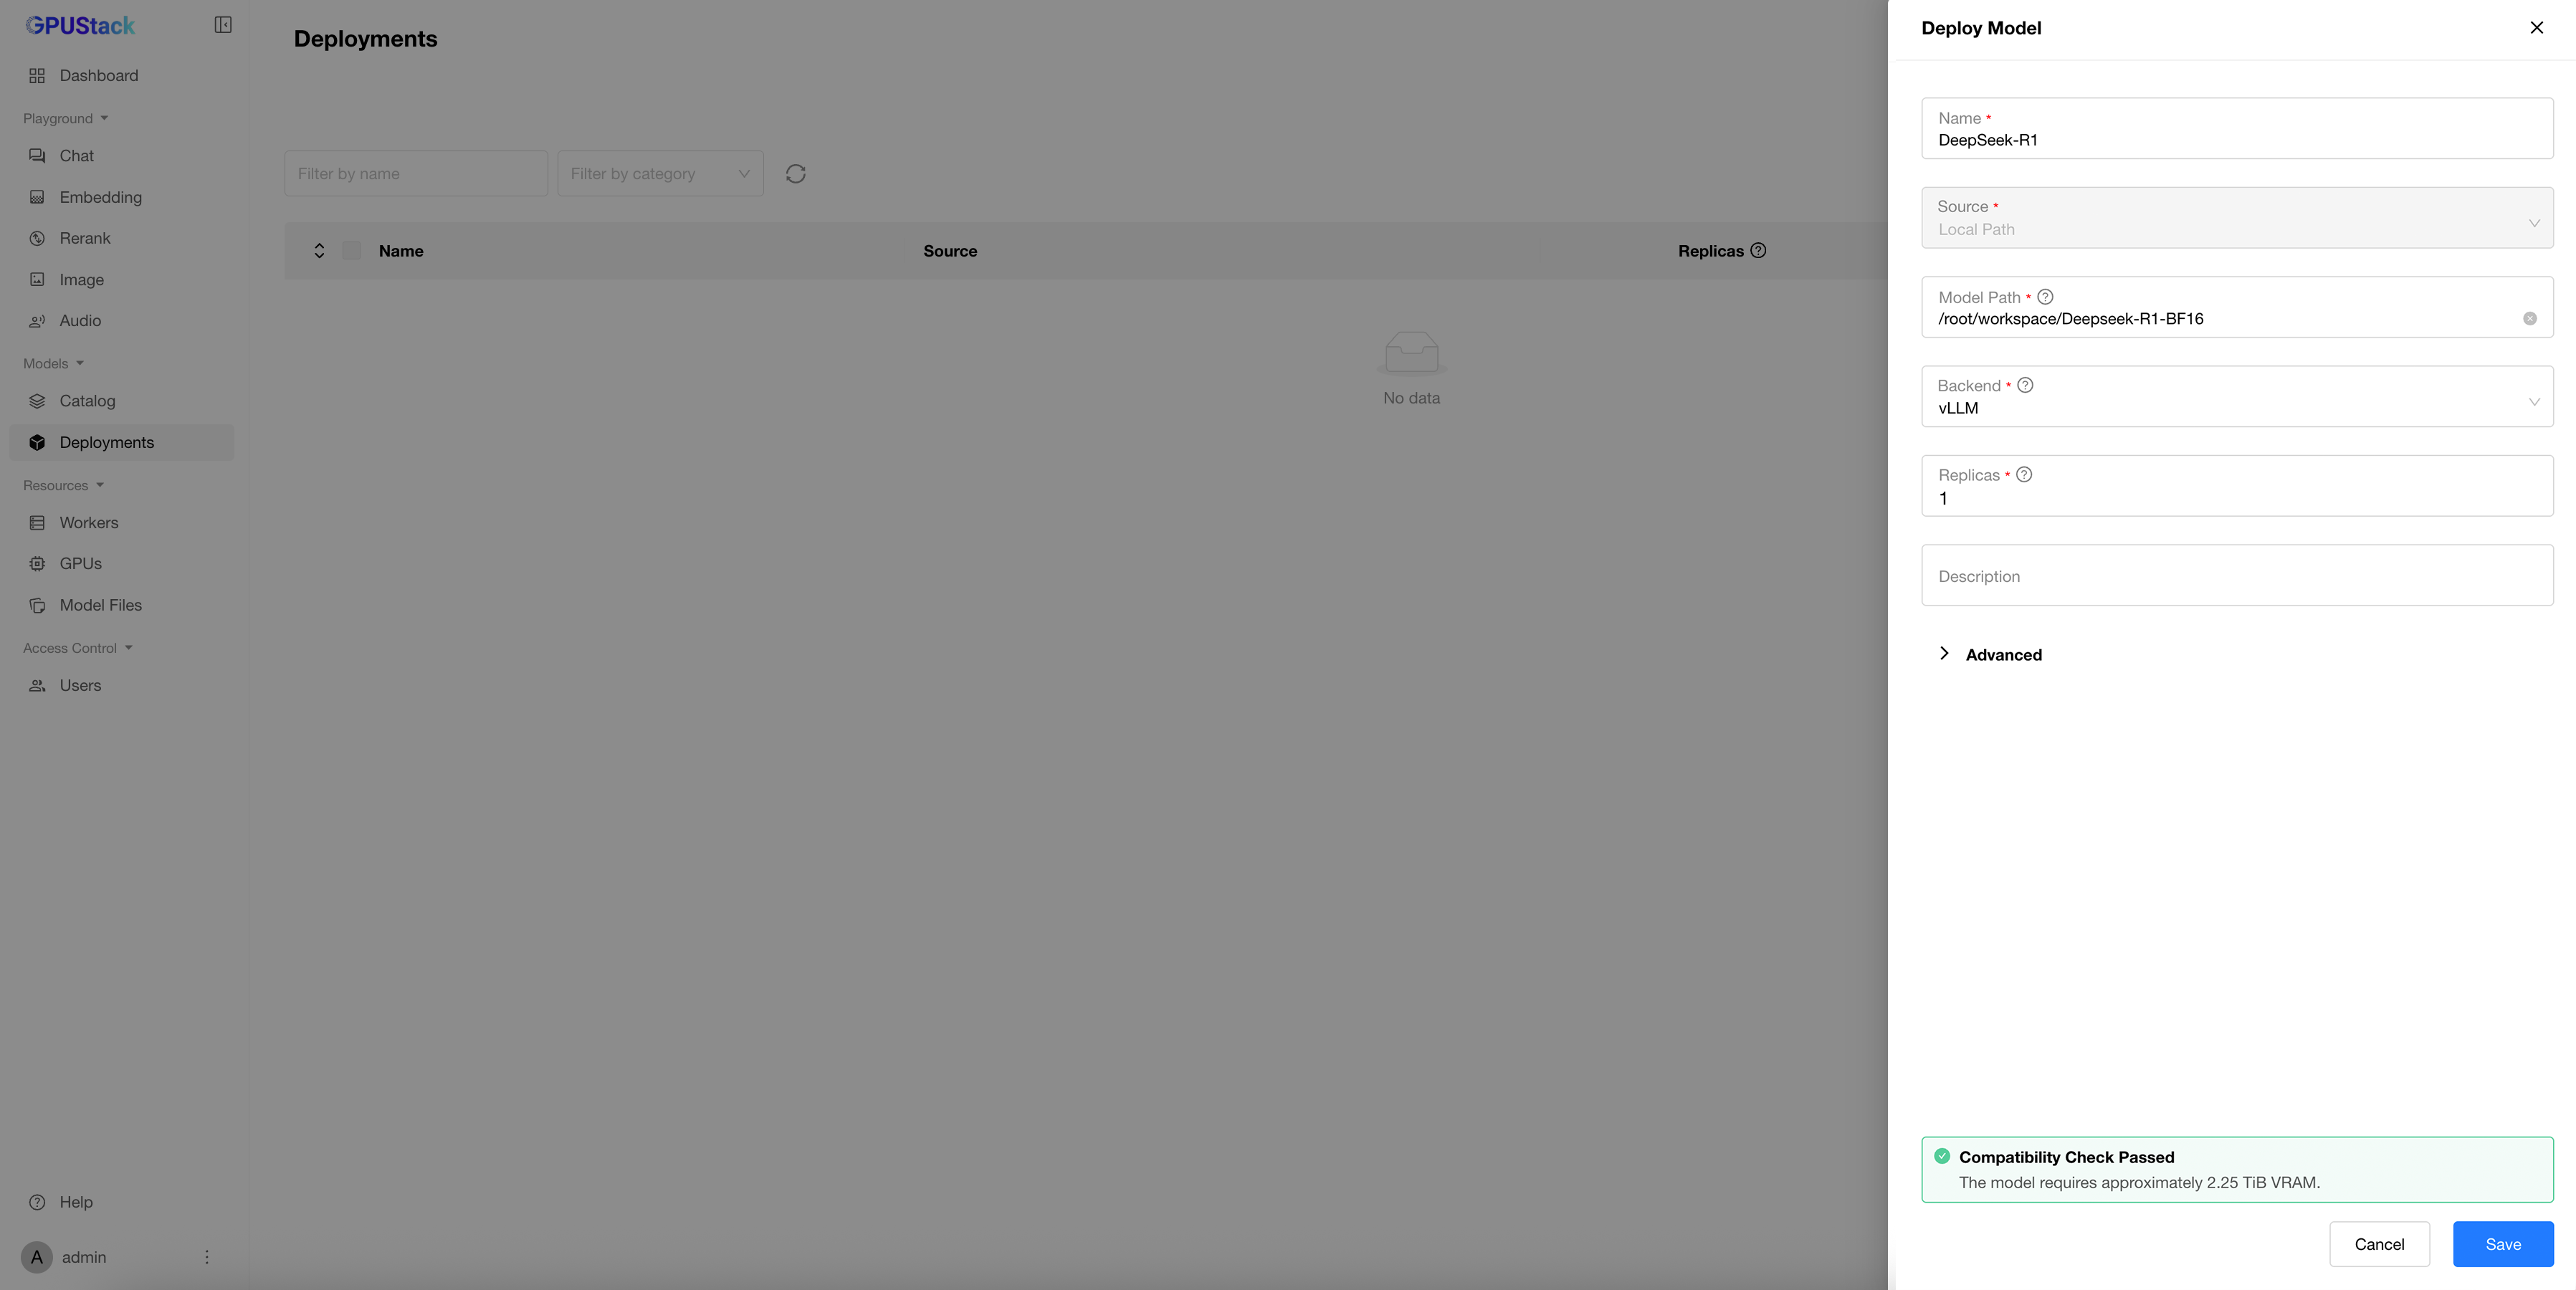
- Перейдите на страницу
Deployments. - Нажмите
Deploy Model. - Выберите
Local Pathв качестве источника. - Введите имя (например,
DeepSeek-R1) в полеName. - Укажите
Model Pathв качестве каталога, содержащего файлы модели DeepSeek R1 на каждом рабочем узле. - Убедитесь, что для
Backendустановлено значениеvLLM. - После прохождения проверки совместимости нажмите
Saveдля развертывания.
Шаг 5. Мониторинг развертывания
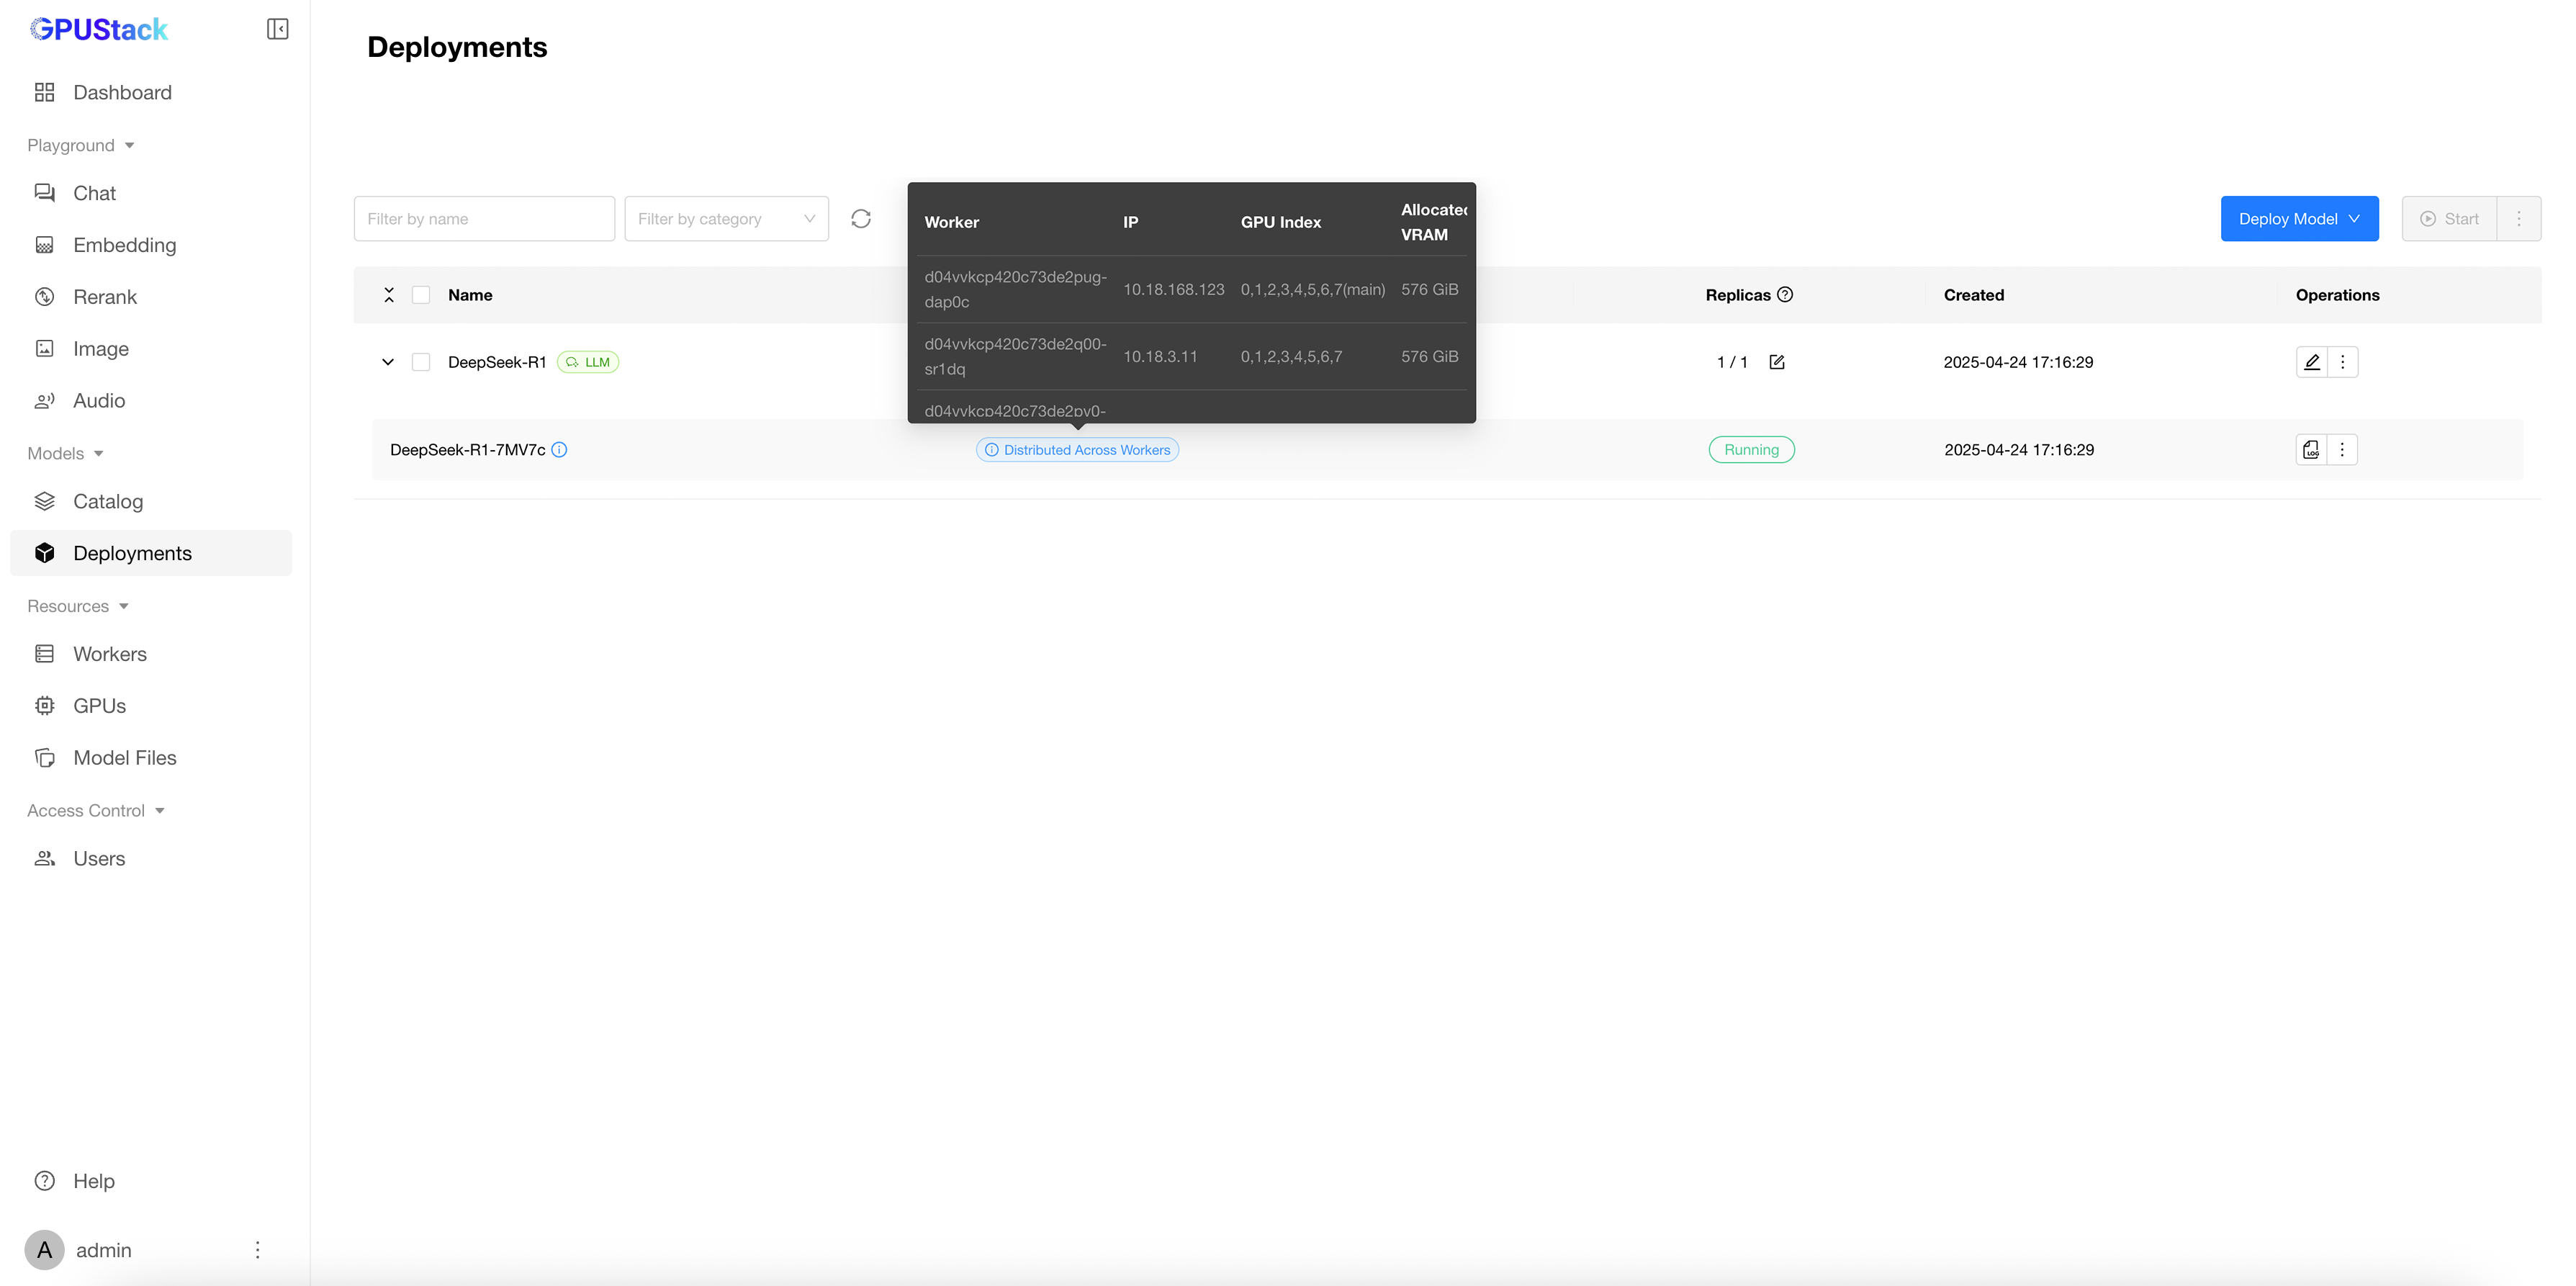
Вы можете отслеживать статус развертывания на странице Deployments. Наведите указатель мыши на distributed across workers, чтобы просмотреть использование графического процессора и рабочих процессов. Нажмите View Logs, чтобы просмотреть журналы в реальном времени, показывающие ход загрузки модели. Загрузка модели может занять несколько минут.
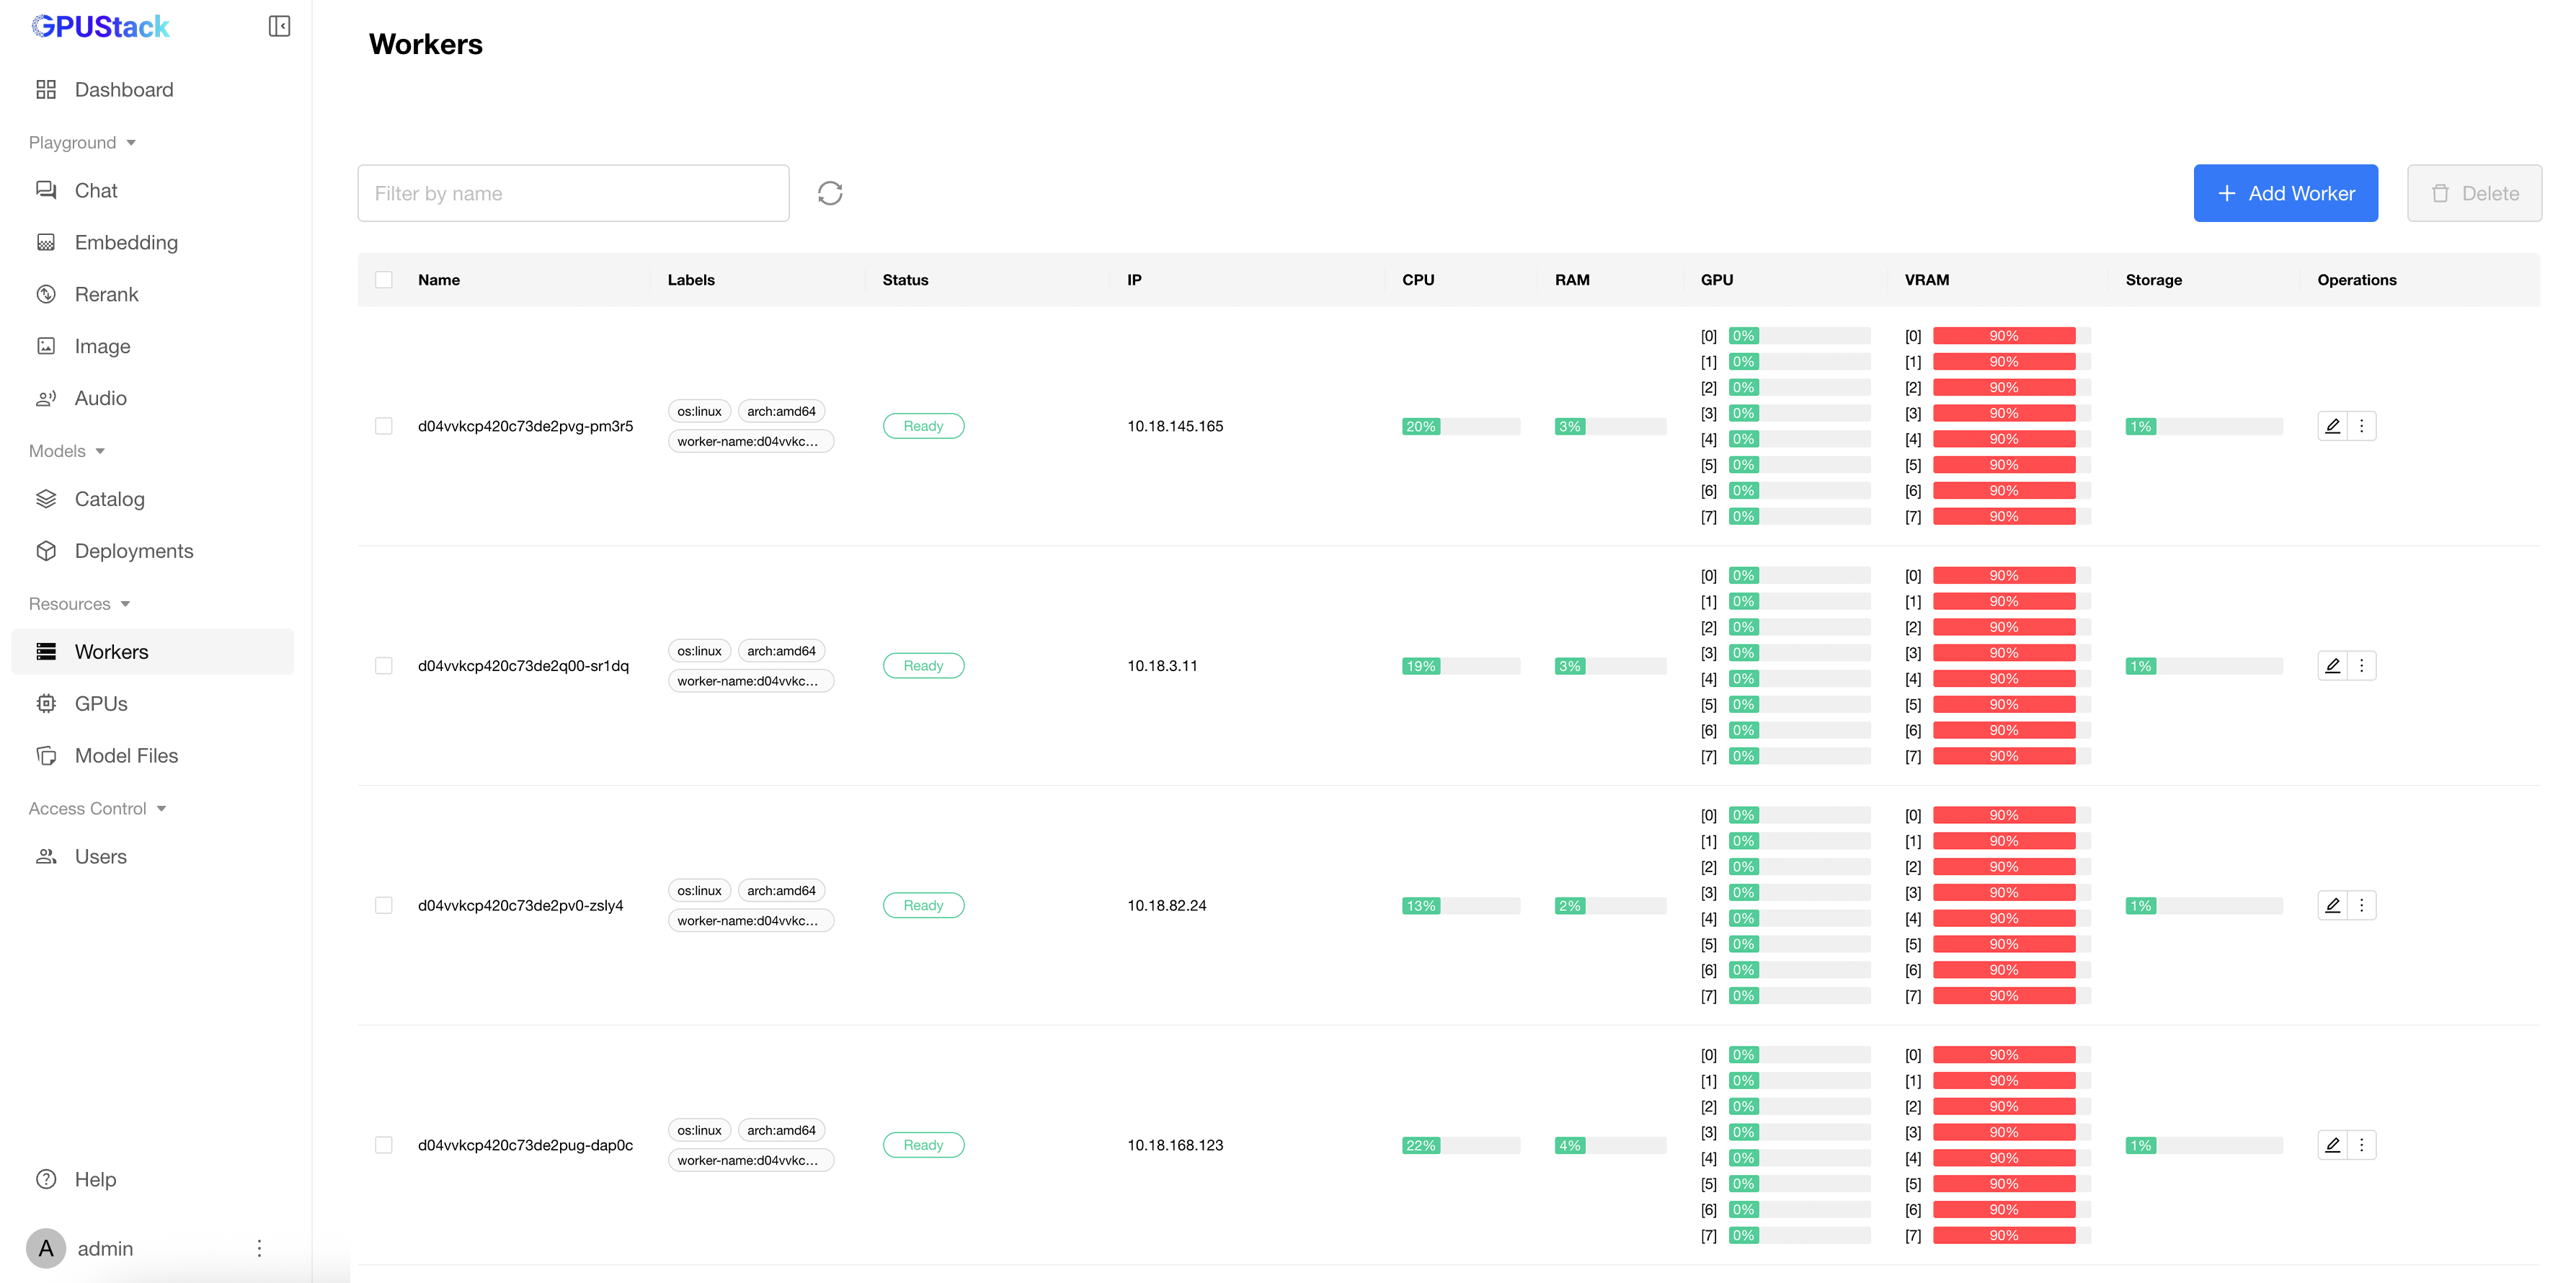
После запуска модели перейдите на страницу Workers, чтобы проверить загрузку графического процессора. По умолчанию vLLM использует 90% памяти графического процессора. Вы можете настроить это в настройках конфигурации модели.
Шаг 6: Запустите вывод через Песочницу
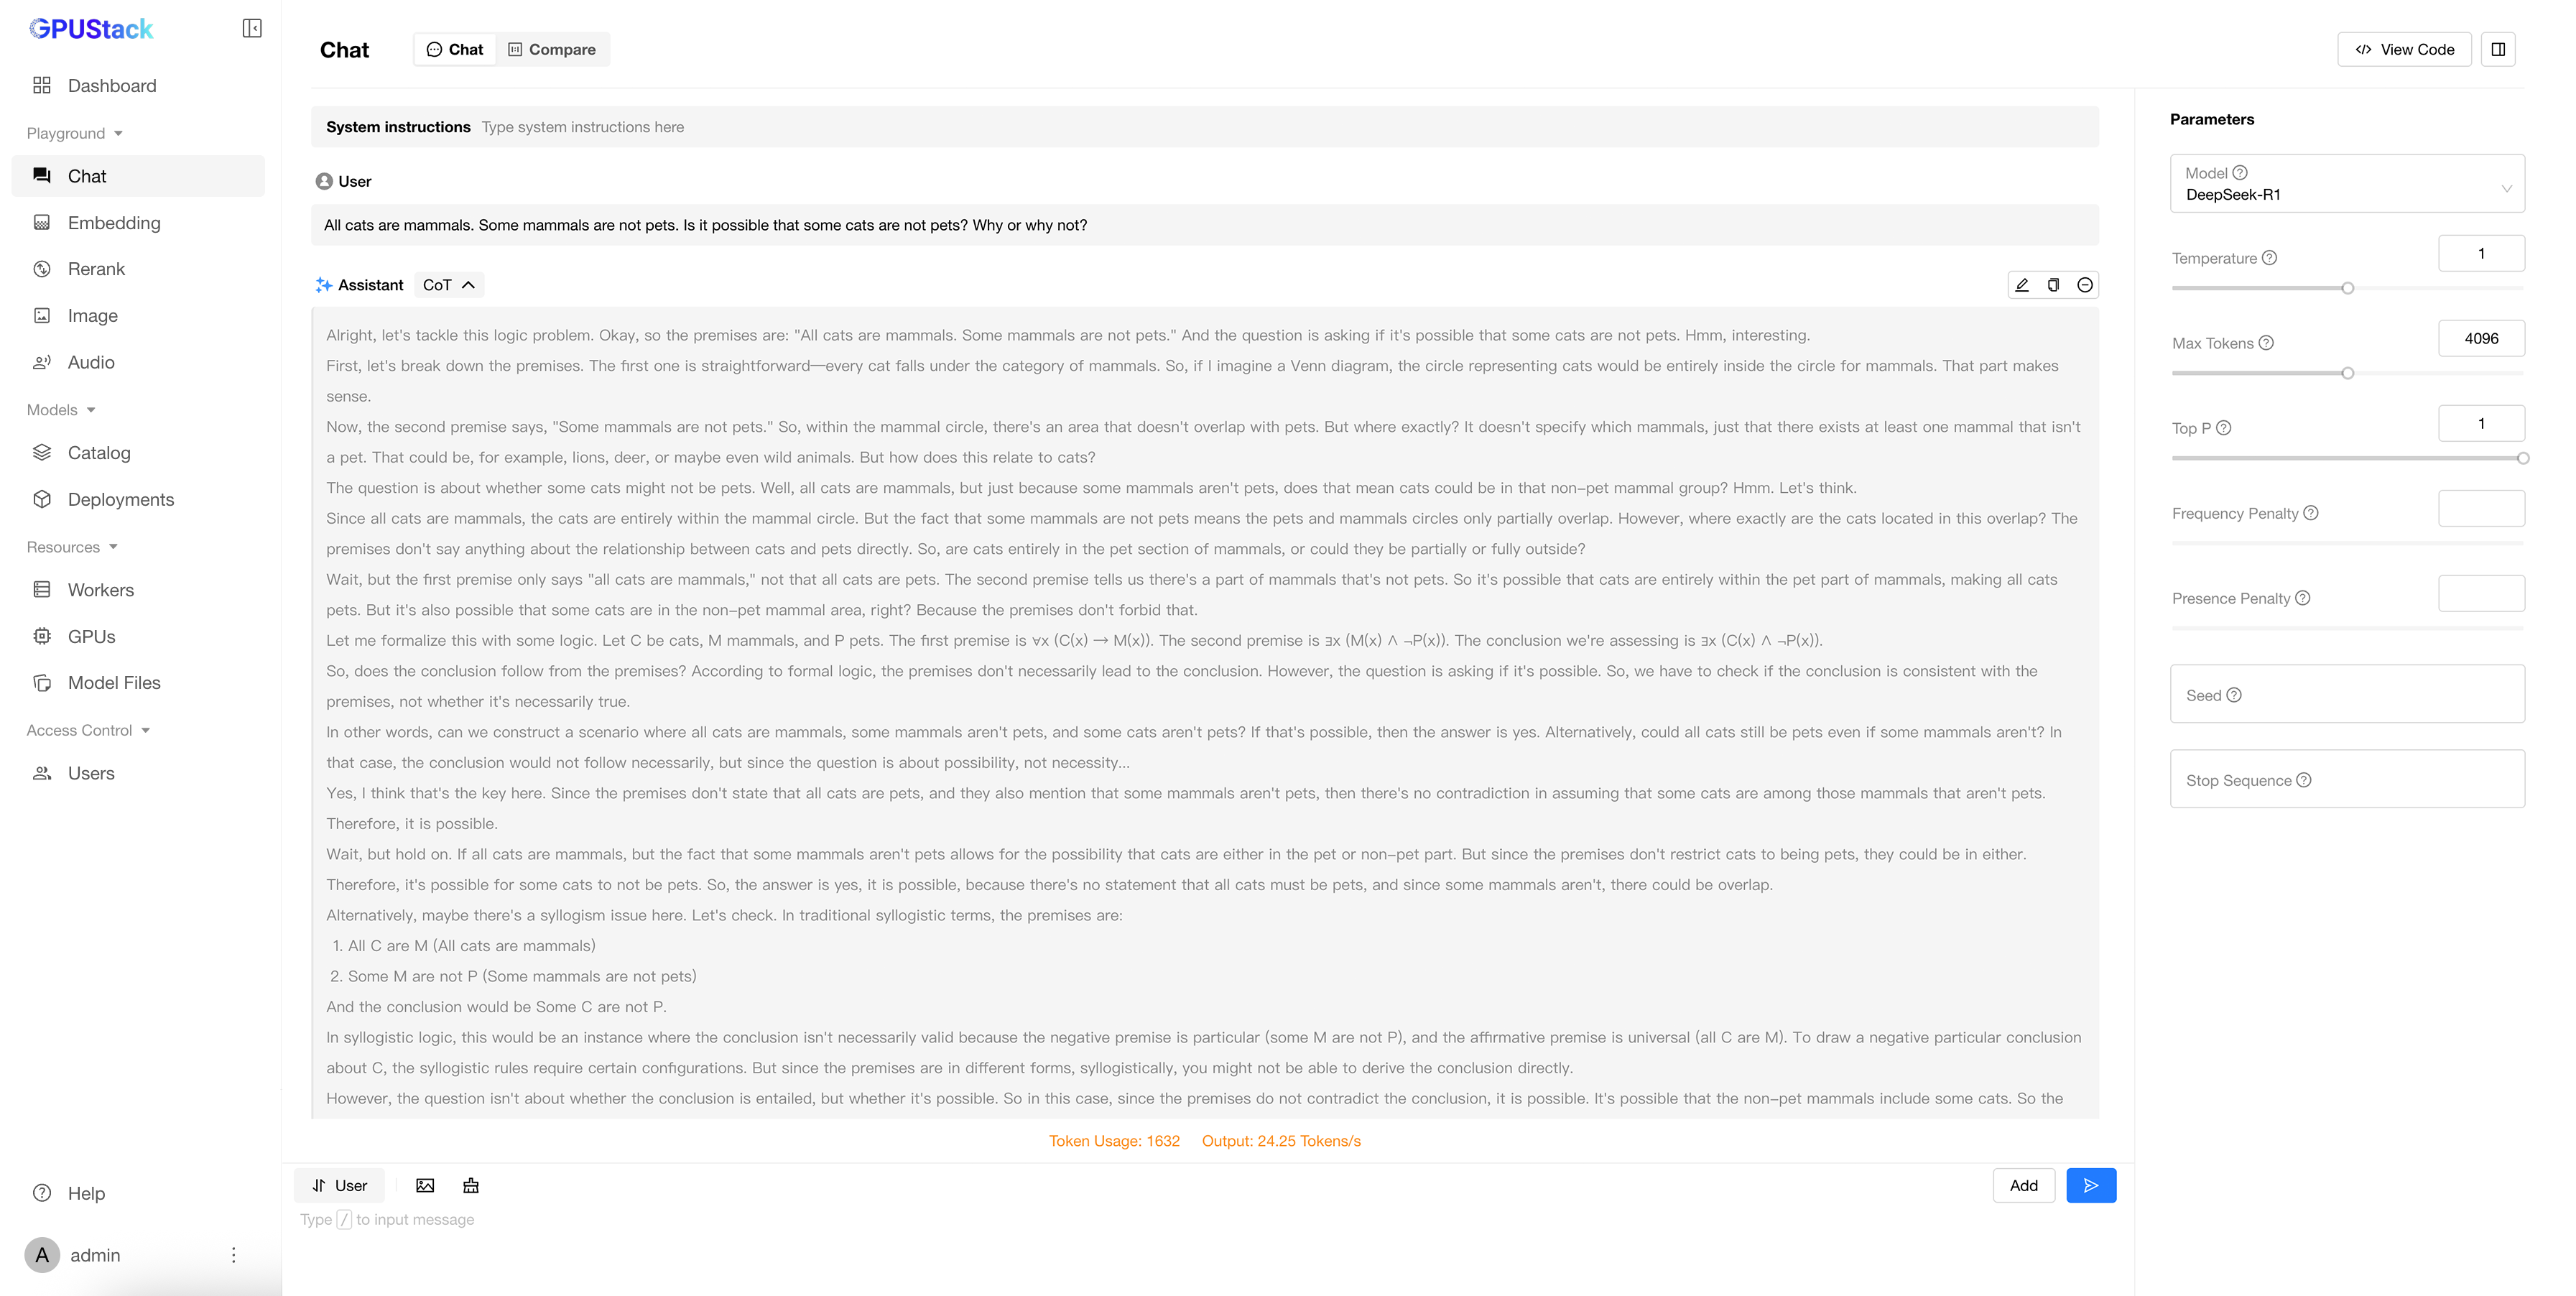
После того как модель развернута и запущена, вы можете протестировать ее с помощью GPUStack Playground.
- Перейдите к
Playground->Chat. - Если развернута только одна модель, она будет выбрана по умолчанию. В противном случае используйте раскрывающееся меню, чтобы выбрать
DeepSeek-R1. - Вводите подсказки и взаимодействуйте с моделью.
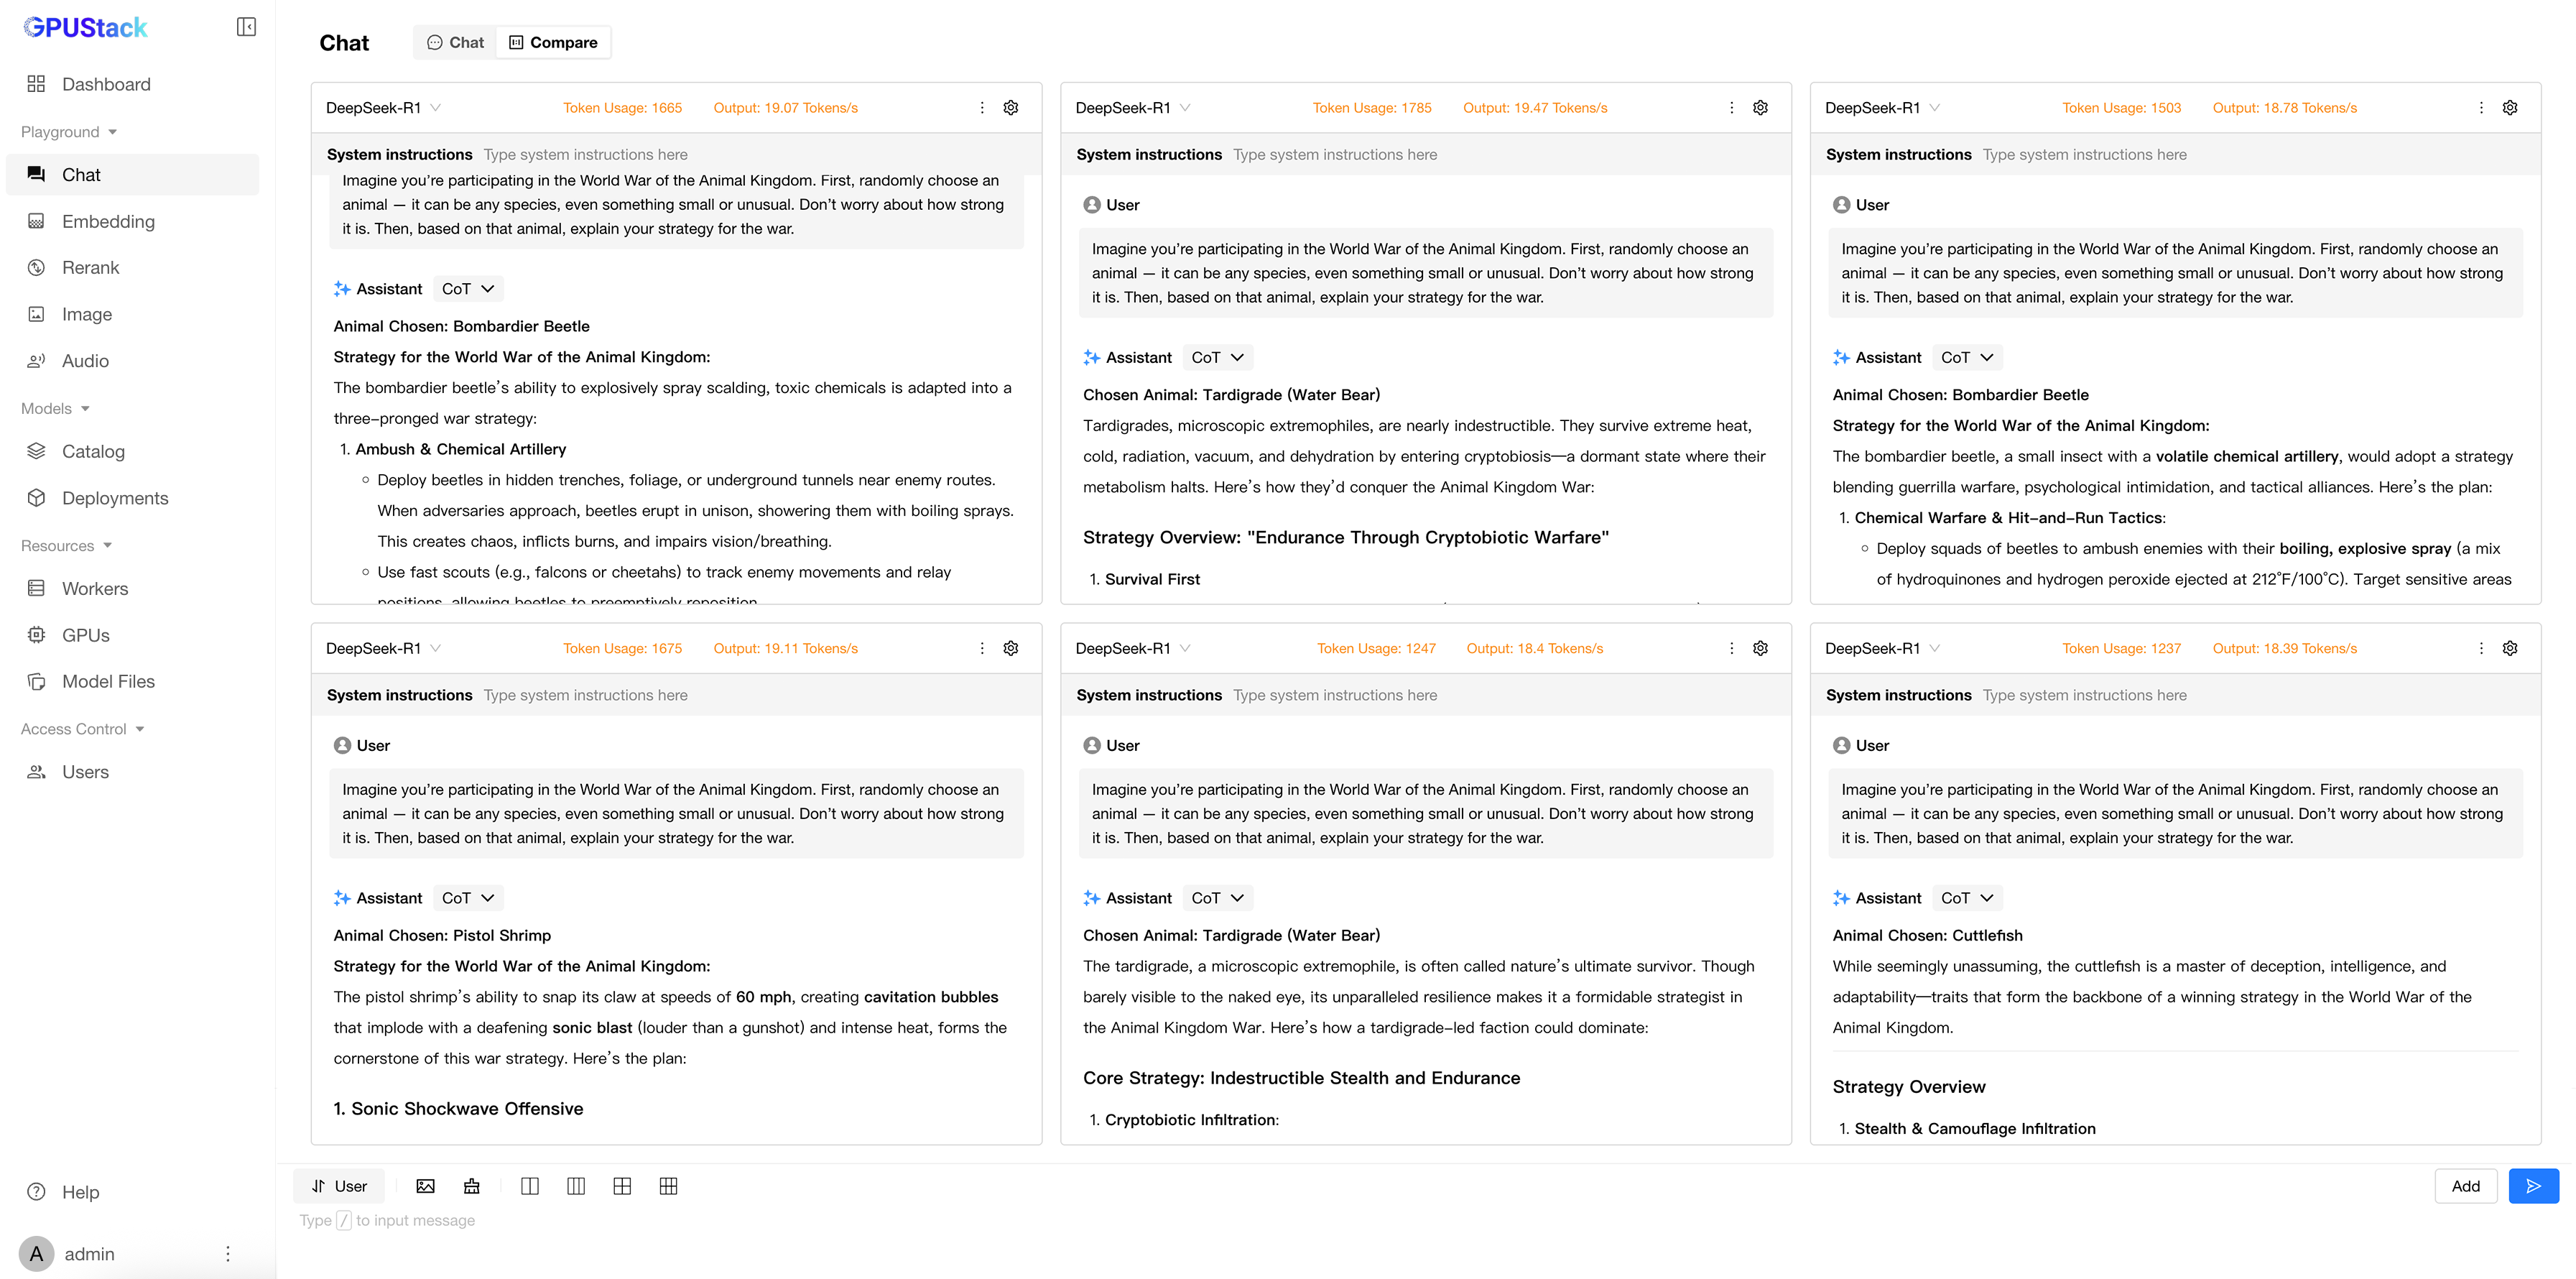
Вы также можете использовать вкладку Compare для тестирования сценариев параллельного вывода.
Теперь вы успешно развернули и запустили DeepSeek R1 671B с использованием распределенной vLLM в кластере GPUStack. Изучите производительность и возможности модели в своих собственных приложениях.
Для получения дополнительной помощи обращайтесь в сообщество GPUStack или в службу поддержки.