Оптимизация пропускной способности Qwen3-32B на NVIDIA H100 GPU Вывод
Рекомендуемая конфигурация для оптимизации пропускной способности Qwen3-32B на H100 GPU:
Команда обслуживания модели Qwen/Qwen3-32B-FP8 --max_seq_len= 40960 --enable_chunked_prefill
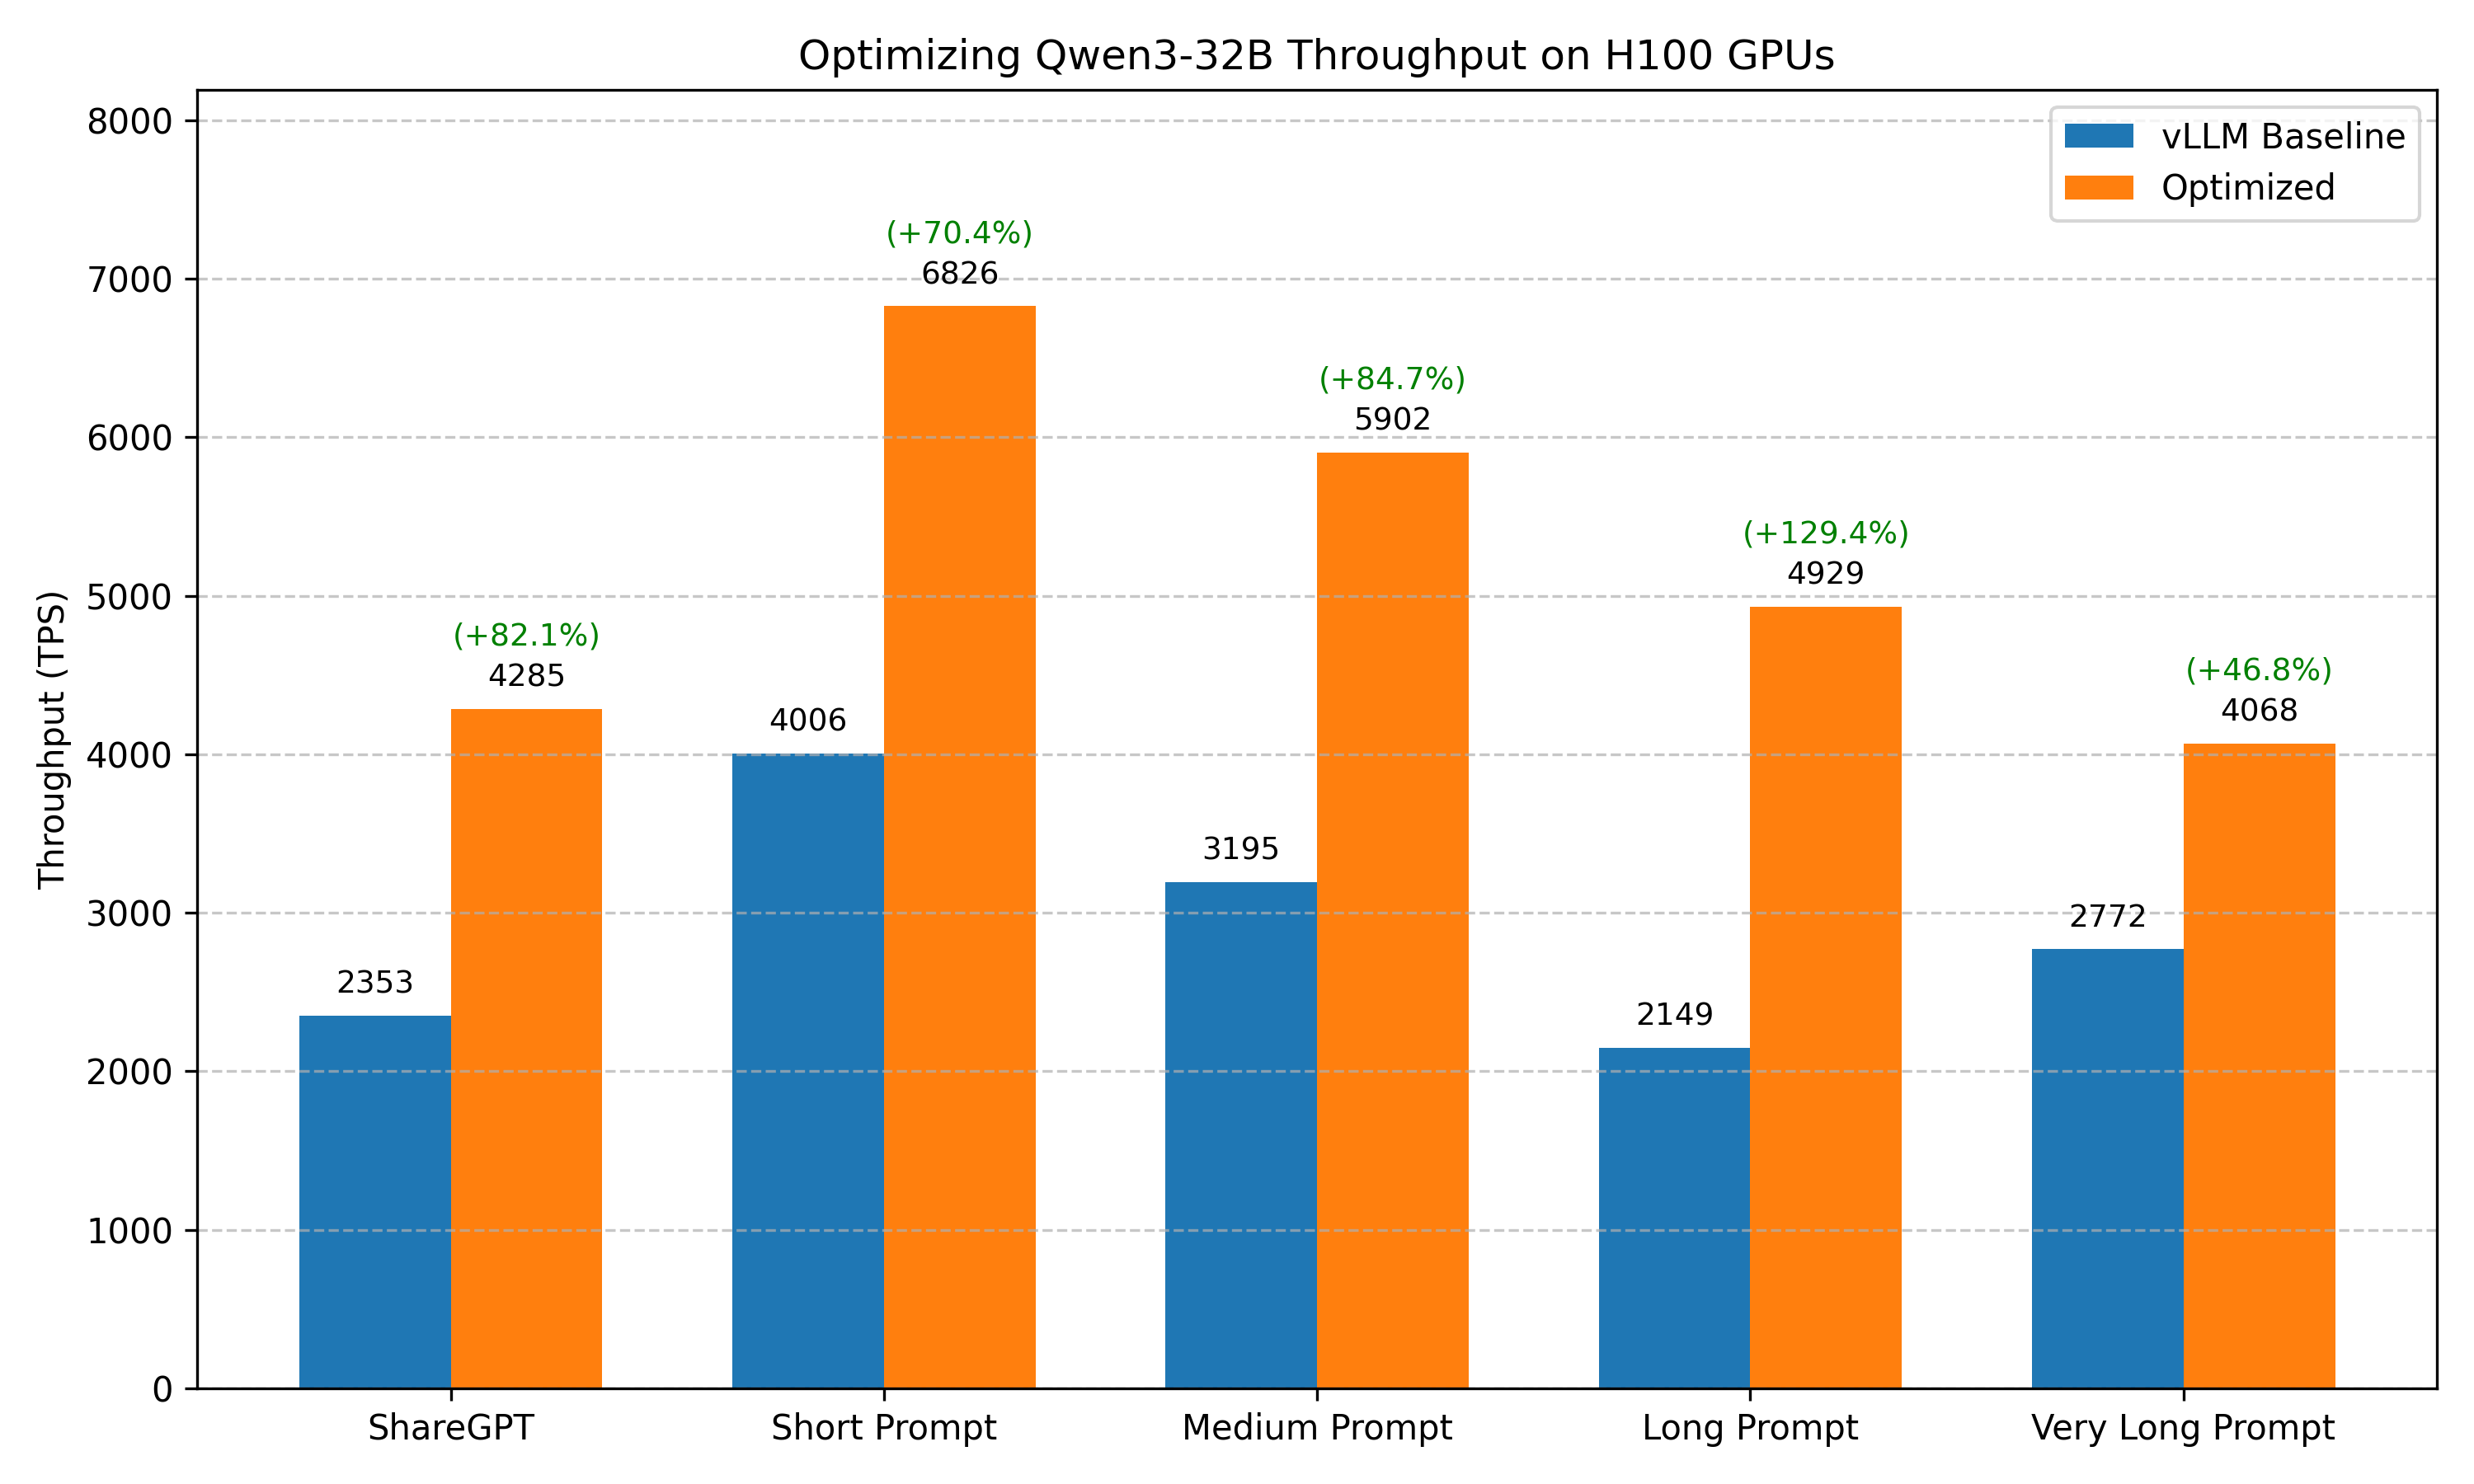
Сравнение результатов бенчмарков до и после оптимизации:
Сценарий бенчмарка базовая конфигурация (vLLM без оптимизации) После оптимизации ShareGPT Общий TPS: 2352.82 Общий TPS: 4284.68 (+82.1%) Короткий запрос Общий TPS: 4005.62 Общий TPS: 6826.33 (+70.4%) Запрос средней длины Общий TPS: 3195.30 Общий TPS: 5901.95 (+84.7%) Длинный запрос Общий TPS: 2148.69 Общий TPS: 4929.16 (+129.4%) Очень длинный запрос Общий TPS: 2771.81 Общий TPS: 4068.16 (+10.7%)
Примечание
Наши бенчмарки не охватывают все возможные сочетания оптимизаций. Например, отправной точкой дальнейшей настройки становится движок инференса с лучшей производительностью при настройках по умолчанию. Такое отсечение вариантов даёт локальный оптимум, который может не совпадать с глобальным. Есть и другие методы оптимизации, зависящие от сценария использования: максимальный размер батча, настройки планировщика, расширенный KV-кэш, CUDA graph, Torch Compile и т. д. Выводы этого документа могут служить отправной точкой для более целенаправленной оптимизации. Тесты проводились на определённых аппаратных и программных конфигурациях. Развитие движков инференса может привести к новым выводам. Квантизация может влиять на точность, однако для большинства моделей FP8 обеспечивает снижение точности менее чем на 1%. Подробности см. в результатах оценки . Поэтому для обслуживания с высокой пропускной способностью настоятельно рекомендуется квантизация FP8. Если что-то упущено или требуется обновление с учётом новых изменений, сообщите нам .
Цель оптимизации Высокая пропускная способность при высокой конкурентности запросов.
Условия эксперимента Модель Qwen3-32B
Оборудование Один NVIDIA H100 SXM GPU.
Версия движка vLLM: v0.11.0 SGLang: v0.5.5.post1 TensorRT-LLM : v1.2.0rc1 Набор данных бенчмарка ShareGPT Случайный набор данных с различной длиной последовательностей: Очень длинный запрос: 32000 входных токенов, 100 выходных токенов Длинный запрос: 4000 входных токенов, 200 выходных токенов Запрос средней длины: 2000 входных токенов, 100 выходных токенов Короткий запрос: 128 входных токенов, 4 выходных токенов Скрипт бенчмарка Для оценки производительности модели используется vLLM bench CLI . Бенчмарк запускается следующей командой:
# Prepare the ShareGPT dataset
https://huggingface.co/datasets/anon8231489123/ShareGPT_Vicuna_unfiltered/resolve/main/ShareGPT_V3_unfiltered_cleaned_split.json
# Benchmark on ShareGPT dataset
bench serve --model Qwen/Qwen3-32B --backend openai-chat --endpoint /v1/chat/completions --dataset-name sharegpt --dataset-path ShareGPT_V3_unfiltered_cleaned_split.json --num-prompts 1000
# Benchmark on random dataset (fixed seed for reproducibility)
bench serve --model Qwen/Qwen3-32B --backend openai-chat --endpoint /v1/chat/completions --dataset-name random --random-input-len 4000 --random-output-len 200 --num-prompts 500 --seed 42
Результаты эксперимента 1. Выбор движка инференса vLLM
Скрипт обслуживания модели serve Qwen/Qwen3-32B
Результат бенчмарка
SGLang
Скрипт обслуживания модели -m sglang.launch_server --model-path Qwen/Qwen3-32B
Результат бенчмарка
TensorRT-LLM
Скрипт обслуживания модели Qwen/Qwen3-32B
Результат бенчмарка
Результат: TensorRT-LLM (2659.50 tok/s) > vLLM (2352.82 tok/s) > SGLang (1690.84 tok/s)
2. Quantization в TensorRT-LLM FP8
Скрипт обслуживания модели -m sglang.launch_server --model-path Qwen/Qwen3-32B-FP8
Результат бенчмарка
3. Включение блочного prefill в TensorRT-LLM Скрипт обслуживания модели Qwen/Qwen3-32B-FP8 --max_seq_len= 40960 --enable_chunked_prefill
Результат бенчмарка
Сводка методов оптимизации Метод оптимизации Прирост пропускной способности Выбор движка +13.0% Quantization +50.6% Включение блочного prefill +7.0%
Другие сценарии бенчмарка Мы дополнительно проверили оптимизированную конфигурацию на разных нагрузках, чтобы оценить её обобщаемость.
Базовый скрипт обслуживания модели serve Qwen/Qwen3-32B
Результаты базового бенчмарка # random 32K input
============ Serving Benchmark Result ============
requests: 100
duration ( s) : 1157 .25
input tokens: 3200000
generated tokens: 7681
throughput ( req/s) : 0 .09
token throughput ( tok/s) : 6 .64
output token throughput ( tok/s) : 24 .00
concurrent requests: 100 .00
Token throughput ( tok/s) : 2771 .81
to First Token----------------
TTFT ( ms) : 585981 .22
TTFT ( ms) : 582757 .65
TTFT ( ms) : 1144686 .57
per Output Token ( excl. 1st token) ------
TPOT ( ms) : 43 .42
TPOT ( ms) : 43 .36
TPOT ( ms) : 44 .34
Latency----------------
ITL ( ms) : 42 .86
ITL ( ms) : 43 .30
ITL ( ms) : 46 .54
==================================================
# random 4K input
============ Serving Benchmark Result ============
requests: 500
duration ( s) : 976 .29
input tokens: 1997942
generated tokens: 99790
throughput ( req/s) : 0 .51
token throughput ( tok/s) : 102 .21
output token throughput ( tok/s) : 186 .00
concurrent requests: 500 .00
Token throughput ( tok/s) : 2148 .69
to First Token----------------
TTFT ( ms) : 482284 .21
TTFT ( ms) : 483375 .28
TTFT ( ms) : 956141 .26
per Output Token ( excl. 1st token) ------
TPOT ( ms) : 66 .61
TPOT ( ms) : 62 .08
TPOT ( ms) : 100 .86
Latency----------------
ITL ( ms) : 66 .29
ITL ( ms) : 43 .38
ITL ( ms) : 1395 .23
==================================================
# random 2K input
============ Serving Benchmark Result ============
requests: 500
duration ( s) : 328 .04
input tokens: 998175
generated tokens: 50000
throughput ( req/s) : 1 .52
token throughput ( tok/s) : 152 .42
output token throughput ( tok/s) : 359 .00
concurrent requests: 500 .00
Token throughput ( tok/s) : 3195 .30
to First Token----------------
TTFT ( ms) : 163909 .40
TTFT ( ms) : 164148 .38
TTFT ( ms) : 322980 .86
per Output Token ( excl. 1st token) ------
TPOT ( ms) : 86 .62
TPOT ( ms) : 84 .24
TPOT ( ms) : 131 .41
Latency----------------
ITL ( ms) : 85 .97
ITL ( ms) : 44 .80
ITL ( ms) : 1462 .05
==================================================
# random 128 input
============ Serving Benchmark Result ============
requests: 1000
duration ( s) : 32 .88
input tokens: 127698
generated tokens: 4000
throughput ( req/s) : 30 .42
token throughput ( tok/s) : 121 .66
output token throughput ( tok/s) : 522 .00
concurrent requests: 1000 .00
Token throughput ( tok/s) : 4005 .62
to First Token----------------
TTFT ( ms) : 21648 .67
TTFT ( ms) : 21342 .36
TTFT ( ms) : 32678 .31
per Output Token ( excl. 1st token) ------
TPOT ( ms) : 1169 .72
TPOT ( ms) : 1292 .78
TPOT ( ms) : 1417 .05
Latency----------------
ITL ( ms) : 877 .29
ITL ( ms) : 1141 .11
ITL ( ms) : 1435 .80
==================================================
Скрипт обслуживания после оптимизации Qwen/Qwen3-32B-FP8 --max_seq_len= 40960 --enable_chunked_prefill
Результаты бенчмарка после оптимизации # random 32K input
============ Serving Benchmark Result ============
requests: 100
duration ( s) : 788 .52
input tokens: 3200000
generated tokens: 7832
throughput ( req/s) : 0 .13
token throughput ( tok/s) : 9 .93
output token throughput ( tok/s) : 104 .00
concurrent requests: 100 .00
Token throughput ( tok/s) : 4068 .16
to First Token----------------
TTFT ( ms) : 396294 .90
TTFT ( ms) : 397717 .15
TTFT ( ms) : 778540 .06
per Output Token ( excl. 1st token) ------
TPOT ( ms) : 286 .97
TPOT ( ms) : 255 .80
TPOT ( ms) : 581 .09
Latency----------------
ITL ( ms) : 284 .98
ITL ( ms) : 39 .76
ITL ( ms) : 2105 .62
==================================================
# random 4K input
============ Serving Benchmark Result ============
requests: 500
duration ( s) : 425 .60
input tokens: 1997942
generated tokens: 99888
throughput ( req/s) : 1 .17
token throughput ( tok/s) : 234 .70
output token throughput ( tok/s) : 828 .00
concurrent requests: 500 .00
Token throughput ( tok/s) : 4929 .16
to First Token----------------
TTFT ( ms) : 208082 .20
TTFT ( ms) : 204136 .20
TTFT ( ms) : 415000 .76
per Output Token ( excl. 1st token) ------
TPOT ( ms) : 138 .75
TPOT ( ms) : 141 .52
TPOT ( ms) : 151 .74
Latency----------------
ITL ( ms) : 138 .01
ITL ( ms) : 45 .37
ITL ( ms) : 1254 .20
==================================================
# random 2K input
============ Serving Benchmark Result ============
requests: 500
duration ( s) : 177 .60
input tokens: 998175
generated tokens: 50000
throughput ( req/s) : 2 .82
token throughput ( tok/s) : 281 .53
output token throughput ( tok/s) : 1529 .00
concurrent requests: 500 .00
Token throughput ( tok/s) : 5901 .95
to First Token----------------
TTFT ( ms) : 86596 .60
TTFT ( ms) : 86629 .72
TTFT ( ms) : 171842 .84
per Output Token ( excl. 1st token) ------
TPOT ( ms) : 223 .40
TPOT ( ms) : 237 .63
TPOT ( ms) : 249 .66
Latency----------------
ITL ( ms) : 221 .16
ITL ( ms) : 49 .40
ITL ( ms) : 1216 .32
==================================================
# random 128 input
============ Serving Benchmark Result ============
requests: 1000
duration ( s) : 19 .29
input tokens: 127698
generated tokens: 4000
throughput ( req/s) : 51 .83
token throughput ( tok/s) : 207 .33
output token throughput ( tok/s) : 860 .00
concurrent requests: 1000 .00
Token throughput ( tok/s) : 6826 .33
to First Token----------------
TTFT ( ms) : 10718 .84
TTFT ( ms) : 10511 .60
TTFT ( ms) : 19055 .52
per Output Token ( excl. 1st token) ------
TPOT ( ms) : 890 .11
TPOT ( ms) : 949 .23
TPOT ( ms) : 1351 .38
Latency----------------
ITL ( ms) : 667 .57
ITL ( ms) : 925 .89
ITL ( ms) : 1854 .09
==================================================