

Обзор
GPUStack — это менеджер GPU-кластеров с открытым исходным кодом для обслуживания моделей ИИ и предоставления GPU-инстансов. Он настраивает и координирует механизмы вывода — vLLM, SGLang, TensorRT-LLM или ваши собственные — и позволяет запускать GPU-инстансы с доступом по SSH по требованию.
-
Мультикластерное управление графическим процессором
Управляет GPU-кластерами на локальных серверах, в Kubernetes и у облачных провайдеров. Поддерживает разделение GPU для развертываний моделей и GPU-инстансов с настраиваемыми квотами видеопамяти и вычислительных ресурсов.
-
Подключаемые механизмы вывода
Автоматически настраивает высокопроизводительные механизмы вывода, такие как vLLM, SGLang и TensorRT-LLM. При необходимости вы также можете добавить собственные механизмы вывода.
-
Оптимизация производительности
Предлагает предварительно настроенные режимы для низкой задержки или высокой пропускной способности. Поддерживает разделение prefill/decode, общий KV-кеш под управлением платформы и спекулятивное декодирование.
-
Встроенное тестирование производительности
Сравнивает пропускную способность и задержку при разных уровнях параллелизма или частоты запросов, помогая выбрать рабочие параметры для достижения ваших целей производительности.
-
GPU-инстансы
Запускает GPU-инстансы с доступом по SSH по требованию для разработки, дообучения и интерактивных задач.
-
Операции корпоративного уровня
Предлагает поддержку автоматического восстановления после сбоев, балансировки нагрузки, мониторинга, аутентификации и контроля доступа.
Архитектура
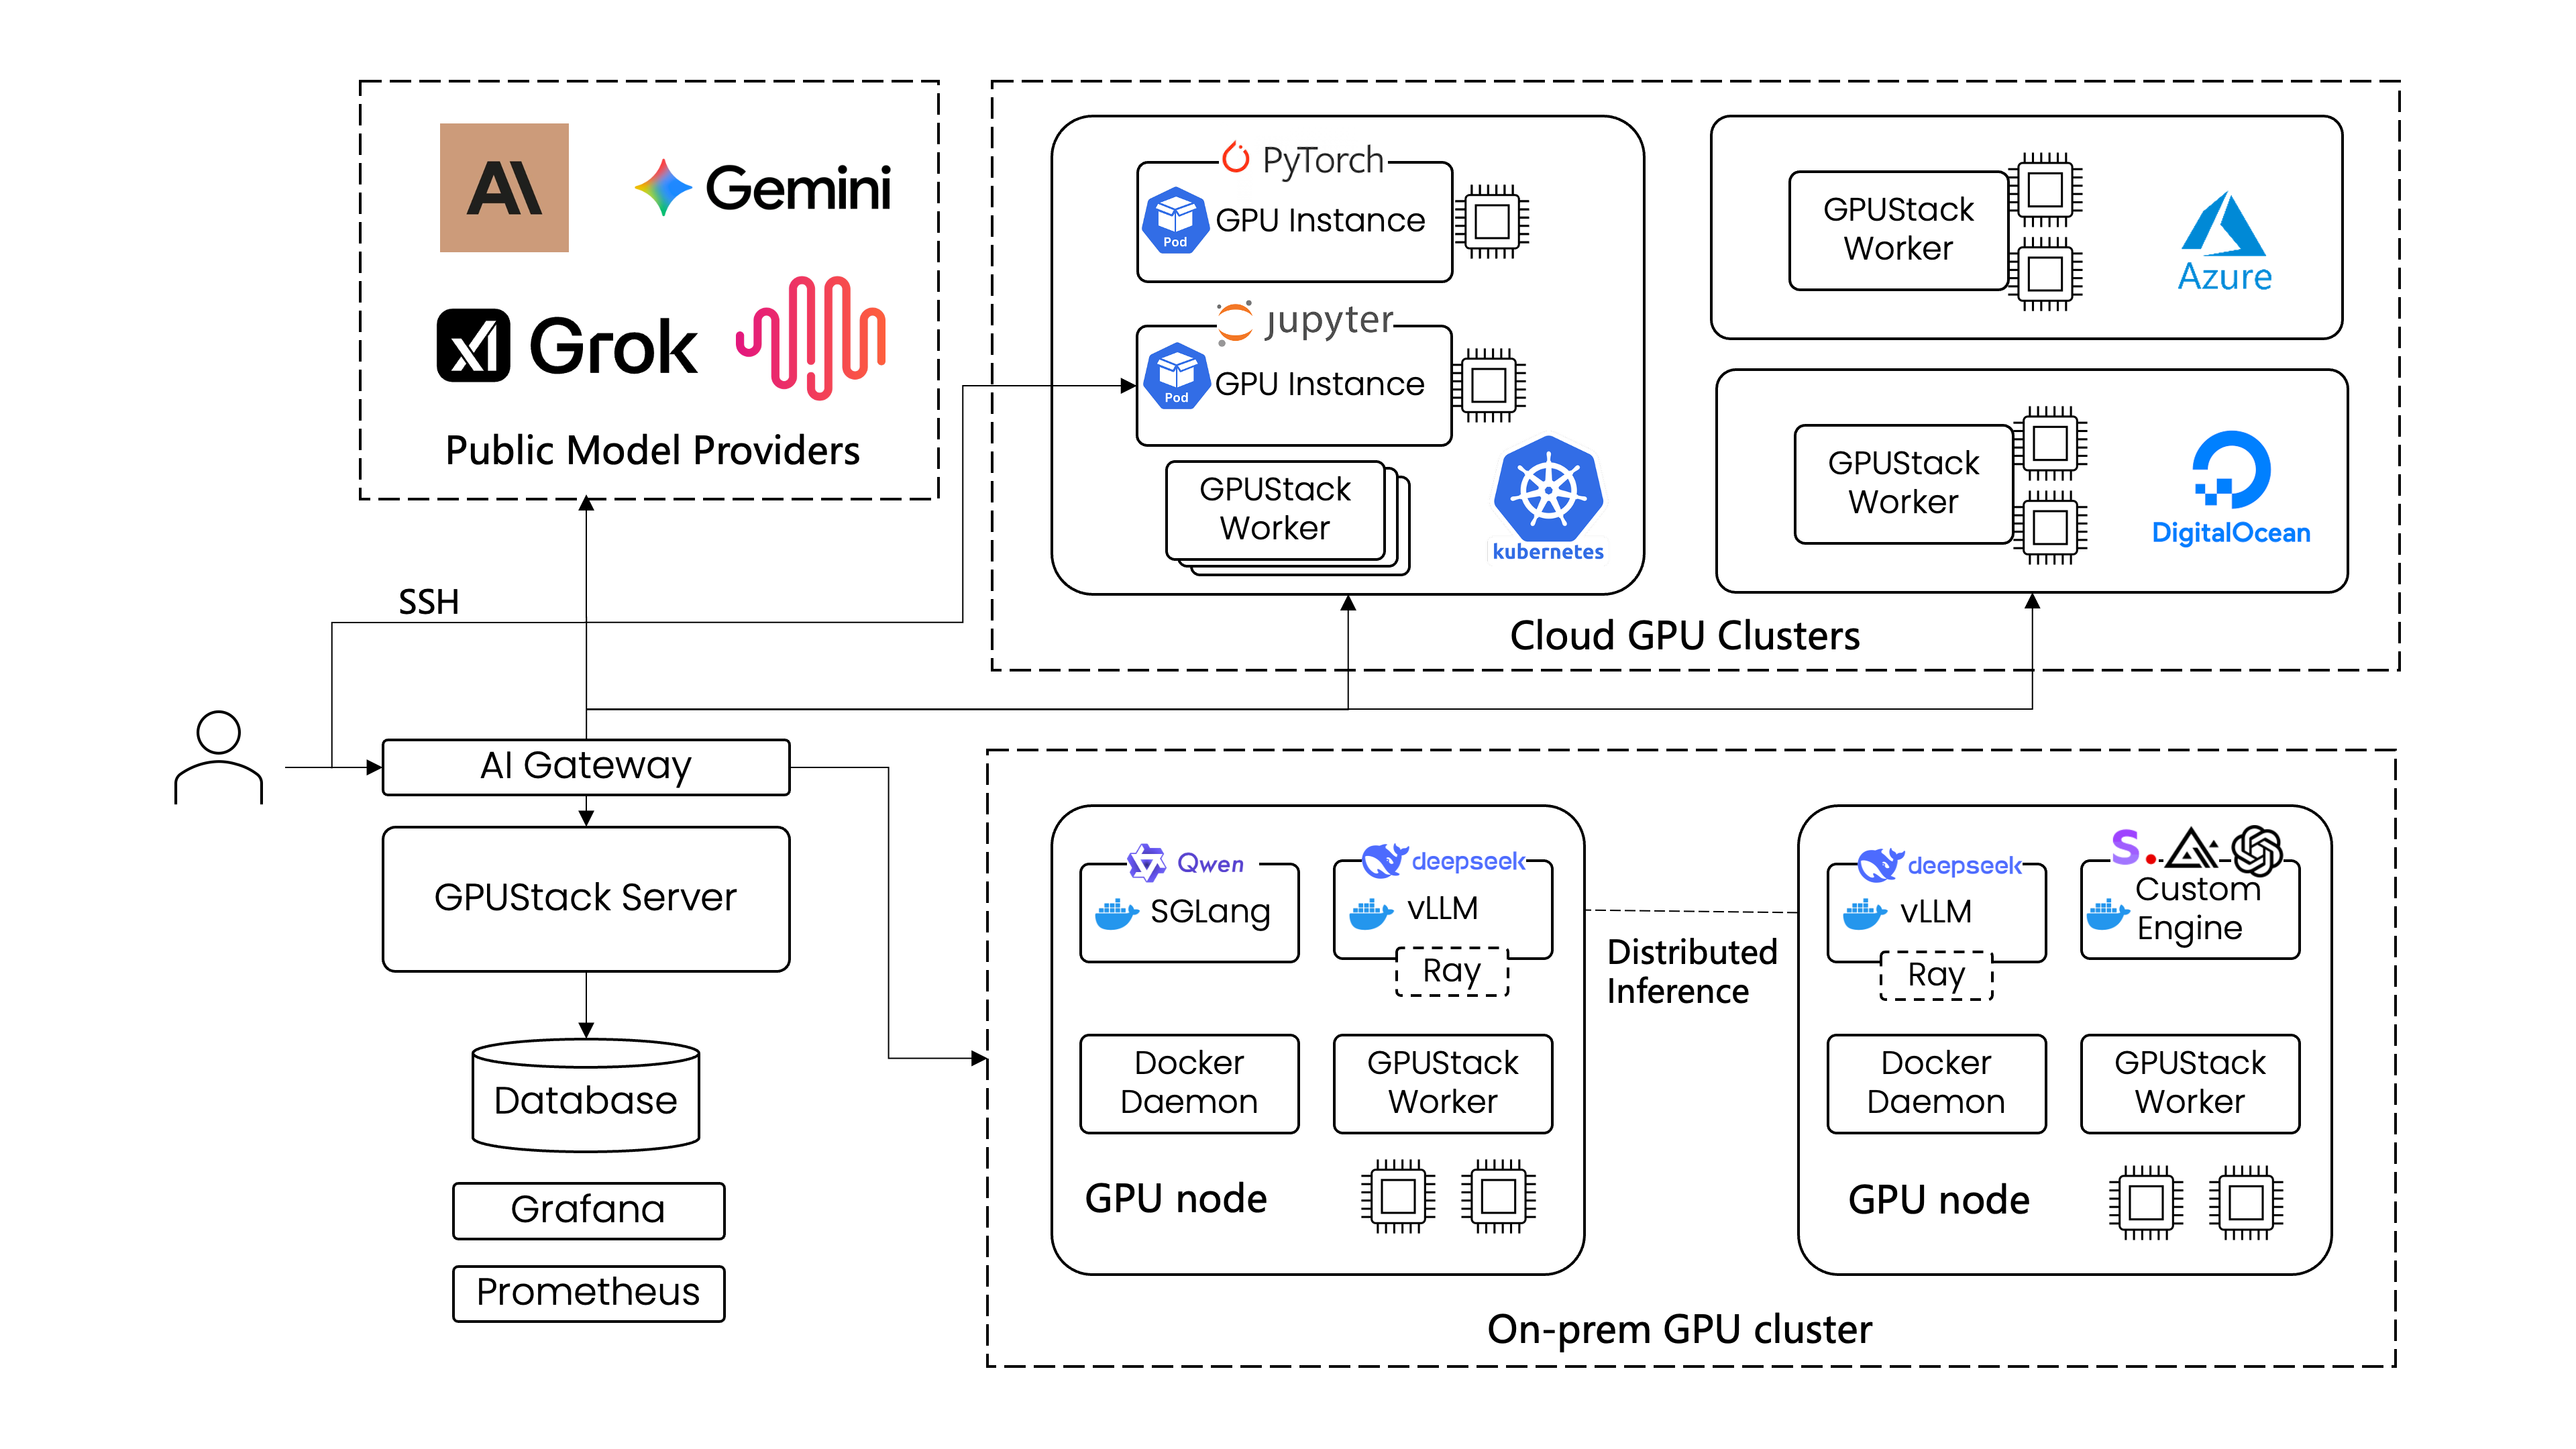
GPUStack позволяет группам разработчиков, ИТ-организациям и поставщикам услуг предоставлять модель как услугу в любом масштабе. Он поддерживает стандартные API для моделей LLM, голоса, изображений и видео. Платформа включает в себя встроенную систему аутентификации пользователей и контроля доступа, мониторинг производительности и использования графического процессора в реальном времени, а также детальный учет использования токенов и частоты запросов API.
На рисунке ниже показано, как один сервер GPUStack может управлять несколькими кластерами графических процессоров как в локальной, так и в облачной среде. Планировщик GPUStack выделяет графические процессоры для максимального использования ресурсов и выбирает подходящие механизмы вывода для оптимальной производительности. Администраторы также получают полную информацию о состоянии и показателях системы через интегрированные информационные панели Grafana и Prometheus.
Обзор кластера с первого взгляда
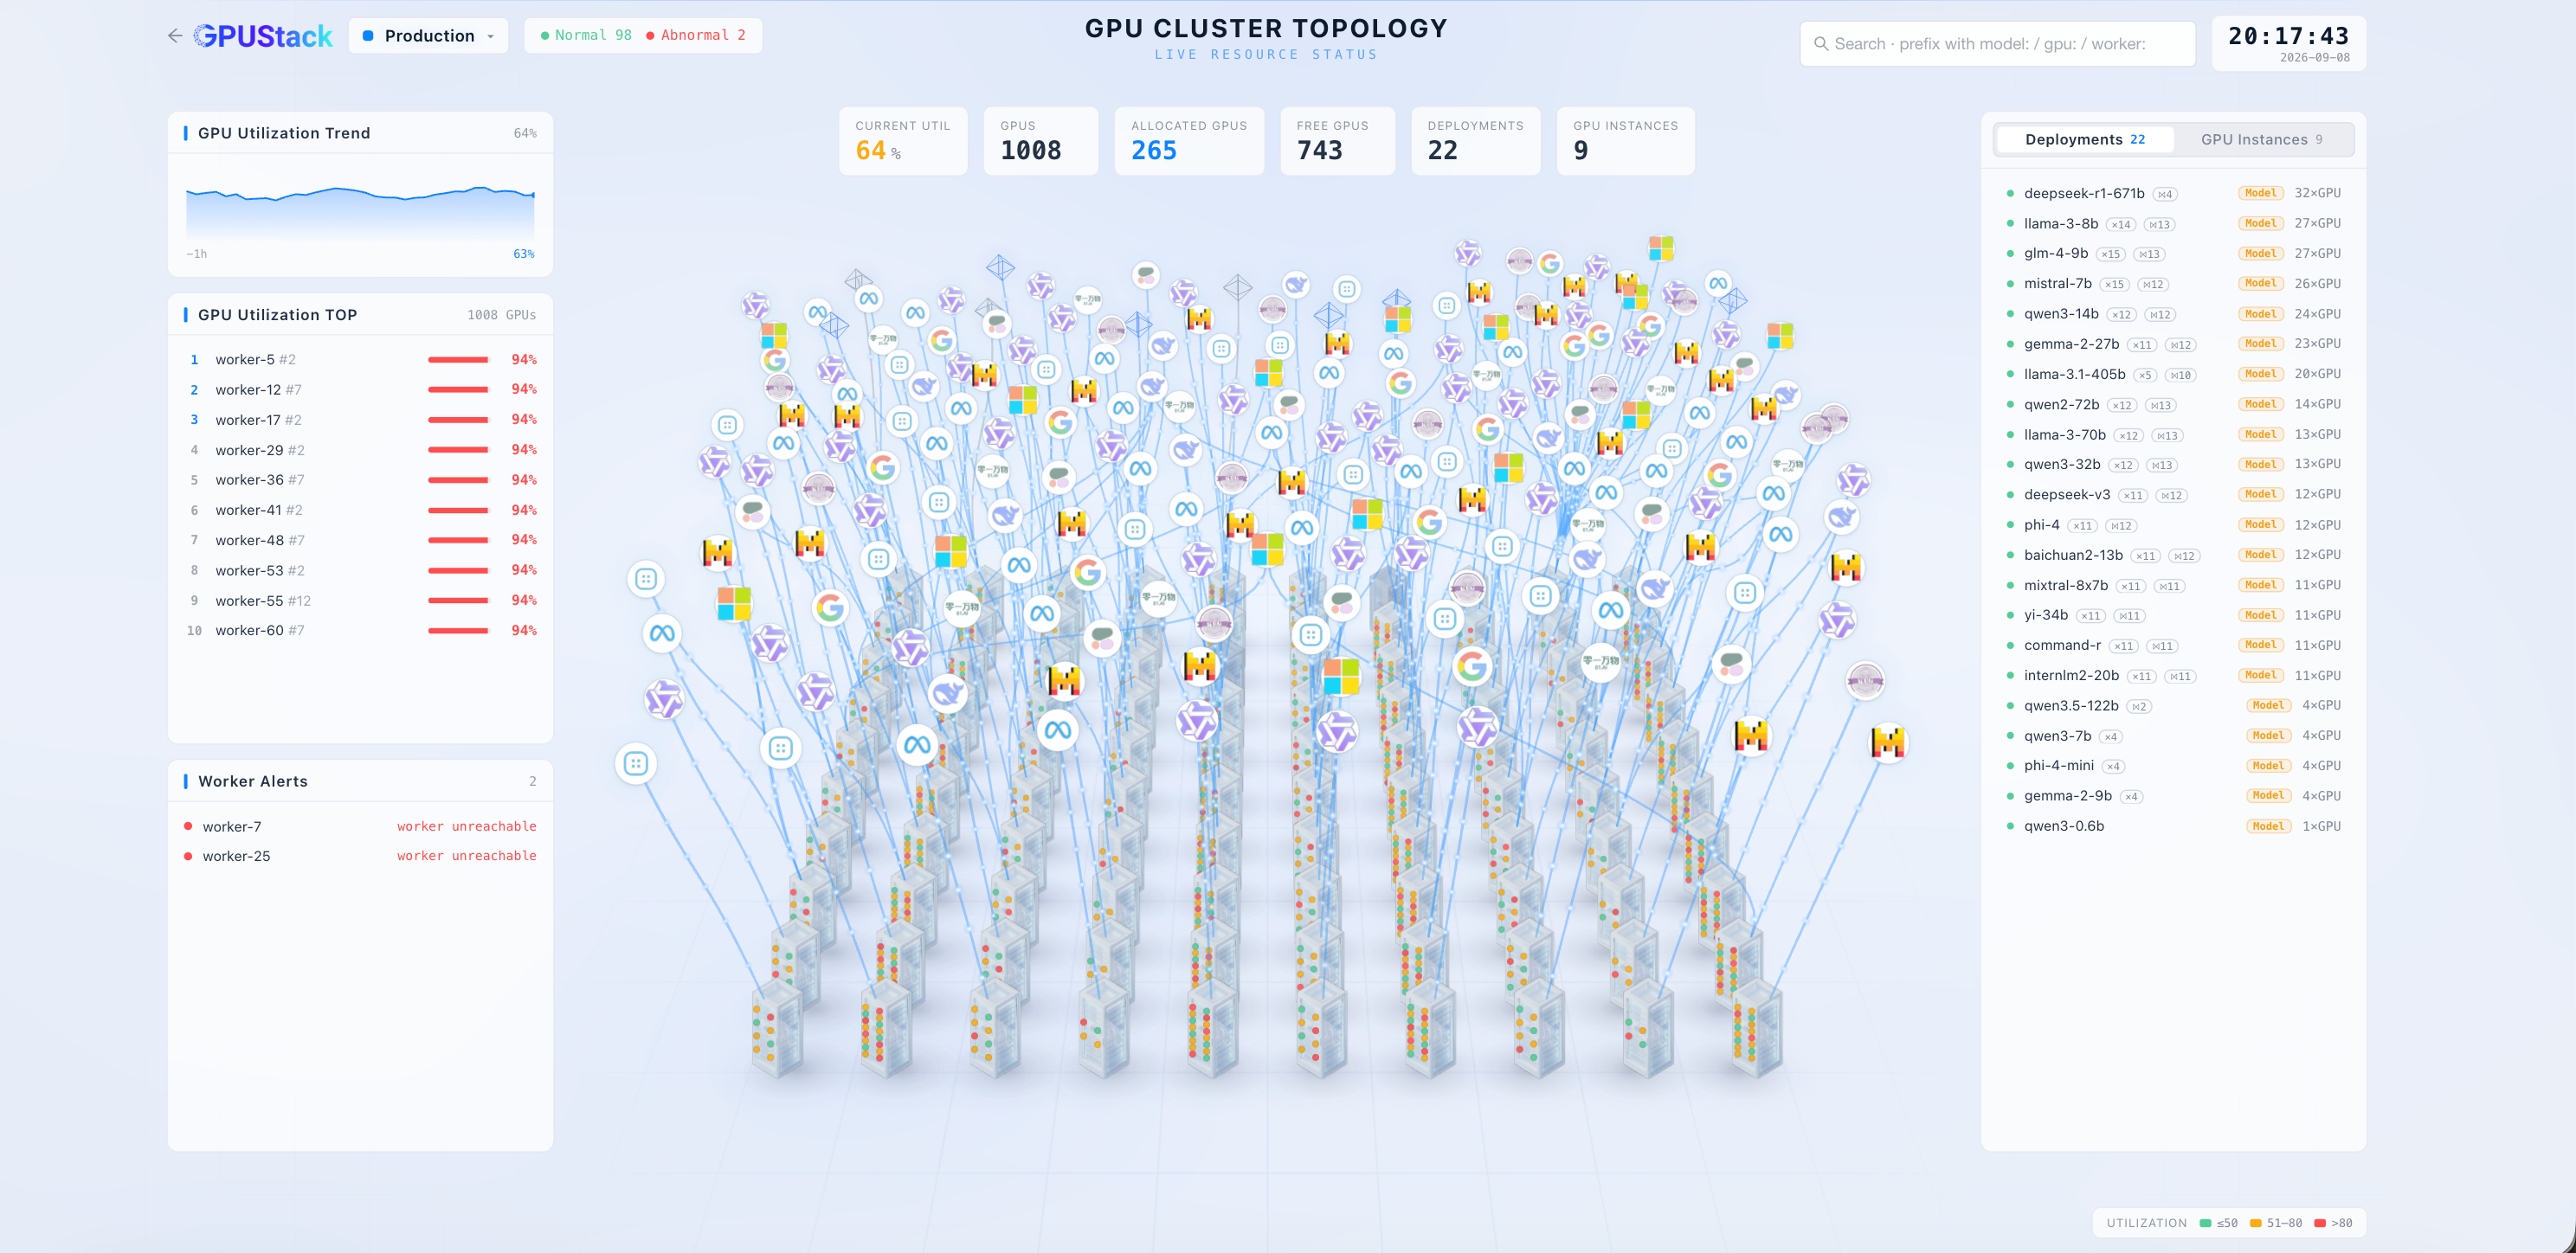
Представление топологии кластера графических процессоров в GPUStack Enterprise обеспечивает в реальном времени общий вид всего вашего парка — каждый работник, графический процессор и модель развертываются в одном месте, с данными об использовании, распределении и состоянии работоспособности в реальном времени.
Оптимизированная производительность вывода
Автоматический выбор механизма и оптимизация параметров GPUStack обеспечивают высокую производительность вывода без дополнительной настройки. На следующем рисунке показано улучшение пропускной способности по сравнению с конфигурациями vLLM по умолчанию:
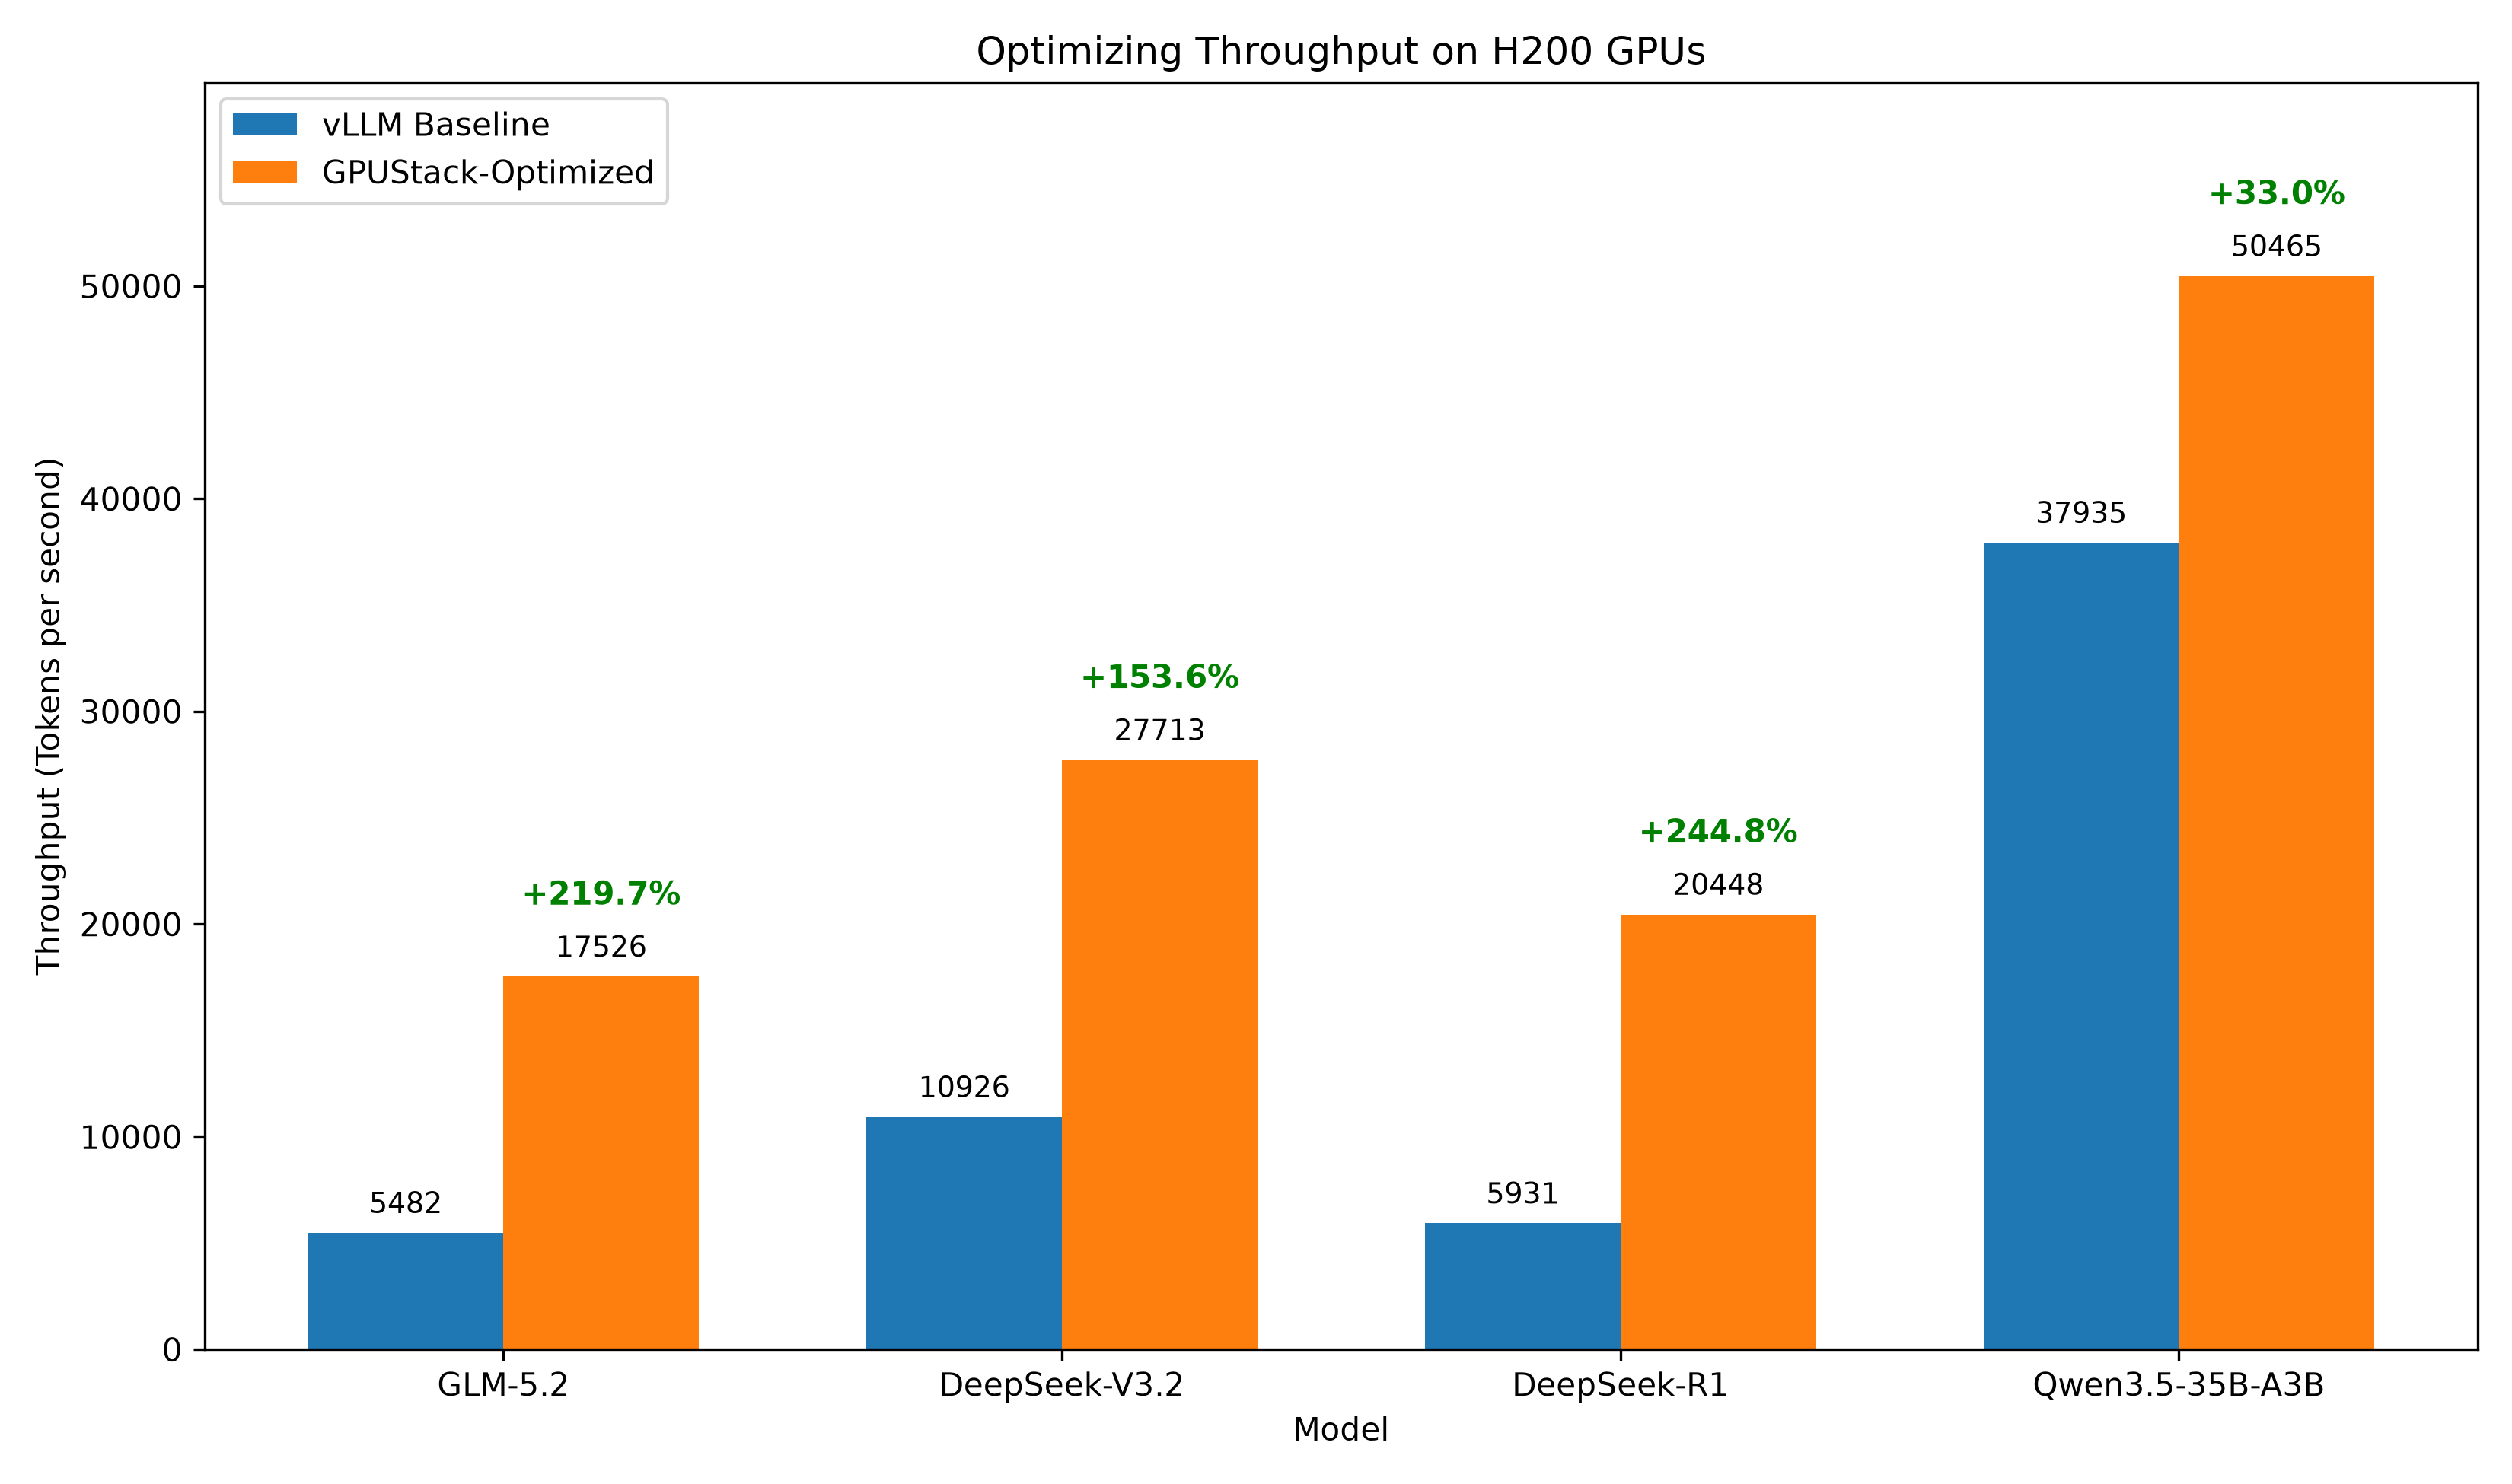
Подробные методы и результаты сравнительного анализа можно найти в нашей Лаборатории производительности вывода.
Поддерживаемые ускорители
GPUStack поддерживает широкий спектр ускорителей для вывода ИИ:
Подробные требования и инструкции по настройке см. в документации Требования к установке.