Архитектура
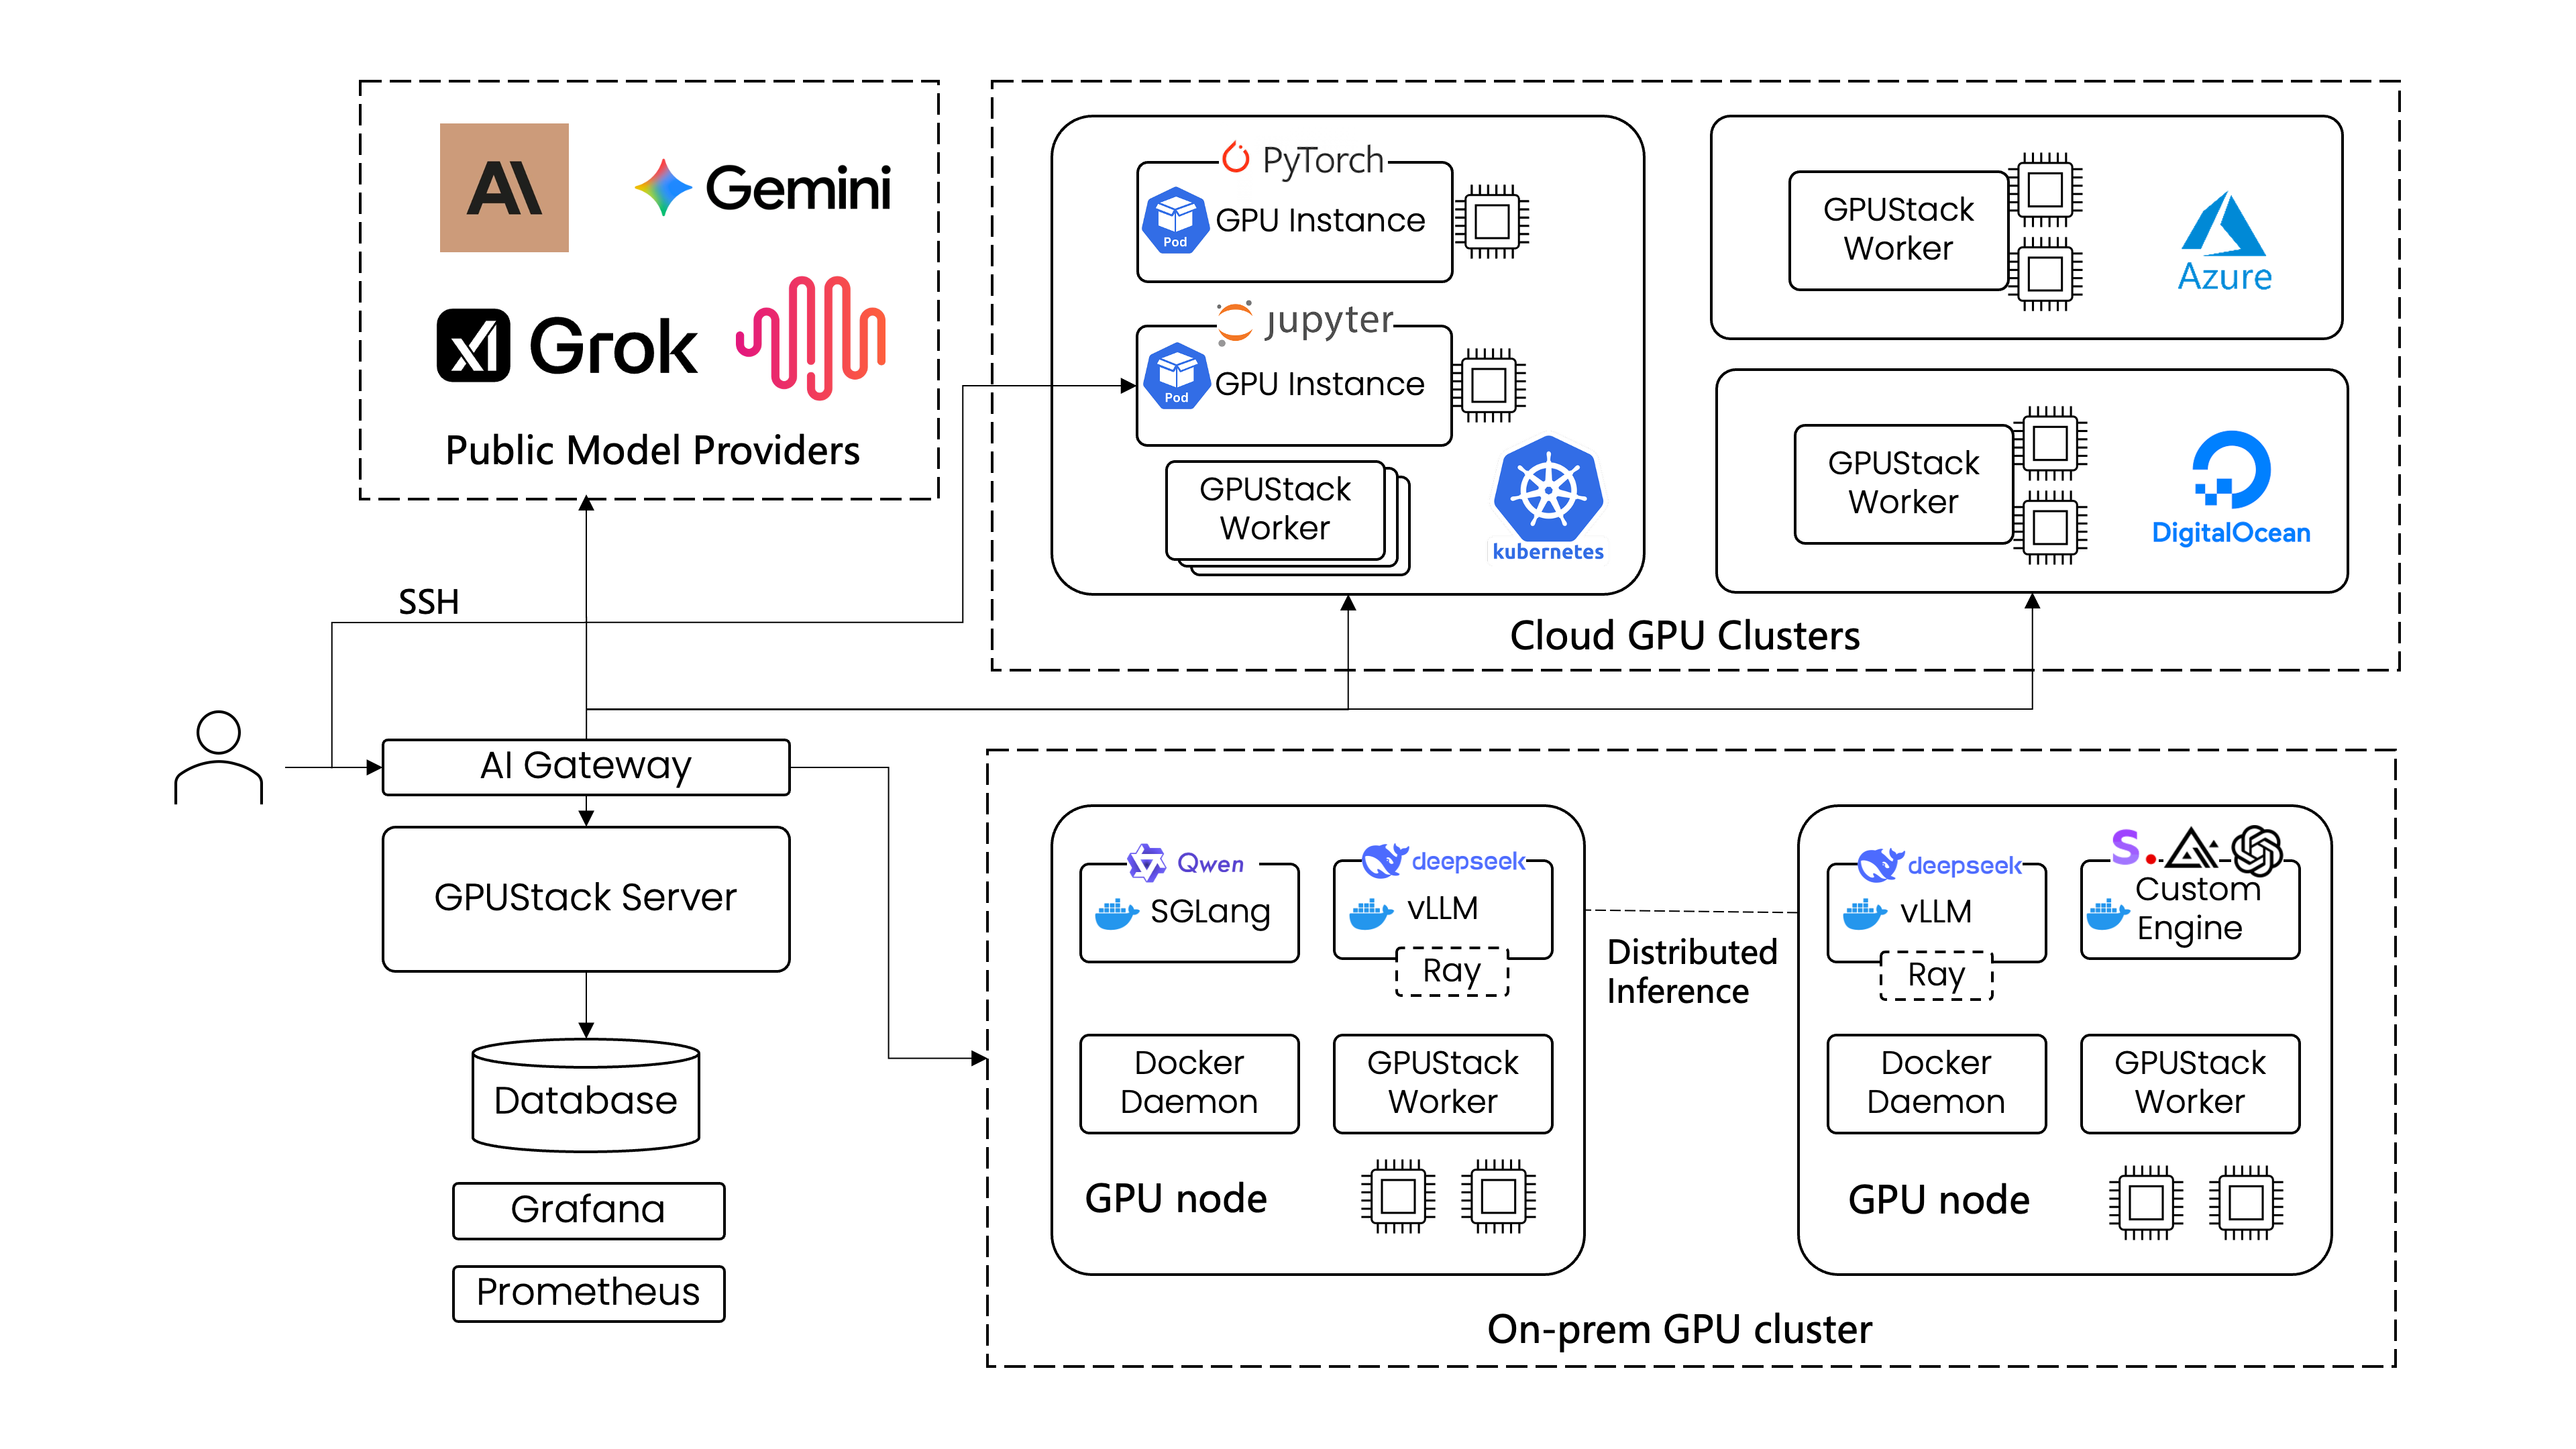
На диаграмме ниже представлено общее представление архитектуры GPUStack.
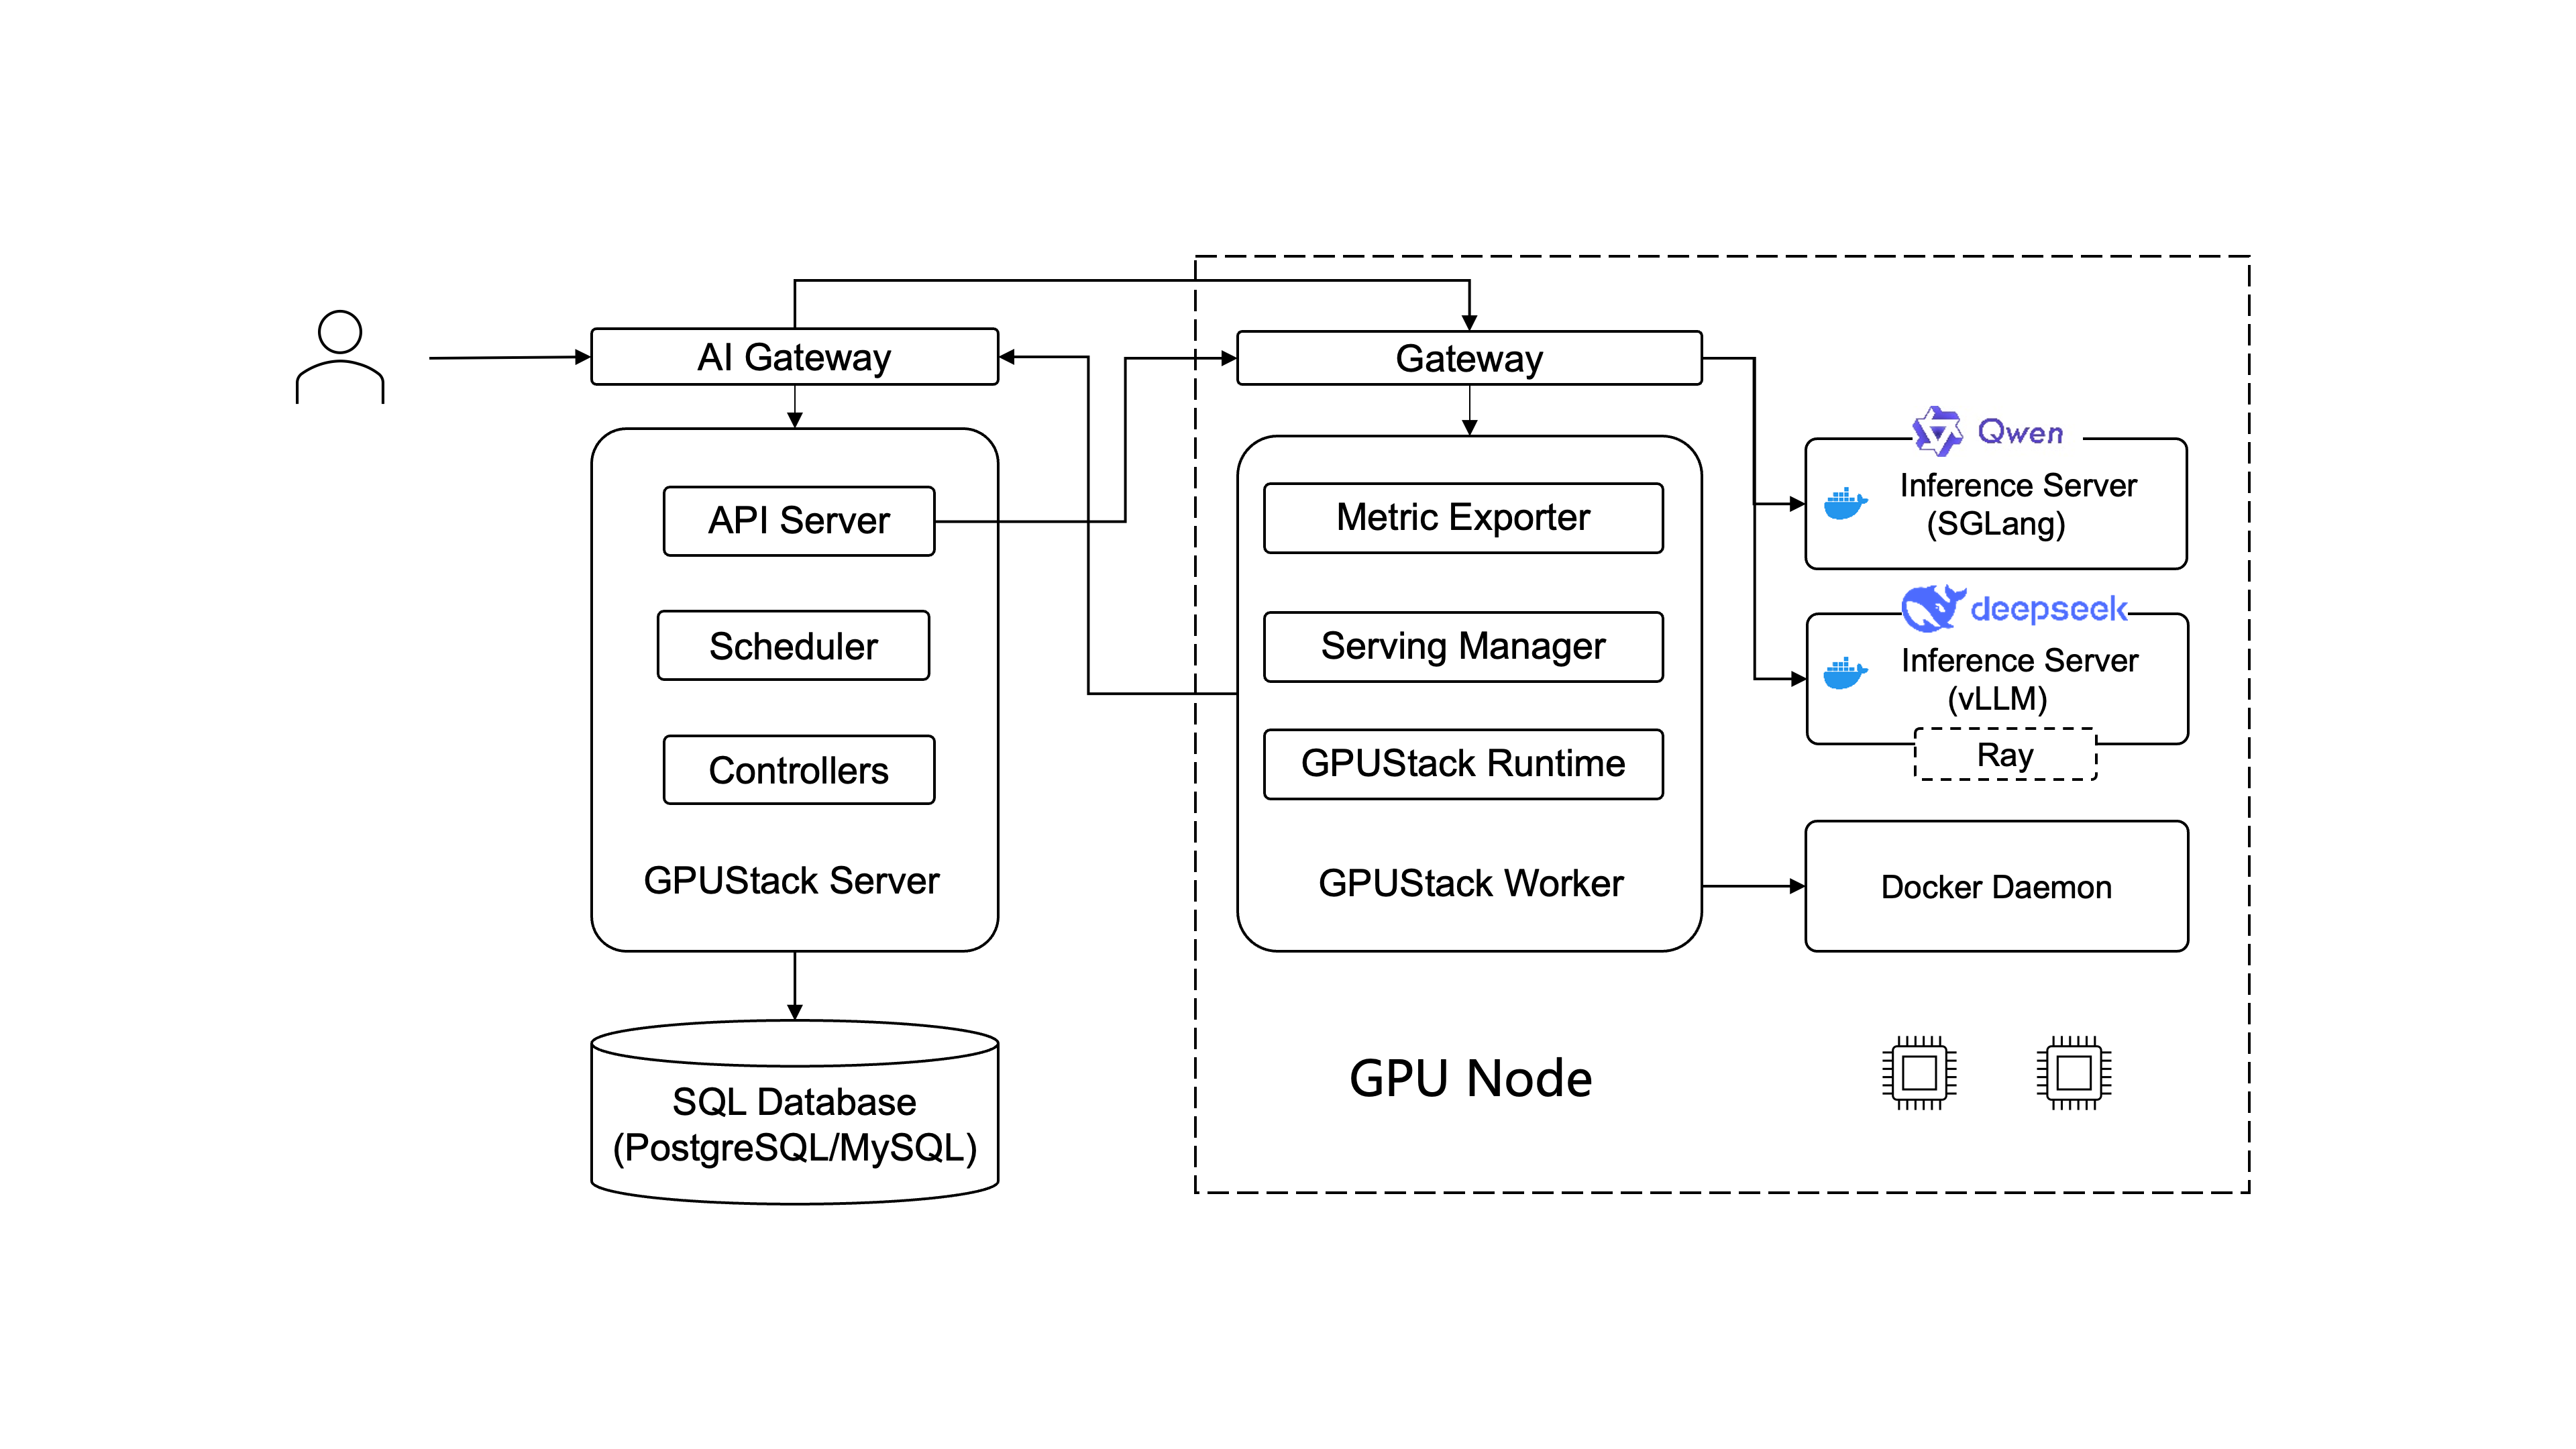
На схеме ниже подробно описаны внутренние компоненты и их взаимодействие.
Сервер
Сервер GPUStack состоит из следующих компонентов:
- API-сервер: Предоставляет интерфейс RESTful для взаимодействия клиентов с системой. Он обрабатывает аутентификацию и авторизацию.
- Планировщик: Отвечает за назначение экземпляров модели работникам.
- Контроллеры: Управляет состоянием ресурсов в системе. Например, они занимаются развертыванием и масштабированием экземпляров модели для соответствия желаемому количеству реплик.
Рабочий
Рабочий GPUStack состоит из следующих компонентов:
- GPUStack Runtime: Обнаруживает устройства графического процессора и взаимодействует со средой выполнения контейнера для развертывания экземпляров модели.
- Менеджер обслуживания: Управляет жизненным циклом экземпляров модели на воркере.
- Экспортер метрик: Экспортирует метрики об экземплярах модели и их производительности.
AI-шлюз
AI Gateway обрабатывает входящие запросы API от клиентов. Он направляет запросы к соответствующим экземплярам модели на основе запрошенной модели. GPUStack использует Higress для маршрутизации API и балансировки нагрузки.
База данных SQL.
Сервер GPUStack подключается к базе данных SQL в качестве хранилища данных. GPUStack по умолчанию использует встроенный PostgreSQL, но вы также можете настроить его на использование внешней базы данных. См. Требования к базе данных для получения списка совместимых баз данных и проверенных версий.
Сервер вывода
Серверы вывода — это серверы, выполняющие задачи вывода. GPUStack поддерживает vLLM, SGLang, Ascend MindIE и VoxBox в качестве встроенного сервера вывода. Вы также можете добавить собственные механизмы вывода.
Ray
Ray — это среда распределенных вычислений, которую GPUStack использует для запуска распределенного vLLM. GPUStack загружает кластер Ray по требованию для запуска распределенного vLLM среди нескольких рабочих процессов.