GPU サービスインスタンス
GPU サービスインスタンスでは、SSH でアクセスできる GPU インスタンスを数分で起動できます。
単一または複数のデバイスを備えた、仮想マシンに似た環境を、学習、推論、テスト、ファインチューニングなどのタスクに利用できます。
各 GPU サービスインスタンスの基盤は Kubernetes Pod なので、GPU インスタンスと CPU 専用インスタンスを組み合わせると、マシン全体(VM またはベアメタル)のリソース利用率を向上できます。
GPUStack は複数の Kubernetes クラスターを管理し、どのクラスターにも GPU サービスインスタンスを起動できる、統一されたインターフェースを提供します。
GPUStack 2.2 からアップグレードする場合
GPUStack 2.3 には最新の GPUStack Operator が同梱され、インプレースアップグレード自体を調整します。Worker Deployment は重複実行ではなく置き換え(Recreate)で更新され、Worker の起動猶予は 900 秒となり、v0.5.x が残したアプリケーション単位の従来の Helm Release を引き継ぎます。
アップグレード後の Worker が正常になったら、Operator のクリーンアップスクリプトで、所有者のなくなった v0.5.x のスケジューリングオブジェクトを削除してください。
以前のアップグレード試行ですでに停止している場合(Kueue CRD が Terminating のまま、Worker が Ready にならない場合)は、Operator の移行のトラブルシューティングを参照してください。完全な手順は、Operator の移行ガイドに従ってください。
前提条件
GPU サービスインスタンスを使用するには、Kubernetes クラスターが 1 つ以上必要です。
クラスターを追加していない状態で、初めて GPU Service > GPU Instances ページを開くと、追加を求められます。
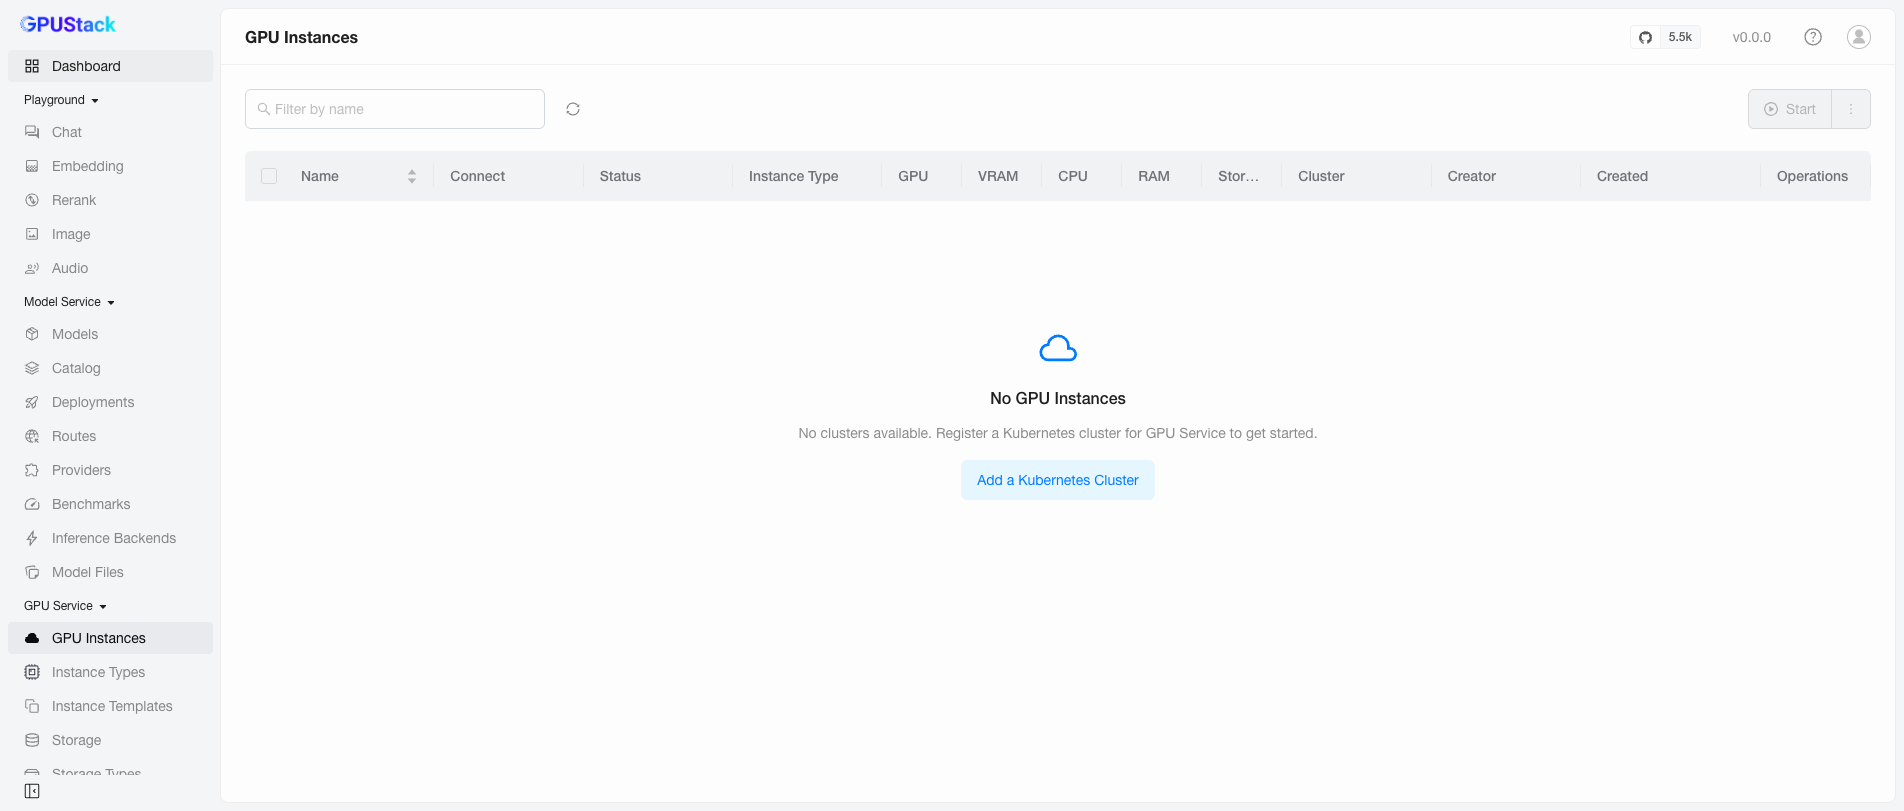
Add a Kubernetes Cluster をクリックして、Resources > Clusters ページに移動します。
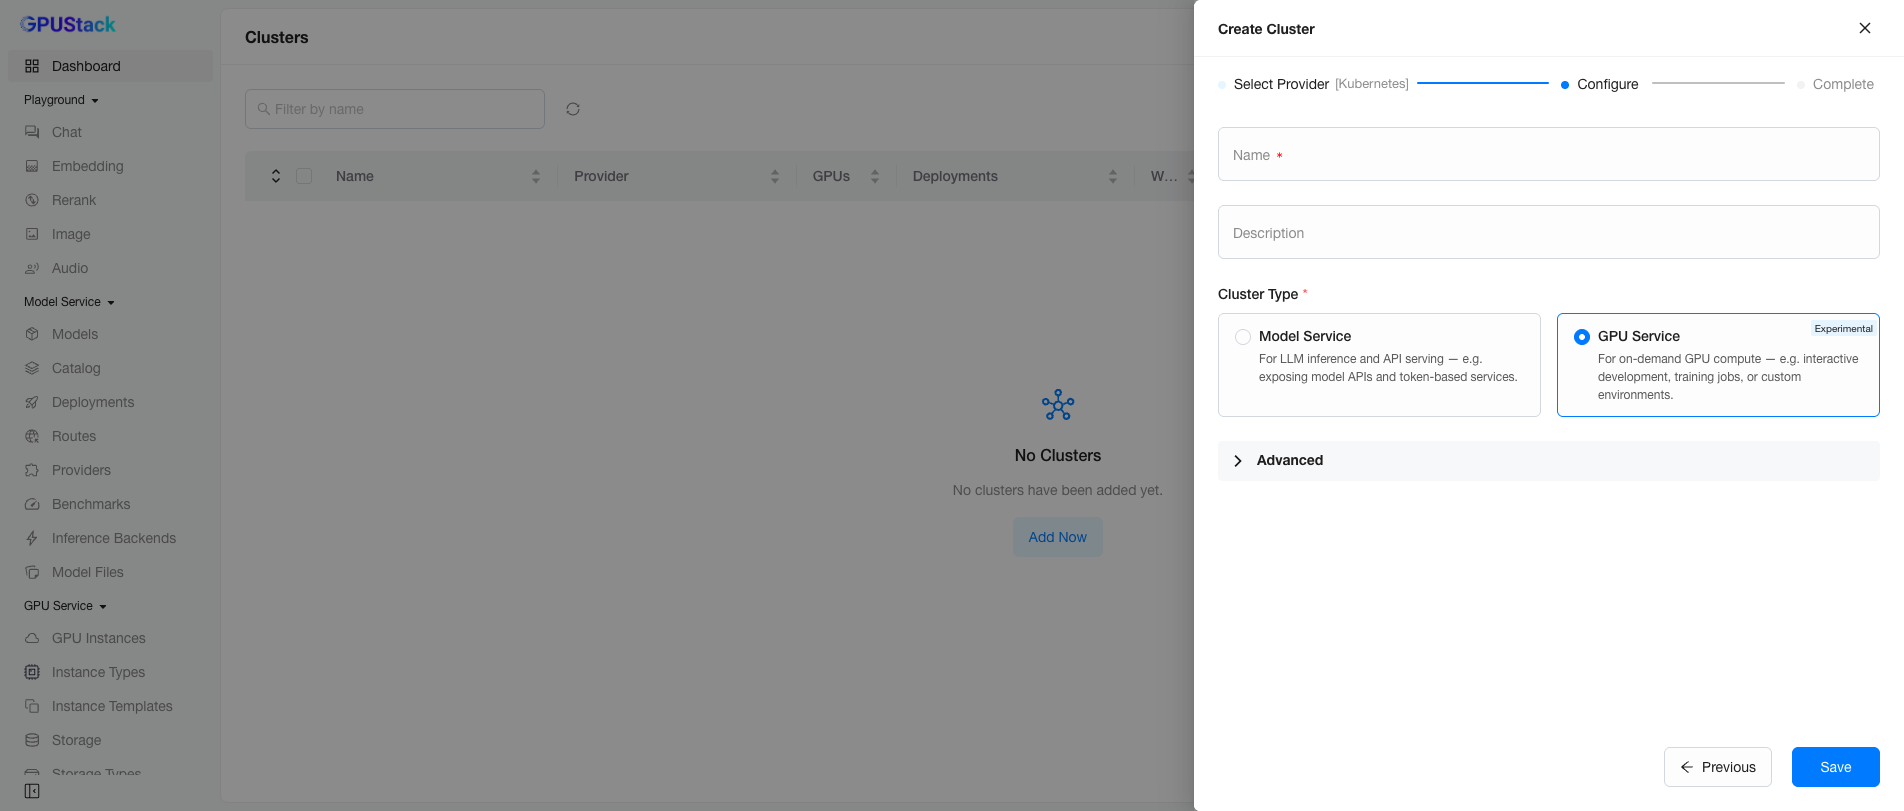
クラスター作成ウィザードは、Select Provider(Kubernetes を選択)→ Configure → Complete の順に進みます。Configure でクラスターの Name と任意の Description を入力し、Cluster Type に GPU Service を選択して、Save をクリックします。
警告
Kubernetes クラスターの用途は、Model Service または GPU Service のいずれか 1 つだけにできます。
高度なオプション
GPU Service 用のクラスターを追加する際は、Advanced を展開して、追加の設定を構成できます。
ノードからのインスタンスタイプの導出
既定で有効です。Operator は各ノードのデバイスを検出し、製品別の単位 CPU/RAM プリセットに基づいて、アクセラレーターモデルごとのタイプと CPU 専用タイプを自動的に導出します。すべてのインスタンスタイプを自分で定義する場合は、Disabled に設定してください。Operator はタイプの作成を停止し、導出タイプを完全に削除できるようになります。

導出タイプの管理については、GPU サービスのインスタンスタイプを参照してください。
ノード上での異なるインスタンスタイプの混在を許可する
既定で有効です。同じノードで異なるインスタンスタイプを同時に提供できます。たとえば GPU ノードで、GPU インスタンスと CPU 専用インスタンスを同時にホストできます。各ノードを単一のタイプ専用にするには、Disabled に設定します。

GPU サービスインスタンスへのアクセスを許可する
通常、すべての Kubernetes ノードは NAT またはファイアウォールの内側にあるため、ノードの IP にクラスター外からアクセスできない場合があります。
この場合は、GPU Service Static Access Address に LoadBalancer VIP などのアドレスを設定し、GPU サービスインスタンスにアクセスできるようにします。
GPUStack Worker にアクセスできることを確認する
GPU サービスは、インスタンスの作成、削除、監視などの管理のために、通常は Kubernetes クラスターへ(逆方向に)アクセスする必要があります。
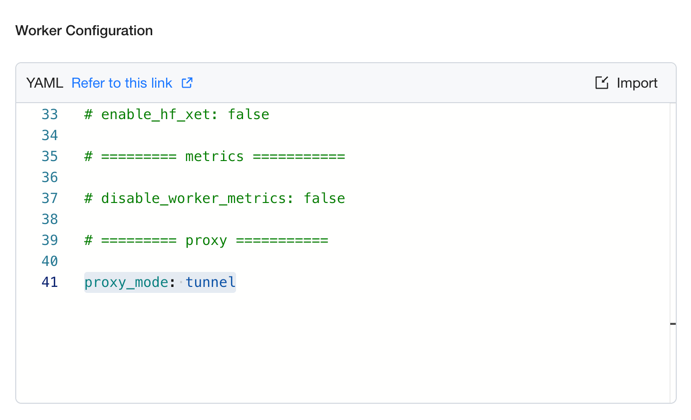
GPUStack Server を Kubernetes クラスターの外にデプロイしている場合は、Worker Configuration で proxy_mode=tunnel を設定し、GPUStack Worker のトンネルモードを有効にします。Worker から GPUStack Server への持続的な接続を維持し、GPU サービスがクラスターにアクセスするためのトンネルを提供します。
Resources > Workers ページで、Worker の Status 列を確認すると、GPUStack Server と Worker 間の接続性を確認できます。
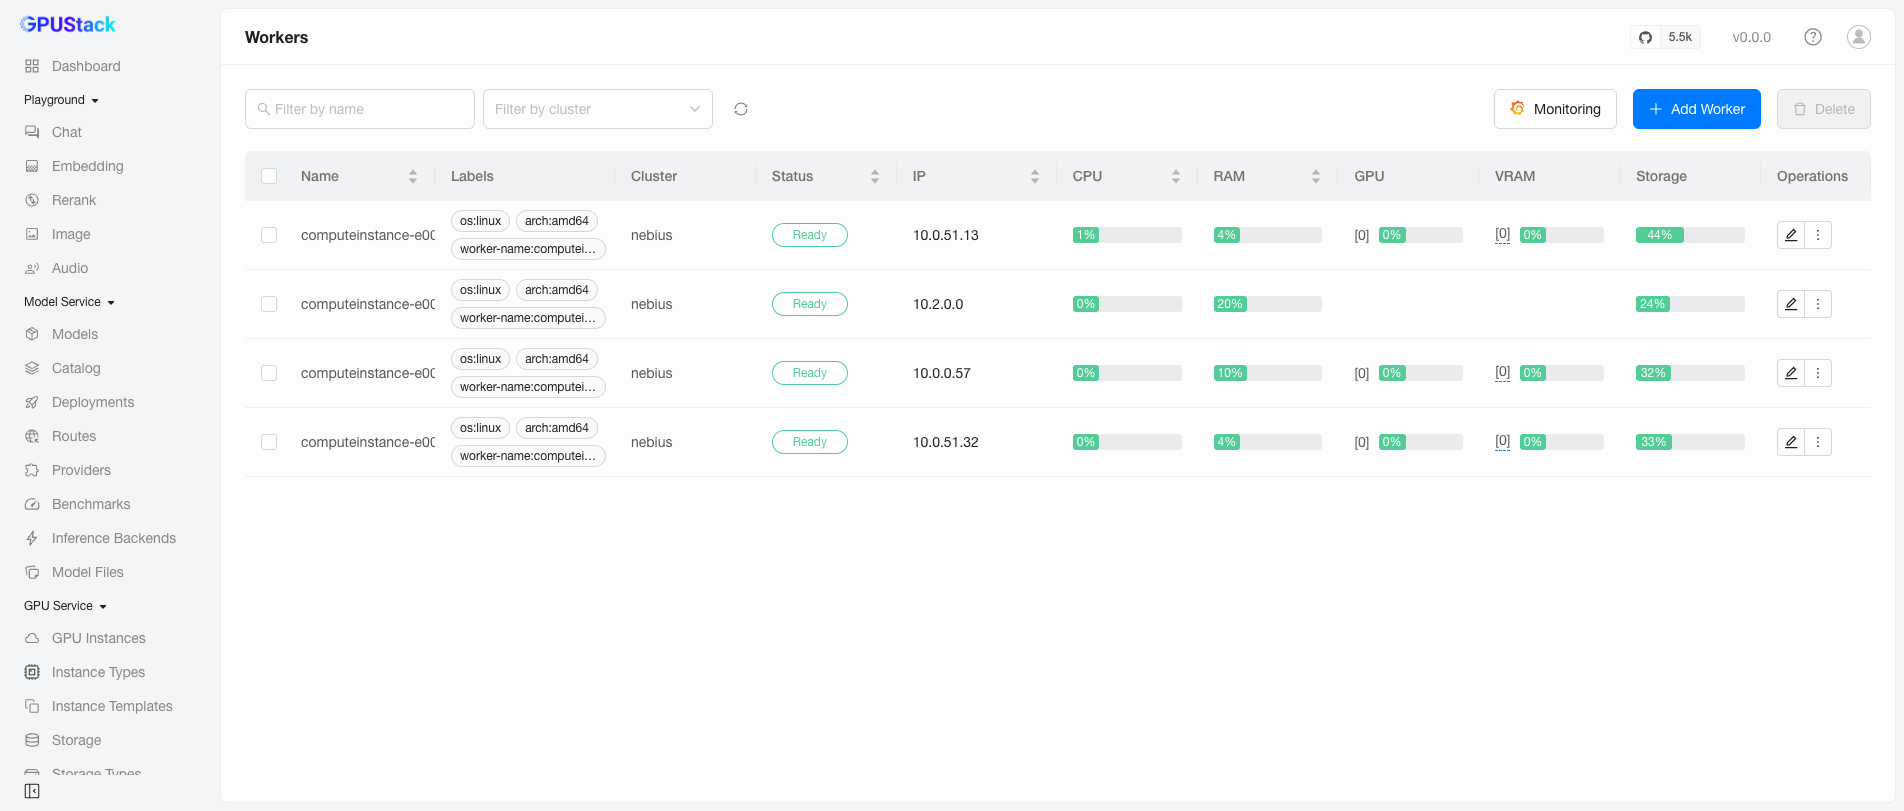
インスタンスタイプの自動検出
GPU Service を有効にした Kubernetes クラスターを追加すると、GPUStack Operator がクラスター内の GPU デバイスを自動検出し、情報を収集して、GPU サービス用のインスタンスタイプを生成します。
タイプの管理については、GPU サービスのインスタンスタイプを参照してください。以降では、インスタンスのデプロイと管理について説明します。
インスタンスの追加
GPU Service > GPU Instances ページで Add GPU Instance をクリックして、作成フォームを開きます。
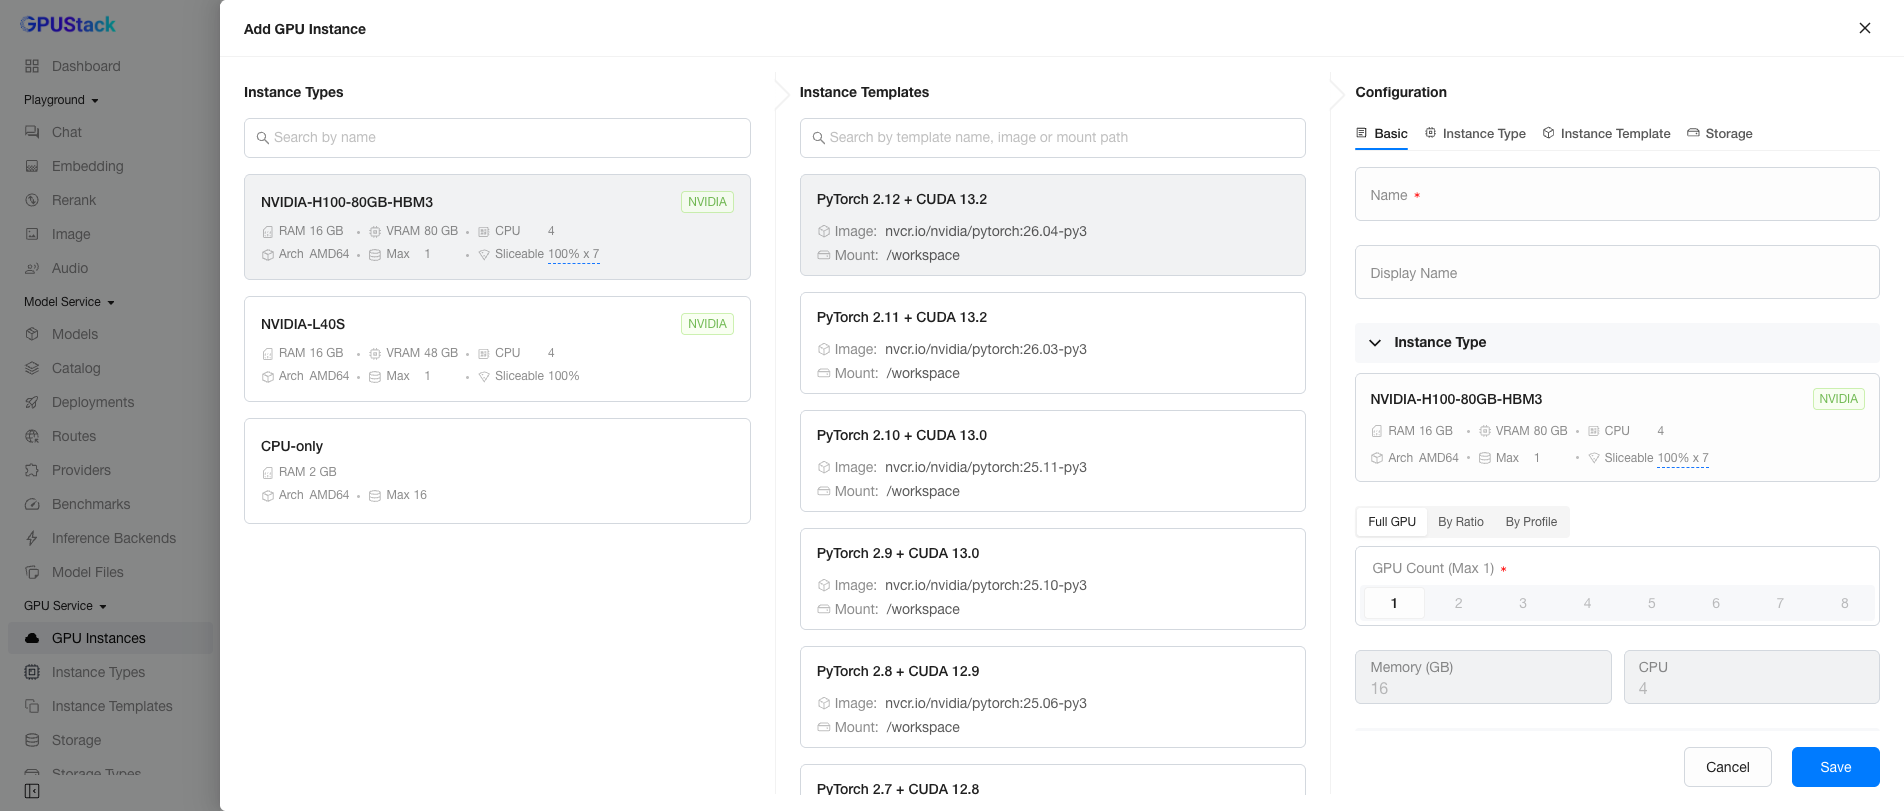
インスタンスタイプの選択
左端の Instance Types 列には、Kubernetes クラスターから検出されたすべてのインスタンスタイプが表示されます。
各タイプのカードには、次の情報が表示されます。
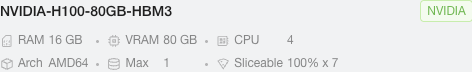
- 名前:
NVIDIA-H100-80GB-HBM3などの製品名。特殊文字を含む製品名は、Kubernetes の規則に適合するように変換します。 - メーカー / ベンダー:右上のラベルにメーカーまたはベンダーを表示します(
NVIDIA、CPU 専用のGENERICなど)。 - RAM / VRAM / CPU:タイプの 1 単位あたりに付与するホスト RAM、デバイスメモリ容量、CPU コア。
- Arch:
AMD64またはARM64などの CPU アーキテクチャ。互換性のあるイメージの選択に役立ちます。 - Max:一度に選択できるデバイスの最大数。Max が 0 の場合、そのタイプのデバイスはすべて割り当て済みで、一部が解放されるまで選択できません。
- Sliceable:このタイプのデバイスの分割方法。論理スライスの残り枠(割合)と、パーティション対応デバイスでは残りハードウェアパーティション数を表示します。
インスタンスタイプの単位リソース
単位リソースは、タイプの 1 単位に付与するホスト CPU と RAM です。アクセラレータータイプではデバイス全体あたりの値です。ノードから導出するタイプは、Operator が管理する製品別のプリセットに基づきます(単位リソースのリファレンスを参照)。論理スライスや物理パーティションのサイズは、その VRAM の割合に応じてプリセットから決まります。単位リソースをカスタマイズして、独自のタイプを定義することもできます。
デバイス全体、スライス、パーティションの選択
アクセラレータータイプでは、Configuration パネルに最大 3 つの割り当てモードが表示されます。
- Full GPU — デバイス全体を排他的に使用します。
- By Ratio — 論理スライス。
VRAM PercentageとCompute Percentageを選択します。デバイスは全体のまま複数のスライスを同時に提供し、それぞれの枠が実行時に制限されます。
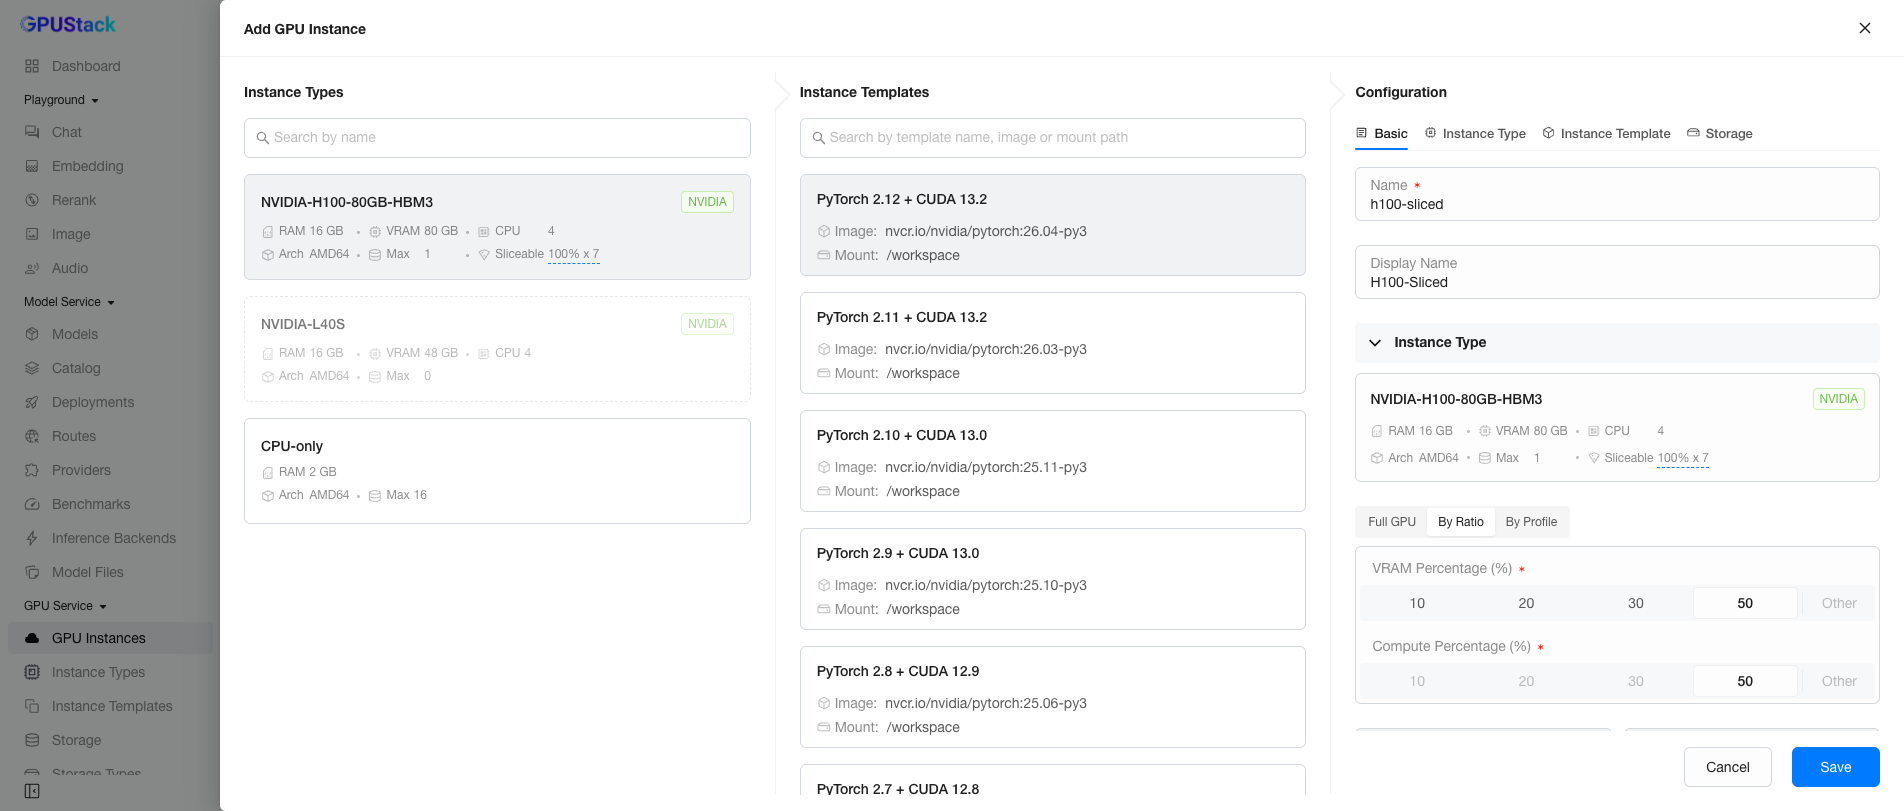
- By Profile — MIG が有効なデバイスの物理パーティション。
Partition Profile(H100 の1g.10gbなど)を選択すると、Operator が MIG インスタンスを作成します。このタブは、クラスター内のノードで MIG が有効な場合だけ表示されます。MIG の有効化はノード単位の管理者操作です。GPU サービスのインスタンスタイプを参照してください。
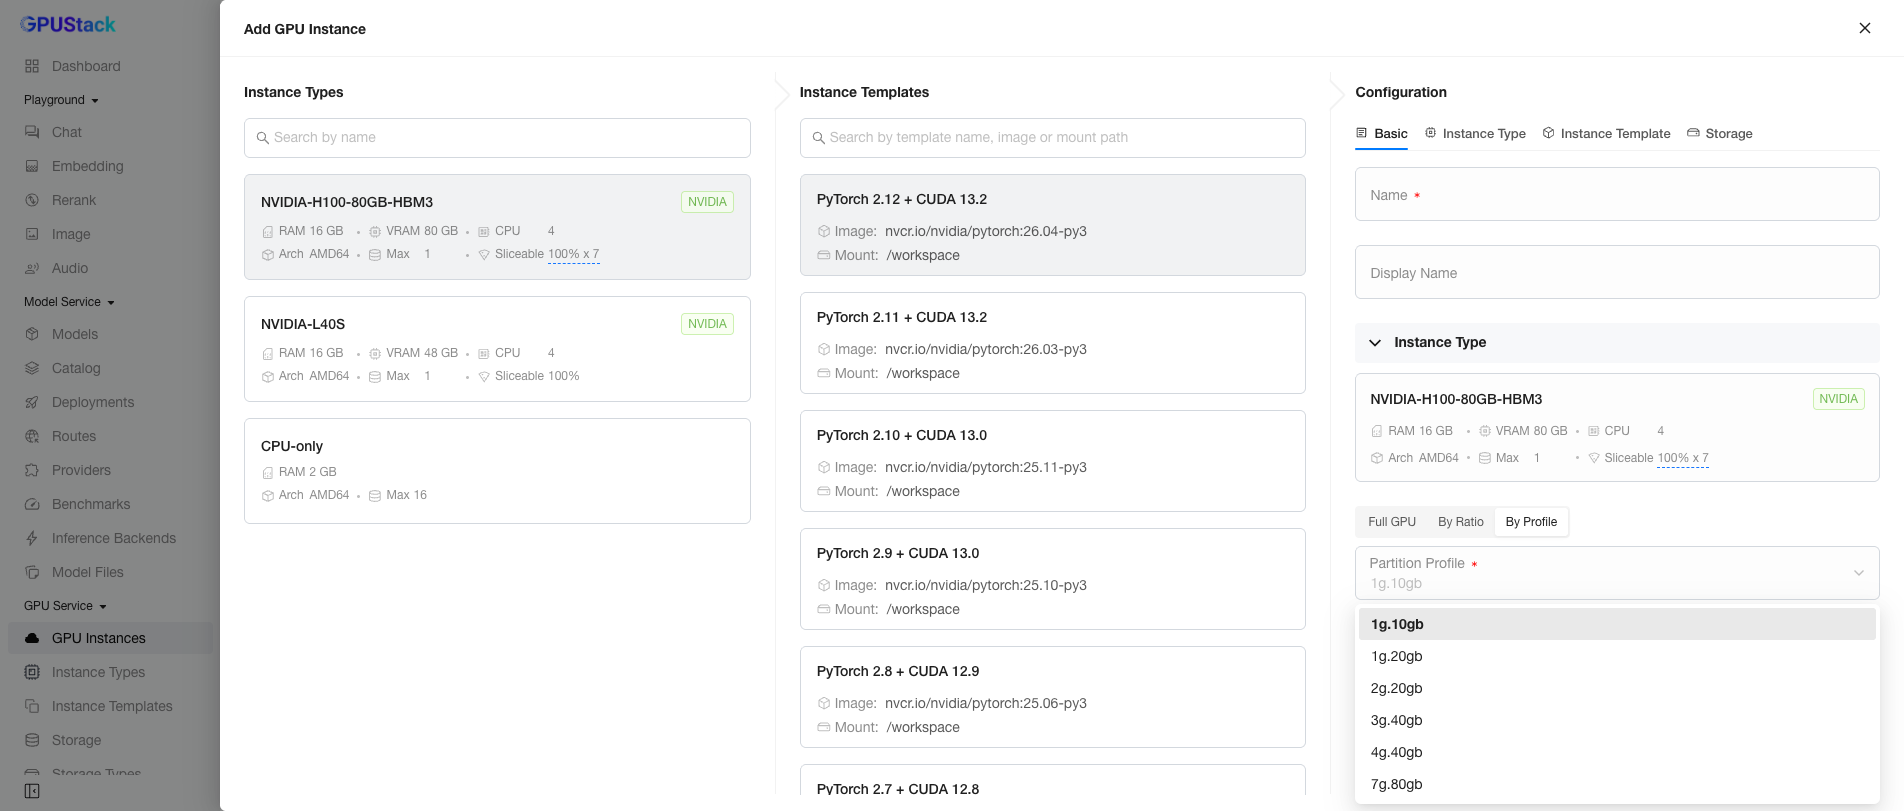
CPU 専用インスタンスタイプ
全体のリソース利用率を高めるため、GPU サービスは CPU 専用インスタンスタイプにも対応しています。
GPUStack Operator は、初期状態では CPU 専用タイプに固定の 1 CPU + 2 GB RAM プロファイルを提供します。カスタマイズについては、GPU サービスのインスタンスタイプを参照してください。
インスタンステンプレートの選択
中央の Instance Templates 列には利用可能なテンプレートが表示され、選択するインスタンスタイプに応じて一覧が更新されます。
テンプレートは GPU Service > Instance Templates ページで管理します。GPU サービスのインスタンステンプレートを参照してください。
インスタンスの構成
右端の Configuration フォームで、新しいインスタンスの詳細を設定します。Basic、Instance Type、Instance Template、Storage、SSH Access の 5 つのセクションに分かれています。
- 基本:インスタンス名と表示名。
- インスタンスタイプ:タイプと割り当てモード。デバイス全体、論理スライス、物理パーティションから選択します。
- インスタンステンプレート:イメージ、コマンド、環境変数などの継承元となるテンプレート。選択後も構成を調整できます。
- ストレージ:
Ephemeralストレージ、またはPersistentストレージ。 - SSH アクセス:インスタンスに割り当てる SSH 公開鍵、または SSH アクセスの無効化。
フォームの入力後、Save をクリックしてインスタンスを作成します。
インスタンスの閲覧
作成後は GPU Service > GPU Instances ページに戻ります。すべてのインスタンスが、Name(設定されている場合は表示名)、Connect、Status、Instance Type、GPU、VRAM、CPU、RAM、Storage、Cluster、Creator、Created、Operations などの列とともに一覧表示されます。
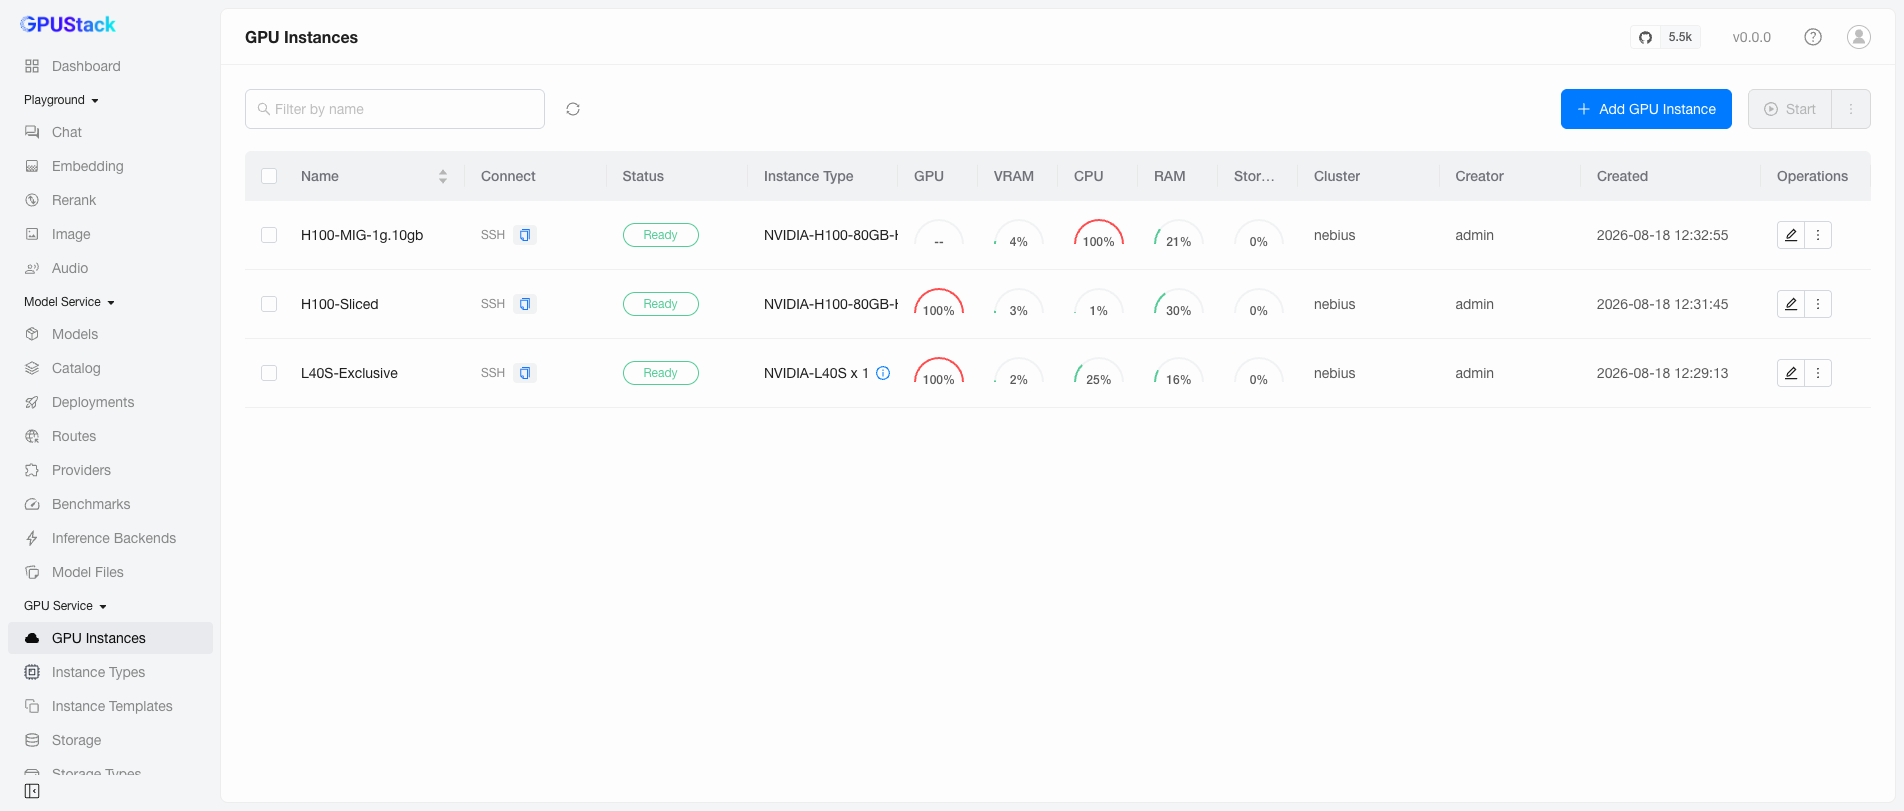
インスタンスは表示名または名前で絞り込めます。Name 列には、いずれかの値が表示されます。Name 列の並べ替えは、表示されているラベルに基づきます。
インスタンスへのアクセス
Connect 列には、ポート構成に応じて、コピーして使う SSH コマンドやクリック可能な Web ページのリンクなど、アクセス先のアドレスが表示されます。
たとえば、SSH コマンドをターミナルに貼り付けると、インスタンスに直接接続できます。
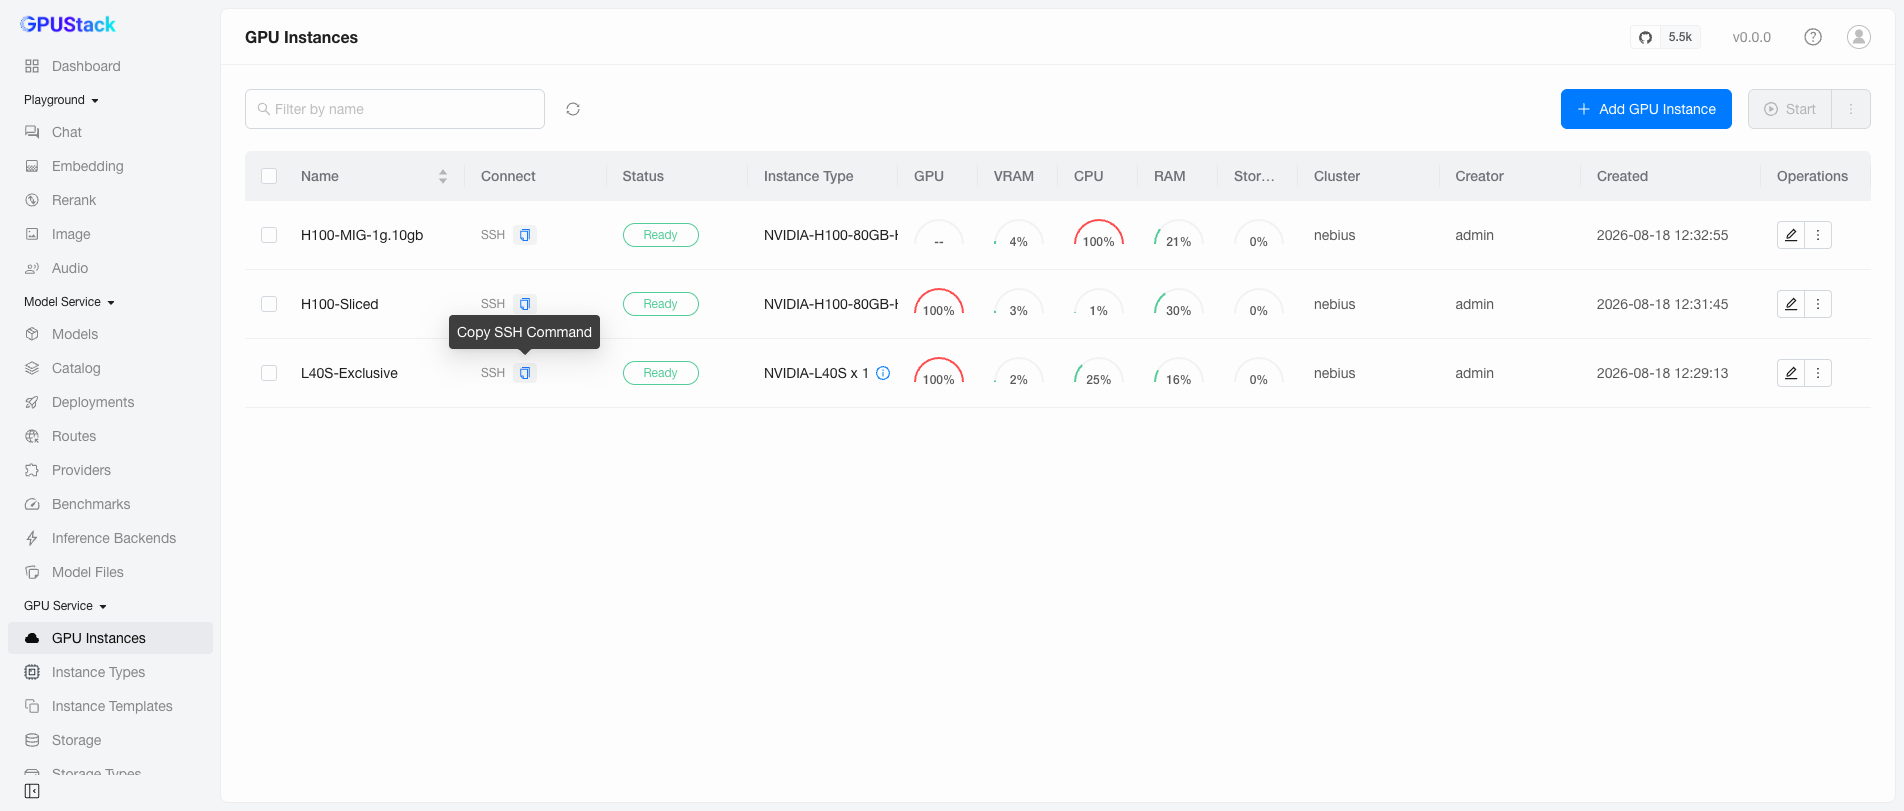
メトリクス
GPU、VRAM、CPU、RAM、Storage 列には、実行中の各インスタンスのリアルタイム利用率ゲージが表示され、ページの表示中は数秒ごとに更新されます。割り当てモードにかかわらず、各ゲージは、そのインスタンス自身の使用量を自身のクォータに対して表示します。排他インスタンスはデバイス全体、スライスはその持ち分、物理パーティションはそのパーティションの容量を基準にします。
測定できない値は、ゼロではなく空として表示します。たとえば MIG パーティションでは、ドライバーが GPU コア利用率を測定できないため、GPU ゲージは -- のままですが、VRAM ゲージは動作します。
値は、Operator のインスタンスメトリクスのサブリソースとノードエクスポーターから取得します。各フィールド、その取得元と制限については、インスタンスメトリクスのリファレンスを参照してください。
上記ゲージについて
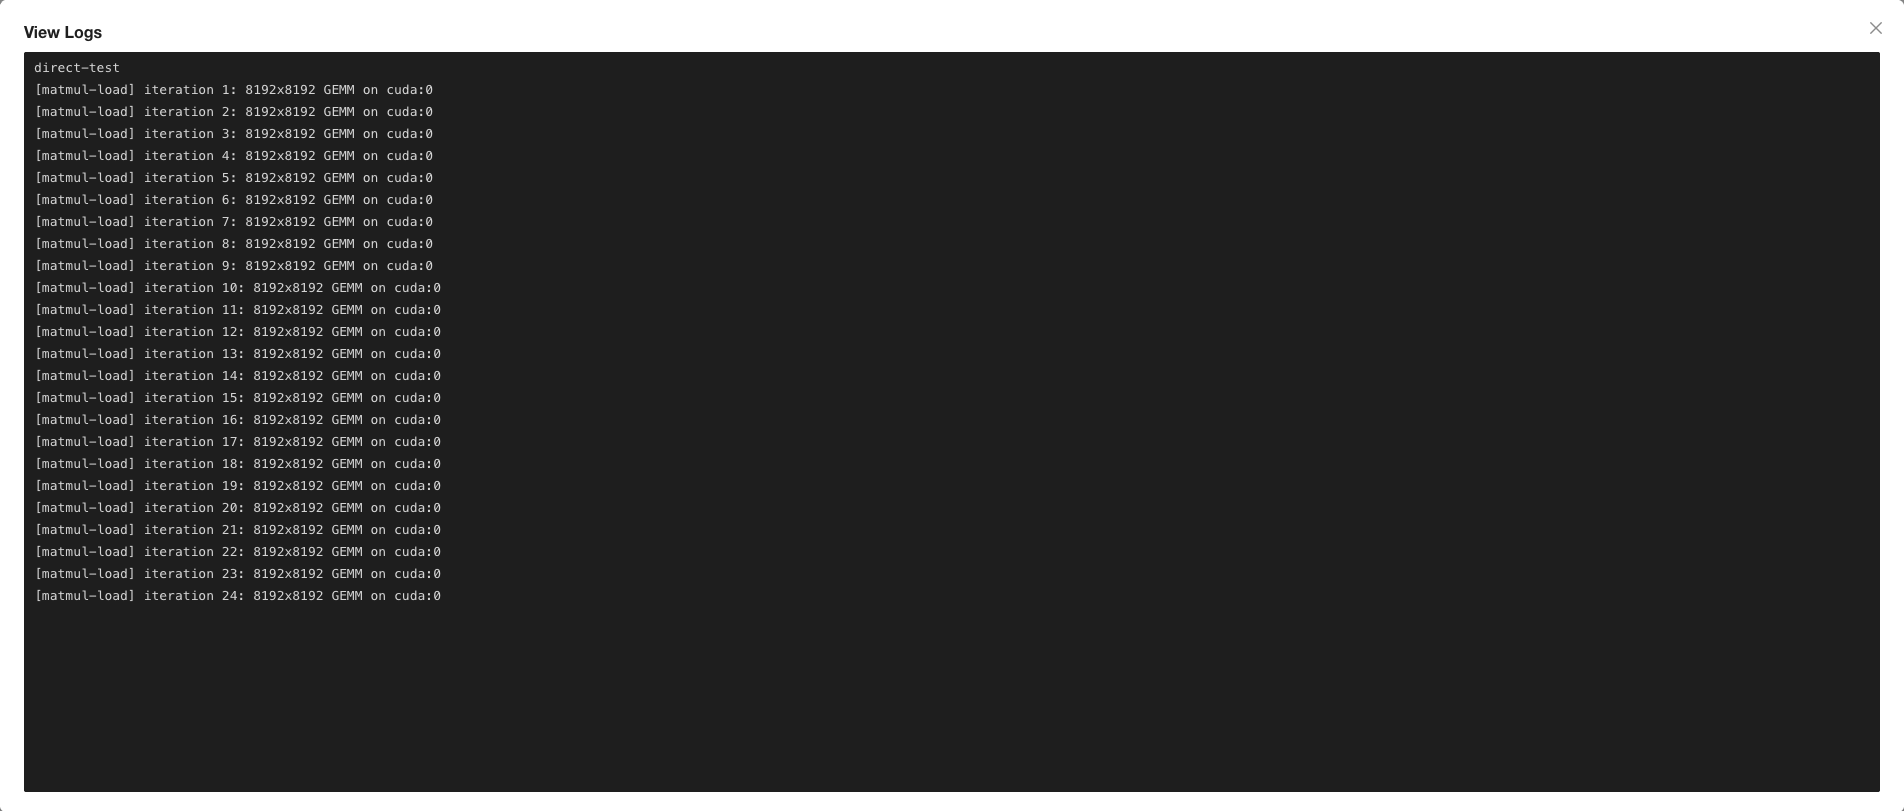
一覧のスクリーンショットには、人工的な負荷をかけた 3 つのデモインスタンスが表示されています。それぞれが Python/PyTorch のループでホスト RAM を確保し、デバイス上で 8192×8192 の行列乗算を繰り返しています(a = a @ a のループ)。そのため、排他の L40S と 50% スライスの H100 の GPU ゲージは 100% です(スライス自身の演算枠を使い切ると 100% となります)。また、MIG インスタンスの GPU ゲージは --、CPU は 100% を示しています。
インスタンスの編集
インスタンスの Edit をクリックして構成を開きます。
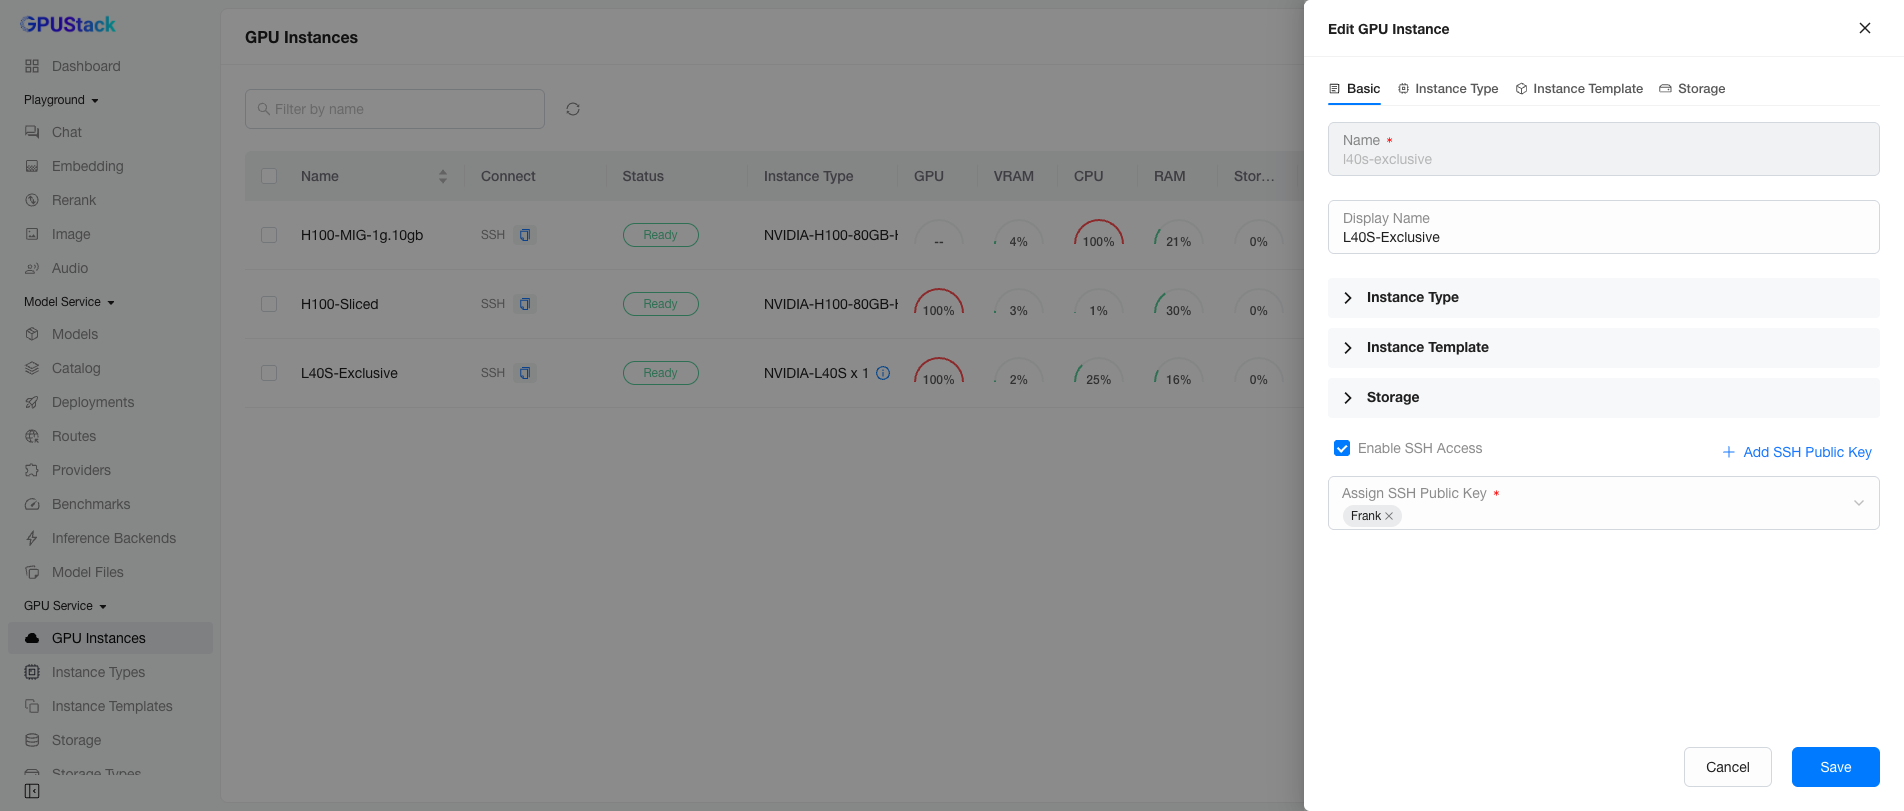
ほとんどの項目はまだ編集できません。変更できるのは表示名と SSH アクセスの構成だけです。SSH 公開鍵の追加や削除、SSH アクセスの無効化が可能です。
注記
インスタンス構成のその他の項目の編集は、今後のリリースで対応する予定です。
インスタンスの操作
GPU サービスは、ログ表示、イベント表示、停止と起動、削除などの操作を提供します。
ログの表示
View Logs をクリックすると、インスタンスのログを表示できます。Jupyter Notebook や TensorBoard などのアプリケーションの出力を確認する際に便利です。
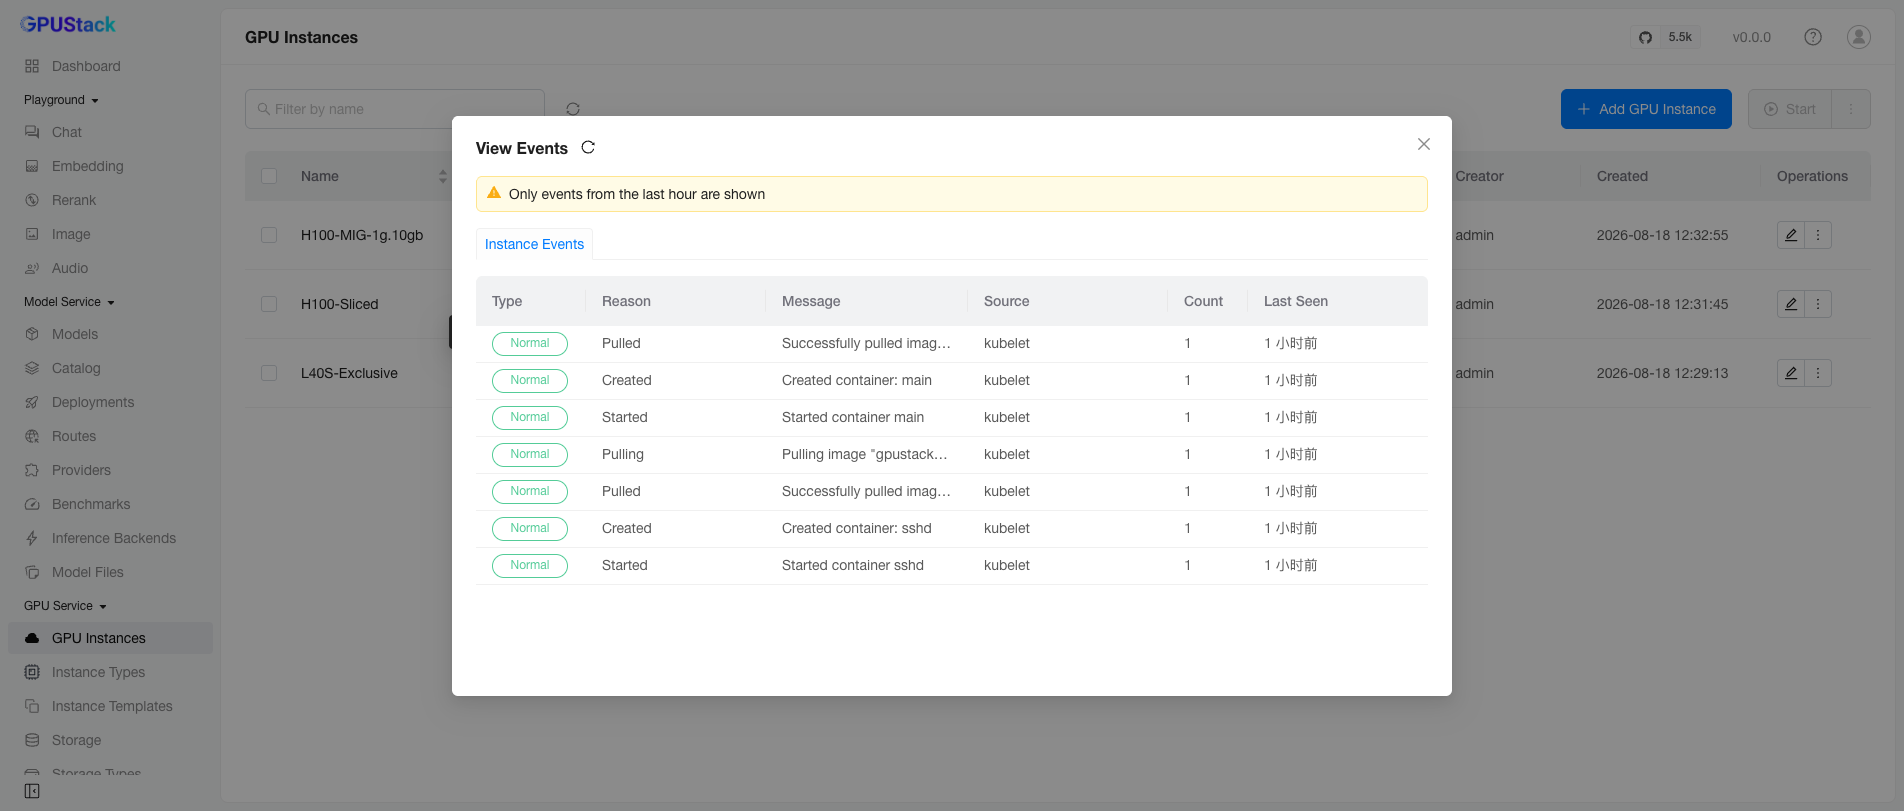
イベントの表示
View Events をクリックすると、インスタンスのイベントを表示できます。Pending、Running、Failed の状態で停止しているなど、状態の変化を追跡できます。
停止・起動・削除
Stop でインスタンスを停止し、Start で再開できます。一時的にリソースを解放し、後で作業を再開する場合に便利です。
警告
インスタンスを停止すると演算リソースが解放され、起動すると再作成されます。この際、新しい IP アドレスが割り当てられ、エフェメラルストレージ内のデータは失われます。
Delete をクリックすると、インスタンスを削除して、すべてのリソースを解放します。