

概要
GPUStack は、AI モデルサービングと GPU インスタンスのプロビジョニングのためのオープンソース GPU クラスターマネージャーです。vLLM、SGLang、TensorRT-LLM、独自の推論エンジンを構成・オーケストレーションし、SSH でアクセスできる GPU インスタンスをオンデマンドで起動できます。
-
複数 GPU クラスターの管理
オンプレミスサーバー、Kubernetes、クラウドプロバイダーにわたる GPU クラスターを管理します。モデルデプロイメントと GPU インスタンス向けの GPU 分割をサポートし、VRAM と計算リソースの配分を設定できます。
-
プラグイン可能な推論エンジン
vLLM、SGLang、TensorRT-LLM などの高性能推論エンジンを自動で構成します。必要に応じてカスタム推論エンジンも追加できます。
-
推論性能の最適化
低レイテンシまたは高スループット向けの事前調整済みモードを提供します。Prefill/Decode 分離、プラットフォームが一元管理する共有 KV キャッシュ、投機的デコーディングをサポートします。
-
組み込みベンチマーク
Auto Tune が同時実行数やリクエストレートを自動的に変化させ、ピークスループット、またはサービスレベル目標(SLO)を満たす最大同時実行数を探索します。
-
GPU インスタンス
開発、ファインチューニング、対話的なワークロード向けに、SSH でアクセスできる GPU インスタンスをオンデマンドで起動します。
-
エンタープライズ水準の運用
自動障害復旧、負荷分散、監視、認証、アクセス制御をサポートします。
アーキテクチャ
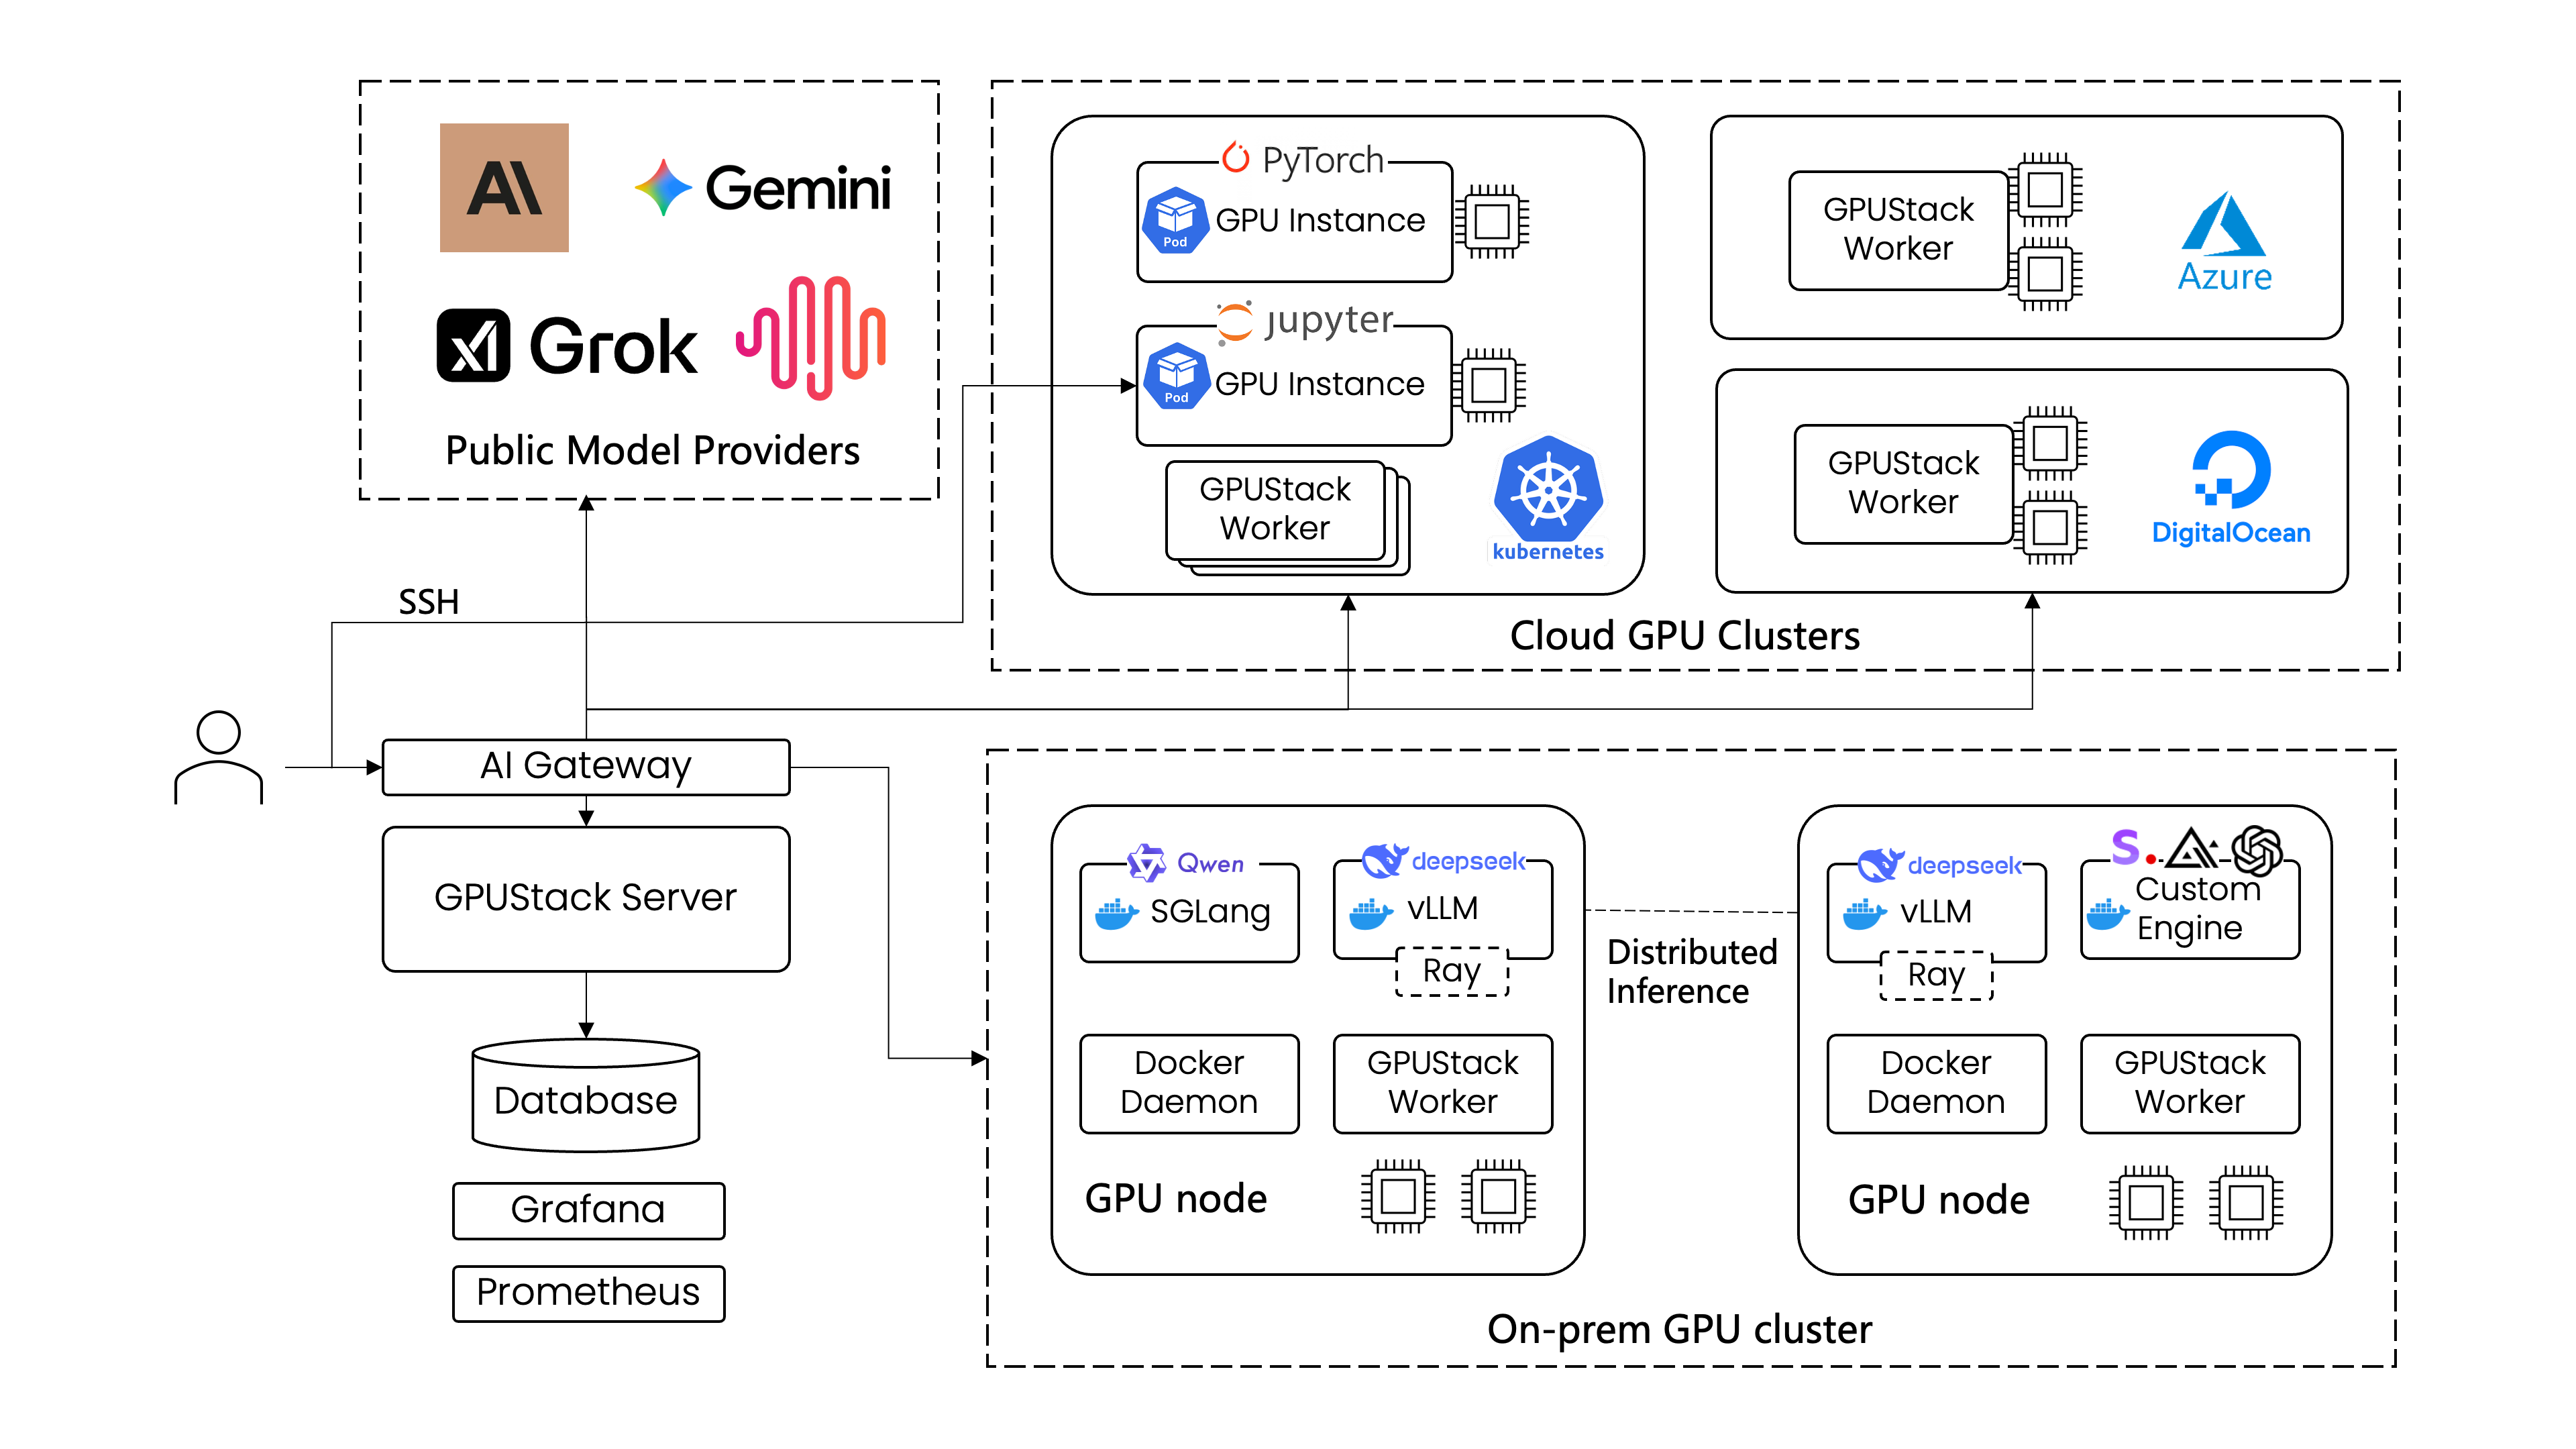
GPUStack は、開発チーム、IT 組織、サービスプロバイダーが Model-as-a-Service を大規模に提供できるようにします。LLM、音声、画像、動画モデル向けの業界標準 API に対応しています。ユーザー認証とアクセス制御、GPU 性能・使用率のリアルタイム監視、トークン使用量と API リクエストレートの詳細な計測機能を内蔵しています。
下図は、1 台の GPUStack サーバーでオンプレミスとクラウドにまたがる複数の GPU クラスターを管理する構成を示しています。GPUStack スケジューラーは GPU を割り当ててリソース使用率を最大化し、適切な推論エンジンを選択して性能を最適化します。管理者は、統合された Grafana と Prometheus のダッシュボードからシステムの健全性とメトリクスを把握できます。
クラスター全体をひと目で把握
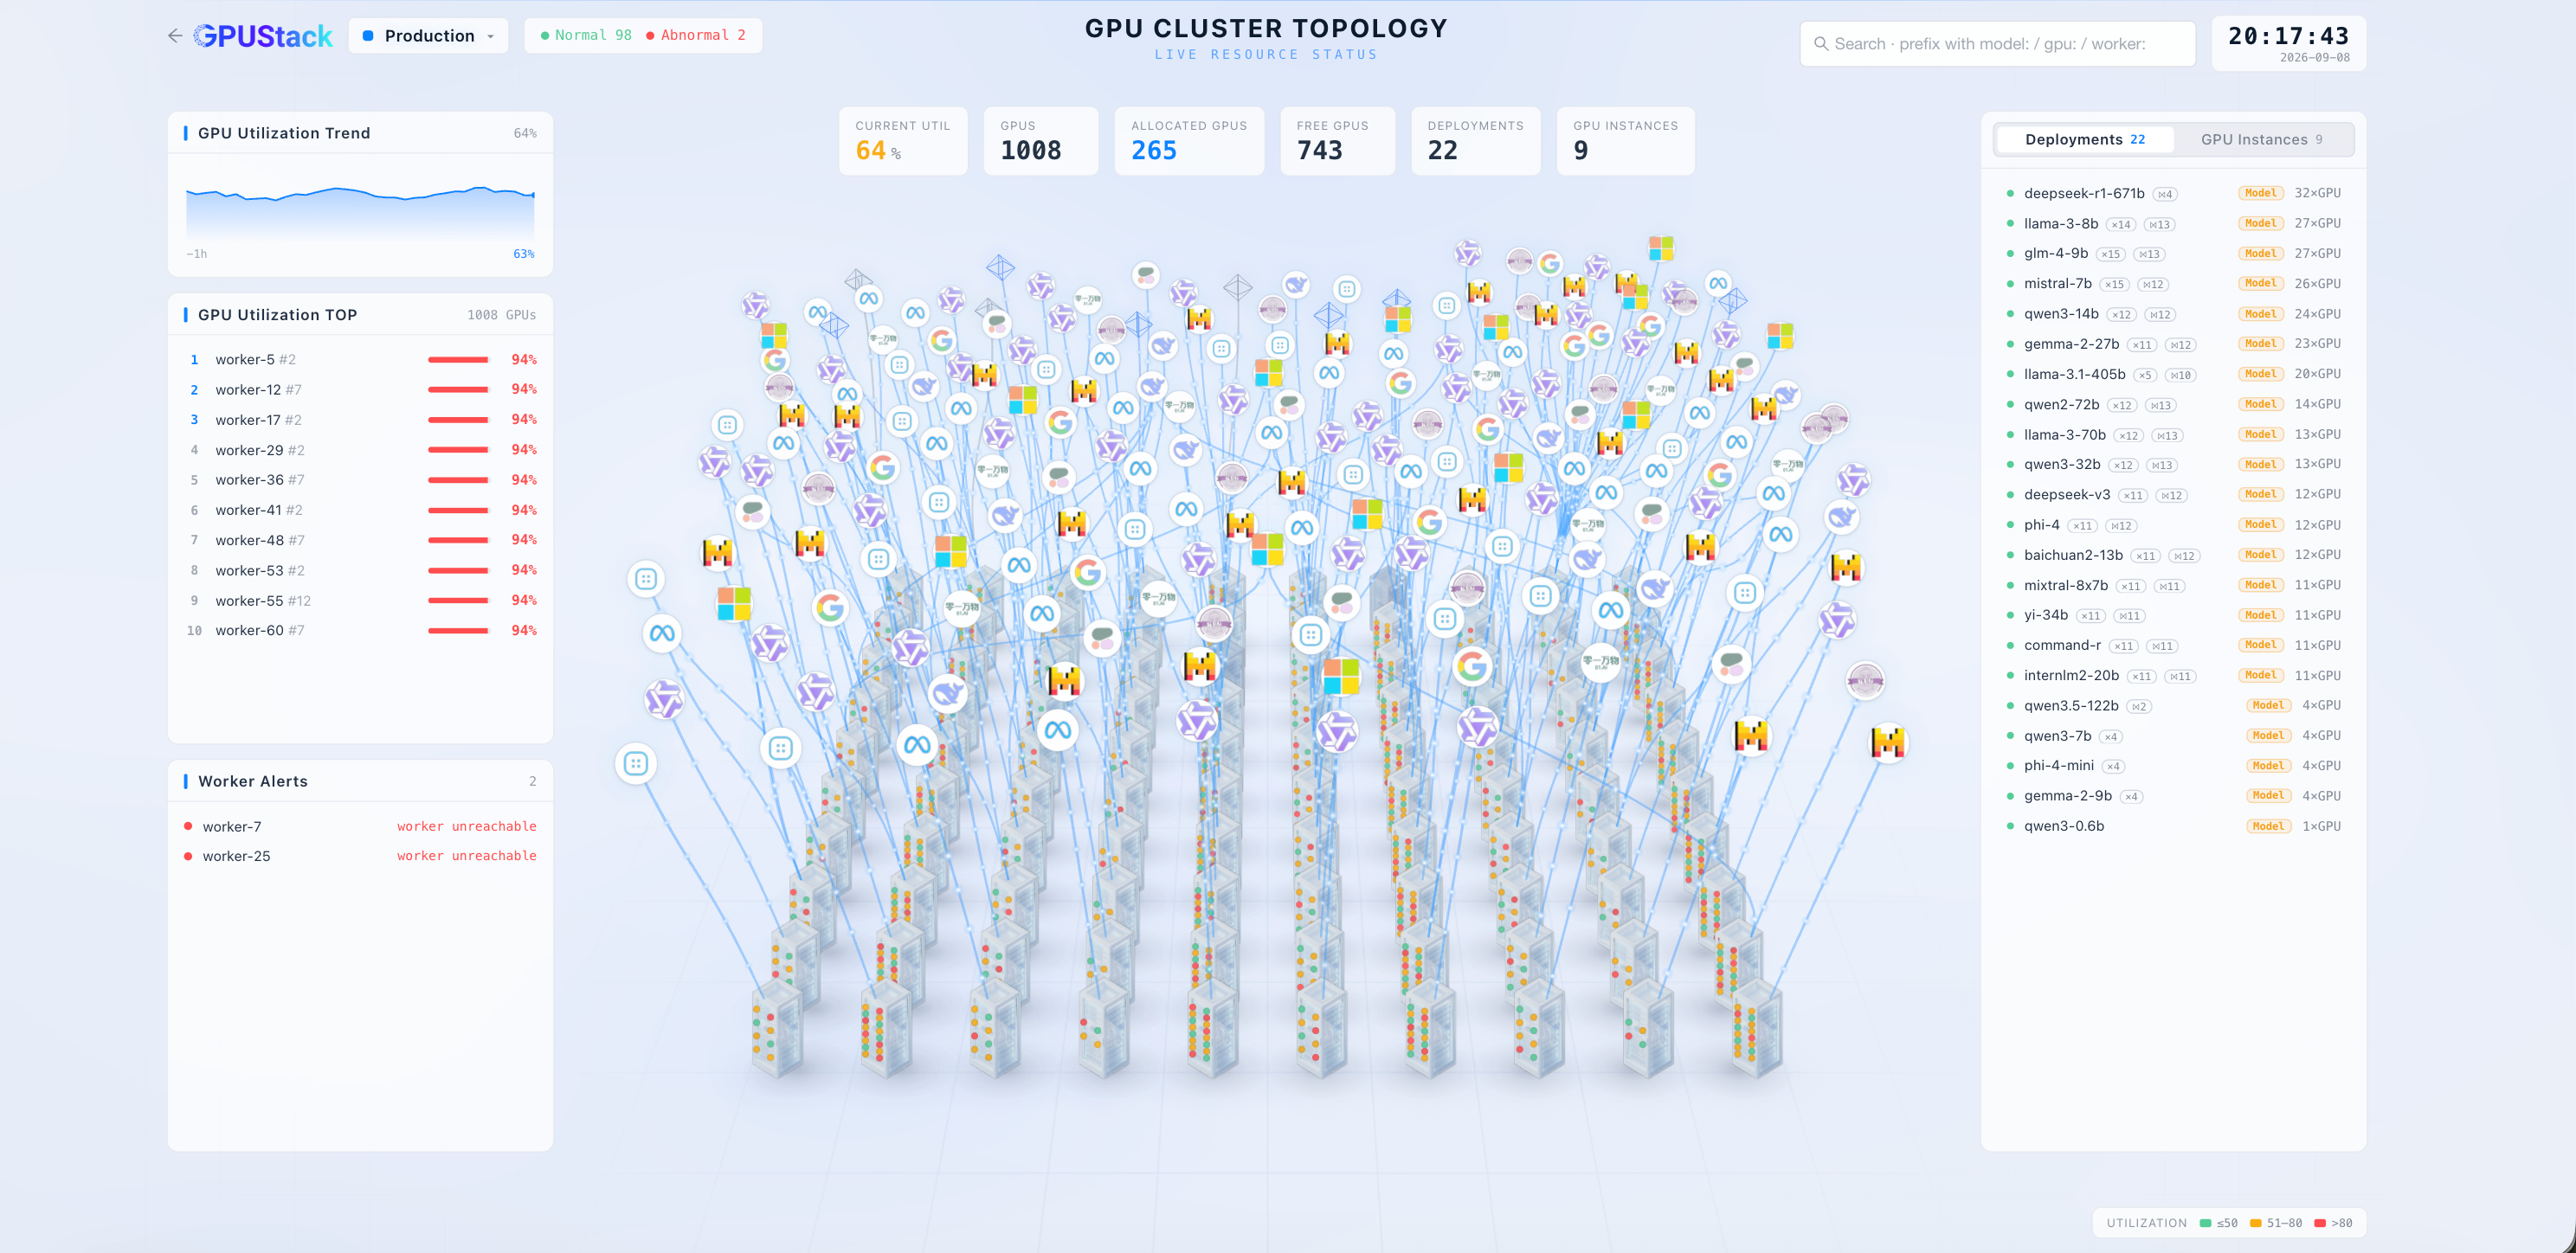
GPUStack Enterprise の GPU クラスタートポロジービューでは、すべてのワーカー、GPU、モデルデプロイメントを 1 か所で俯瞰できます。使用率、割り当て、健全性の状態がリアルタイムに表示されます。
最適化された推論性能
GPUStack はエンジンの自動選択とパラメーターの最適化により、導入直後から優れた推論性能を提供します。下図は、vLLM のデフォルト設定に対するスループットの向上を示しています。
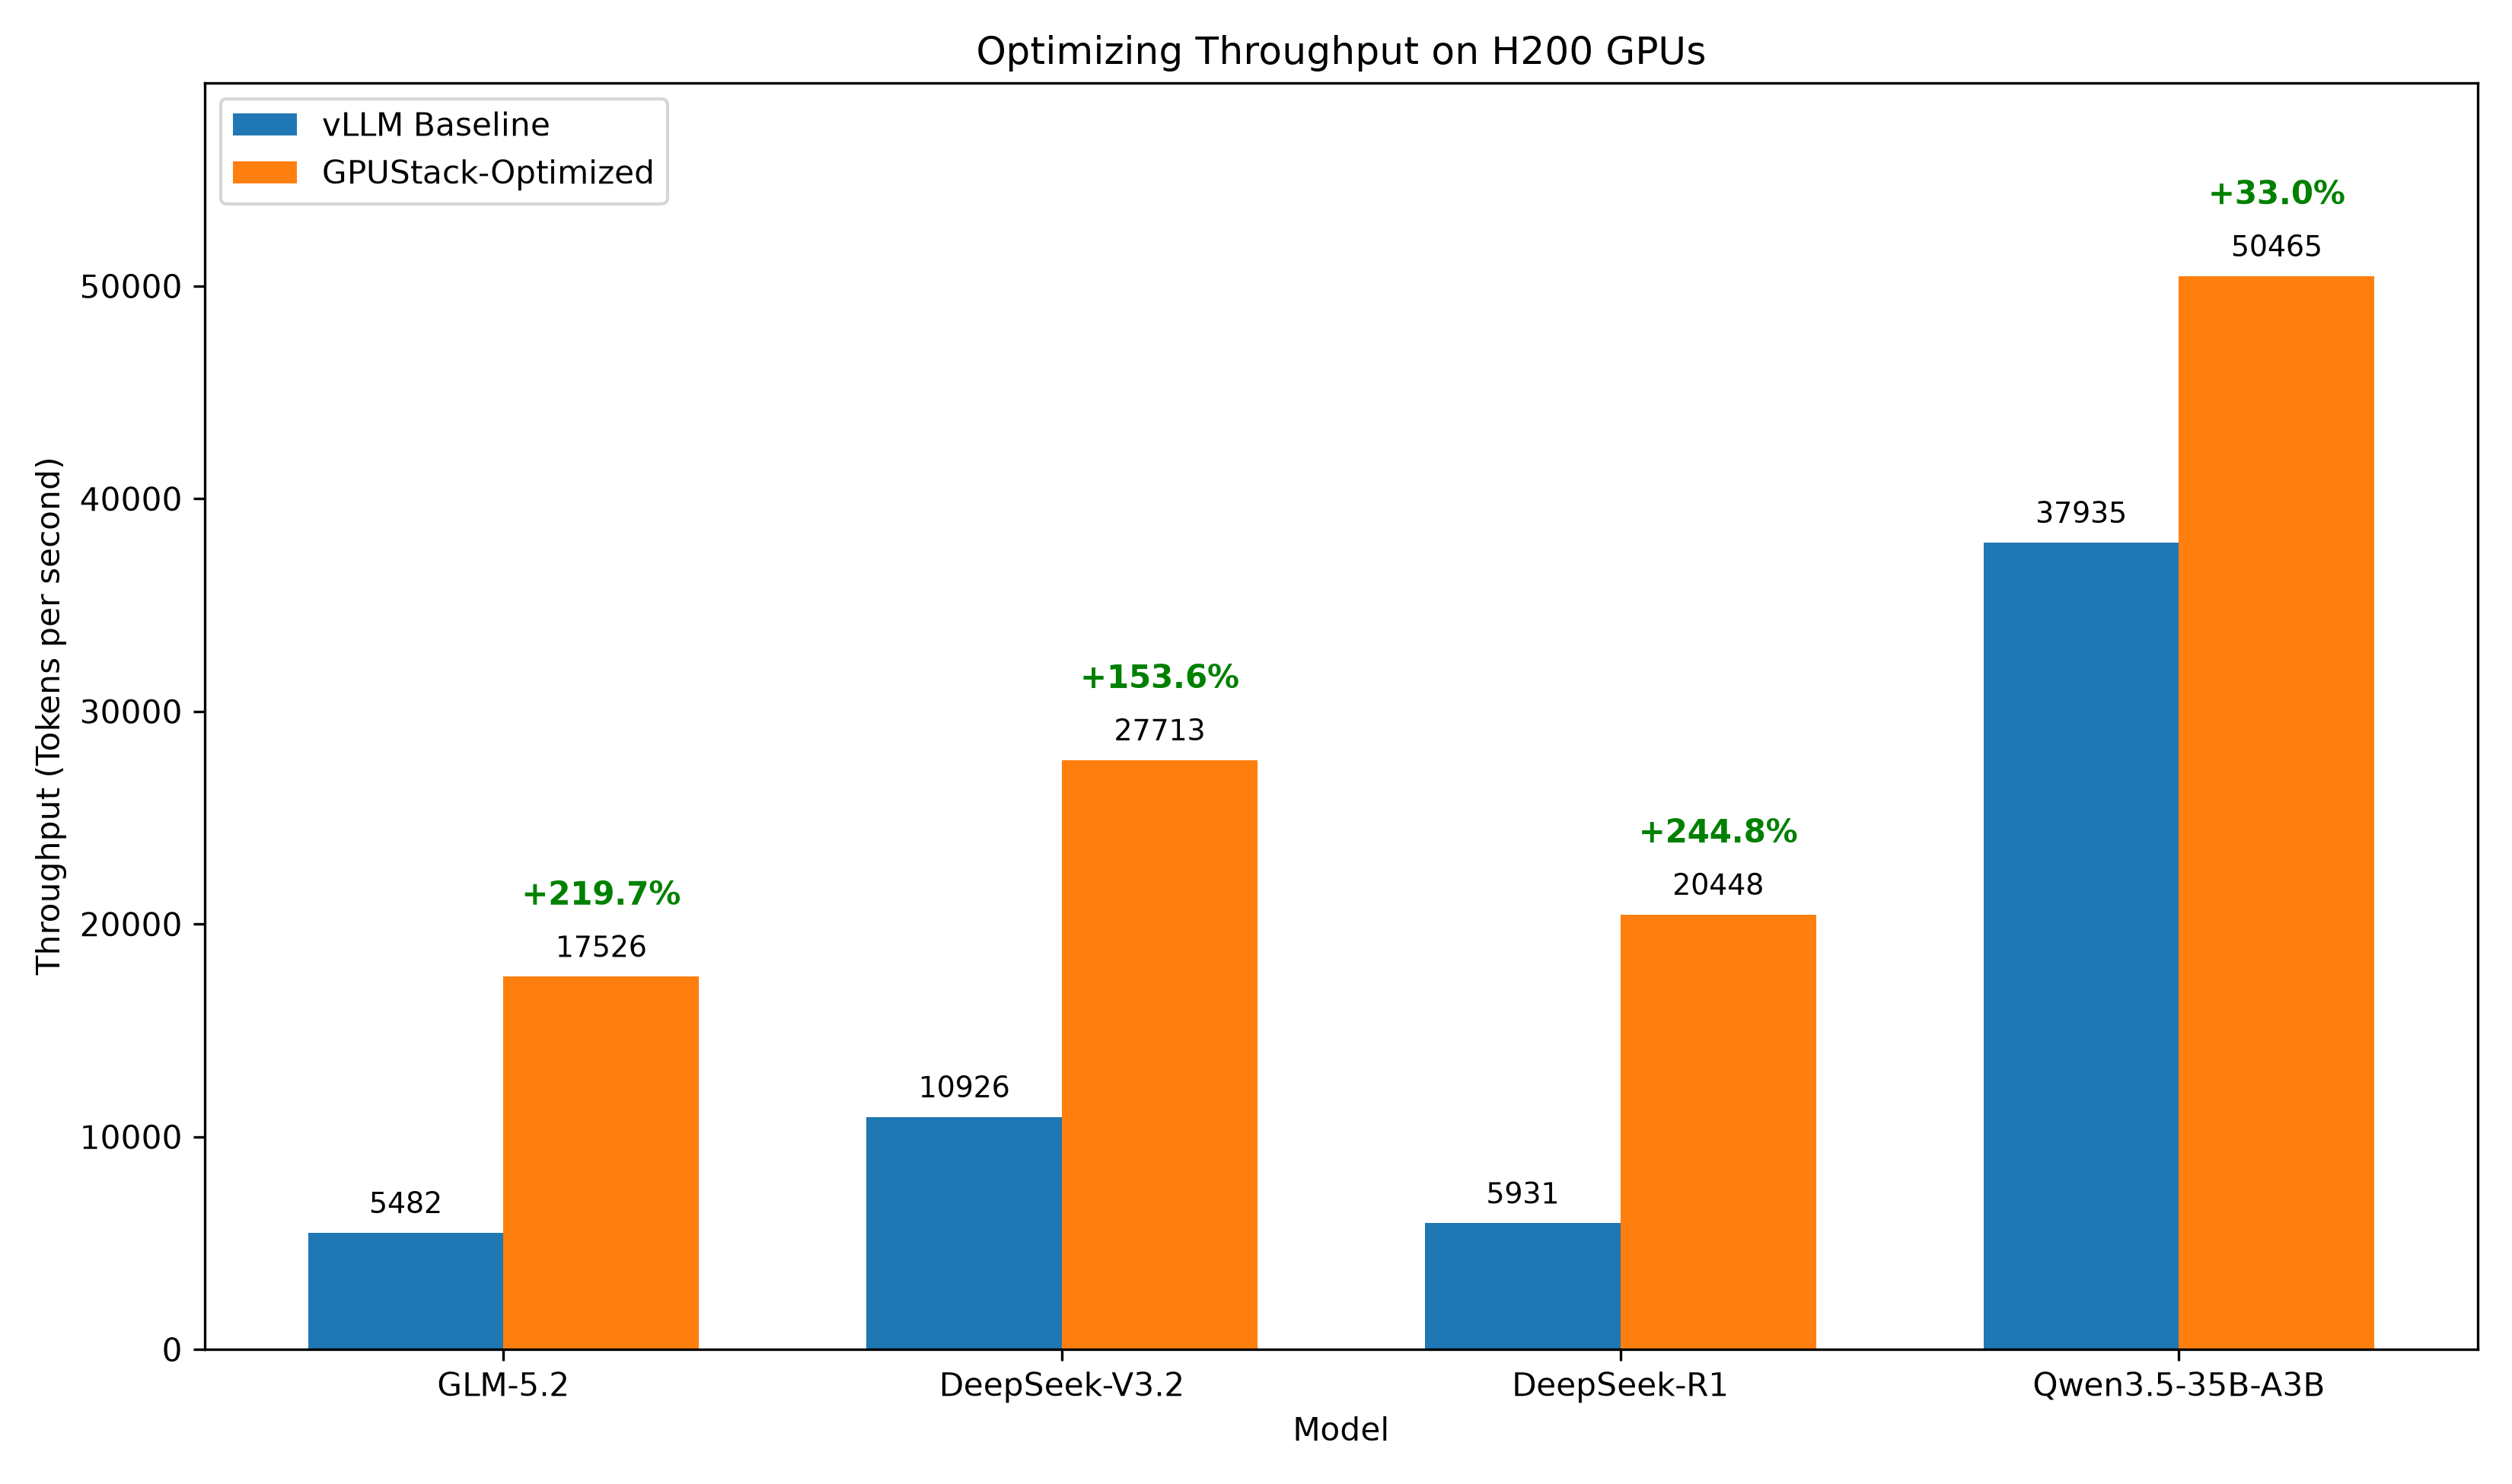
ベンチマーク手法と結果の詳細は、推論性能ラボをご覧ください。
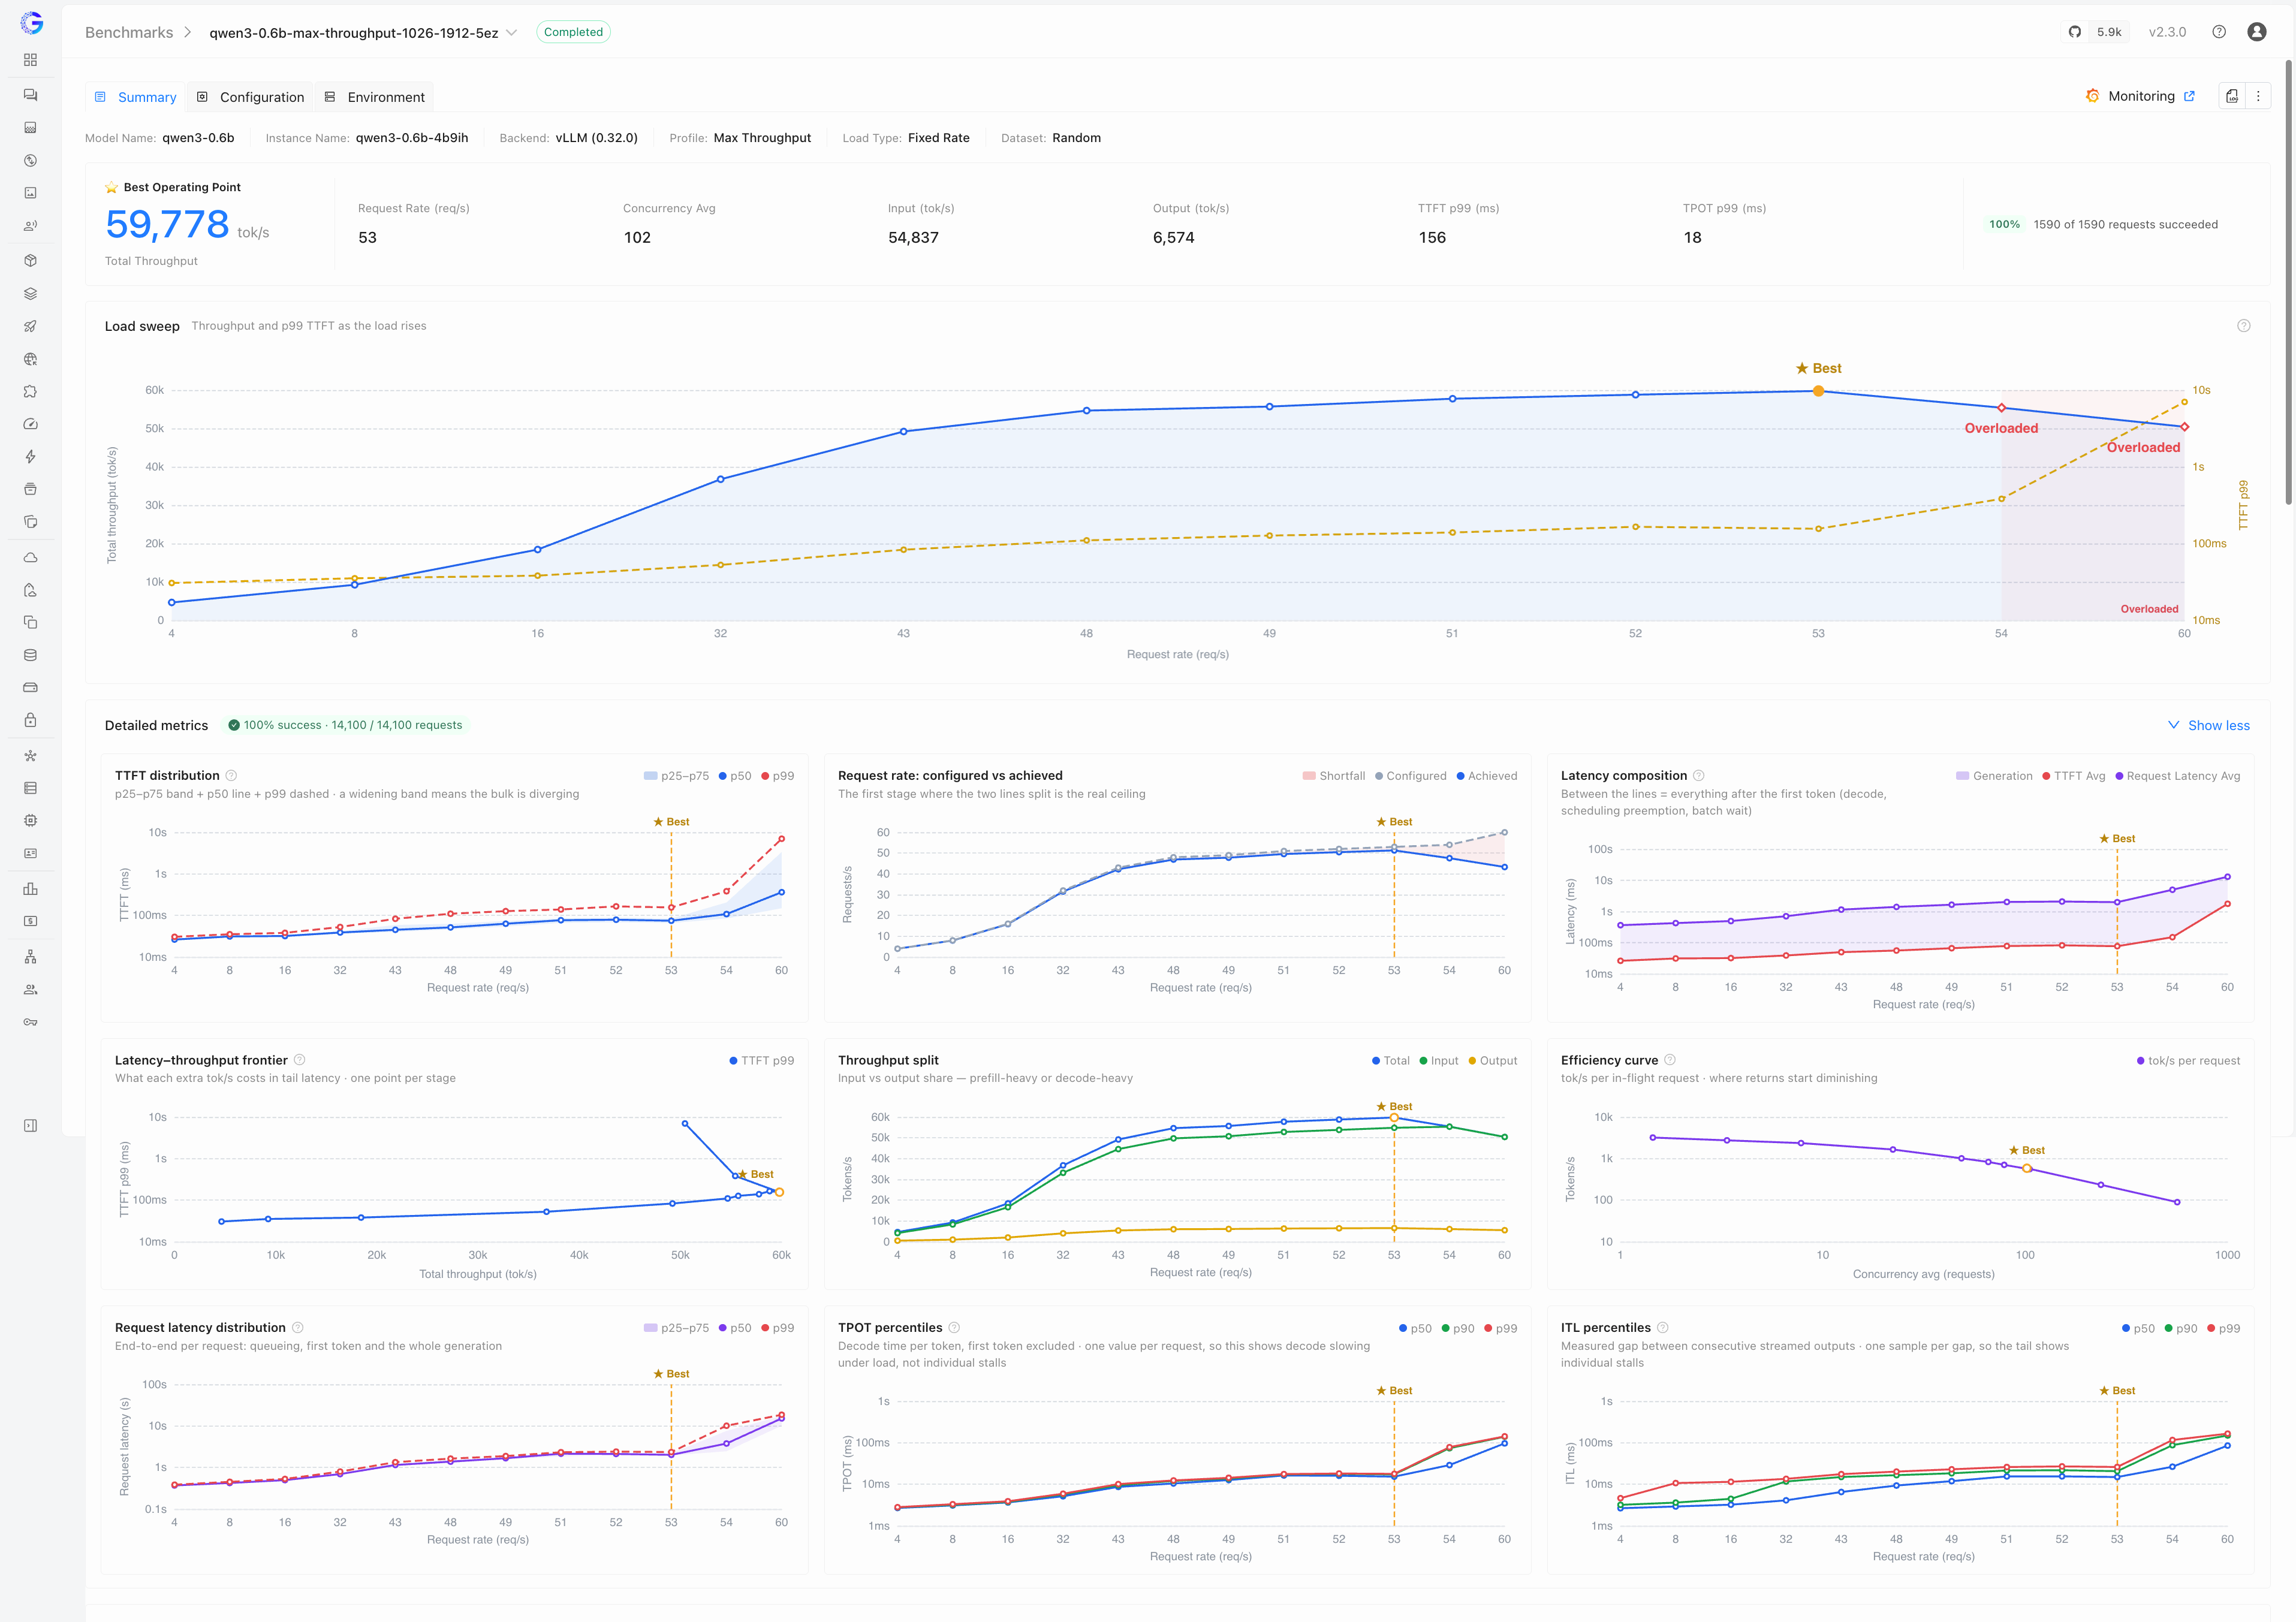
GPUStack の組み込みベンチマークで、デプロイメントが処理できる負荷を把握できます。Auto Tune が負荷を適応的に調整し、ピークスループット、またはサービスレベル目標(SLO)を満たす最大同時実行数を自動的に探索します。詳細なスループットとレイテンシのグラフがキャパシティプランニングを支援します。
対応アクセラレーター
GPUStack は、AI 推論用のさまざまなアクセラレーターに対応しています。
要件とセットアップ手順の詳細は、インストール要件をご覧ください。