アーキテクチャ
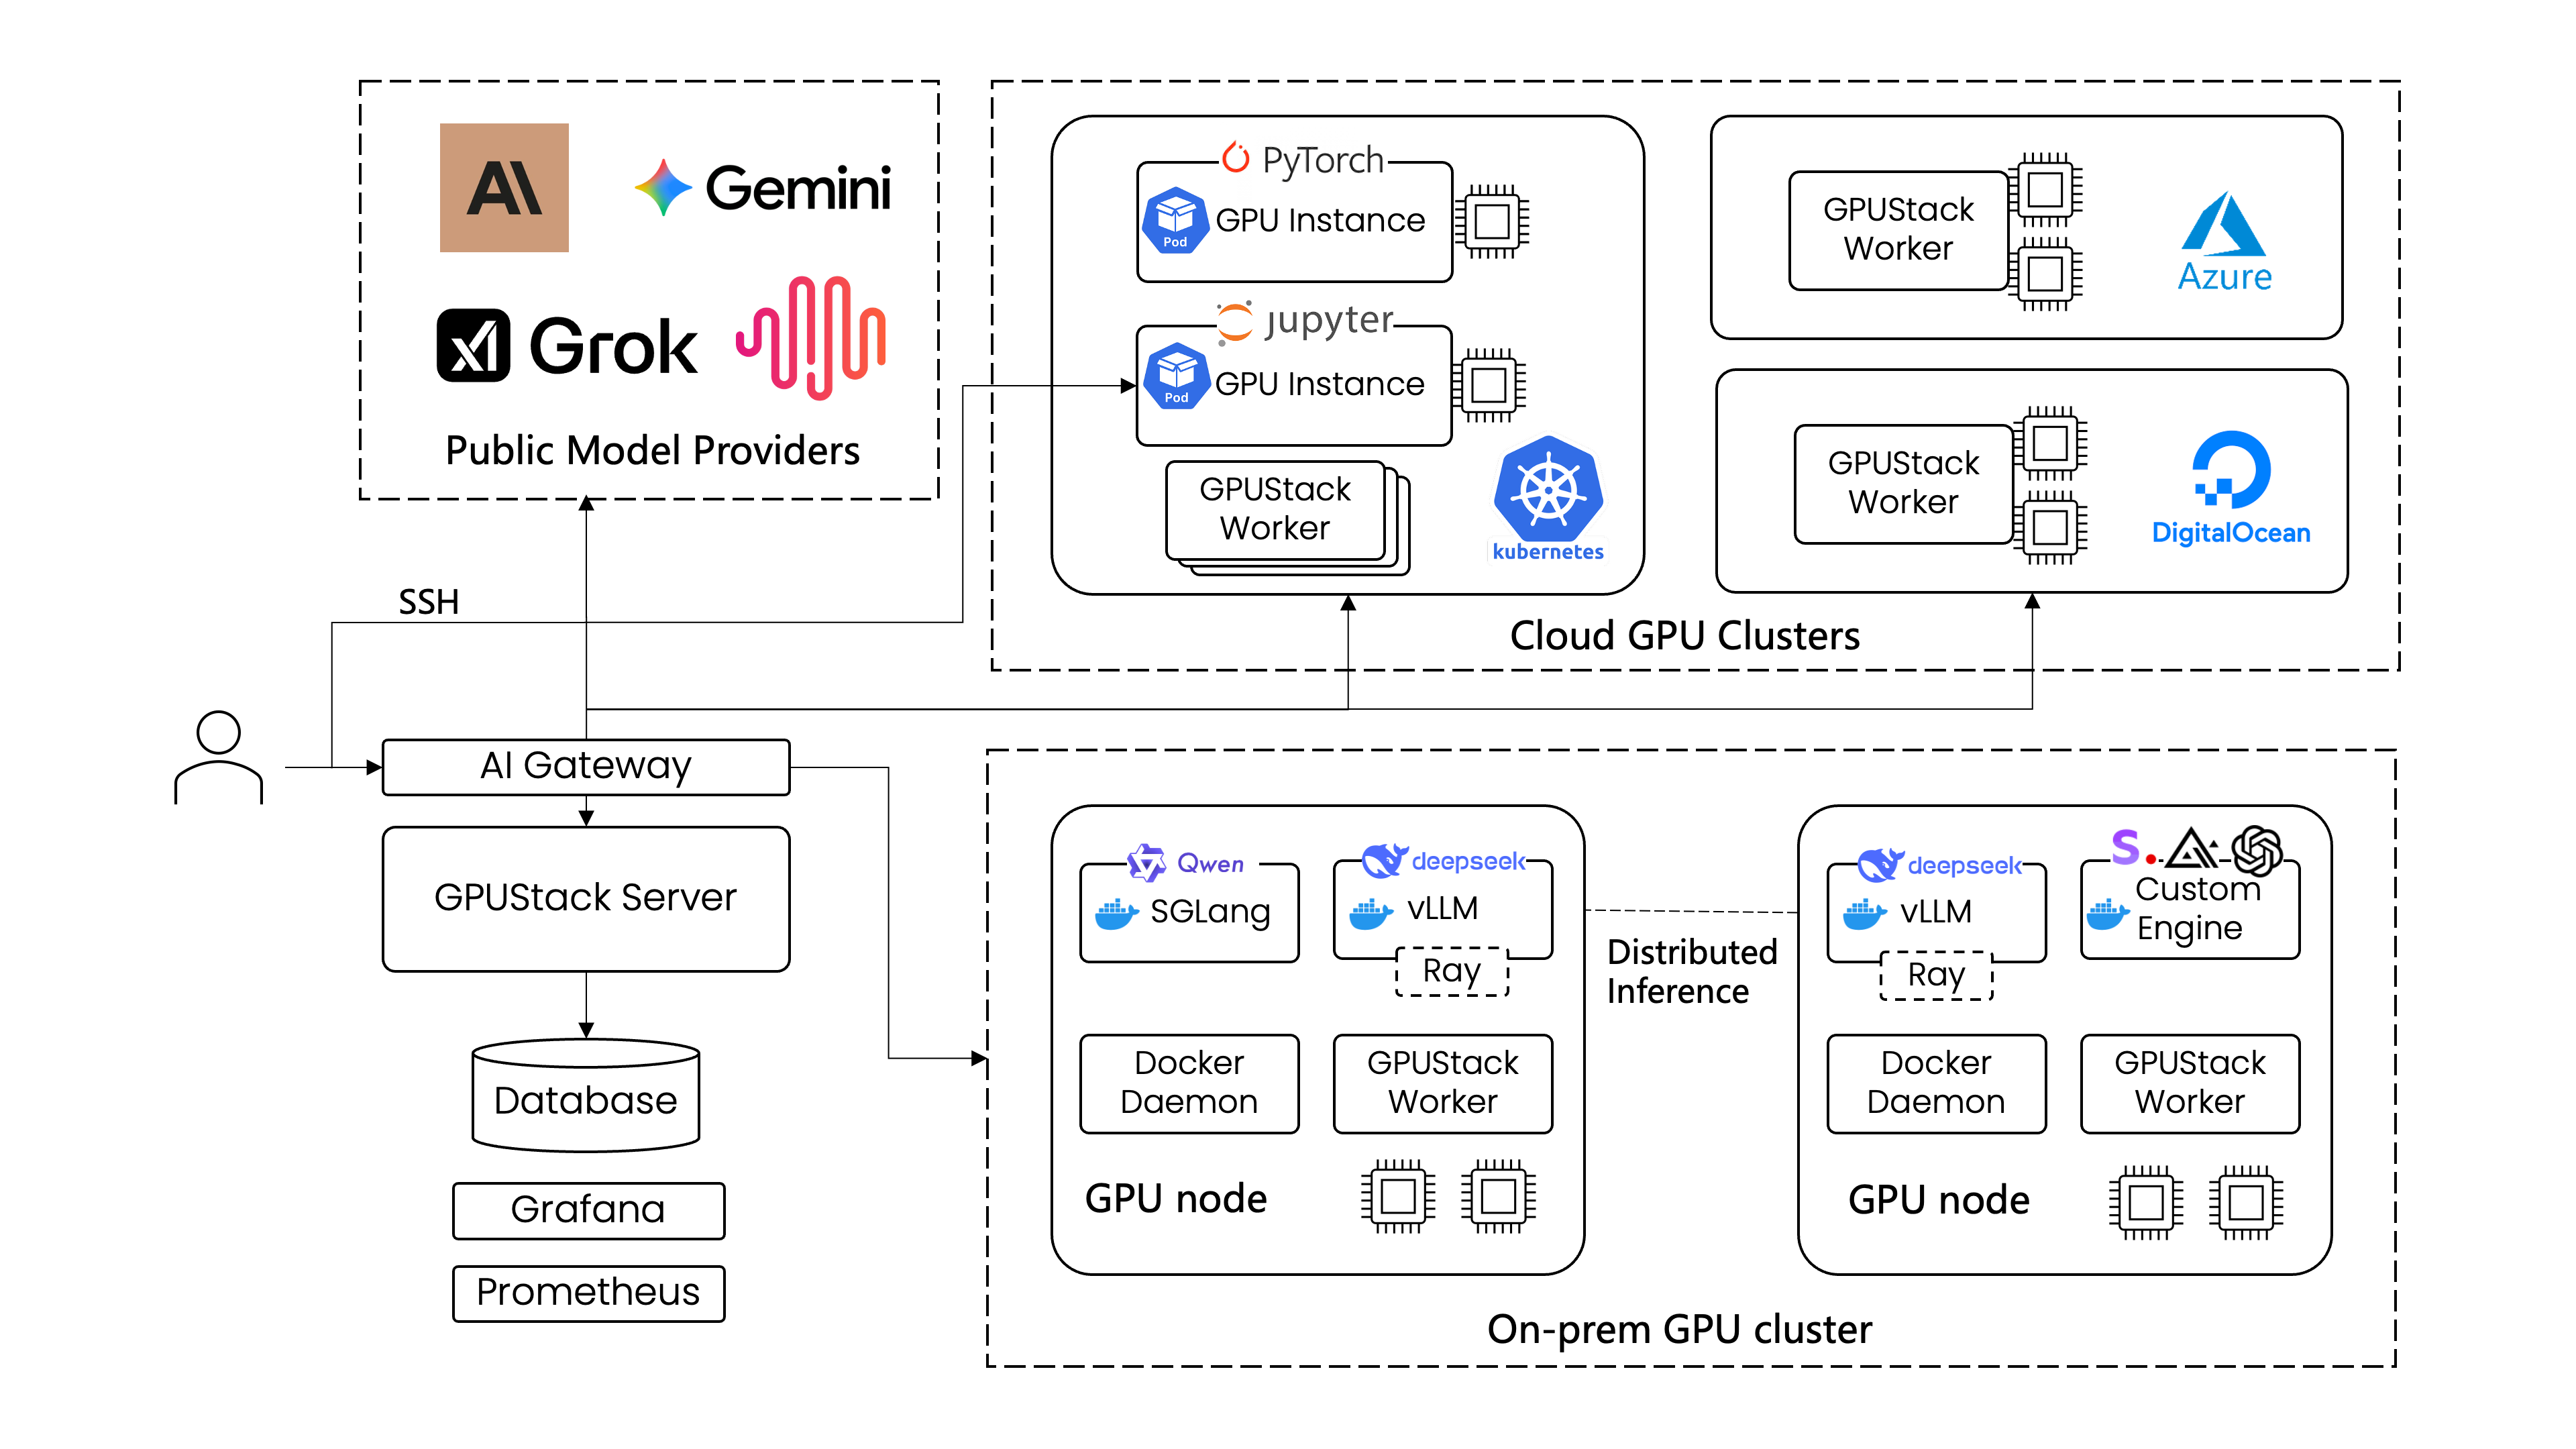
下図は、GPUStack のアーキテクチャの全体像を示しています。
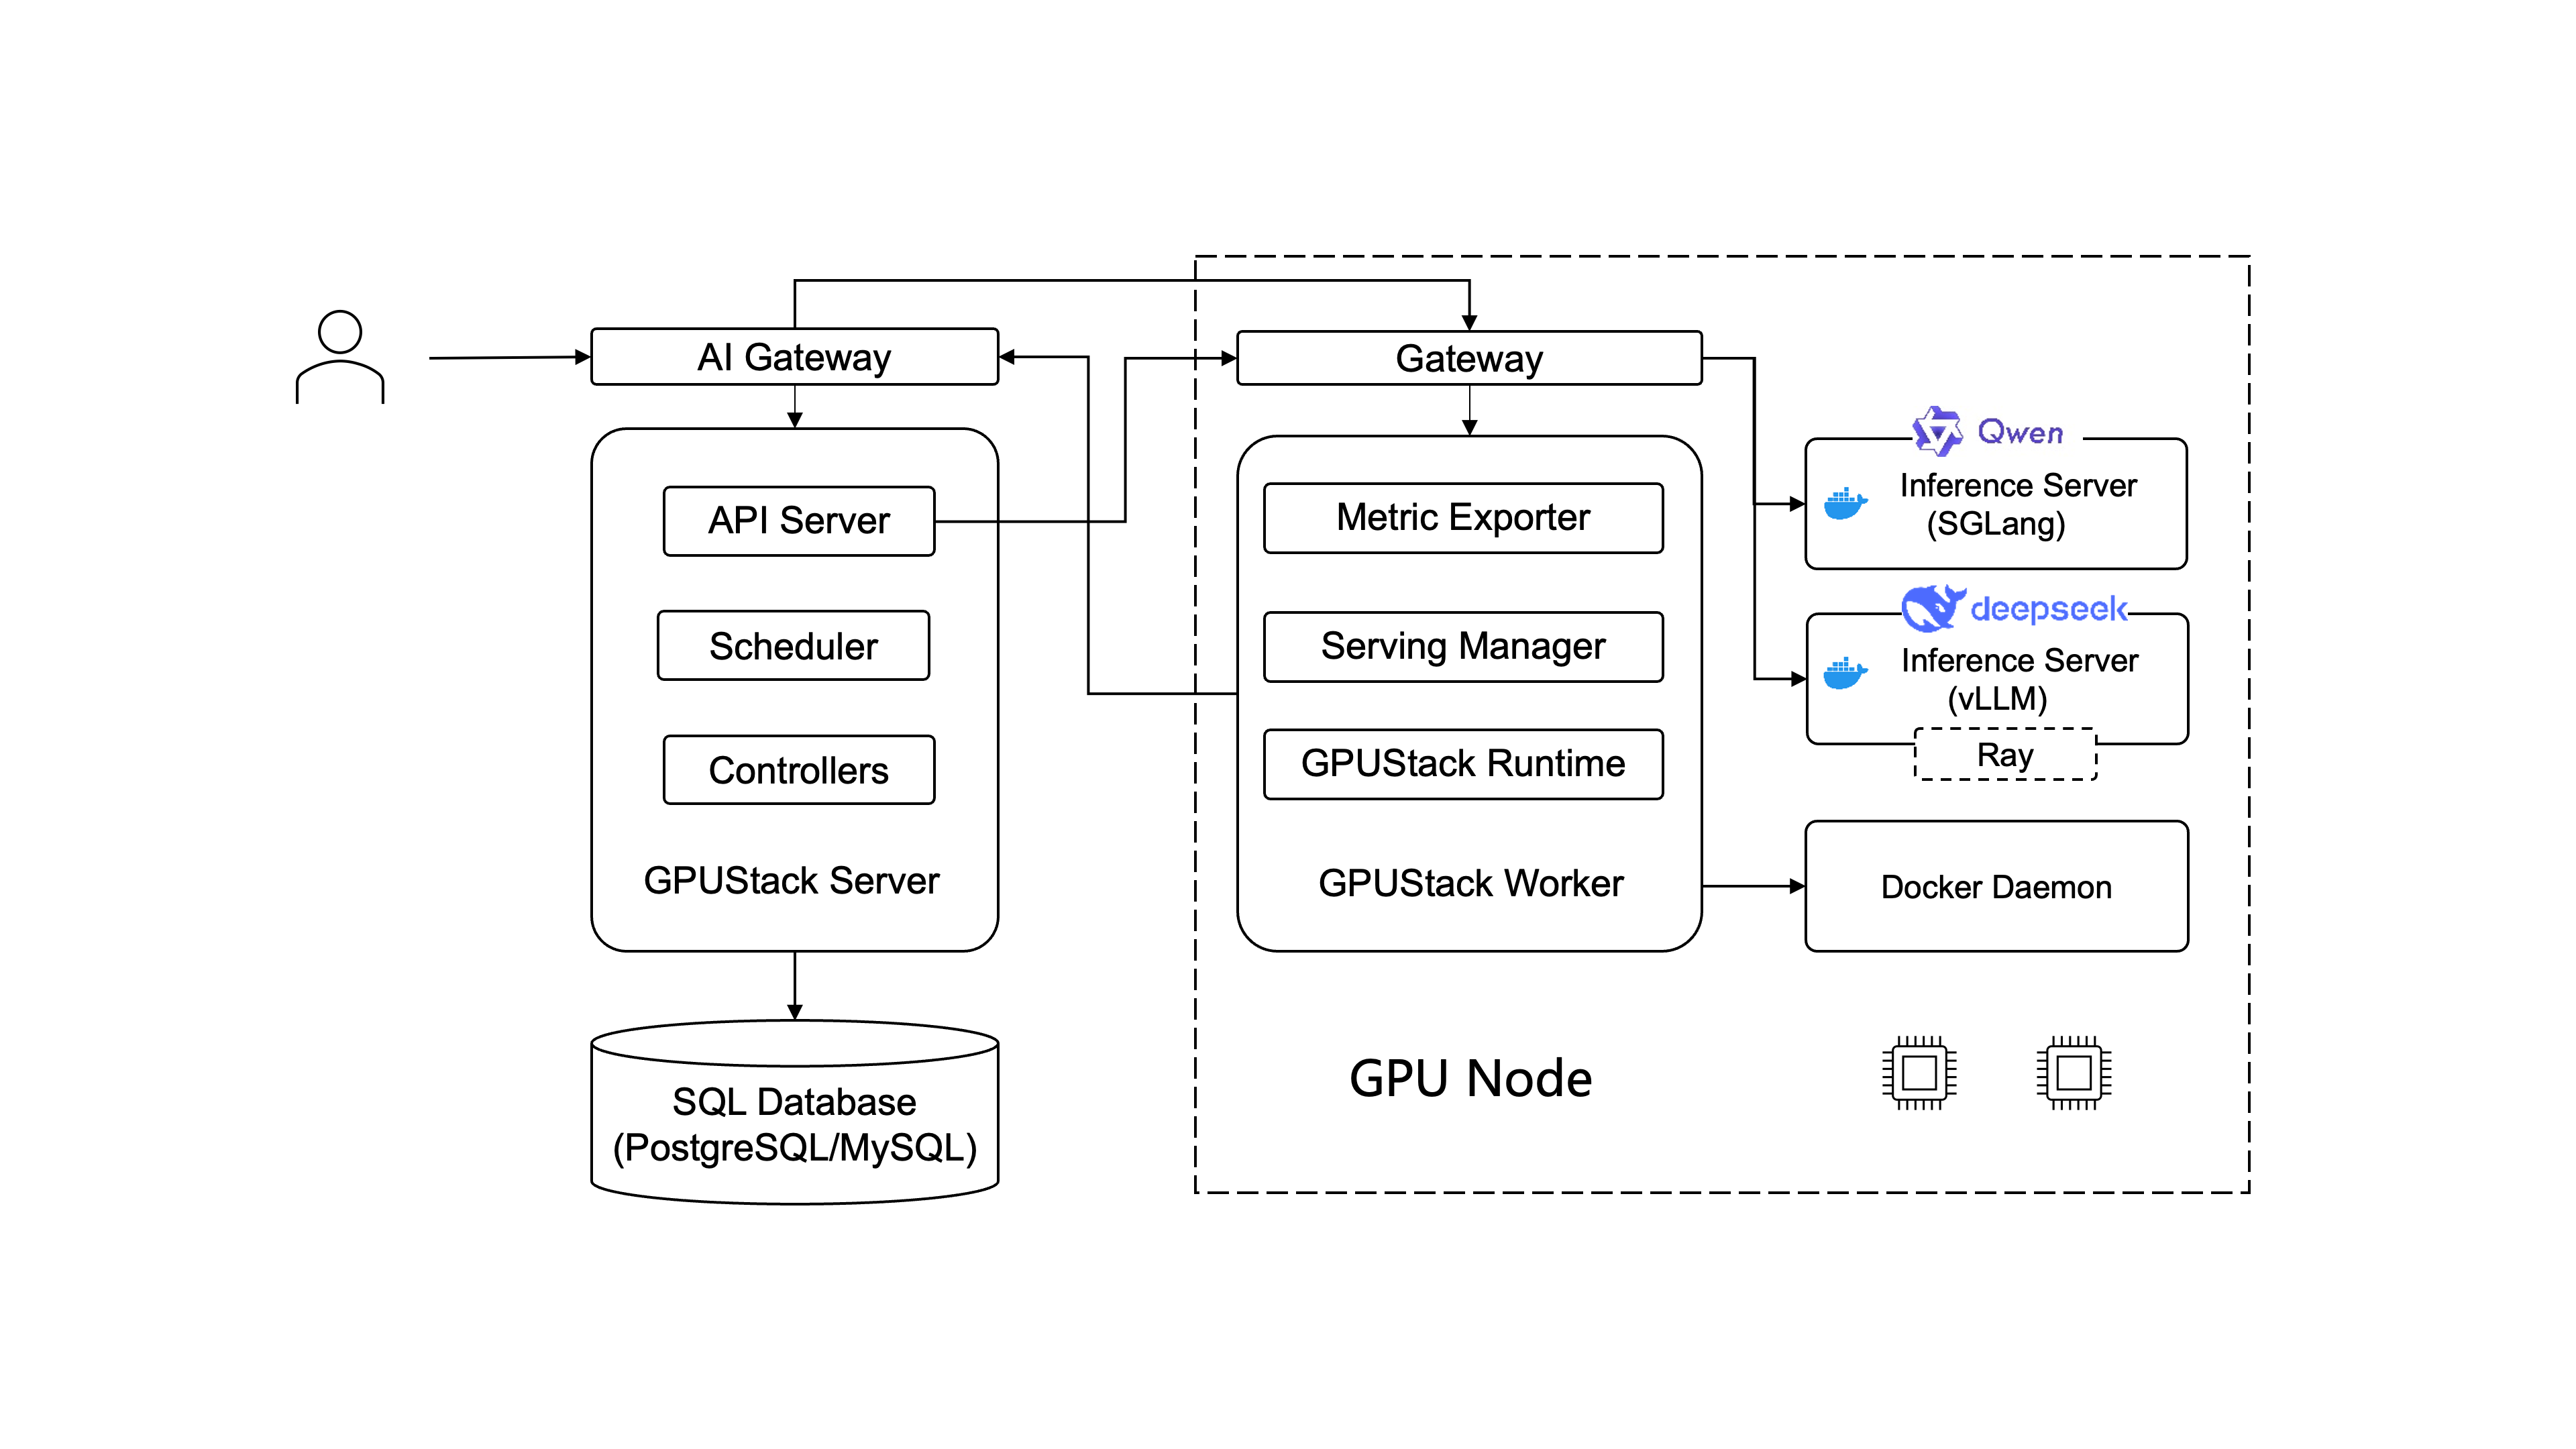
次の図は、内部コンポーネントとその相互作用を詳しく示しています。
サーバー
GPUStack サーバーは、次のコンポーネントで構成されます。
- API サーバー: クライアントがシステムと通信するための RESTful インターフェースを提供します。認証と認可を処理します。
- スケジューラー: モデルインスタンスをワーカーに割り当てます。
- コントローラー: システム内のリソースの状態を管理します。たとえば、モデルインスタンスのロールアウトやスケーリングを行い、指定したレプリカ数を維持します。
ワーカー
GPUStack ワーカーは、次のコンポーネントで構成されます。
- GPUStack Runtime: GPU デバイスを検出し、コンテナーランタイムと連携してモデルインスタンスをデプロイします。
- Serving Manager: ワーカー上のモデルインスタンスのライフサイクルを管理します。
- Metric Exporter: モデルインスタンスとその性能に関するメトリクスを出力します。
AI ゲートウェイ
AI ゲートウェイはクライアントからの API リクエストを処理します。要求されたモデルに基づいて、適切なモデルインスタンスにリクエストを振り分けます。GPUStack は API ルーティングと負荷分散に Higress を使用します。
SQL データベース
GPUStack サーバーはデータストアとして SQL データベースに接続します。デフォルトでは組み込み PostgreSQL を使用しますが、外部データベースも設定できます。対応データベースと検証済みバージョンの一覧は、データベース要件をご覧ください。
推論サーバー
推論サーバーは、推論タスクを実行するバックエンドです。GPUStack は、vLLM、SGLang、Ascend MindIE、VoxBox を組み込みの推論サーバーとしてサポートします。カスタム推論バックエンドも追加できます。
Ray
Ray は、GPUStack が分散 vLLM の実行に使用する分散コンピューティングフレームワークです。GPUStack は必要に応じて Ray クラスターを起動し、複数のワーカーで分散 vLLM を実行します。